Wenn wichtige Seiten einer Website nicht in den Suchergebnissen erscheinen, liegt die Ursache nicht immer bei den Inhalten oder den Rankings. Häufig verhindern technische Crawling-Fehler, dass Suchmaschinen bestimmte URLs zuverlässig abrufen, verstehen oder zur Indexierung vormerken können. Wer Crawling-Fehler schnell erkennen möchte, braucht deshalb eine klare Prüfroutine statt einzelner Vermutungen.
Dieser Ratgeber zeigt, wie Sie Crawl-Probleme systematisch einordnen, welche Werkzeuge dabei helfen und welche Fehler zuerst behoben werden sollten. Im Mittelpunkt stehen nachvollziehbare Prüfungen, saubere Prioritäten und Maßnahmen, die sich auch ohne tiefgehende Programmierkenntnisse umsetzen lassen.
Was Crawling-Fehler eigentlich bedeuten
Beim Crawling ruft ein Suchmaschinen-Bot öffentlich erreichbare URLs auf und verarbeitet deren Inhalte. Dabei folgt er unter anderem internen Links, XML-Sitemaps und Weiterleitungen. Ein Crawling-Fehler bedeutet, dass dieser Abruf oder die Verarbeitung einer URL nicht wie vorgesehen funktioniert hat.
Das ist nicht automatisch ein schwerwiegendes SEO-Problem. Eine absichtlich entfernte Seite darf beispielsweise einen Fehlerstatus zurückgeben. Kritisch wird es, wenn wichtige Inhalte betroffen sind: etwa Kategorieseiten, Produktseiten, Leistungsseiten, Ratgeber oder zentrale Landingpages.
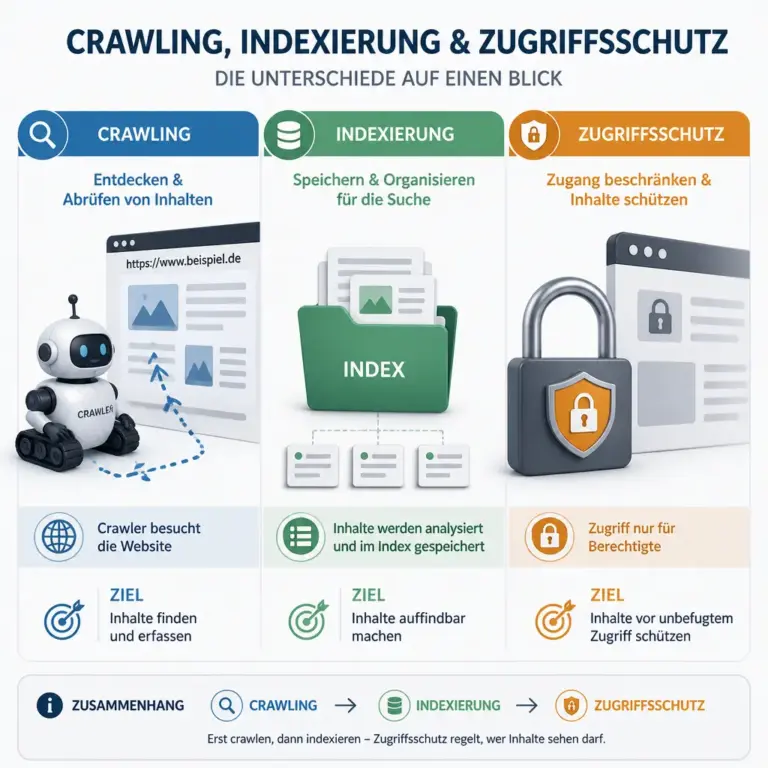
Wichtig ist die Unterscheidung zwischen Crawling und Indexierung. Crawling beschreibt den Abruf einer Seite. Indexierung beschreibt die Entscheidung, ob und wie diese Seite in den Suchindex aufgenommen wird. Eine Seite kann erfolgreich gecrawlt, aber wegen geringer Eigenständigkeit, widersprüchlicher Signale oder eines noindex-Hinweises nicht indexiert werden. Umgekehrt kann eine technisch erreichbare Seite kaum gecrawlt werden, wenn sie schlecht intern verlinkt ist.
Die häufigsten Crawling-Fehler im Überblick
Für eine schnelle erste Einschätzung hilft es, die Meldungen nach ihrer Ursache zu sortieren. Die genaue Bezeichnung kann je nach Werkzeug anders lauten, die dahinterliegenden Probleme ähneln sich jedoch häufig.
- Serverfehler: Die Website liefert beispielsweise einen Statuscode aus dem Bereich 500. Das kann auf Überlastung, fehlerhafte Serverkonfigurationen, Anwendungsfehler oder zeitweise Ausfälle hindeuten.
- Clientfehler: Ein Statuscode wie 404 zeigt, dass eine angeforderte URL nicht gefunden wurde. Bei wichtigen oder stark verlinkten Seiten sollte die Ursache geprüft werden.
- Weiterleitungsketten: Eine URL führt nicht direkt zum Ziel, sondern über mehrere Zwischenstationen. Das erschwert die Verarbeitung und macht die technische Struktur unnötig komplex.
- Weiterleitungsschleifen: Zwei oder mehrere URLs verweisen gegenseitig aufeinander. Der Abruf kann dadurch nicht zu einer endgültigen Zielseite gelangen.
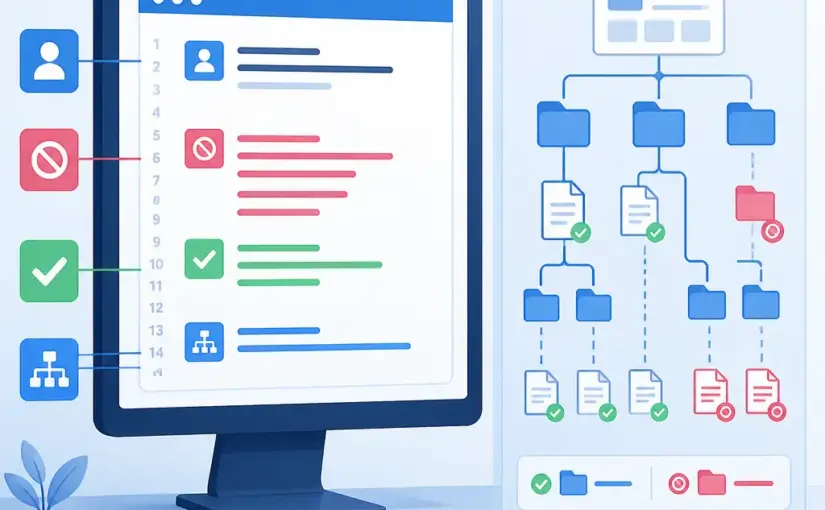
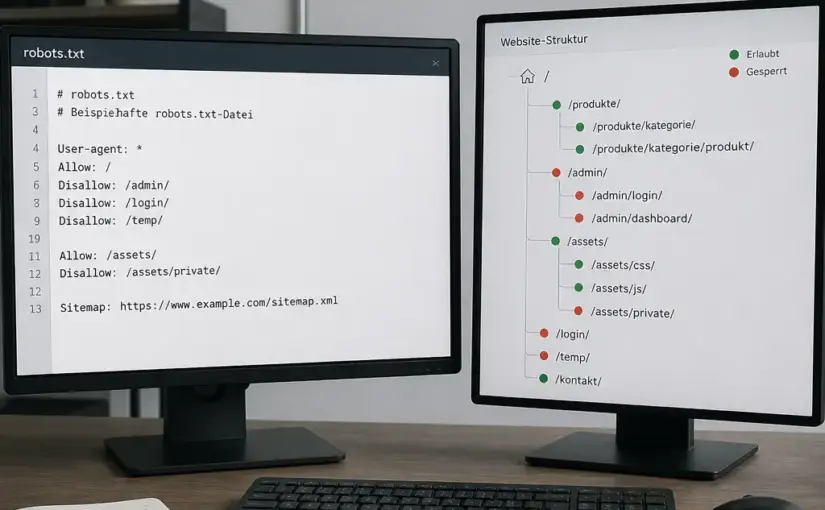
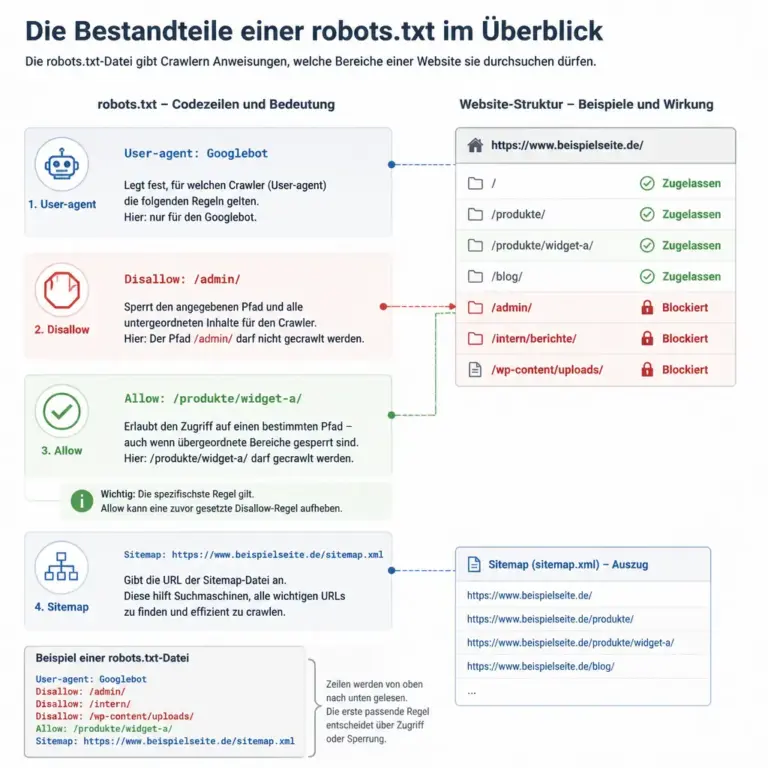
- Durch robots.txt blockiert: Eine Regel in der Datei
robots.txtverhindert den Abruf bestimmter Pfade. Das kann beabsichtigt oder ein versehentlicher Ausschluss sein. - Kein Zugriff: Ein Server verweigert den Abruf, etwa durch eine Zugangssperre, eine Sicherheitsregel oder eine fehlerhafte Berechtigung.
- DNS- oder Verbindungsprobleme: Die Domain kann vorübergehend nicht aufgelöst oder der Server nicht erreicht werden.
- Ungewöhnlich langsame Antwort: Eine Seite antwortet so langsam, dass der Abruf abbricht oder unzuverlässig wird.
- Blockierte Ressourcen: Wichtige JavaScript-, CSS- oder Bilddateien sind nicht erreichbar. Die HTML-Seite kann zwar geladen werden, wird aber möglicherweise nicht vollständig verstanden.
Nicht jede Warnung verlangt dieselbe Reaktion. Entscheidend sind URL-Typ, Bedeutung für Nutzer, interne Verlinkung, Statuscode und die Frage, ob der Zustand beabsichtigt ist.
Eine schnelle Prüfroutine für Crawling-Fehler
Eine strukturierte Reihenfolge verhindert, dass Sie sich in Einzelfällen verlieren. Beginnen Sie mit den wichtigsten URLs und arbeiten Sie sich anschließend zu weniger kritischen Meldungen vor.
1. Betroffene URL und Seitentyp erfassen
Notieren Sie zunächst die konkrete URL und ihren Zweck. Handelt es sich um die Startseite, eine wichtige Kategorie, einen Artikel, eine Produktseite oder eine technische URL? Eine einzelne veraltete Filter-URL hat meist eine andere Priorität als eine zentrale Seite, die in der Hauptnavigation verlinkt ist.
Prüfen Sie außerdem, ob mehrere betroffene URLs einem gemeinsamen Muster folgen. Treten Fehler nur bei URLs mit bestimmten Parametern, Verzeichnissen oder Sprachvarianten auf, deutet das eher auf eine systematische Konfiguration als auf einen Einzelfall hin.
2. Den aktuellen HTTP-Status prüfen
Der HTTP-Status zeigt, wie der Server auf eine Anfrage reagiert. Für eine erste Prüfung reicht ein HTTP-Header-Checker oder die technische Detailansicht eines geeigneten SEO-Werkzeugs. Entscheidend ist, ob die URL aktuell dieselbe Antwort liefert wie zum Zeitpunkt der Fehlermeldung.
Eine Seite mit dem Statuscode 200 ist grundsätzlich erreichbar. Das bedeutet jedoch nicht automatisch, dass sie indexierbar ist. Prüfen Sie zusätzlich Weiterleitungen, Canonical-Angaben, Robots-Meta-Direktiven und den tatsächlich ausgelieferten Inhalt.
Bei einer dauerhaft entfernten Seite kann ein passender Fehlerstatus korrekt sein. Wurde der Inhalt dagegen verschoben, ist eine direkte Weiterleitung auf die relevanteste neue URL meist sinnvoller als eine allgemeine Weiterleitung auf die Startseite.
3. Blockierungen und Indexierungssignale vergleichen
Vergleichen Sie anschließend die wichtigsten technischen Signale:
- Ist die URL in
robots.txtfür den relevanten Bot gesperrt? - Enthält die HTML-Seite ein
noindexoder eine vergleichbare Anweisung? - Verweist das Canonical-Element auf diese URL oder auf eine andere Variante?
- Ist die Seite über interne Links erreichbar?
- Ist sie in einer XML-Sitemap enthalten, obwohl sie absichtlich ausgeschlossen werden soll?
- Werden wichtige Inhalte erst nach einer problematischen JavaScript-Ausführung sichtbar?
Diese Signale sollten zusammenpassen. Eine URL, die in der Sitemap als wichtig dargestellt wird, aber gleichzeitig per noindex ausgeschlossen ist, erzeugt ein widersprüchliches Bild. Ebenso sollte eine wichtige indexierbare Seite nicht ausschließlich über schwer zugängliche Skript-Elemente erreichbar sein.
4. Einen Live-Abruf durchführen
Historische Crawling-Berichte können veraltet sein. Deshalb ist ein aktueller Live-Test wichtig. Er zeigt, ob der Fehler noch besteht, ob die URL inzwischen weiterleitet oder ob sich die Serverantwort verändert hat.
Beachten Sie, dass ein Live-Abruf nicht jede Situation vollständig abbildet. Temporäre Serverprobleme, unterschiedliche Bot-Anfragen, Geoblocking, WAF-Regeln oder Lastspitzen können zu abweichenden Ergebnissen führen. Wiederholen Sie die Prüfung bei unklaren Fällen und beziehen Sie Server- oder Hosting-Protokolle ein, wenn die Ursache nicht sichtbar wird.
So priorisieren Sie Crawling-Fehler richtig
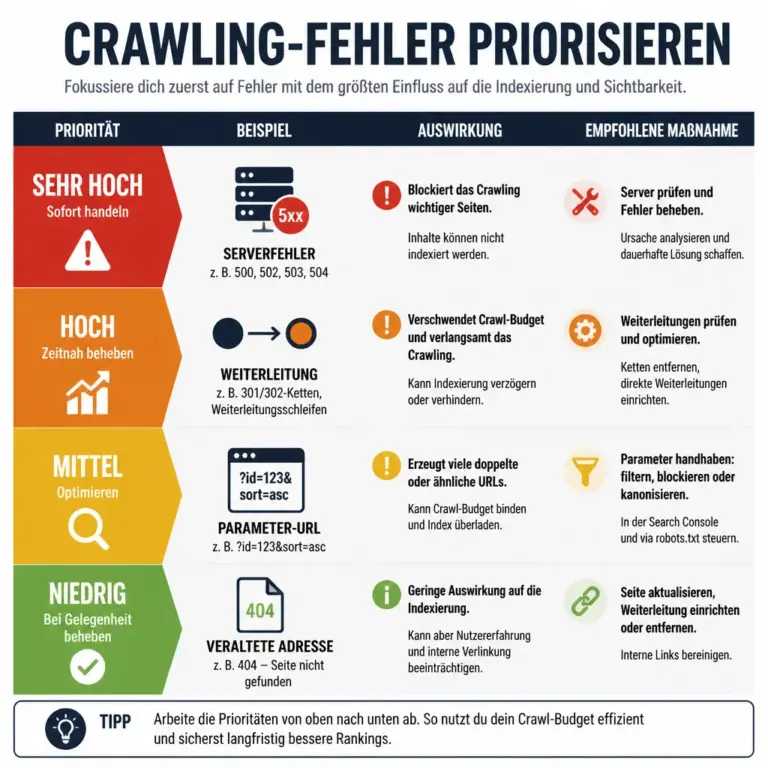
Die Grafik zeigt, warum nicht jede Fehlermeldung gleich dringend ist. Besonders wichtig sind Fehler auf zentralen Seiten, während absichtlich entfernte oder unwichtige URLs meist nachrangig behandelt werden können.
Eine lange Liste technischer Meldungen wirkt schnell dringender, als sie tatsächlich ist. Priorisieren Sie nach dem möglichen Schaden und nicht allein nach der Anzahl der betroffenen URLs.
| Priorität | Typischer Fall | Empfohlene Reaktion |
|---|---|---|
| Sehr hoch | Wichtige Seite liefert einen Serverfehler, ist gesperrt oder führt in eine Schleife. | Ursache zeitnah beheben, danach erneut live prüfen. |
| Hoch | Zentrale Seite ist verschwunden, falsch weitergeleitet oder nicht intern verlinkt. | Ziel, Weiterleitung und Verlinkung korrigieren. |
| Mittel | Viele ähnliche URLs entstehen durch Filter, Parameter oder doppelte Varianten. | URL-Konzept, interne Links und Crawling-Signale bereinigen. |
| Niedrig | Veraltete, absichtlich entfernte oder unwichtige URL wird weiterhin gemeldet. | Absicht dokumentieren und unnötige Signale möglichst reduzieren. |
Beziehen Sie zusätzlich die Bedeutung für Nutzer ein. Ein Fehler auf einer kaum besuchten Archivseite ist anders zu bewerten als ein Fehler auf einer Seite, die viele interne Links, externe Verweise oder geschäftlich wichtige Inhalte bündelt.
Typische Ursachen und passende Lösungen
404-Fehler durch entfernte oder geänderte URLs
Ein 404-Fehler ist nicht grundsätzlich falsch. Er ist passend, wenn eine URL dauerhaft nicht mehr existiert und keine sinnvolle Ersatzseite vorhanden ist. Problematisch wird er, wenn eine Seite versehentlich gelöscht, beim Relaunch umbenannt oder aus internen Links nicht angepasst wurde.
Ermitteln Sie zunächst, ob es eine inhaltlich nahe Ersatz-URL gibt. Falls ja, richten Sie eine direkte Weiterleitung ein und aktualisieren Sie interne Verweise, Sitemaps und gegebenenfalls externe Kommunikationsmittel. Falls keine Ersatzseite existiert, entfernen Sie unnötige interne Links und prüfen Sie, ob die URL noch in einer Sitemap auftaucht.
Serverfehler und instabile Erreichbarkeit
Bei Serverfehlern sollte nicht sofort nur die betroffene URL betrachtet werden. Prüfen Sie, ob zur gleichen Zeit weitere Seiten, Verzeichnisse oder die gesamte Domain betroffen waren. Ein einzelner Fehler kann auf eine fehlerhafte Vorlage hindeuten; viele zeitgleiche Fehler sprechen eher für Hosting-, Datenbank-, Cache- oder Deployment-Probleme.
Hilfreich sind Serverprotokolle, Anwendungslogs und der zeitliche Abgleich mit Änderungen. Auch Sicherheitsdienste können legitime Abrufe blockieren. Lassen Sie Regeln prüfen, die bestimmte User-Agents, IP-Bereiche, Länder oder ungewöhnliche Anfragefolgen ausfiltern.
Falsch gesetzte robots.txt-Regeln
Die Datei robots.txt steuert, welche Pfade ein Bot abrufen darf. Ein versehentlich zu weit gefasster Ausschluss kann ganze Verzeichnisse blockieren. Kontrollieren Sie deshalb besonders Regeln für Verzeichnisse, Wildcards und neu eingeführte URL-Strukturen.
Eine robots.txt-Regel ersetzt keinen zuverlässigen Indexierungsschutz für sensible Inhalte. Wenn Inhalte wirklich nicht öffentlich zugänglich sein sollen, benötigen sie eine geeignete Zugriffskontrolle. Für SEO ist außerdem wichtig: Eine blockierte URL kann unter Umständen weiterhin durch externe Hinweise bekannt werden, obwohl ihr Inhalt nicht abgerufen werden darf.
Weiterleitungen, Ketten und Schleifen
Eine gute Weiterleitung führt möglichst direkt von der alten URL zur passenden Zielseite. Ketten entstehen oft, wenn frühere Weiterleitungen bei späteren URL-Änderungen nicht aktualisiert wurden. Prüfen Sie daher nicht nur die erste Antwort, sondern die vollständige Abfolge bis zum endgültigen Ziel.
Bei Schleifen helfen ein Vergleich von HTTP- und HTTPS-Version, www- und nicht-www-Variante, Groß- und Kleinschreibung sowie Sprach- und Trailing-Slash-Regeln. Auch widersprüchliche Vorgaben aus Serverkonfiguration, Content-Management-System und Plugins können eine Schleife verursachen.
Langsame oder überlastete Seiten
Eine langsame Antwort kann durch große Datenbankabfragen, nicht optimierte Medien, externe Dienste, fehlerhafte Caches oder hohe Serverlast entstehen. Prüfen Sie, ob die Verzögerung dauerhaft, nur zu bestimmten Zeiten oder nur bei bestimmten Seitentypen auftritt.
Reduzieren Sie unnötige Abfragen, optimieren Sie Medien und überprüfen Sie Cache-Regeln. Dabei sollte nicht blind jede Funktion entfernt werden. Ziel ist eine stabile, vollständige Auslieferung der Inhalte, nicht lediglich eine kurzfristig niedrigere Ladezeit in einem einzelnen Test.
Interne Verlinkung und XML-Sitemap als Kontrollpunkte
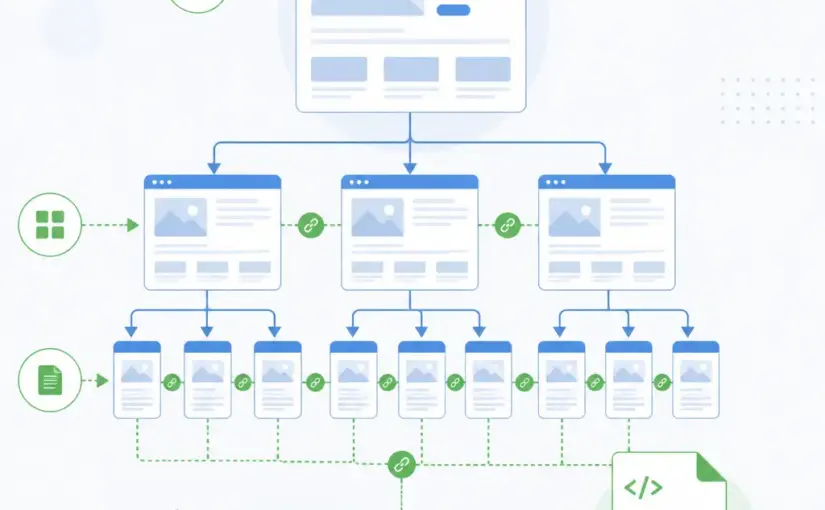
Suchmaschinen entdecken URLs über verschiedene Wege. Interne Links sind dabei ein wichtiges Signal für Struktur und Bedeutung. Eine wichtige Seite sollte von relevanten, selbst erreichbaren Seiten aus verlinkt sein. Vermeiden Sie, dass zentrale Inhalte ausschließlich über Suchfelder, Filter oder Skript-Interaktionen erreichbar sind.
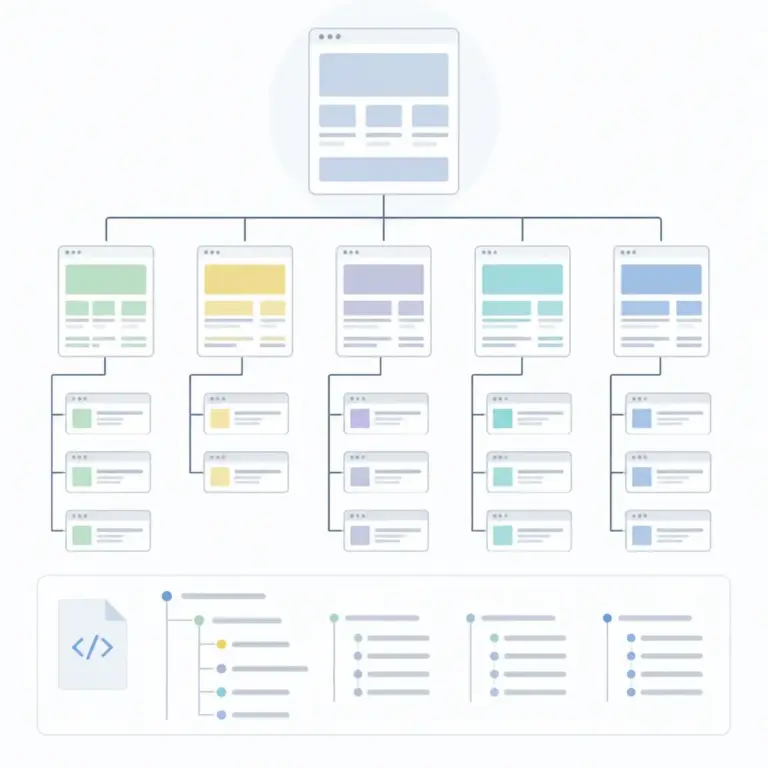
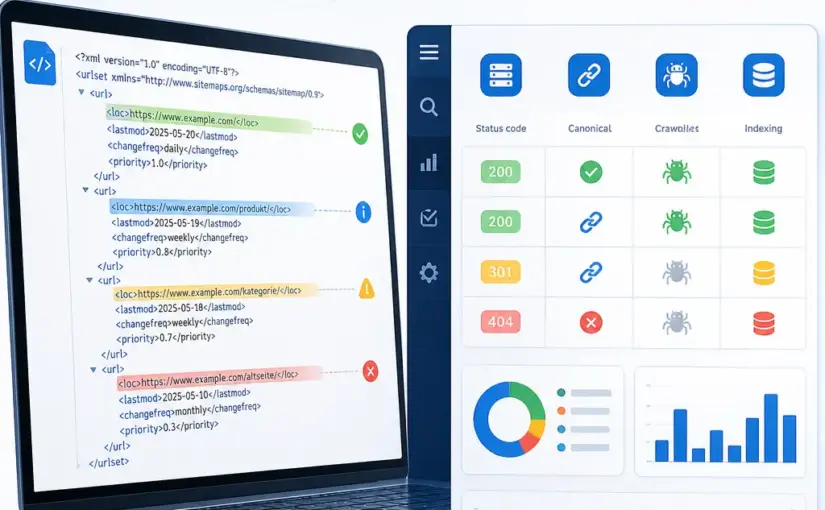
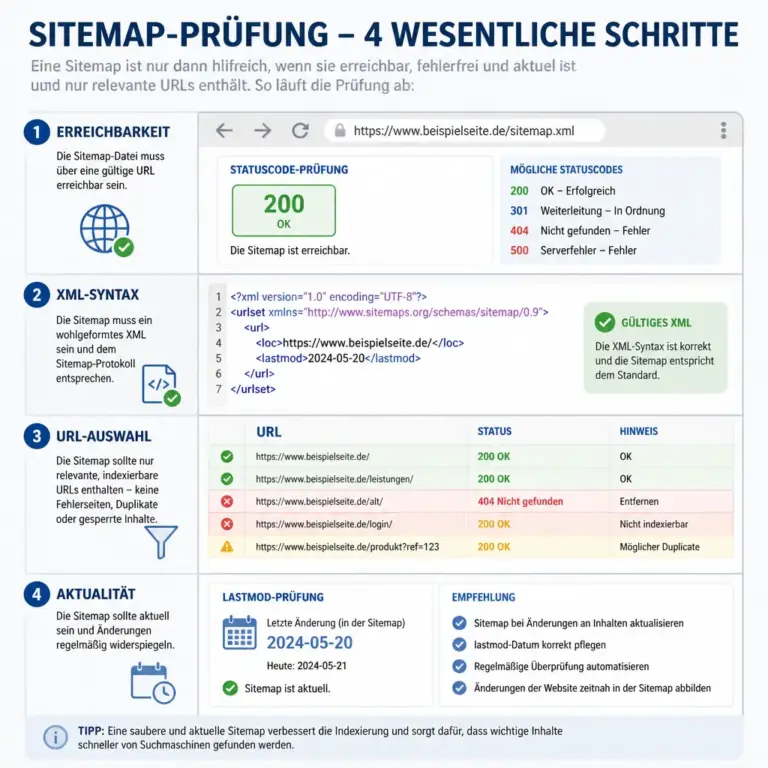
Die XML-Sitemap sollte vor allem die URLs enthalten, die Sie als relevante, kanonische und grundsätzlich indexierbare Seiten betrachten. Entfernen Sie Fehler-URLs, Weiterleitungen, doppelte Varianten und absichtlich nicht indexierbare Adressen. Eine Sitemap repariert keinen Crawling-Fehler, erleichtert aber die Kontrolle über die gewünschte URL-Menge.
Vergleichen Sie regelmäßig drei Mengen: URLs in der Sitemap, intern stark verlinkte URLs und URLs mit tatsächlichen Crawling- oder Indexierungsproblemen. Große Überschneidungen können Hinweise auf ein strukturelles Problem liefern.
Welche Werkzeuge bei der Fehlersuche helfen
Sie benötigen nicht zwingend eine große Sammlung von Tools. Wichtiger ist, dass jedes Werkzeug eine konkrete Frage beantwortet.
- Suchmaschinen-Tools: Sie zeigen bekannte Crawling-, Indexierungs- und Sitemapsignale und erlauben bei vielen Systemen eine Prüfung einzelner URLs.
- HTTP-Header-Prüfer: Sie machen Statuscodes, Weiterleitungen und Antwortketten sichtbar.
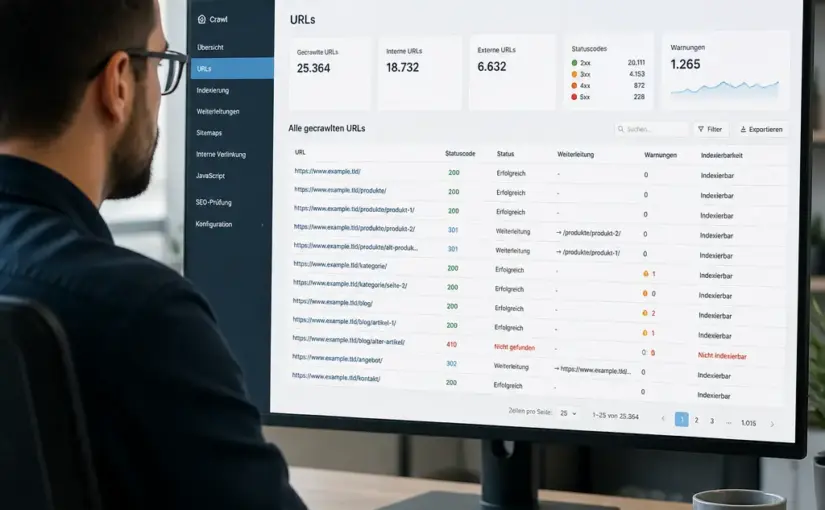
- Crawler für die eigene Website: Sie finden interne 404-Links, Weiterleitungsketten, Canonical-Abweichungen und blockierte Ressourcen in größerem Umfang.
- Server- und Anwendungsprotokolle: Sie zeigen, welche Anfragen tatsächlich ankamen und ob dabei Fehler, Zeitüberschreitungen oder Sicherheitsblockaden auftraten.
- Browser-Entwicklerwerkzeuge: Sie helfen, fehlende Ressourcen, Skriptfehler und Ladeprobleme aus Sicht eines normalen Abrufs zu untersuchen.
Dokumentieren Sie bei jeder Prüfung URL, Datum, Status, Ursache, Maßnahme und Ergebnis der Nachkontrolle. So erkennen Sie wiederkehrende Muster und vermeiden, denselben Fehler mehrfach zu untersuchen.
Was nach der Behebung wichtig ist
Nach einer technischen Änderung ist der Fehler nicht automatisch aus allen Berichten verschwunden. Prüfen Sie zunächst live, ob die URL jetzt die gewünschte Antwort liefert. Kontrollieren Sie anschließend Weiterleitung, Canonical, Robots-Meta, interne Links und Sitemap.
Bei einer wichtigen URL kann eine erneute Prüfung über das zuständige Suchmaschinenwerkzeug sinnvoll sein. Danach braucht die Verarbeitung Zeit. Eine sofortige Änderung der Sichtbarkeit ist nicht garantiert und sollte nicht mit einem technischen Fehler verwechselt werden.
Beobachten Sie die betroffene URL und ähnliche URLs über einen angemessenen Zeitraum. Treten neue Fehler auf, vergleichen Sie sie mit den letzten Änderungen an Templates, Plugins, Serverregeln oder URL-Strukturen. Ein kleines Änderungsprotokoll erleichtert die Ursachenanalyse erheblich.
FAQ
Was ist der schnellste Weg, Crawling-Fehler zu erkennen?
Beginnen Sie mit dem Bericht Ihres Suchmaschinen-Tools und prüfen Sie anschließend wichtige URLs live. Kontrollieren Sie Statuscode, Weiterleitungen, robots.txt, Robots-Meta, Canonical und interne Verlinkung. Diese Reihenfolge trennt schnell zwischen Serverproblem, Blockierung und fehlender Indexierbarkeit.
Ist jeder 404-Fehler schlecht für SEO?
Nein. Ein 404-Status kann korrekt sein, wenn eine URL dauerhaft entfernt wurde und keine passende Ersatzseite existiert. Problematisch wird der Fehler, wenn eine wichtige Seite versehentlich gelöscht wurde, viele interne Links darauf zeigen oder eine relevante Ersatzseite fehlt.
Was ist der Unterschied zwischen robots.txt und noindex?
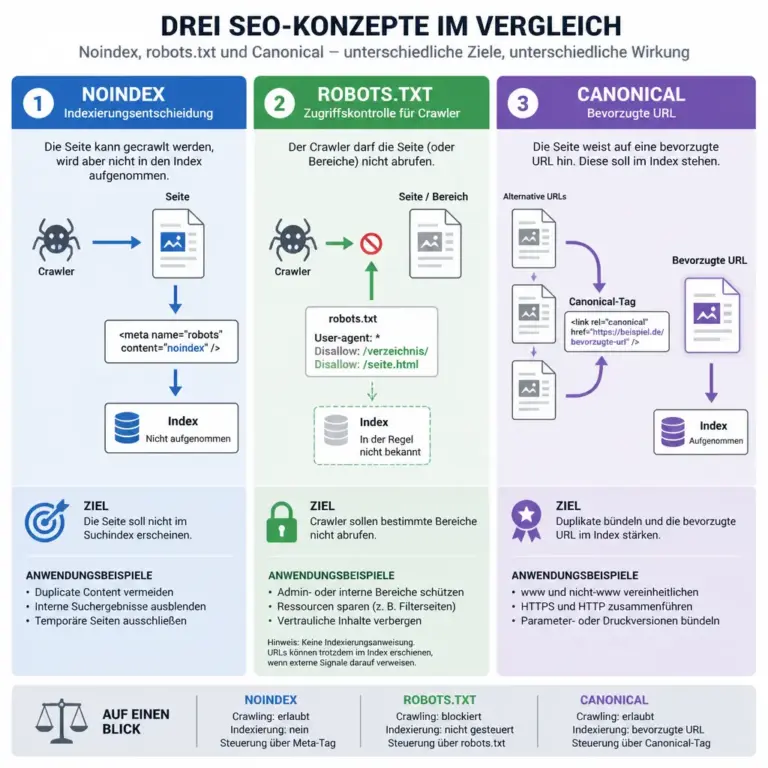
robots.txt steuert vor allem, ob ein Bot einen Pfad abrufen darf. noindex ist ein Signal zur Nichtaufnahme in den Index, das der Bot beim Abruf der Seite verarbeiten muss. Die beiden Mechanismen erfüllen daher unterschiedliche Aufgaben und sollten nicht widersprüchlich eingesetzt werden.
Warum wird eine Seite mit Statuscode 200 trotzdem nicht indexiert?
Ein erfolgreicher Abruf ist nur eine technische Voraussetzung. Die Seite kann dennoch ein noindex enthalten, auf eine andere Canonical-URL verweisen, sehr ähnliche Inhalte haben oder aus Sicht der Suchmaschine nicht ausreichend eigenständig sein. Prüfen Sie deshalb neben dem Statuscode alle Indexierungssignale und den tatsächlichen Inhalt.
Wie oft sollte ich Crawling-Fehler prüfen?
Die passende Frequenz hängt von Größe und Änderungsrate der Website ab. Wichtige Websites sollten nach Relaunches, URL-Änderungen, Serverumstellungen und größeren Plugin- oder Template-Updates gezielt geprüft werden. Zusätzlich ist eine regelmäßige Kontrolle sinnvoll, damit schleichende Fehler nicht unbemerkt bleiben.
Kann ein SEO-Plugin alle Crawling-Fehler beheben?
Ein Plugin kann bestimmte Metadaten, Sitemaps oder Weiterleitungen verwalten. Serverfehler, DNS-Probleme, Sicherheitsblockaden und fehlerhafte Anwendungslogik liegen jedoch oft außerhalb seines Zuständigkeitsbereichs. Verwenden Sie Plugins als Teil der Prüfung, nicht als Ersatz für eine vollständige technische Analyse.
Wann sollte ich den Hosting-Anbieter oder die Entwicklung einbeziehen?
Das ist sinnvoll, wenn Serverfehler wiederkehren, die Antwortzeiten stark schwanken, Sicherheitsregeln legitime Abrufe blockieren oder die Ursache in Server-, Datenbank- oder Anwendungseinstellungen liegt. Stellen Sie möglichst konkrete Informationen bereit: URL, Zeitpunkt, Statuscode, Anfrageverlauf und beobachtete Fehlermeldung.
Fazit: Crawling-Fehler schnell erkennen und sinnvoll beheben
Crawling-Fehler lassen sich am zuverlässigsten erkennen, wenn Sie nicht nur einzelne Meldungen betrachten, sondern URL, Statuscode, Blockierungen, Weiterleitungen, interne Links und Sitemap gemeinsam bewerten. Priorisieren Sie wichtige Seiten, unterscheiden Sie beabsichtigte von unbeabsichtigten Zuständen und prüfen Sie Änderungen anschließend live.
Eine klare Dokumentation macht die Fehlersuche schneller und hilft, wiederkehrende Ursachen zu finden. So wird aus einer unübersichtlichen Liste technischer Warnungen eine überschaubare Arbeitsroutine, die die Erreichbarkeit und Wartbarkeit Ihrer Website langfristig verbessert.