Technische SEO-Fehler vermeiden: Der umfassende Ratgeber für stabile Rankings

Technische SEO-Fehler können dazu führen, dass gut recherchierte Inhalte nur eingeschränkt gefunden, falsch verstanden oder gar nicht indexiert werden. Dabei sind nicht ausschließlich große Relaunches oder komplexe Serverprobleme kritisch. Häufig entstehen Schwierigkeiten durch kleine Einstellungen: eine versehentlich gesetzte noindex-Direktive, fehlerhafte Canonicals, langsame Vorlagen oder interne Links, die ins Leere führen.

Dieser Ratgeber zeigt, wie Sie technische SEO-Fehler vermeiden, Probleme systematisch priorisieren und technische Qualität dauerhaft in Ihren Website-Prozess integrieren. Der Schwerpunkt liegt auf nachvollziehbaren Prüfungen, klaren Entscheidungskriterien und Maßnahmen, die sich auf Websites unterschiedlicher Größe übertragen lassen.

Was technische SEO leisten soll
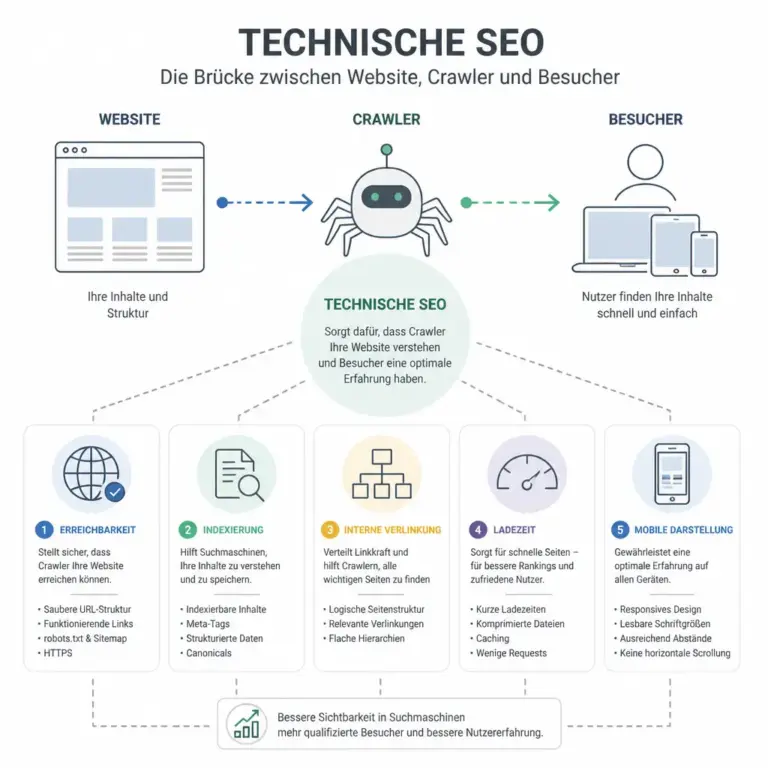
Infografik zu den wichtigsten Aufgaben der technischen SEO
Technische SEO verbindet Erreichbarkeit, Indexierung und Nutzerfreundlichkeit.

Die Grafik zeigt, dass technische SEO mehrere Grundlagen gleichzeitig abdeckt. Leser erkennen auf einen Blick, warum eine Website nicht nur schnell, sondern auch crawlbar und logisch strukturiert sein muss.

Technische Suchmaschinenoptimierung schafft die Voraussetzungen dafür, dass Suchmaschinen eine Website effizient crawlen, relevante Inhalte korrekt interpretieren und geeignete Seiten in den Suchindex aufnehmen können. Sie ersetzt keine hilfreichen Inhalte, sondern unterstützt deren Auffindbarkeit und Nutzbarkeit.

Zu den technischen Grundlagen gehören unter anderem:

  • eine erreichbare und logisch strukturierte Website,
  • eindeutige Statuscodes und funktionierende Weiterleitungen,
  • eine kontrollierbare interne Verlinkung,
  • korrekte Indexierungs- und Canonical-Signale,
  • gute Ladezeiten und eine stabile Darstellung,
  • eine verständliche URL- und Seitenstruktur sowie
  • eine zuverlässige Auslieferung auf mobilen Geräten.

Technische SEO ist deshalb weniger eine einmalige Checkliste als ein Kontrollsystem. Änderungen an Templates, Plugins, Servern, Tracking-Lösungen oder redaktionellen Abläufen können technische Signale jederzeit verändern. Ein gutes Vorgehen prüft nicht nur, ob ein Problem existiert, sondern auch, welche Seiten, Nutzer und Geschäftsziele davon betroffen sind.

Die häufigsten technischen SEO-Fehler

Fehlerhafte Indexierungssteuerung

Eine Seite kann inhaltlich hochwertig sein und trotzdem nicht in Suchmaschinen erscheinen, wenn sie versehentlich von der Indexierung ausgeschlossen wird. Typische Ursachen sind ein noindex-Meta-Tag, ein entsprechender HTTP-Header oder eine falsche Einstellung im Content-Management-System. Auch Passwortschutz, Wartungsmodi und Umgebungen wie Staging-Server können den Zugriff verhindern.

Prüfen Sie wichtige Vorlagen und nicht nur einzelne Beispielseiten. Kontrollieren Sie insbesondere Startseite, Kategorieseiten, Produkt- oder Leistungsseiten, Beiträge und paginierte Ansichten. Die robots.txt-Datei kann das Crawling bestimmter Bereiche einschränken, verhindert aber nicht in jedem Fall die Indexierung bereits bekannter URLs. Sie sollte daher nicht als Ersatz für ein bewusst gesetztes Indexierungssignal verstanden werden.

Unklare oder widersprüchliche Canonical-Signale

Das Canonical-Element hilft dabei, bei ähnlichen oder mehrfach erreichbaren Inhalten eine bevorzugte URL anzugeben. Es ist jedoch keine Garantie, dass Suchmaschinen dieser Empfehlung folgen. Problematisch wird es, wenn Canonicals auf nicht erreichbare Seiten, irrelevante Zielseiten oder URLs mit abweichendem Inhalt zeigen.

Eine sinnvolle Canonical-Prüfung beantwortet mindestens vier Fragen: Ist die Ziel-URL erreichbar? Ist sie indexierbar? Entspricht ihr Inhalt der geprüften Seite? Und passt sie zur gewünschten Informationsarchitektur? Bei einer eindeutig eigenständigen Seite ist häufig ein selbstreferenzielles Canonical die klarere Lösung als eine pauschale Zusammenfassung vieler URLs.

Fehlerhafte Statuscodes und Weiterleitungen

Ein Statuscode beschreibt, was mit einer URL passiert. Ein erfolgreicher Inhalt wird typischerweise mit 200 ausgeliefert, eine dauerhaft verschobene Seite mit 301 oder 308, eine temporäre Verschiebung mit einem passenden temporären Statuscode. Nicht gefundene Inhalte sollten nicht automatisch auf die Startseite umgeleitet werden, weil dadurch die ursprüngliche Suchintention verloren gehen kann.

Vermeiden Sie Weiterleitungsketten und -schleifen. Eine Kette entsteht, wenn URL A auf B, B auf C und C erst auf das endgültige Ziel verweist. Besser ist eine direkte Weiterleitung von der alten URL auf die aktuelle Zielseite. Nach Domainwechseln, HTTPS-Umstellungen, URL-Anpassungen und Migrationen lohnt sich eine vollständige Prüfung der alten, wichtigen Adressen.

Kaputte interne und externe Links

Interne Links helfen Suchmaschinen und Besuchern, Zusammenhänge und Prioritäten zu verstehen. Verlinkungen auf nicht vorhandene Seiten, blockierte Ressourcen oder falsche Varianten erzeugen dagegen Reibung. Externe Links sollten ebenfalls regelmäßig auf Erreichbarkeit und inhaltliche Passung geprüft werden, besonders wenn sie für eine Erklärung oder Entscheidung wesentlich sind.

Ein Fehlerbericht allein reicht nicht immer aus. Bewerten Sie, ob eine defekte URL aus einem zentralen Navigationsbereich, aus vielen Beiträgen oder nur aus einer alten Randseite verlinkt wird. Reparieren Sie zuerst Links mit hoher Sichtbarkeit und ersetzen Sie veraltete Ziele durch thematisch passende, tatsächlich erreichbare Seiten.

Duplikate durch URL-Varianten

Ein Inhalt kann über verschiedene URLs erreichbar sein, etwa durch Groß- und Kleinschreibung, Parameter, alternative Pfade, Druckansichten oder unterschiedliche Protokolle. Nicht jede Variante ist automatisch ein Problem. Kritisch wird es, wenn Suchmaschinen viele nahezu identische URLs crawlen müssen oder wenn interne Links uneinheitlich auf mehrere Varianten zeigen.

Definieren Sie eine bevorzugte URL-Struktur und verwenden Sie sie konsequent in Navigation, Canonicals, XML-Sitemap und strukturierten Daten. Parameter sollten nur dann indexierbar sein, wenn sie eigenständigen, suchrelevanten Inhalt erzeugen. Andernfalls sind eine geeignete technische Steuerung und eine konsistente interne Verlinkung wichtig.

Technische SEO-Fehler systematisch prüfen

Eine gute Prüfung beginnt nicht mit einer langen Liste zufälliger Einzelprobleme, sondern mit einem klaren Untersuchungsrahmen. Legen Sie zunächst fest, welche Websitebereiche, Gerätetypen und Seitentypen betrachtet werden. Eine kleine Unternehmensseite benötigt andere Kontrollroutinen als ein umfangreicher Shop mit facettierten Filtern.

1. Die wichtigsten Seitentypen erfassen

Erstellen Sie eine Übersicht der URL-Muster und Vorlagen. Dazu gehören beispielsweise Startseite, Übersichtsseiten, Detailseiten, redaktionelle Beiträge, Suchergebnisse, Filterseiten, Login-Bereiche und Fehlerseiten. Wählen Sie aus jedem relevanten Typ mehrere Beispiele und prüfen Sie sie manuell. So lassen sich Template-Fehler erkennen, bevor sie auf hunderten Seiten auftreten.

2. Indexierbarkeit und Erreichbarkeit trennen

Eine URL kann im Browser erreichbar sein und dennoch für Suchmaschinen ausgeschlossen werden. Prüfen Sie deshalb getrennt:

  • Antwortet der Server mit einem passenden Statuscode?
  • Kann ein Crawler die URL ohne unnötige Hürden abrufen?
  • Gibt es noindex– oder andere Ausschlusssignale?
  • Verweist das Canonical auf ein plausibles Ziel?
  • Ist die URL in der XML-Sitemap enthalten, falls sie indexiert werden soll?
  • Wird sie von wichtigen internen Seiten aus verlinkt?

Abweichungen zwischen diesen Signalen sind ein Hinweis auf Abstimmungsbedarf. Eine Sitemap sollte keine Seiten enthalten, die absichtlich nicht indexiert werden sollen. Umgekehrt sollten wichtige, indexierbare Seiten nicht ausschließlich über schwer erreichbare Pfade verfügbar sein.

3. Mit repräsentativen Stichproben arbeiten

Vollständige Crawls sind nützlich, aber nicht jede Meldung hat dieselbe Bedeutung. Gruppieren Sie Ergebnisse nach Fehlerart und URL-Muster. Prüfen Sie anschließend eine Auswahl von Seiten manuell, um den technischen Kontext zu verstehen. Ein automatischer Bericht kann beispielsweise eine fehlende Überschrift oder ein vermeintliches Duplikat melden, obwohl die Vorlage in diesem konkreten Fall bewusst anders aufgebaut ist.

Dokumentieren Sie für jedes Problem die betroffenen Vorlagen, die vermutete Ursache, das Risiko, die verantwortliche Person oder Abteilung und die geplante Kontrolle nach der Umsetzung. Diese Dokumentation verhindert, dass identische Fehler bei späteren Änderungen erneut auftreten.

Wichtige Prüfbereiche im Detail

Interne Verlinkung und Informationsarchitektur

Eine klare Website-Struktur erleichtert die Orientierung. Wichtige Inhalte sollten aus relevanten Übersichts- oder Themenseiten erreichbar sein und nicht nur über eine interne Suche. Verwenden Sie verständliche Linktexte, die das Ziel beschreiben, ohne künstlich Suchbegriffe zu wiederholen.

Überprüfen Sie besonders verwaiste Seiten, also URLs ohne eingehende interne Links. Sie können zwar über externe Verweise oder eine Sitemap gefunden werden, sind aber für Besucher und Crawler schwerer einzuordnen. Prüfen Sie außerdem, ob wichtige Seiten unnötig tief in der Navigation liegen und ob sich thematisch verwandte Inhalte sinnvoll gegenseitig ergänzen.

XML-Sitemap und robots.txt

Die XML-Sitemap sollte eine aktuelle Auswahl der URLs enthalten, die für die Indexierung relevant sind. Entfernen Sie Weiterleitungen, Fehlerseiten, nicht kanonische Varianten und bewusst ausgeschlossene Inhalte. Wenn das System Änderungsdaten ausgibt, sollten diese die tatsächliche inhaltliche Überarbeitung widerspiegeln und nicht bei jedem Abruf pauschal aktualisiert werden.

Die robots.txt-Datei sollte übersichtlich bleiben. Eine zu breite Sperre kann wichtige Ressourcen oder ganze Bereiche unzugänglich machen. Eine zu offene Konfiguration ist nicht automatisch schlecht, kann aber bei großen Websites unnötige Crawl-Last verursachen. Änderungen an dieser Datei gehören deshalb in einen kontrollierten Freigabeprozess.

Mobile Darstellung und Core-Web-Vitals-relevante Faktoren

Technische Qualität zeigt sich auch in der Nutzung auf mobilen Geräten. Achten Sie auf Inhalte, die außerhalb des sichtbaren Bereichs liegen, zu kleine Bedienelemente, horizontales Scrollen und Layoutverschiebungen. Bilder, Schriftarten, Skripte und externe Dienste können die Ladezeit beeinflussen. Nicht jede Optimierung muss sofort umgesetzt werden; entscheidend ist eine Priorisierung nach betroffenen Vorlagen und tatsächlichem Nutzungskontext.

Reduzieren Sie unnötige Ressourcen, komprimieren Sie geeignete Bilder und laden Sie nicht benötigte Inhalte möglichst erst bei Bedarf. Prüfen Sie nach Änderungen nicht nur eine einzelne Startseite, sondern verschiedene Seitentypen unter realistischen Bedingungen. Eine schnelle Vorlage kann durch ein zusätzliches Plugin oder ein neues Tracking-Element wieder deutlich schwerer werden.

Strukturierte Daten

Strukturierte Daten können Suchmaschinen helfen, Inhalte einzuordnen. Sie müssen jedoch den sichtbaren Inhalt korrekt beschreiben und vollständig genug für den jeweiligen Anwendungsfall sein. Falsche Auszeichnungen, erfundene Bewertungen oder Angaben, die auf der Seite nicht nachvollziehbar sind, schaffen kein vertrauenswürdiges Signal.

Prüfen Sie nach Änderungen an Templates, ob strukturierte Daten weiterhin gültig sind. Achten Sie auf Pflichtfelder, passende Datentypen und konsistente URLs. Strukturierte Daten sollten niemals genutzt werden, um Inhalte zu behaupten, die Besucher nicht vorfinden.

Priorisierung: Welche Fehler zuerst behoben werden sollten

Nicht jeder technische Mangel benötigt sofort dieselbe Aufmerksamkeit. Priorisieren Sie nach vier Kriterien: Reichweite, Auswirkung, Behebbarkeit und Risiko. Ein noindex auf allen wichtigen Leistungsseiten hat eine andere Dringlichkeit als ein einzelner veralteter Link in einem alten Beitrag.

Priorität Typisches Beispiel Empfohlene Reaktion
Sehr hoch Wichtige Seiten sind ausgeschlossen oder nicht erreichbar. Ursache sofort prüfen, Änderung kontrolliert umsetzen und erneut validieren.
Hoch Falsche Weiterleitungen, Canonicals oder zentrale Sitemap-Fehler. Betroffene Vorlagen und wichtige URLs priorisiert korrigieren.
Mittel Interne Linklücken, einzelne defekte Ressourcen oder uneinheitliche Varianten. Nach Reichweite bündeln und in einem festen Sprint beheben.
Niedrig Technische Hinweise ohne erkennbare Auswirkung auf wichtige Inhalte. Beobachten, dokumentieren und bei passenden Änderungen bearbeiten.

Behalten Sie nach einer Korrektur die Ausgangssituation und das erwartete Ergebnis fest. So lässt sich später feststellen, ob die Maßnahme die Ursache tatsächlich behoben hat oder nur eine Fehlermeldung verschwunden ist.

Technische SEO bei Migrationen und Relaunches

Relaunches gehören zu den risikoreichsten Situationen für technische SEO. Neue Templates, veränderte URLs, andere Systeme und neue Hosting-Umgebungen können gleichzeitig zahlreiche Signale verändern. Erstellen Sie deshalb vor dem Relaunch eine Bestandsaufnahme der wichtigen URLs, der aktuellen Weiterleitungen, der Indexierungsregeln, der Sitemap und der internen Linkstruktur.

Testen Sie die neue Umgebung möglichst mit realistischen Daten, bevor sie öffentlich erreichbar ist. Prüfen Sie dort Vorlagen, Canonicals, Statuscodes, mobile Darstellung, strukturierte Daten und Ressourcen. Nach dem Go-live sollten Sie zunächst die wichtigsten Seiten und anschließend die gesamte Umleitungsmatrix kontrollieren. Beobachten Sie außerdem, ob Fehlerraten, Crawling-Muster oder die Erreichbarkeit zentraler Inhalte auffällig abweichen.

Ein häufiger Fehler ist, die alte Website zu früh abzuschalten. Halten Sie benötigte Weiterleitungsinformationen und eine vollständige URL-Liste bereit, damit alte Verweise nicht verloren gehen. Entfernen Sie Weiterleitungen erst, wenn klar ist, dass sie nicht mehr benötigt werden und keine wertvollen Zugriffe oder Verweise auf sie zeigen.

Prozesse, mit denen Sie technische SEO-Fehler vermeiden

Nachhaltige Qualität entsteht durch Zuständigkeiten und wiederholbare Abläufe. Legen Sie fest, wer technische Änderungen prüft, wer Freigaben erteilt und wo Ergebnisse dokumentiert werden. Redaktion, Entwicklung, Marketing und Hosting sollten bei größeren Änderungen frühzeitig eingebunden werden.

  • Nutzen Sie eine Checkliste für neue Seitentypen und Templates.
  • Prüfen Sie Weiterleitungen und Indexierung vor jeder Migration.
  • Führen Sie nach Releases eine kurze technische Abnahme durch.
  • Überwachen Sie zentrale Fehlergruppen regelmäßig statt nur einmalig.
  • Dokumentieren Sie Ausnahmen, damit bewusste Entscheidungen nicht als Fehler behandelt werden.
  • Planen Sie eine Rückfalloption, wenn eine Änderung unerwartete Auswirkungen hat.

Automatisierung kann wiederkehrende Prüfungen unterstützen, ersetzt aber keine fachliche Bewertung. Warnungen müssen in ihrem Kontext beurteilt werden. Umgekehrt sollten manuelle Prüfungen dort stattfinden, wo eine falsche technische Entscheidung besonders weitreichende Folgen hätte.

FAQ

Wie oft sollte eine Website technisch geprüft werden?

Die passende Frequenz hängt von Größe, Änderungsrate und Geschäftsrelevanz der Website ab. Regelmäßige automatische Kontrollen können zwischen größeren manuellen Prüfungen stehen. Nach Relaunches, Plugin-Updates, Domainänderungen oder strukturellen Anpassungen ist eine zusätzliche Prüfung sinnvoll.

Kann ein SEO-Crawler alle technischen Fehler finden?

Nein. Crawler erkennen viele wiederkehrende Muster, aber nicht jede inhaltliche oder geschäftliche Fehlentscheidung. Sie können beispielsweise einen Statuscode melden, jedoch nicht zuverlässig beurteilen, ob eine Weiterleitung zur Suchintention passt. Automatische Ergebnisse sollten deshalb mit manuellen Stichproben und Kenntnis der Website ergänzt werden.

Ist jede doppelte URL ein Problem?

Nicht zwingend. Mehrere URLs können technisch notwendig oder vorübergehend unkritisch sein. Problematisch wird es, wenn dadurch wichtige Signale widersprüchlich werden, unnötige Crawl-Ressourcen gebunden werden oder Besucher zwischen Varianten wechseln. Entscheidend sind Umfang, interne Verlinkung, Indexierungsabsicht und inhaltliche Unterschiede.

Was ist wichtiger: Ladezeit oder Indexierung?

Beides erfüllt eine andere Funktion. Wenn wichtige Inhalte nicht erreichbar oder von der Indexierung ausgeschlossen sind, sollte dieses Problem zuerst behoben werden. Danach lohnt es sich, Geschwindigkeit und Stabilität zu verbessern, weil sie die Nutzung und die technische Zugänglichkeit unterstützen.

Sollten alle nicht relevanten Seiten auf die Startseite weiterleiten?

In der Regel nicht. Eine Weiterleitung ist sinnvoll, wenn eine nachvollziehbare neue Zielseite existiert. Fehlt ein passendes Ziel, kann eine sauber gestaltete Fehlerseite hilfreicher sein als eine pauschale Weiterleitung, die den ursprünglichen Inhalt nicht ersetzt.

Wie wichtig ist die robots.txt-Datei?

Sie kann das Crawling steuern, darf aber nicht als alleinige Indexierungsstrategie dienen. Eine falsche Regel kann wichtige Inhalte oder Ressourcen sperren. Änderungen sollten daher getestet und mit den übrigen Signalen wie Canonicals, Meta-Direktiven und Sitemap abgestimmt werden.

Was sollte nach einer technischen Korrektur geprüft werden?

Prüfen Sie, ob die konkrete Ursache behoben wurde, ob die Änderung auf alle betroffenen Vorlagen wirkt und ob keine neuen Probleme entstanden sind. Kontrollieren Sie außerdem Statuscode, Indexierung, Canonical, interne Links und Darstellung der wichtigsten Beispielseiten.

Fazit: Technische SEO als laufende Qualitätsaufgabe

Technische SEO-Fehler vermeiden bedeutet nicht, jede Warnung dauerhaft auf null zu bringen. Entscheidend ist, wichtige Inhalte zuverlässig erreichbar, verständlich strukturiert und technisch konsistent auszuliefern. Beginnen Sie mit Indexierung, Statuscodes, Canonicals, Weiterleitungen und internen Links. Ergänzen Sie diese Grundlagen um mobile Qualität, strukturierte Daten, Sitemaps und regelmäßige Prozesskontrollen.

Wer technische Prüfungen in Releases, Migrationen und redaktionelle Abläufe integriert, erkennt Probleme früher und kann sie nach ihrer tatsächlichen Auswirkung priorisieren. So wird technische SEO zu einer verlässlichen Grundlage für Nutzerfreundlichkeit, Auffindbarkeit und langfristige Website-Qualität.
Canonical oder Noindex? Der praktische SEO-Ratgeber zur richtigen Entscheidung

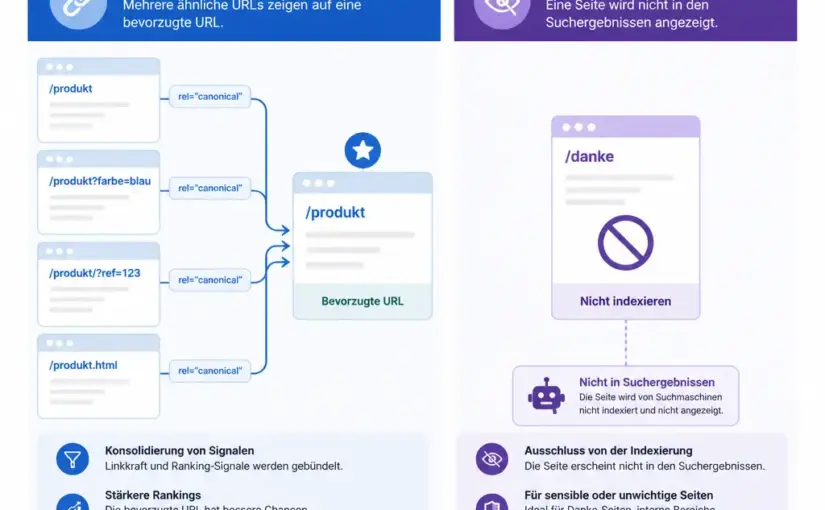
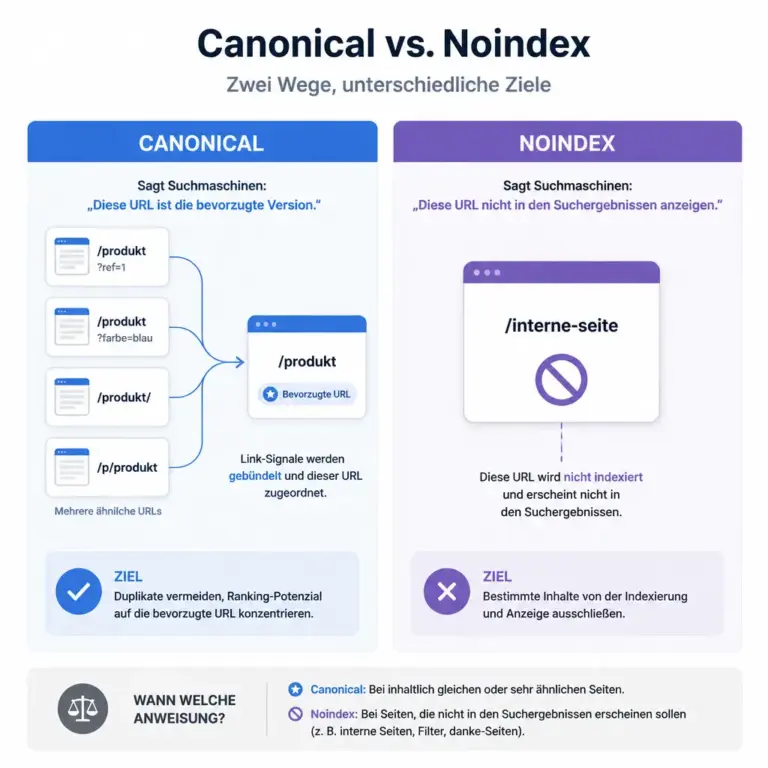
Canonical oder Noindex? Beide Signale helfen dabei, Suchmaschinen bei der Bewertung ähnlicher oder unerwünschter URLs zu unterstützen. Sie verfolgen jedoch unterschiedliche Ziele: Ein Canonical weist auf die bevorzugte Version mehrerer ähnlicher Seiten hin, während noindex verhindern soll, dass eine konkrete Seite in den Suchergebnissen erscheint. Die falsche Wahl kann dazu führen, dass wichtige Inhalte aus dem Index verschwinden oder doppelte URLs weiterhin unnötige Aufmerksamkeit erhalten.

Dieser Ratgeber erklärt die Unterschiede, zeigt typische Anwendungsfälle und bietet eine praktische Entscheidungshilfe für Websites, Onlineshops, Blogs und technische Plattformen. Dabei gilt: Keine der beiden Maßnahmen ersetzt eine saubere Informationsarchitektur, verständliche Inhalte und eine sorgfältige technische Prüfung.

Was bedeuten Canonical und Noindex?

Canonical und Noindex sind zwei verschiedene Steuerungssignale für Suchmaschinen. Sie werden häufig gemeinsam genannt, weil beide bei ähnlichen, doppelten oder nicht gewünschten URLs zum Einsatz kommen können. Inhaltlich sind sie aber nicht austauschbar.

Canonical: Welche URL ist die bevorzugte Version?

Mit einem Canonical-Link wird eine bevorzugte URL für inhaltlich gleiche oder sehr ähnliche Seiten angegeben. Das Signal lautet sinngemäß: „Von mehreren erreichbaren Varianten ist diese URL die wichtigste Version.“

Ein Canonical wird im <head> einer HTML-Seite eingebunden:

<link rel="canonical" href="https://www.beispiel.de/ratgeber/canonical-noindex">

In vielen Fällen verweist eine Seite auf sich selbst. Das wird als selbstreferenzierendes Canonical bezeichnet. Bei URL-Varianten kann eine alternative Seite hingegen auf eine andere, bevorzugte URL verweisen. Suchmaschinen können dieses Signal bei der Auswahl der indexierten und in Suchergebnissen angezeigten URL berücksichtigen.

Wichtig ist die Formulierung „Signal“: Ein Canonical ist keine absolute Anweisung. Suchmaschinen prüfen zusätzlich den Inhalt, interne Verlinkungen, Weiterleitungen, Sitemap-Einträge und weitere technische Hinweise. Ein Canonical sollte daher zu den übrigen Signalen der Website passen.

Noindex: Diese konkrete URL soll nicht in den Suchergebnissen erscheinen

noindex ist eine Anweisung beziehungsweise ein starkes Robots-Meta-Signal, eine bestimmte Seite nicht in den Suchindex aufzunehmen oder dort wieder zu entfernen. Die Seite kann weiterhin erreichbar sein und von Nutzern verwendet werden.

Typischerweise wird das Signal so im <head> hinterlegt:

<meta name="robots" content="noindex, follow">

Die häufig verwendete Kombination noindex, follow bedeutet: Die Seite selbst soll nicht in den Suchergebnissen erscheinen; Links auf der Seite dürfen grundsätzlich weiterhin entdeckt und verfolgt werden. Das follow ist meist nicht notwendig, weil Suchmaschinen Links auch ohne diese ausdrückliche Angabe verarbeiten können. Entscheidend ist der Teil noindex.

Damit Suchmaschinen das Meta-Tag sehen können, darf die URL nicht durch die robots.txt vom Crawling ausgeschlossen sein. Eine blockierte URL kann das enthaltene Noindex-Signal unter Umständen nicht zuverlässig übermitteln.

Der wichtigste Unterschied zwischen Canonical und Noindex

Infografik zum Unterschied zwischen Canonical und Noindex 1
Frage Canonical Noindex
Was wird gesteuert? Die bevorzugte URL innerhalb ähnlicher Versionen Die Aufnahme einer konkreten URL in den Suchindex
Bleibt die Seite erreichbar? Ja Ja, sofern keine andere Zugriffsbeschränkung besteht
Wird die Seite aus dem Index entfernt? Nicht zwingend Das ist das Ziel des Signals
Wofür ist es besonders geeignet? Duplikate und URL-Varianten mit einem bevorzugten Original Interne Seiten, dünne Inhalte oder nicht suchrelevante Bereiche
Was passiert mit Linksignalen? Signale können der bevorzugten URL zugeordnet werden Die Seite wird nicht als Suchergebnis gewünscht; die interne Verlinkung bleibt gesondert zu bewerten

Die Kurzform lautet: Canonical bündelt ähnliche Varianten auf eine bevorzugte URL, Noindex schließt eine konkrete URL aus den Suchergebnissen aus. Diese Kurzform hilft bei der ersten Einordnung, ersetzt aber nicht die Prüfung des jeweiligen Seitentyps.

Canonical oder Noindex: Eine praktische Entscheidungshilfe

Bevor eine technische Maßnahme gesetzt wird, sollte die eigentliche Absicht klar sein. Stelle dir nacheinander diese Fragen:

  1. Existiert eine andere URL mit demselben oder nahezu demselben Inhalt? Wenn ja, kann ein Canonical auf die bevorzugte Version passen.
  2. Soll die konkrete URL grundsätzlich nicht in der Suche erscheinen? Dann ist Noindex meist das passendere Signal.
  3. Hat die Seite einen eigenständigen Nutzen für Suchende? Wenn der Inhalt eine eigene Suchintention vollständig beantwortet, sollte er nicht vorschnell auf eine andere URL kanonisiert oder auf Noindex gesetzt werden.
  4. Ist die Seite nur eine technische oder funktionale Variante? Filter-, Sortier-, Warenkorb- oder interne Suchseiten benötigen oft eine andere Behandlung als redaktionelle Landingpages.
  5. Kann die bevorzugte Ziel-URL gecrawlt und indexiert werden? Ein Canonical auf eine blockierte, weitergeleitete oder ebenfalls nicht indexierbare URL ist häufig widersprüchlich.

Eine einfache Entscheidungsregel lautet: Gibt es ein sichtbares, eigenständiges Suchergebnisziel, sollte die Seite zunächst als mögliche Indexierungsseite betrachtet werden. Gibt es dagegen mehrere nahezu gleiche URLs und nur eine soll als Hauptversion dienen, ist ein Canonical naheliegend. Soll keine der Varianten in den Suchergebnissen auftauchen, reicht ein Canonical allein nicht aus; dann muss die Indexierungsabsicht ausdrücklich geprüft werden.

Typische Anwendungsfälle für ein Canonical

URL-Parameter für Tracking

Eine redaktionelle Seite kann durch Tracking-Parameter in mehreren URL-Varianten erreichbar sein, etwa durch Kampagnen- oder Analyseparameter. Wenn der Seiteninhalt gleich bleibt und die Parameter keine eigene Suchintention abbilden, kann die saubere Haupt-URL als Canonical angegeben werden.

Zusätzlich sollten interne Links möglichst direkt auf die bevorzugte URL zeigen. Das Canonical ist kein Ersatz für eine konsistente Verlinkung. Werden beide Varianten dauerhaft in der Website verlinkt, bleibt für Suchmaschinen und Nutzer unnötige URL-Komplexität bestehen.

Sortierung und Darstellung in einem Katalog

Ein Katalog kann dieselben Produkte oder Beiträge nach Preis, Aktualität, Farbe oder anderen Kriterien sortieren. Wenn die Sortieransichten keinen eigenständigen, suchrelevanten Inhalt bieten, kann die Hauptansicht als bevorzugte URL definiert werden.

Ob ein Canonical genügt, hängt davon ab, ob die Varianten weiterhin sinnvoll crawlbar sein sollen und ob sie für Nutzer oder externe Verweise benötigt werden. Bei umfangreichen Filterkombinationen ist eine Gesamtlösung aus URL-Konzept, interner Verlinkung, Crawl-Steuerung und gegebenenfalls Noindex oft sinnvoller als ein pauschales Signal auf jeder Variante.

Druckansicht oder alternative Layout-Version

Eine Druckansicht enthält häufig denselben Text wie die normale Seite, aber eine veränderte Darstellung. Wenn sie öffentlich erreichbar bleiben soll, jedoch nicht als eigenständiges Suchergebnis gewünscht ist, kann eine kanonische Zuordnung zur normalen Inhaltsseite geprüft werden. Bei rein funktionalen Varianten kann je nach Ziel auch Noindex angemessen sein.

Ähnliche Produkt- oder Beitragsseiten

Ein Canonical ist nicht automatisch richtig, nur weil zwei Seiten thematisch ähnlich sind. Wenn zwei Seiten unterschiedliche Fragen beantworten, verschiedene Produkte beschreiben oder jeweils einen eigenständigen Nutzen besitzen, sollten sie nicht ohne sorgfältige Prüfung zusammengelegt werden.

Bei echten Duplikaten oder nahezu identischen Varianten ist ein Canonical plausibler. Bei nur oberflächlicher Ähnlichkeit sollte stattdessen geprüft werden, ob beide Seiten durch bessere Abgrenzung, zusätzliche Informationen oder eine neue Informationsarchitektur eigenständig werden können.

Typische Anwendungsfälle für Noindex

Interne Suchergebnisse

Interne Suchseiten werden häufig automatisch aus Suchbegriffen erzeugt. Sie können für die Website-Navigation hilfreich sein, sind aber nicht grundsätzlich als öffentliche Landingpages gedacht. Wenn diese Seiten keinen kuratierten, stabilen und eigenständigen Inhalt besitzen, ist Noindex oft eine passende Option.

Warenkorb, Kasse und persönliche Bereiche

Warenkorb-, Konto-, Login- und vergleichbare Funktionsseiten richten sich an konkrete Nutzeraktionen. Sie sollen in der Regel nicht als informative Suchergebnisse gefunden werden. Hier ist Noindex meist näher an der eigentlichen Absicht als ein Canonical, weil nicht eine andere Inhaltsversion bevorzugt, sondern die Funktion aus dem Suchindex herausgehalten werden soll.

Vorläufige oder dünne Seiten

Eine noch nicht fertige Vorschauseite, ein interner Entwurf oder eine Seite mit sehr wenig eigenständigem Inhalt kann vorübergehend mit Noindex versehen werden. Vor einer späteren Veröffentlichung sollte die Maßnahme wieder entfernt und die Seite technisch wie redaktionell geprüft werden.

Mehrere Varianten ohne brauchbare Hauptversion

Manchmal existieren viele nahezu gleiche URLs, aber keine davon ist als dauerhaftes Suchergebnis sinnvoll. In diesem Fall kann ein Canonical auf eine nicht passende Seite das Problem nur verschieben. Noindex kann dann geeigneter sein, sofern die URLs weiterhin erreichbar sein müssen. Langfristig ist jedoch eine Bereinigung der URL-Erzeugung meist die robustere Lösung.

Wann Canonical und Noindex nicht einfach kombiniert werden sollten

Ein häufiges Missverständnis ist die Kombination aus Noindex und Canonical auf derselben Seite mit dem Gedanken, beide Signale würden sich gegenseitig verstärken. Das kann widersprüchlich sein: Einerseits wird die Seite als nicht indexierbar markiert, andererseits wird eine bevorzugte URL genannt. Suchmaschinen können das Canonical unter solchen Bedingungen weniger zuverlässig berücksichtigen.

Wenn eine Seite nicht im Index erscheinen soll, sollte zunächst Noindex die klare Hauptabsicht ausdrücken. Wenn mehrere indexierbare Varianten auf eine bevorzugte Version verweisen sollen, sollte das Canonical sauber und konsistent eingesetzt werden. Eine Kombination kann in speziellen technischen Szenarien sinnvoll sein, sollte aber nicht als pauschale Standardlösung verwendet werden.

Ebenso problematisch ist ein Canonical auf eine URL, die selbst noindex trägt. Die Zielseite sollte normalerweise als gültige, indexierbare Hauptversion vorgesehen sein. Widersprüchliche Signale erschweren die Verarbeitung und machen die gewünschte Indexierungslogik weniger eindeutig.

Technische Umsetzung und Qualitätskontrolle

Die korrekte Syntax ist nur der erste Schritt. Nach der Implementierung sollte geprüft werden, ob die Maßnahme tatsächlich zur URL-Strategie passt.

Checkliste für Canonical

  • Die Canonical-URL ist vollständig und verwendet das gewünschte Protokoll sowie die gewünschte Host-Version.
  • Die Ziel-URL ist erreichbar und liefert nicht dauerhaft auf eine andere Adresse weiter.
  • Die Zielseite ist nicht absichtlich mit Noindex versehen.
  • Die Zielseite enthält den gleichen oder den klar bevorzugten Inhalt.
  • Interne Links, XML-Sitemap und hreflang-Verweise widersprechen der bevorzugten URL nicht.
  • Es gibt keine unnötigen Ketten von Canonical-Verweisen.
  • Die URL verwendet eine konsistente Schreibweise, etwa bei Großschreibung, abschließendem Schrägstrich und Parametern.

Checkliste für Noindex

  • Das Robots-Meta-Tag steht in der ausgelieferten HTML-Seite oder wird zuverlässig über einen passenden HTTP-Header gesetzt.
  • Die URL ist für Suchmaschinen erreichbar, damit das Noindex-Signal gelesen werden kann.
  • Die Seite soll tatsächlich nicht als Suchergebnis erscheinen.
  • Wichtige Inhalte wurden nicht versehentlich mit Noindex versehen.
  • Die Seite wird nicht unnötig in XML-Sitemaps als indexierbare Ziel-URL geführt.
  • Interne Links verweisen nur dann prominent auf die URL, wenn sie für Nutzer weiterhin eine wichtige Funktion erfüllt.
  • Bei einer zeitlich begrenzten Maßnahme ist dokumentiert, wann die Einstellung erneut geprüft wird.

Häufige Fehler bei Canonical und Noindex

Canonical als Ersatz für eine Weiterleitung

Wenn eine alte URL dauerhaft auf eine neue URL umziehen soll und Nutzer ebenfalls automatisch weitergeleitet werden sollen, ist eine serverseitige Weiterleitung meist die passendere Lösung. Ein Canonical lässt die alte URL erreichbar und informiert vor allem Suchmaschinen über die bevorzugte Variante. Beide Maßnahmen verfolgen also nicht dasselbe Ziel.

Noindex für jede ähnliche Seite

Ähnliche Themen sind nicht automatisch doppelte Inhalte. Wer vorschnell viele Seiten auf Noindex setzt, kann wertvolle Suchintentionen und nützliche Einstiegsseiten verlieren. Vor der Entscheidung sollte geklärt werden, ob die Seite eine eigene Frage beantwortet und ob sie für Besucher einen eigenständigen Nutzen hat.

Blockierung in der robots.txt statt Noindex

Ein Crawling-Verbot und ein Noindex-Signal sind nicht gleichbedeutend. Wenn eine URL gar nicht abgerufen werden darf, kann ihr Inhalt nicht zuverlässig auf ein Meta-Tag geprüft werden. Soll eine Seite aus dem Index verschwinden, muss die technische Umsetzung diesen Unterschied berücksichtigen.

Canonical auf die Startseite

Die Startseite ist nicht automatisch die passende Sammelstelle für fehlerhafte, dünne oder doppelte URLs. Ein Canonical sollte auf die inhaltlich passende Hauptversion zeigen. Ist keine solche Version vorhanden, sind eine Überarbeitung, eine Weiterleitung oder Noindex möglicherweise sinnvoller.

Nach der Veröffentlichung nicht kontrollieren

CMS, Plugins, Shopsysteme und Templates können Canonical- oder Noindex-Angaben automatisch erzeugen. Nach Änderungen sollten deshalb nicht nur die Einstellungen im Backend, sondern auch der tatsächlich ausgelieferte Quelltext und die betroffenen URL-Muster geprüft werden.

Eine sinnvolle Vorgehensweise bei großen Websites

Bei vielen URLs sollte die Entscheidung nicht einzeln und zufällig getroffen werden. Besser ist ein wiederholbarer Prozess:

  1. URL-Muster erfassen: Gruppiere Seiten nach Parametern, Filterkombinationen, Seitentypen, Sprachversionen und Funktionen.
  2. Suchintention bewerten: Notiere, welche Gruppen für Suchende eigenständige Antworten oder Angebote liefern.
  3. Hauptversion bestimmen: Lege bei echten Duplikaten eine klare, stabile bevorzugte URL fest.
  4. Signal auswählen: Nutze Canonical für bevorzugte Varianten und Noindex für Seiten, die nicht in den Suchergebnissen erscheinen sollen.
  5. Begleitsignale angleichen: Prüfe interne Links, Sitemaps, Weiterleitungen, hreflang und strukturierte Daten.
  6. Ergebnis beobachten: Kontrolliere nach der Umsetzung, ob die Suchmaschinen die gewünschte URL-Auswahl und Indexierung nachvollziehbar verarbeiten.

Besonders wichtig ist eine Dokumentation: Für jedes URL-Muster sollte festgehalten werden, welche Seiten indexierbar sein sollen, welche Hauptversion gilt und warum eine bestimmte Maßnahme gewählt wurde. Das erleichtert spätere Relaunches, Plugin-Wechsel und Fehleranalysen.

FAQ

Ist Canonical dasselbe wie Noindex?

Nein. Canonical nennt eine bevorzugte URL unter ähnlichen Varianten. Noindex weist darauf hin, dass eine konkrete URL nicht in den Suchergebnissen erscheinen soll. Beide Signale beantworten unterschiedliche Fragen.

Was ist besser bei doppelten Seiten: Canonical oder Noindex?

Wenn eine Version als Hauptseite erhalten bleiben und die Varianten auf sie verweisen sollen, ist Canonical meist passend. Wenn keine der betreffenden URLs als Suchergebnis erscheinen soll, kann Noindex näher an der gewünschten Absicht liegen. Bei dauerhaft identischen URLs kann zusätzlich eine URL-Bereinigung oder Weiterleitung sinnvoll sein.

Kann eine noindex-Seite trotzdem gecrawlt werden?

Ja. Noindex verhindert grundsätzlich nicht, dass die Seite erreichbar oder abrufbar ist. Damit das Signal verarbeitet werden kann, darf der Zugriff für den relevanten Crawler nicht gleichzeitig durch die robots.txt blockiert sein.

Verhindert ein Canonical garantiert die Indexierung der URL?

Nein. Ein Canonical ist ein starkes Signal, aber keine absolute Garantie. Suchmaschinen bewerten zusätzlich Inhalt, interne Verlinkung, technische Erreichbarkeit und weitere Signale. Die bevorzugte URL sollte deshalb eindeutig und konsistent ausgezeichnet werden.

Soll jede Seite ein selbstreferenzierendes Canonical haben?

Ein selbstreferenzierendes Canonical kann bei vielen indexierbaren Seiten eine klare technische Grundlage schaffen, ist aber kein Ersatz für ein durchdachtes URL-Konzept. Entscheidend ist, dass die Angabe korrekt, konsistent und für den jeweiligen Seitentyp sinnvoll ist.

Was sollte ich bei Filterseiten im Onlineshop verwenden?

Das hängt davon ab, ob ein Filter eine eigene, dauerhaft nützliche Suchintention bedient. Für rein technische Kombinationen kann eine kanonische Hauptseite oder eine andere Crawl- und Indexierungsstrategie passen. Wertvolle Filter-Landingpages sollten dagegen nicht pauschal auf Noindex gesetzt werden.

Kann ich eine URL mit Noindex in der XML-Sitemap lassen?

Technisch kann sie dort stehen, sinnvoll ist es normalerweise nicht. Eine XML-Sitemap sollte vor allem URLs enthalten, die als wichtige, indexierbare Seiten vorgesehen sind. Widersprüchliche Signale erschweren die klare Kommunikation der Website-Struktur.

Wie lange dauert es, bis Noindex oder Canonical verarbeitet wird?

Das lässt sich nicht pauschal festlegen. Die Verarbeitung hängt unter anderem davon ab, wann die URL erneut gecrawlt wird und welche weiteren Signale vorliegen. Nach einer Änderung sollte deshalb nicht sofort aus einzelnen Suchergebnissen auf den endgültigen Zustand geschlossen werden.

Fazit: Die Absicht entscheidet

Bei der Frage „Canonical oder Noindex?“ ist nicht die technische Kürze des Signals entscheidend, sondern die gewünschte Funktion der URL. Ein Canonical bündelt ähnliche Varianten unter einer bevorzugten Adresse. Noindex hält eine konkrete Seite aus den Suchergebnissen heraus, während sie für Nutzer weiterhin erreichbar bleiben kann.

Prüfe deshalb zuerst die Suchintention, den eigenständigen Nutzen und die Rolle der URL in der Website. Setze anschließend ein eindeutiges Signal und gleiche interne Links, Sitemaps, Weiterleitungen und weitere technische Angaben daran an. Eine regelmäßige Kontrolle des tatsächlich ausgelieferten Codes verhindert, dass CMS-Einstellungen oder URL-Parameter die geplante SEO-Struktur unbemerkt wieder auflösen.

Noindex richtig verwenden: Anleitung für WordPress und SEO

Das Meta-Tag noindex ist ein präzises Werkzeug für die Suchmaschinenoptimierung. Es teilt Suchmaschinen mit, dass eine bestimmte Seite nicht in den Suchergebnissen erscheinen soll. Richtig eingesetzt, hilft es dabei, dünne, doppelte oder intern wenig hilfreiche Inhalte aus dem Suchindex herauszuhalten. Falsch eingesetzt, kann es jedoch wichtige Seiten unsichtbar machen.

In diesem Ratgeber erfahren Sie, wann Noindex richtig verwenden sinnvoll ist, wie sich noindex von robots.txt und einem Canonical-Tag unterscheidet und wie Sie die Einstellung in WordPress kontrolliert umsetzen. Außerdem finden Sie eine praktische Prüfliste, typische Fehler und Antworten auf häufige Fragen.

Was bedeutet „noindex“?

noindex ist eine Anweisung im HTML-Code einer Seite oder im HTTP-Header. Sie richtet sich an Suchmaschinen-Crawler und bedeutet sinngemäß: Diese URL soll nicht in den Suchergebnissen gelistet werden.

Die häufigste Variante steht im <head>-Bereich des Dokuments:

<meta name="robots" content="noindex, follow">

Die Kombination noindex, follow verhindert die Aufnahme der Seite in den Index, erlaubt aber grundsätzlich weiterhin das Verfolgen von Links auf dieser Seite. Alternativ kann eine Seite mit noindex, nofollow versehen werden. Damit wird zusätzlich signalisiert, dass Links auf der Seite nicht verfolgt werden sollen.

Für die meisten redaktionellen Anwendungsfälle ist noindex, follow die differenziertere Einstellung. Sie sollten nofollow nicht pauschal ergänzen, nur weil eine Seite selbst nicht indexiert werden soll.

Wann ist Noindex sinnvoll?

Noindex eignet sich für URLs, die technisch erreichbar oder intern nützlich sind, aber keinen eigenständigen Wert für Suchende haben. Entscheidend ist nicht, ob eine Seite existiert, sondern ob sie als eigenständiges Suchergebnis hilfreich wäre.

Typische Anwendungsfälle

  • Interne Suchergebnisse: Suchseiten mit frei kombinierbaren Suchbegriffen liefern häufig wechselnde oder sehr ähnliche Inhalte.
  • Filter- und Sortier-URLs: Parameter wie Farbe, Größe, Sortierung oder Ansicht können zahlreiche Varianten derselben Seite erzeugen.
  • Doppelte Archivseiten: Datums-, Autoren- oder Schlagwortarchive sind nicht automatisch problematisch, können aber bei geringer eigener Aussagekraft entbehrlich sein.
  • Interne Hilfsseiten: Bestellbestätigungen, Warenkörbe, Login-Seiten oder bestimmte Kontoansichten sind normalerweise keine sinnvollen öffentlichen Suchergebnisse.
  • Test- und Übergangsseiten: Vor der Veröffentlichung kann eine Seite vorübergehend aus dem Suchindex herausgehalten werden.
  • Inhalte mit sehr geringem eigenständigem Nutzen: Dazu können automatisch erzeugte Übersichten oder fast leere Taxonomien gehören.

Die Entscheidung sollte immer URL für URL oder anhand einer klar definierten Regel getroffen werden. Eine pauschale Noindex-Regel für ganze Verzeichnisse oder Inhaltstypen kann leicht wertvolle Seiten erfassen.

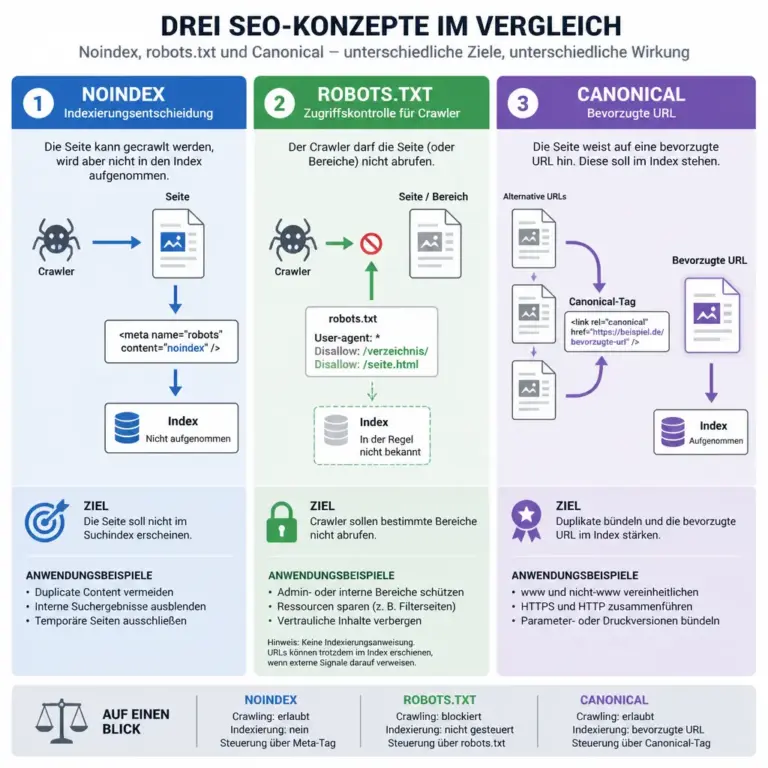
Noindex, robots.txt und Canonical im Vergleich

Vergleich von Noindex, robots.txt und Canonical in einer SEO-Infografik
Die drei Signale erfüllen unterschiedliche Aufgaben bei der technischen SEO.

Die Grafik macht sichtbar, dass Noindex, robots.txt und Canonical nicht austauschbar sind. Besonders wichtig ist die Trennung zwischen Zugriff auf eine URL und ihrer Aufnahme in den Suchindex.

Diese drei SEO-Maßnahmen werden häufig verwechselt, verfolgen aber unterschiedliche Ziele. Eine gute technische Strategie beginnt damit, ihre Funktionen sauber zu trennen.

Maßnahme Hauptzweck Wichtiger Hinweis
noindex Eine URL soll nicht in den Suchindex aufgenommen oder dort entfernt werden. Die Suchmaschine muss die Anweisung abrufen können, um sie zuverlässig zu sehen.
robots.txt Crawler sollen bestimmte Bereiche möglichst nicht abrufen. Eine blockierte URL kann dadurch daran gehindert werden, ein Noindex-Signal auszulesen.
Canonical Eine bevorzugte URL unter mehreren ähnlichen oder doppelten Varianten angeben. Ein Canonical ist ein Hinweis, keine Garantie für die Auswahl durch die Suchmaschine.

Wenn eine URL sicher nicht indexiert werden soll, darf sie nicht zugleich in der robots.txt blockiert sein, sofern die Suchmaschine das Noindex-Signal noch auslesen muss. Die beiden Maßnahmen lösen unterschiedliche Probleme: Die Datei robots.txt steuert den Zugriff, während noindex die Indexierung betrifft.

Ein Canonical ist dagegen oft besser geeignet, wenn mehrere URL-Varianten denselben wichtigen Inhalt darstellen und eine Hauptversion in den Suchergebnissen erscheinen soll. Noindex wäre in diesem Fall möglicherweise zu streng, weil damit auch eine eigenständige Suchintention verloren gehen kann.

Noindex richtig verwenden: Entscheidungskriterien

Bevor Sie eine Seite auf Noindex setzen, helfen einige konkrete Fragen. Sie verhindern, dass die Einstellung nur als schnelle Lösung für ein ungeklärtes Strukturproblem dient.

1. Hat die URL eine eigene Suchintention?

Prüfen Sie, ob Nutzer nach genau diesem Inhalt suchen könnten und ob die Seite diese Erwartung erfüllt. Eine eigenständige Kategorie mit verständlicher Beschreibung kann wertvoll sein. Eine automatisch erzeugte Kombination aus drei Filtern ist dagegen oft kein sinnvolles Ziel für die organische Suche.

2. Ist der Inhalt ausreichend vollständig?

Eine kurze Seite ist nicht automatisch schlecht. Problematisch wird es, wenn sie die Frage des Nutzers nicht beantwortet, fast ausschließlich aus Navigation besteht oder nur minimale Unterschiede zu vielen anderen URLs aufweist. In manchen Fällen ist eine Überarbeitung die bessere Lösung als Noindex.

3. Gibt es eine bessere Haupt-URL?

Wenn mehrere Seiten denselben Zweck erfüllen, sollten Sie entscheiden, ob eine URL gestärkt und die anderen zusammengeführt, per Canonical bevorzugt oder aus dem Index ausgeschlossen werden sollen. Noindex ist nicht automatisch die richtige Maßnahme gegen jede Form von Duplicate Content.

4. Brauchen Besucher diese Seite direkt?

Eine nicht indexierte Seite kann weiterhin über interne Links, Lesezeichen oder direkte Verweise erreichbar sein. Das ist bei Konto-, Warenkorb- oder Bestätigungsseiten sinnvoll. Prüfen Sie aber, ob sensible Inhalte wirklich angemessen geschützt sind: Noindex ist kein Zugriffsschutz.

5. Soll die Einstellung dauerhaft gelten?

Bei einer temporären Baustelle ist es wichtig, später eine Wiedervorlage einzuplanen. Bei dauerhaft unnötigen URLs können Sie zusätzlich die interne Verlinkung, URL-Struktur oder Erzeugungslogik verbessern.

Noindex in WordPress umsetzen

In WordPress wird Noindex meist über ein SEO-Plugin, die Einstellungen des jeweiligen Inhaltstyps oder eine individuelle technische Konfiguration gesetzt. Die genaue Bezeichnung kann je nach Plugin und Version abweichen. Suchen Sie nach Optionen wie „Suchmaschinen erlauben, diesen Beitrag in den Suchergebnissen anzuzeigen?“ oder „Indexierung erlauben“.

Einzelne Seite oder einzelnen Beitrag ausschließen

  1. Öffnen Sie den betreffenden Beitrag oder die Seite im WordPress-Editor.
  2. Rufen Sie die SEO-Einstellungen des Dokuments auf.
  3. Deaktivieren Sie die Option, die eine Indexierung erlaubt, beziehungsweise wählen Sie „noindex“.
  4. Speichern oder aktualisieren Sie den Inhalt.
  5. Rufen Sie den Quelltext der veröffentlichten URL auf und suchen Sie nach noindex.

Verlassen Sie sich nicht ausschließlich auf die Anzeige im Editor. Entscheidend ist, was die öffentlich ausgelieferte URL tatsächlich enthält. Caching, mehrere SEO-Erweiterungen oder individuelle Theme-Funktionen können die Ausgabe beeinflussen.

Archiv- und Taxonomieseiten steuern

Für Kategorien, Schlagwörter, Autoren- oder Datumsarchive bieten viele Plugins globale Einstellungen. Hier ist besondere Vorsicht erforderlich. Eine sinnvolle Kategorieübersicht kann Suchenden Orientierung geben und sollte nicht allein deshalb auf Noindex stehen, weil sie ein Archiv ist.

Bewerten Sie zunächst die Qualität und Funktion der jeweiligen Archivart. Wenn Sie eine Taxonomie dauerhaft nicht benötigen, kann das Entfernen oder Zusammenführen leerer Begriffe besser sein. Wenn die Archive intern nützlich, aber für Suchmaschinen nicht relevant sind, ist Noindex eine mögliche kontrollierte Einstellung.

Robots-Meta-Tag und X-Robots-Tag

HTML-Dokumente verwenden häufig das Robots-Meta-Tag im <head>. Bei nicht-HTML-Dateien wie PDF-Dokumenten kann der Server stattdessen einen HTTP-Header ausliefern:

X-Robots-Tag: noindex

Die technische Umsetzung des Headers hängt vom Webserver, dem Hosting und der verwendeten Infrastruktur ab. Änderungen an Serverregeln sollten Sie erst nach einer Sicherung und mit einer nachvollziehbaren Rückfallmöglichkeit durchführen. Bei Unsicherheit ist die Dokumentation des Hosters oder die Unterstützung einer fachkundigen Person sinnvoll.

Kontrolle und Prüfung nach der Änderung

Eine Noindex-Einstellung ist erst dann zuverlässig bewertet, wenn Sie die veröffentlichte Ausgabe und die technischen Rahmenbedingungen kontrollieren. Arbeiten Sie am besten mit einer kleinen, wiederholbaren Prüfroutine.

  • Quelltext prüfen: Suchen Sie nach einem Robots-Meta-Tag und kontrollieren Sie, ob es tatsächlich noindex enthält.
  • HTTP-Antwort prüfen: Bei Dateien und speziellen Konfigurationen kann ein X-Robots-Tag relevant sein.
  • Robots.txt kontrollieren: Stellen Sie sicher, dass die URL nicht blockiert wird, wenn das Noindex-Signal noch abgerufen werden muss.
  • Interne Links prüfen: Entfernen Sie unnötige Links zu ausgeschlossenen Seiten, ohne wichtige Nutzerwege zu zerstören.
  • Sitemap prüfen: Nicht indexierbare URLs sollten normalerweise nicht in der XML-Sitemap stehen. Die genaue Sitemap-Konfiguration hängt vom System ab.
  • Weiterleitungen und Canonicals ansehen: Eine Noindex-Seite sollte nicht versehentlich gleichzeitig auf eine andere URL weiterleiten oder ein widersprüchliches Canonical ausgeben.
  • Nachkontrolle einplanen: Caches, Plugin-Updates und Template-Änderungen können technische Signale verändern.

Eine URL-Prüfung in einem Suchmaschinen-Tool kann zusätzliche Hinweise liefern. Dabei sollten Sie die dort angezeigten Informationen als Diagnosehilfe verstehen und mit dem tatsächlich ausgelieferten Quelltext abgleichen. Die Entfernung einer bereits bekannten URL aus einem Index kann außerdem zeitversetzt erfolgen.

Häufige Fehler beim Einsatz von Noindex

Die komplette Website auf Noindex setzen

Ein falsch gesetztes globales Robots-Signal kann alle wichtigen Inhalte betreffen. Prüfen Sie deshalb nach Änderungen an Theme, SEO-Plugin oder Hosting besonders die Startseite, wichtige Landingpages, Kategorien und Beiträge.

Noindex mit Zugriffsschutz verwechseln

Jede Person, die die URL kennt oder über einen Link erreicht, kann eine nicht indexierte Seite weiterhin aufrufen, sofern keine Authentifizierung oder andere Schutzmaßnahme greift. Für vertrauliche Inhalte benötigen Sie einen echten Zugriffsschutz.

Die URL in robots.txt sperren und Noindex erwarten

Wenn ein Crawler eine URL wegen der robots.txt nicht abrufen darf, sieht er möglicherweise auch das Meta-Tag nicht. Eine Sperre kann deshalb die gewünschte Verarbeitung des Noindex-Signals verhindern.

Wichtige Inhalte wegen geringer Wortzahl ausschließen

Die Länge allein entscheidet nicht über den Nutzen. Eine kompakte Kontakt-, Produkt- oder Hilfeseite kann für Besucher sehr relevant sein. Bewerten Sie Inhalt, Suchintention, Aktualität und Nutzerführung gemeinsam.

Noindex als Ersatz für eine schlechte Informationsarchitektur nutzen

Wenn tausende Filter-URLs entstehen, ist es oft besser, die URL-Erzeugung, interne Verlinkung und Crawling-Steuerung grundsätzlich zu analysieren. Noindex kann eine sinnvolle Maßnahme sein, sollte aber nicht die einzige Antwort auf strukturelle Probleme bleiben.

Praktische Noindex-Checkliste

Die folgende Checkliste eignet sich für einzelne Seiten ebenso wie für größere WordPress-Bereinigungen:

  1. Definieren Sie, warum die konkrete URL nicht in den Suchergebnissen erscheinen soll.
  2. Prüfen Sie, ob Überarbeitung, Zusammenlegung, Weiterleitung oder Canonical die passendere Lösung wäre.
  3. Setzen Sie Noindex gezielt auf der betroffenen URL oder in einer klar begrenzten Regel.
  4. Vermeiden Sie widersprüchliche Einstellungen in SEO-Plugin, Theme, Server und robots.txt.
  5. Entfernen Sie die URL aus der XML-Sitemap, sofern sie dort nicht benötigt wird.
  6. Kontrollieren Sie Meta-Tag oder HTTP-Header in der veröffentlichten Version.
  7. Dokumentieren Sie den Grund und prüfen Sie bei temporären Maßnahmen ein Ablaufdatum.
  8. Beobachten Sie wichtige Seiten nach Plugin-, Theme- oder Serveränderungen erneut.

FAQ

Ist Noindex schlecht für SEO?

Nein. Noindex ist zunächst eine Steuerungsanweisung. Sie kann SEO unterstützen, wenn unwichtige oder nicht eigenständige URLs aus dem Index herausgehalten werden. Problematisch wird sie nur, wenn relevante Seiten versehentlich ausgeschlossen werden.

Kann eine Noindex-Seite weiterhin aufgerufen werden?

Ja. Noindex verhindert grundsätzlich die Aufnahme in Suchergebnisse, sperrt aber nicht den direkten Zugriff. Für private oder geschützte Inhalte brauchen Sie Authentifizierung, Berechtigungen oder eine andere geeignete Zugriffskontrolle.

Soll ich noindex mit nofollow kombinieren?

Nicht automatisch. Wenn die Seite selbst nicht indexiert werden soll, Links darauf aber weiterhin für die interne Navigation relevant sind, kann noindex, follow passender sein. Die Wahl hängt vom Zweck der Seite und Ihrer Linkstrategie ab.

Wie unterscheidet sich Noindex von einem Canonical?

Noindex weist darauf hin, dass eine URL nicht gelistet werden soll. Ein Canonical nennt dagegen eine bevorzugte Version aus mehreren ähnlichen URLs. Wenn eine Variante weiterhin als Suchergebnis infrage kommt, kann ein Canonical die passendere Lösung sein.

Kann ich Noindex in der robots.txt eintragen?

Nein, noindex ist kein regulärer Ersatz für eine Robots.txt-Regel. Das Signal wird typischerweise im HTML-Meta-Tag oder über den X-Robots-Tag im HTTP-Header übertragen. Die robots.txt steuert vor allem, welche URLs ein Crawler abrufen darf.

Wie schnell verschwindet eine URL aus dem Index?

Das lässt sich nicht pauschal festlegen. Die Suchmaschine muss die URL erneut abrufen und das Signal verarbeiten. Eine Änderung im Quelltext führt daher nicht zwingend sofort zu einer sichtbaren Änderung der Suchergebnisse.

Soll eine Noindex-Seite aus der Sitemap entfernt werden?

In der Regel ja, weil eine XML-Sitemap bevorzugt URLs enthalten sollte, die Suchmaschinen indexieren dürfen und sollen. Prüfen Sie jedoch die konkrete Sitemap-Konfiguration und beheben Sie die Ursache, wenn ausgeschlossene URLs automatisch wieder aufgenommen werden.

Fazit: Noindex gezielt statt pauschal einsetzen

Noindex richtig verwenden bedeutet, die Anweisung als präzises Steuerungswerkzeug zu betrachten. Nicht jede kurze, doppelte oder technisch erzeugte URL muss automatisch ausgeschlossen werden. Entscheidend sind Suchintention, eigenständiger Nutzen, Zugriffszweck und die Frage, ob eine andere SEO-Maßnahme besser passt.

Setzen Sie Noindex möglichst gezielt, vermeiden Sie Konflikte mit robots.txt und Canonical, prüfen Sie die tatsächlich ausgelieferte Version und dokumentieren Sie wichtige Änderungen. So bleibt Ihre WordPress-Website für Besucher zugänglich, während der Suchindex auf die Inhalte konzentriert wird, die dort wirklich einen eigenständigen Beitrag leisten.