Domainbewertung nach einem CMS-Wechsel: Sichtbarkeit, Risiken und Chancen richtig einschätzen

Ein Wechsel des Content-Management-Systems kann technische Abläufe vereinfachen, die Pflege beschleunigen oder neue Funktionen ermöglichen. Gleichzeitig verändert sich dabei oft mehr als nur die Oberfläche einer Website. URL-Strukturen, interne Verlinkungen, Seitentemplates, Ladeverhalten, Metadaten und Crawling-Signale können betroffen sein. Genau deshalb sollte die Domainbewertung nach einem CMS-Wechsel nicht auf eine einzelne Sichtbarkeitszahl oder einen kurzen Blick in ein SEO-Tool reduziert werden.

Eine belastbare Bewertung beantwortet vor allem drei Fragen: Welche Werte der bisherigen Website wurden erhalten? Welche Veränderungen sind tatsächlich auf den CMS-Wechsel zurückzuführen? Und welche Verbesserungen lassen sich nach dem Umzug noch umsetzen? Dieser Beitrag zeigt eine praxistaugliche Vorgehensweise, typische Fehlerquellen und Kriterien für eine faire Einschätzung vor und nach der Migration.

Was bedeutet Domainbewertung nach einem CMS-Wechsel?

Unter einer Domainbewertung nach einem CMS-Wechsel ist die strukturierte Analyse einer Website vor und nach der technischen Umstellung zu verstehen. Dabei wird nicht nur geprüft, ob einzelne Rankings vorhanden sind. Betrachtet werden auch die Auffindbarkeit wichtiger Seiten, die Qualität der Weiterleitungen, die Indexierung, die interne Verlinkung, technische Zugriffssignale und die Entwicklung organischer Zugriffe.

Der Begriff „Domainbewertung“ kann je nach Ziel unterschiedlich verwendet werden. Bei einer SEO-Bewertung geht es meist um die organische Sichtbarkeit und die technische Grundlage. Bei einer Unternehmens- oder Kaufentscheidung können zusätzlich Markenbekanntheit, Backlinks, Inhalte, Zielgruppen, Conversion-Pfade und rechtliche Rahmenbedingungen relevant sein. Ein CMS-Wechsel ist in beiden Fällen ein wichtiger Einschnitt, weil aktuelle Messwerte nicht automatisch den historischen Zustand der Domain abbilden.

Die Bewertung sollte daher immer einen Zeitraum vor dem Wechsel, die eigentliche Umstellungsphase und eine ausreichend lange Beobachtung danach berücksichtigen. Einzelne Tage mit schwankenden Zugriffen liefern nur begrenzte Hinweise. Aussagekräftiger ist eine nachvollziehbare Entwicklung, bei der technische Änderungen und ihre möglichen Folgen dokumentiert werden.

Warum ein CMS-Wechsel die Bewertung einer Domain beeinflusst

Ein CMS steuert nicht nur die redaktionelle Eingabe. Es beeinflusst häufig die Generierung von URLs, Canonical-Tags, XML-Sitemaps, strukturierten Daten, Seitentiteln, Navigationen und serverseitigen Einstellungen. Werden diese Elemente beim Wechsel anders ausgegeben, kann sich die Suchmaschinenbewertung verändern, obwohl die Inhalte auf den ersten Blick ähnlich bleiben.

Besonders wichtig ist die Trennung zwischen einem reinen Systemwechsel und einer umfassenden Website-Migration. Wird nur die technische Plattform ausgetauscht und bleiben URLs, Inhalte und interne Verlinkungen weitgehend gleich, ist die Vergleichbarkeit besser. Kommen gleichzeitig ein neues Design, eine neue Informationsarchitektur, eine Domainänderung, eine Sprachversion oder eine starke Inhaltsbereinigung hinzu, lassen sich die Auswirkungen schwerer isolieren.

Auch positive Effekte sind möglich. Ein neues CMS kann unnötige Parameter reduzieren, bessere Ladezeiten ermöglichen, redaktionelle Fehler verhindern oder eine übersichtlichere interne Verlinkung unterstützen. Eine faire Domainbewertung betrachtet deshalb Risiken und Verbesserungen gleichermaßen, statt den Wechsel grundsätzlich als Verlust oder Erfolg zu interpretieren.

Die richtige Vergleichsbasis vor dem Wechsel
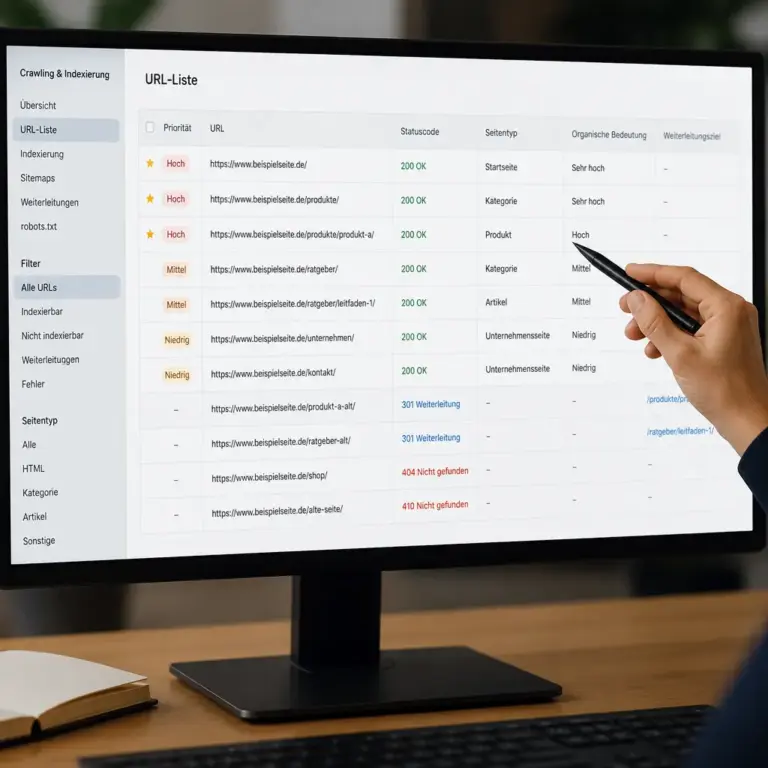
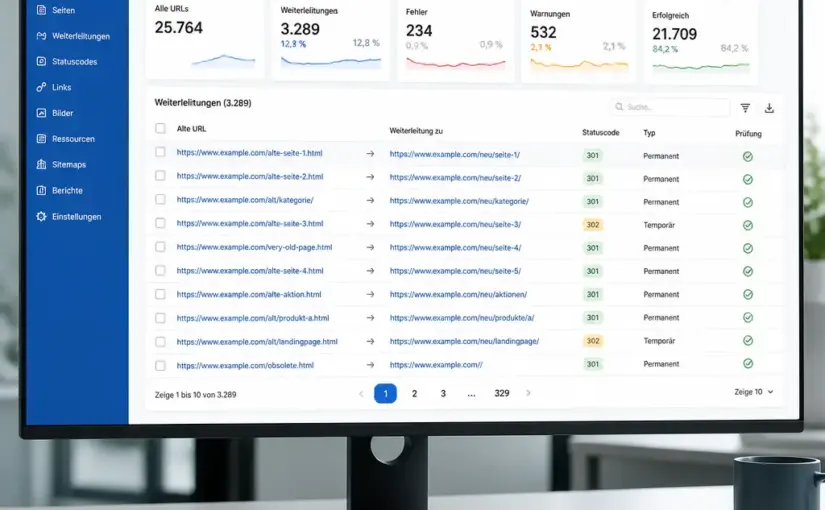
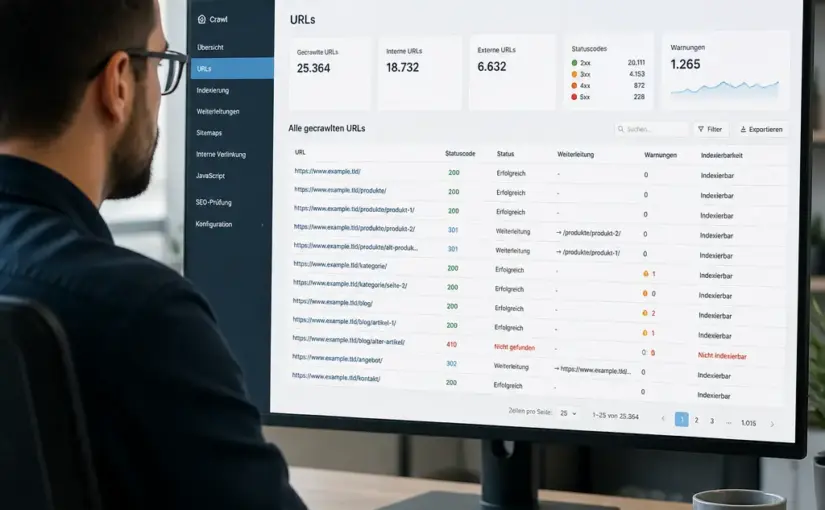
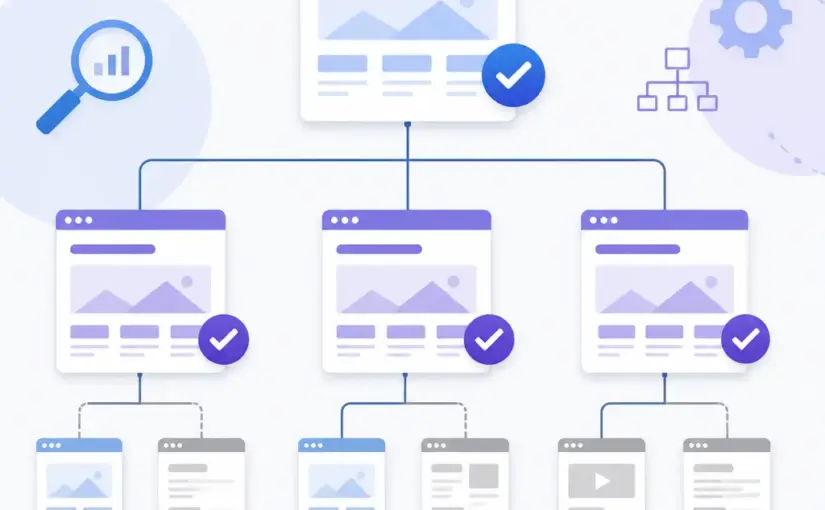
Priorisierte URL-Liste als Vergleichsbasis vor einem CMS-Wechsel
Eine dokumentierte URL-Basis erleichtert den Vergleich vor und nach der Migration.

Die Abbildung zeigt, warum nicht jede URL gleich bewertet werden sollte. Besonders wichtige Zielseiten, verlinkte Inhalte und zentrale Seitentypen verdienen bei der Bestandsaufnahme eine klare Priorität.

Eine Bewertung wird deutlich zuverlässiger, wenn vor der Umstellung ein dokumentierter Ausgangszustand vorhanden ist. Dieser dient später als Referenz. Es genügt nicht, nur die Startseite oder einige wichtige Suchbegriffe zu prüfen. Die Bestandsaufnahme sollte die wesentlichen Seitentypen und URL-Gruppen der Domain abbilden.

  • URL-Bestand: Erfassen Sie indexierbare Seiten, Statuscodes, Weiterleitungen und wichtige URL-Muster.
  • Organische Leistung: Dokumentieren Sie Klicks, Impressionen, durchschnittliche Positionen und die wichtigsten Suchanfragen aus den verfügbaren Analysewerkzeugen.
  • Inhalte: Ordnen Sie Seiten nach Zweck, Themenbereich, Aktualität und geschäftlicher Bedeutung.
  • Technische Signale: Prüfen Sie Canonical-Tags, Robots-Anweisungen, XML-Sitemaps, strukturierte Daten und mobile Darstellung.
  • Interne Verlinkung: Halten Sie fest, welche Seiten besonders viele interne Verweise erhalten und ob wichtige Inhalte erreichbar sind.
  • Externe Verweise: Identifizieren Sie wertvolle Backlinks und prüfen Sie, auf welche konkreten URLs sie zeigen.

Zusätzlich sollte eine Liste der wichtigsten Zielseiten erstellt werden. Dazu gehören beispielsweise Leistungsseiten, Ratgeber, Produktseiten, Kontaktseiten und Seiten mit bereits vorhandenen externen Verweisen. Diese Liste ist später hilfreicher als ein pauschaler Blick auf alle URLs, weil sie die geschäftliche Relevanz berücksichtigt.

Welche Daten nach dem CMS-Wechsel geprüft werden sollten

Nach der Migration sollten dieselben Bereiche erneut untersucht werden. Entscheidend ist, möglichst dieselben Messgrößen und Zeiträume zu verwenden. Werden vor dem Wechsel andere Filter oder Seitengruppen genutzt als danach, kann ein scheinbarer Unterschied allein durch die Messmethode entstehen.

Indexierung und Crawling

Prüfen Sie, ob wichtige Seiten weiterhin indexiert werden können und ob Suchmaschinen die vorgesehenen Inhalte erreichen. Achten Sie auf versehentlich gesetzte noindex-Anweisungen, blockierende Regeln in der robots.txt, falsche Canonical-Ziele und Sitemaps mit alten oder nicht erreichbaren URLs.

Ein Blick auf die Zahl indexierter Seiten allein reicht nicht aus. Eine Website kann ähnlich viele indexierte URLs haben wie vorher und trotzdem wichtige Inhalte verloren haben. Umgekehrt kann eine niedrigere Zahl sinnvoll sein, wenn doppelte, dünne oder technisch erzeugte Seiten bewusst entfernt wurden. Entscheidend ist die Qualität und Relevanz des verbleibenden Bestands.

Weiterleitungen und URL-Erhalt

Wenn sich URLs ändern, sollte jede wichtige alte Adresse auf die passende neue Zielseite weiterleiten. Eine Weiterleitung auf die Startseite ist in vielen Fällen keine gute inhaltliche Entsprechung. Sie erschwert Nutzern und Suchmaschinen die Orientierung und kann den ursprünglichen Zweck der alten URL nicht angemessen fortführen.

Erstellen Sie deshalb eine Weiterleitungsmatrix mit alter URL, neuer URL, Statuscode, Seitentyp und Prüfstatus. Achten Sie außerdem auf Weiterleitungsketten, Schleifen und veraltete interne Links. Eine erfolgreiche Weiterleitung bedeutet nicht automatisch, dass auch die gesamte Nutzerführung und interne Verlinkung angepasst wurden.

Inhalte, Metadaten und Seitentemplates

Ein neues CMS kann Inhalte zwar übernehmen, aber anders ausgeben. Kontrollieren Sie, ob Überschriftenhierarchien, Seitentitel, Meta-Beschreibungen, Bild-Alternativtexte, strukturierte Daten und hreflang-Verweise vollständig und sinnvoll übertragen wurden. Auch der sichtbare Text kann durch neue Templates gekürzt, verschoben oder auf bestimmten Seitentypen ausgeblendet werden.

Besondere Aufmerksamkeit verdienen Seiten, deren Inhalte über Felder, Taxonomien oder modulare Bausteine verwaltet werden. Beim Import können Werte fehlen, zusammengeführt oder in falschen Feldern abgelegt werden. Eine manuelle Stichprobe aus jeder wichtigen Seitengruppe ist daher sinnvoll. Sie sollte sowohl redaktionelle als auch technische Merkmale abdecken.

Messgrößen für eine belastbare Domainbewertung

Keine einzelne Kennzahl beschreibt den Zustand einer Domain vollständig. Eine gute Bewertung kombiniert mehrere Perspektiven und erklärt, was die jeweiligen Daten tatsächlich aussagen.

Bereich Wichtige Fragen Einordnung
Organische Zugriffe Wie entwickeln sich Klicks und qualifizierte Besuche? Zeigt die Nutzung, erklärt aber allein nicht die Ursache einer Veränderung.
Suchanfragen und Positionen Bleiben wichtige Themen und Zielseiten sichtbar? Hilft, Verschiebungen nach Suchintention und Seitentyp zu erkennen.
Indexierbarkeit Sind relevante Inhalte erreichbar und crawlbar? Deckt technische Sperren und Fehlkonfigurationen auf.
URL- und Weiterleitungsqualität Wurden alte Adressen sinnvoll auf neue Ziele geführt? Bewertet die Kontinuität der bestehenden Signale.
Interne Verlinkung Finden Nutzer und Crawler wichtige Inhalte? Zeigt strukturelle Veränderungen nach dem Template-Wechsel.
Backlink-Ziele Verweisen externe Links noch auf passende erreichbare Seiten? Hilft, wertvolle externe Verweise zu schützen.
Technische Qualität Wie verhalten sich Ladezeit, mobile Darstellung und Stabilität? Unterstützt die Bewertung der Nutzungserfahrung und technischen Basis.

Bei der Interpretation sollten saisonale Schwankungen, Kampagnen, Marktveränderungen und redaktionelle Maßnahmen berücksichtigt werden. Ein Rückgang nach dem Wechsel beweist nicht automatisch einen CMS-Fehler. Ebenso ist ein kurzfristiger Anstieg kein sicherer Beleg für eine nachhaltige Verbesserung. Die Ursachen müssen anhand der betroffenen URLs, Suchanfragen und technischen Änderungen geprüft werden.

Ein praktischer Ablauf für die Bewertung

1. Umfang und Ziel der Migration klären

Dokumentieren Sie zunächst, was genau geändert wurde: CMS, Hosting, Templates, URL-Struktur, Inhalte, Navigation, Domain, Sprachversionen oder Tracking. Je mehr Komponenten gleichzeitig verändert wurden, desto vorsichtiger muss die spätere Ursachenzuordnung ausfallen.

2. Bestand vor der Umstellung sichern

Exportieren Sie die relevanten URLs, Statuscodes, Seitentitel, Canonicals und Analysewerte. Ergänzen Sie die Daten um eine Priorisierung. Eine umsatznahe Zielseite, ein viel verlinkter Ratgeber und eine technisch erzeugte Filterseite sollten nicht gleich behandelt werden.

3. Technische Abnahme durchführen

Prüfen Sie die neue Website zunächst unabhängig von Rankingveränderungen. Funktionieren Navigation, Suche, Formulare und mobile Darstellung? Sind wichtige Seiten erreichbar? Werden konsistente Statuscodes, Metadaten und strukturierte Daten ausgegeben? Diese Abnahme verhindert, dass technische Fehler erst durch spätere Verluste entdeckt werden.

4. Alte und neue URL-Struktur vergleichen

Vergleichen Sie die URL-Listen automatisiert oder in überschaubaren Segmenten. Markieren Sie neue, entfernte, unveränderte und umgeleitete URLs. Für jede entfernte Seite sollte eine bewusste Entscheidung vorliegen: Gibt es eine passende Nachfolgeseite, ist eine dauerhafte Weiterleitung sinnvoll oder soll die URL tatsächlich entfallen?

5. Entwicklung nach der Veröffentlichung beobachten

Beobachten Sie zunächst technische Fehler und anschließend die Entwicklung der organischen Daten. Segmentieren Sie die Auswertung nach Verzeichnissen, Seitentypen, Themen und Zielseiten. So wird sichtbar, ob ein Problem die gesamte Domain betrifft oder nur bestimmte Templates beziehungsweise Inhaltsgruppen.

6. Ursachen und Maßnahmen dokumentieren

Führen Sie ein Änderungsprotokoll. Notieren Sie Veröffentlichungszeitpunkte, Anpassungen an Weiterleitungen, technische Korrekturen und größere redaktionelle Änderungen. Eine solche Chronik erleichtert die Bewertung, weil spätere Schwankungen mit konkreten Maßnahmen verglichen werden können.

Typische Fehler bei der Domainbewertung

Nur die Sichtbarkeitskurve betrachten

Aggregierte Kurven sind nützlich für einen ersten Überblick, zeigen aber selten, welche Seiten betroffen sind. Prüfen Sie immer die zugrunde liegenden Keywords, Verzeichnisse und URLs. Ein Verlust kann auf wenige wichtige Seiten konzentriert sein oder aus vielen kleinen Veränderungen bestehen.

Weiterleitungen pauschal zur Startseite setzen

Diese Lösung wirkt schnell, ersetzt aber keine inhaltliche Zuordnung. Alte Seiten mit eigenständiger Suchintention sollten nach Möglichkeit auf eine fachlich passende neue Seite zeigen. Fehlt eine passende Nachfolgeseite, kann eine kontrollierte Entfernung sinnvoller sein als eine beliebige Weiterleitung.

Alte und neue Website nicht mit derselben Methode messen

Unterschiedliche Tracking-Einstellungen, Filter oder Cookie-Konfigurationen können die Vergleichbarkeit beeinträchtigen. Vor der Bewertung sollte geklärt werden, ob sich Messsysteme, Datenansichten oder Ziele geändert haben. Eine technische Veränderung im Analysewerkzeug darf nicht vorschnell als SEO-Verlust interpretiert werden.

Die Indexierungszahl als Qualitätsbeweis verstehen

Mehr indexierte URLs bedeuten nicht automatisch mehr Wert. Ein CMS kann viele Varianten, Suchseiten oder Parameter erzeugen, die für Nutzer keinen eigenständigen Nutzen bieten. Bewerten Sie deshalb die Relevanz, Erreichbarkeit und Qualität der indexierten Inhalte.

Wie sich Chancen des neuen CMS bewerten lassen

Die Domainbewertung sollte nicht bei der Fehlerkontrolle enden. Nach einem Wechsel lohnt sich eine separate Betrachtung der Verbesserungsmöglichkeiten. Dazu gehören klarere Content-Modelle, einheitliche Templates, bessere redaktionelle Prozesse und eine leichter pflegbare interne Verlinkung.

Fragen Sie beispielsweise, ob Seitentitel und strukturierte Daten nun konsistenter gepflegt werden können. Lassen sich veraltete Inhalte leichter aktualisieren? Sind verwandte Inhalte besser miteinander verknüpft? Können technische Fehler durch Pflichtfelder oder kontrollierte Eingaben reduziert werden? Solche Vorteile zeigen sich nicht immer sofort in Rankings, können aber die langfristige Qualität der Domain stärken.

Auch die Geschwindigkeit und Stabilität sollten im realen Nutzungskontext geprüft werden. Nicht jede technische Optimierung wirkt auf jeder Seite gleich. Vergleichen Sie daher zentrale Seitentypen und mobile Nutzungssituationen, statt nur einen einzelnen Testwert zu betrachten. Wichtig ist, dass Verbesserungen nicht auf Kosten von Lesbarkeit, Bedienbarkeit oder inhaltlicher Vollständigkeit gehen.

Wann eine externe Prüfung sinnvoll ist

Eine unabhängige Prüfung kann besonders hilfreich sein, wenn die Domain nach dem Wechsel deutlich an Sichtbarkeit verliert, viele URLs betroffen sind oder mehrere Änderungen gleichzeitig umgesetzt wurden. Auch bei einem geplanten Kauf, einer Zusammenführung von Domains oder einer Migration mit hoher wirtschaftlicher Bedeutung kann eine zweite Perspektive Risiken sichtbar machen.

Eine qualifizierte Prüfung sollte transparent erklären, welche Daten verwendet wurden, welche Einschränkungen bestehen und wie Empfehlungen priorisiert werden. Achten Sie auf eine nachvollziehbare Verbindung zwischen Befund und Maßnahme. Pauschale Aussagen ohne konkrete URLs, Seitentypen oder technische Belege helfen bei der Umsetzung nur begrenzt.

Erfahrung mit vergleichbaren Migrationen kann die Analyse bereichern, ersetzt aber keine Prüfung des konkreten Einzelfalls. Seriöse Einschätzungen trennen beobachtete Daten, plausible Hypothesen und noch zu überprüfende Annahmen. Genau diese Unterscheidung macht eine Domainbewertung belastbarer.

FAQ

Wie lange sollte eine Domain nach einem CMS-Wechsel beobachtet werden?

Das hängt von Umfang, Crawlinghäufigkeit, Saisonalität und bisherigen Daten ab. Eine erste technische Prüfung sollte unmittelbar nach der Veröffentlichung erfolgen. Für die Bewertung der organischen Entwicklung ist ein längerer Beobachtungszeitraum sinnvoll, der mehrere typische Nutzungs- und Veröffentlichungsphasen abdeckt.

Ist ein Rankingverlust nach dem Wechsel immer ein technischer Fehler?

Nein. Mögliche Ursachen sind unter anderem technische Sperren, fehlende Weiterleitungen, veränderte Inhalte, eine neue interne Verlinkung oder externe Marktveränderungen. Der Verlust sollte nach URLs, Suchanfragen und Seitentypen untersucht werden, bevor eine konkrete Ursache festgelegt wird.

Welche URLs sollten bei der Migration besonders geschützt werden?

Priorität haben wichtige Zielseiten, stark verlinkte Inhalte, Seiten mit stabilen organischen Zugriffen und URLs, die für Nutzer oder Geschäftsziele zentral sind. Zusätzlich sollten ältere Seiten mit wertvollen externen Verweisen geprüft werden. Eine Priorisierung verhindert, dass wichtige Adressen in einer großen URL-Menge übersehen werden.

Was ist wichtiger: Backlinks oder interne Verlinkung?

Beide Bereiche erfüllen unterschiedliche Aufgaben. Externe Verweise können auf die Bedeutung einer konkreten Seite hinweisen, während interne Links die Auffindbarkeit und thematische Struktur unterstützen. Nach einem CMS-Wechsel sollten deshalb sowohl verlinkte Zielseiten als auch deren Einbindung in die neue Navigation kontrolliert werden.

Kann eine geringere Zahl indexierter Seiten positiv sein?

Ja, wenn zuvor viele doppelte, leere oder nicht hilfreiche URLs indexiert waren und relevante Inhalte erhalten bleiben. Die Zahl allein ist kein Qualitätsmaß. Entscheidend ist, ob wichtige Seiten erreichbar, technisch zugänglich und inhaltlich passend sind.

Wie lässt sich feststellen, ob das CMS die Ursache einer Veränderung ist?

Vergleichen Sie den Zeitpunkt der Veränderung mit dem Veröffentlichungszeitpunkt und prüfen Sie betroffene URL-Gruppen. Danach sollten Weiterleitungen, Indexierungsregeln, Templates, Inhalte und Tracking getrennt untersucht werden. Wenn gleichzeitig andere Änderungen erfolgten, bleibt die Ursachenzuordnung möglicherweise eingeschränkt.

Welche Daten sollte ein Migrationsprotokoll enthalten?

Empfehlenswert sind Datum und Umfang der Veröffentlichung, URL-Änderungen, Weiterleitungen, technische Anpassungen, Inhaltsänderungen, Tracking-Konfigurationen und bekannte offene Punkte. Ergänzen Sie jeweils verantwortliche Aufgaben oder einen Prüfstatus, damit spätere Beobachtungen nachvollziehbar bleiben.

Fazit: Domainbewertung als fortlaufenden Prozess verstehen

Eine gute Domainbewertung nach einem CMS-Wechsel verbindet technische Prüfung, Datenvergleich und fachliche Einordnung. Sie untersucht nicht nur, ob Rankings schwanken, sondern auch, ob wichtige Inhalte erreichbar bleiben, Weiterleitungen sinnvoll funktionieren, interne Strukturen tragen und das neue System langfristig bessere Prozesse ermöglicht.

Die verlässlichste Vorgehensweise beginnt vor dem Wechsel mit einer dokumentierten Ausgangsbasis. Danach folgen eine technische Abnahme, ein strukturierter URL-Vergleich, die Beobachtung relevanter Daten und eine priorisierte Fehlerbehebung. Wer Änderungen sauber protokolliert und zwischen Fakten und Annahmen unterscheidet, kann die Domain realistischer bewerten und die Chancen des neuen CMS gezielt nutzen.
Website-Umzug ohne Rankingverlust: Der vollständige SEO-Ratgeber

Ein Website-Umzug kann technisch notwendig sein, birgt aber aus SEO-Sicht erhebliche Risiken. Ändert sich die Domain, die URL-Struktur, das CMS, das Hosting oder alles gleichzeitig, müssen Suchmaschinen die Zusammenhänge zwischen alten und neuen Seiten erneut verstehen. Ein sorgfältig geplanter Website-Umzug ohne Rankingverlust ist deshalb kein einzelner Schalter, sondern ein kontrollierter Prozess aus Bestandsaufnahme, Weiterleitungen, technischen Prüfungen und Monitoring.

Dieser Ratgeber zeigt, wie Sie einen Umzug vorbereiten, welche SEO-Signale erhalten bleiben müssen und wie Sie nach dem Go-live mögliche Fehler schnell erkennen. Ein vollständiger Ranking-Erhalt lässt sich nicht garantieren, weil Suchmaschinen ihre Bewertung laufend aktualisieren. Durch eine saubere Migration lassen sich vermeidbare Verluste jedoch deutlich reduzieren.

Was bedeutet ein Website-Umzug aus SEO-Sicht?

Der Begriff „Website-Umzug“ beschreibt mehrere unterschiedliche Szenarien. Nicht jede Veränderung hat dieselben Folgen für die organische Sichtbarkeit. Ein reiner Wechsel des Hostings kann ohne sichtbare URL-Änderung relativ unauffällig verlaufen. Ein Domainwechsel oder eine neue URL-Struktur greift dagegen direkt in die Signale ein, die Suchmaschinen einzelnen Dokumenten zuordnen.

  • Hostingwechsel: Die Domain und URLs bleiben gleich, während Server, Rechenzentrum oder Anbieter wechseln.
  • CMS-Wechsel: Inhalte werden in ein anderes Content-Management-System übertragen. Dabei ändern sich häufig Templates, interne Links, Metadaten oder strukturierte Daten.
  • Domainwechsel: Die Website erhält eine neue Hauptdomain. Alle relevanten alten URLs müssen auf passende neue Ziele verweisen.
  • HTTPS-Umstellung: HTTP-Adressen werden durch HTTPS ersetzt. Die alten Varianten dürfen nicht parallel als eigenständige Versionen bestehen bleiben.
  • Relaunch mit neuer URL-Struktur: Pfade, Kategorien, Dateinamen oder Sprachverzeichnisse werden verändert.
  • Zusammenlegung oder Aufteilung: Mehrere Websites werden kombiniert oder Inhalte auf verschiedene Domains verteilt.

Je mehr dieser Änderungen gleichzeitig stattfinden, desto schwieriger wird die Fehlersuche. Wenn möglich, sollten Sie einen Domainwechsel nicht zeitgleich mit einer umfassenden inhaltlichen Neuausrichtung und einem kompletten Relaunch durchführen. Eine schrittweise Planung macht Veränderungen messbarer.

Die wichtigsten Ziele einer SEO-Migration

Bei einem Website-Umzug sollten nicht nur einzelne Rankings im Blick bleiben. Entscheidend ist, dass Suchmaschinen und Nutzer die neue Website eindeutig als Fortführung der bisherigen Inhalte erkennen können. Dafür müssen mehrere Ziele zusammenkommen:

  • Wichtige alte URLs führen per dauerhafter Weiterleitung zur jeweils passenden neuen URL.
  • Inhalte, Suchintention und zentrale Seitenelemente bleiben erhalten oder werden nachvollziehbar verbessert.
  • Die neue Website ist crawlbar, indexierbar und technisch erreichbar.
  • Interne Links, Canonicals, hreflang-Angaben und XML-Sitemaps zeigen auf die neue Struktur.
  • Die neue Website erfüllt grundlegende Anforderungen an Ladezeit, Mobilfreundlichkeit und Sicherheit.
  • Messung und Überwachung funktionieren bereits zum Start.

Eine Weiterleitung allein reicht nicht aus. Sie kann den Übergang unterstützen, aber sie ersetzt weder relevante Inhalte noch eine konsistente technische Konfiguration.

Vor dem Website-Umzug: Bestandsaufnahme und Planung

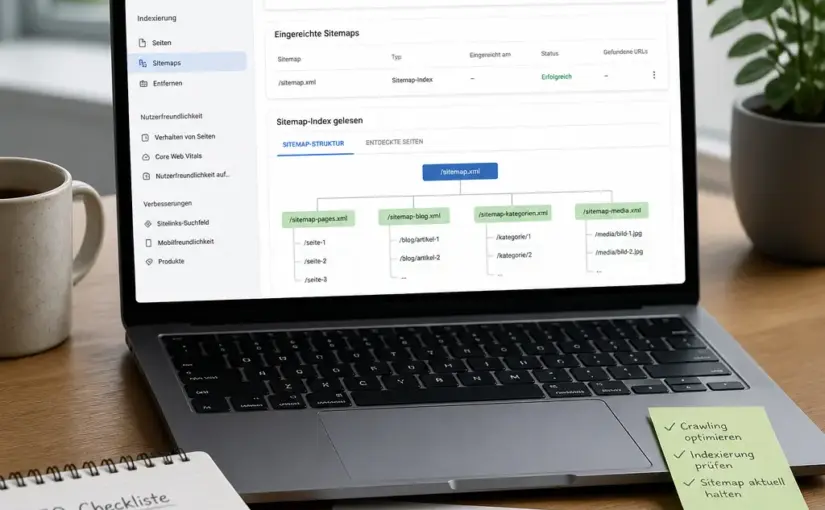
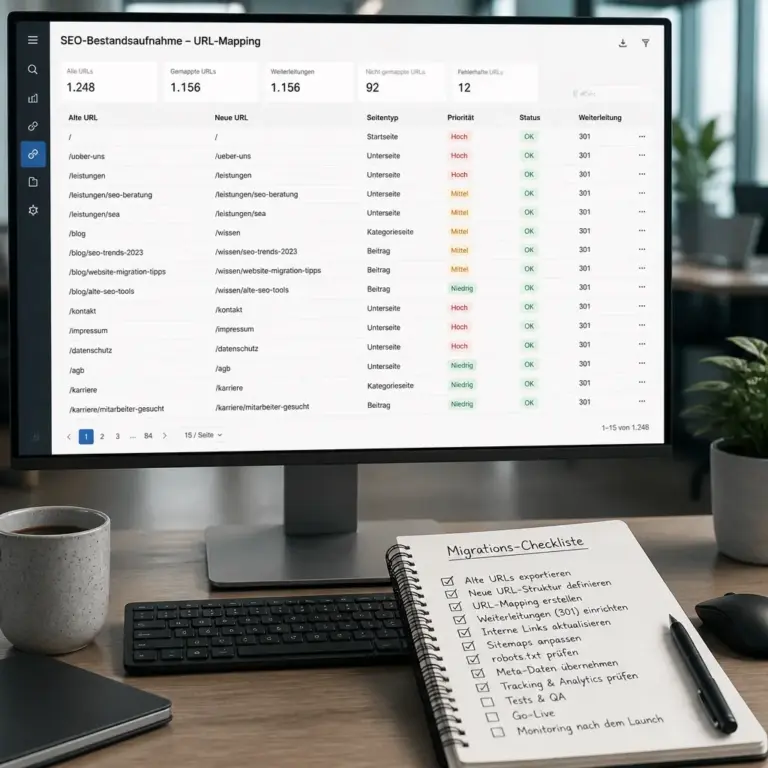
SEO-Bestandsaufnahme mit URL-Liste und Migrations-Checkliste
Eine vollständige URL-Liste schafft die Grundlage für eine kontrollierte Migration.

Die Abbildung zeigt, welche Informationen vor dem Umzug gesammelt werden sollten. Besonders wichtig sind die Zuordnung von alten und neuen URLs sowie eine klare Priorisierung wichtiger Seiten.

Die Vorbereitung ist der wichtigste Teil eines Website-Umzugs ohne Rankingverlust. Erstellen Sie zunächst eine belastbare Liste aller bekannten URLs und ergänzen Sie sie um SEO- und Geschäftsdaten. Verlassen Sie sich nicht ausschließlich auf eine einzelne Quelle: Ein Crawler, Server-Logdaten, XML-Sitemaps, interne Datenbanken und Analysewerkzeuge können jeweils unterschiedliche URLs sichtbar machen.

Welche URLs sollten priorisiert werden?

Nicht jede URL ist gleich wichtig. Priorisieren Sie insbesondere Seiten mit organischem Traffic, wertvollen Backlinks, vielen internen Verweisen, Conversion-Relevanz oder hoher Sichtbarkeit für wichtige Suchbegriffe. Berücksichtigen Sie außerdem alte URLs, die nicht mehr stark besucht werden, aber noch externe Links besitzen. Solche Adressen können weiterhin zur Autorität der Website beitragen.

Eine nützliche Migrationsliste enthält mindestens folgende Spalten:

Feld Zweck
Alte URL Eindeutige Ausgangsadresse inklusive Protokoll und Hostname
Neue URL Das fachlich passende Ziel der Migration
Seitentyp Zum Beispiel Kategorie, Ratgeber, Produktseite oder PDF
Priorität Hoch, mittel oder niedrig nach SEO- und Geschäftsrelevanz
Weiterleitungsstatus Geplant, umgesetzt, geprüft oder fehlerhaft
Inhaltliche Entscheidung Übernehmen, zusammenführen, überarbeiten oder entfernen

Die bestehende Website dokumentieren

Erfassen Sie vor dem Umzug mindestens Seitentitel, Meta-Beschreibungen, Überschriften, Canonical-URLs, Statuscodes, Indexierbarkeit, Wortlaut wichtiger Inhalte, interne Links und strukturierte Daten. Speichern Sie außerdem eine Liste der bestehenden XML-Sitemaps sowie der wichtigsten Landingpages. Bei mehrsprachigen Websites gehören Sprachversionen und hreflang-Beziehungen ebenfalls in die Dokumentation.

Vergleichen Sie die Daten mit der aktuellen Suchleistung. Notieren Sie Seiten, die für strategische Suchbegriffe sichtbar sind, regelmäßig organische Besuche erhalten oder über wertvolle externe Verweise verfügen. Diese Seiten benötigen beim Umzug besondere Aufmerksamkeit.

Eine Testumgebung einrichten

Die neue Website sollte vor dem Launch auf einer geschützten Testumgebung vollständig geprüft werden. Suchmaschinen dürfen diese Umgebung nicht versehentlich indexieren. Eine technische Zugriffsbeschränkung ist sicherer als eine alleinige robots.txt-Sperre, weil blockierte URLs weiterhin bekannt werden können. Prüfen Sie in der Testumgebung unter anderem Templates, Navigation, Formulare, Medien, Canonicals, Statuscodes und strukturierte Daten.

Testen Sie außerdem verschiedene URL-Varianten: mit und ohne www, HTTP und HTTPS, Groß- und Kleinschreibung sowie mögliche abschließende Schrägstriche. Das gewünschte Verhalten muss eindeutig sein. Jede nicht kanonische Variante sollte konsistent zur bevorzugten URL führen.

URL-Struktur und Weiterleitungen richtig umsetzen

Der häufigste SEO-Fehler bei einem Website-Umzug ist eine unvollständige oder falsche Weiterleitungskette. Für dauerhaft verschobene Inhalte verwenden Sie in der Regel permanente Weiterleitungen. Eine alte URL sollte möglichst direkt auf die fachlich passende neue URL zeigen, nicht zunächst auf eine Zwischenadresse.

Direkte Zuordnung statt Weiterleitung auf die Startseite

Leiten Sie einen alten Ratgeber auf den entsprechenden neuen Ratgeber weiter, eine alte Kategorie auf die passende neue Kategorie und eine entfernte Produktseite auf einen wirklich vergleichbaren Ersatz. Eine pauschale Weiterleitung vieler alter URLs auf die Startseite ist für Nutzer wenig hilfreich und kann die inhaltliche Beziehung verwässern. Gibt es kein sinnvolles neues Ziel, ist ein geeigneter Fehlerstatus oft ehrlicher als eine irreführende Weiterleitung.

Weiterleitungsketten und Schleifen vermeiden

Eine Weiterleitungskette entsteht, wenn URL A auf URL B und URL B wiederum auf URL C verweist. Solche Ketten erschweren Crawling und Diagnose. Noch problematischer sind Schleifen, bei denen URLs wechselseitig aufeinander verweisen. Testen Sie deshalb nicht nur die Zielseite, sondern die gesamte Kette jeder priorisierten URL.

Nach der Umsetzung sollten interne Links direkt auf die neuen URLs zeigen. Auch Canonical-Tags, hreflang-Verweise, XML-Sitemaps und strukturierte Daten dürfen nicht auf alte Adressen verweisen. Weiterleitungen sind primär für externe Zugriffe und alte Bookmarks da, nicht als dauerhafter Ersatz für eine bereinigte interne Verlinkung.

Inhalte, interne Verlinkung und Seitensignale erhalten

Bei einer Migration geht es nicht nur um technische Adressen. Suchmaschinen bewerten die Inhalte und deren Zusammenhang. Wenn der Umzug gleichzeitig viele Texte kürzt, Kategorien entfernt oder Suchintentionen verändert, lässt sich ein Rankingverlust nicht mehr eindeutig der Migration zuordnen.

Vergleichen Sie alte und neue Seiten deshalb inhaltlich. Prüfen Sie, ob wichtige Informationen, Begriffe, Überschriften, Medien und unterstützende Inhalte vorhanden sind. Das bedeutet nicht, alte Schwächen unverändert zu kopieren. Verbesserungen sind sinnvoll, sollten aber geplant und nachvollziehbar erfolgen.

Interne Links aktualisieren

Die interne Verlinkung hilft Suchmaschinen, Prioritäten und thematische Beziehungen zu verstehen. Nach dem Umzug sollten Navigationsmenüs, Brotkrümel, Footer-Links, Related-Content-Elemente und redaktionelle Verweise auf die neuen URLs zeigen. Suchen Sie zusätzlich nach Links auf alte Pfade, fehlerhafte Anker und verwaiste Seiten.

Achten Sie auf die Linktiefe wichtiger Inhalte. Eine Seite, die vor dem Relaunch mit wenigen Klicks erreichbar war, sollte nicht plötzlich nur noch über schwer auffindbare Archive erreichbar sein. Prüfen Sie auch, ob neue Filter- oder Sortierparameter unkontrolliert viele crawlbare URL-Varianten erzeugen.

Canonical, hreflang und strukturierte Daten

Canonical-Tags müssen auf die jeweils bevorzugte neue URL zeigen. Eine neue Seite mit einem Canonical auf eine alte Domain sendet widersprüchliche Signale. Bei mehreren Sprachversionen müssen hreflang-Angaben gegenseitig auf erreichbare, passende und indexierbare URLs verweisen. Prüfen Sie außerdem, ob strukturierte Daten noch zum sichtbaren Inhalt passen und keine veralteten Adressen enthalten.

Technische Checks vor dem Go-live

Vor der Veröffentlichung sollte die neue Website mit einem technischen Crawler und, soweit vorhanden, mit Server-Logdaten geprüft werden. Ziel ist nicht eine möglichst lange Fehlerliste, sondern die Behebung der Probleme, die Crawling, Indexierung, Nutzerführung oder relevante Inhalte beeinträchtigen.

  • Erreichbarkeit der wichtigsten Seiten mit dem erwarteten Statuscode
  • Keine versehentlichen noindex-Anweisungen auf wichtigen Seiten
  • Keine globale robots.txt-Sperre für zentrale Bereiche
  • Funktionierende Canonicals und interne Links
  • XML-Sitemap mit aktuellen, kanonischen und indexierbaren URLs
  • Korrekte HTTPS-Konfiguration und gültige Zertifikatskette
  • Funktionsfähige mobile Darstellung und verständliche Navigation
  • Keine unnötigen 404-Fehler bei wichtigen Zielseiten
  • Erreichbare Bilder, PDFs, CSS- und JavaScript-Ressourcen
  • Konfiguration von Weiterleitungen ohne Schleifen oder Ketten

Bewerten Sie Ladezeiten nicht nur anhand eines einzelnen Laborwerts. Prüfen Sie unterschiedliche Seitentypen, Geräte und Netzbedingungen. Ein technisch guter Wert auf der Startseite sagt wenig über eine schwere Produktdetailseite oder einen umfangreichen Ratgeber aus.

Der richtige Ablauf am Tag des Umzugs

Planen Sie den Go-live in ein Zeitfenster, in dem das zuständige Team erreichbar ist und Fehler kurzfristig beheben kann. Erstellen Sie vorher eine kurze Checkliste mit Verantwortlichkeiten, Rückfallplan und Kommunikationsweg. Sichern Sie die alte Website und Datenbank, bevor Sie Änderungen an DNS, Server oder CMS vornehmen.

  1. Letzten Inhaltsstand und relevante Konfigurationen sichern.
  2. Neue Website vollständig veröffentlichen und die Produktionsumgebung prüfen.
  3. Dauerhafte Weiterleitungen aktivieren und stichprobenartig sowie automatisiert testen.
  4. Canonical-Tags, interne Links, XML-Sitemap und robots.txt kontrollieren.
  5. Analyse- und Tracking-Funktionen auf korrekte Datenerfassung prüfen.
  6. Eigentümerschaft und bevorzugte Varianten in den verfügbaren Suchmaschinenwerkzeugen kontrollieren.
  7. Wichtige alte und neue URLs direkt auf Statuscode und Zielinhalt prüfen.
  8. Server- und Crawling-Fehler in den ersten Stunden eng überwachen.

Bei einem Domainwechsel sollten Sie die alte Domain nicht vorschnell abschalten. Sie wird für Weiterleitungen, alte Links und die Diagnose benötigt. Wie lange sie technisch aktiv bleibt, hängt von der Struktur und den Zugriffen ab; eine pauschale kurze Frist ist nicht für jedes Projekt geeignet.

Nach dem Umzug: Monitoring und Fehlerbehebung

Die Arbeit endet nicht mit dem Go-live. Suchmaschinen crawlen Websites nicht vollständig in einem einzigen Durchgang. Beobachten Sie deshalb die Entwicklung über mehrere Wochen und vergleichen Sie wichtige Kennzahlen mit dem vorher dokumentierten Zustand.

Kontrollieren Sie regelmäßig:

  • organische Sitzungen und Landingpages,
  • Impressionen, Klicks und durchschnittliche Positionen,
  • Indexierungs- und Crawling-Meldungen,
  • Serverfehler und Weiterleitungsfehler,
  • 404-Seiten sowie Soft-404-Signale,
  • Wiederkehrende Besucher und wichtige Conversion-Pfade,
  • Entwicklung der internen und externen Verlinkung.

Vergleichen Sie möglichst URL- und Seitentypen statt nur den Gesamttraffic. Ein Rückgang kann durch Saison, Marktveränderungen, Trackingfehler oder eine parallele Inhaltsänderung entstehen. Suchen Sie zuerst nach technischen Mustern: Sind ganze Verzeichnisse betroffen? Fehlen wichtige Weiterleitungen? Werden neue Seiten blockiert? Sind Canonicals oder hreflang-Angaben falsch?

Server-Logs können zeigen, welche alten URLs noch aufgerufen werden und ob Suchmaschinen auf unerwartete Pfade stoßen. Diese Daten ergänzen Berichte aus Analyse- und Suchmaschinenwerkzeugen, ersetzen sie aber nicht.

Häufige Fehler bei einem Website-Umzug

Die alte Website wird ohne Weiterleitungen abgeschaltet

Wenn alte Adressen plötzlich nicht mehr erreichbar sind, verlieren Nutzer und Suchmaschinen den Zusammenhang zwischen den Versionen. Erstellen Sie deshalb vor dem Abschalten der alten Infrastruktur eine geprüfte Zuordnung der wichtigsten URLs.

Alle alten Seiten führen zur Startseite

Eine zentrale Weiterleitung ist schnell eingerichtet, aber inhaltlich selten passend. Sie verschlechtert die Nutzerführung und kann wichtige Seitensignale nicht angemessen übertragen. Arbeiten Sie stattdessen mit möglichst präzisen Zielseiten.

Die Testumgebung bleibt für Suchmaschinen offen

Eine öffentlich erreichbare Kopie kann zu doppelten Inhalten und verwirrenden Signalen führen. Schützen Sie die Umgebung vor der Indexierung und entfernen Sie diesen Schutz beim Go-live nur von der Produktionswebsite.

Die neue Website wird zu stark verändert

Ein Relaunch ist eine gute Gelegenheit für Verbesserungen. Werden jedoch URL-Struktur, Inhalte, interne Links, Templates und Seitentypen gleichzeitig umfassend verändert, wird die Ursachenanalyse schwierig. Dokumentieren Sie jede geplante Änderung und priorisieren Sie Risiken.

Tracking wird nicht überprüft

Ein Ausfall der Messung kann wie ein SEO-Verlust aussehen. Prüfen Sie daher nach dem Umzug, ob Sitzungen, Conversions und Kampagnen korrekt erfasst werden und ob neue Datenschutz- oder Consent-Einstellungen die Messung beeinflussen.

FAQ

Kann ein Website-Umzug vollständig ohne Rankingverlust gelingen?

Ein gut vorbereiteter Umzug kann die bestehenden Signale weitgehend erhalten, eine Garantie gibt es jedoch nicht. Suchmaschinen bewerten Inhalte und Websites laufend neu. Je genauer URL-Zuordnung, Weiterleitungen, Inhalte und technische Signale umgesetzt werden, desto geringer ist das Risiko vermeidbarer Verluste.

Wie lange müssen Weiterleitungen bestehen bleiben?

Das hängt von alten Zugriffen, externen Links und der Bedeutung der URLs ab. Entfernen Sie Weiterleitungen nicht vorschnell. Bei einem Domainwechsel sollte die alte Domain weiterhin kontrolliert werden, solange Nutzer oder Suchmaschinen noch darauf zugreifen und die Weiterleitungen benötigt werden.

Ist ein Hostingwechsel ohne Domainänderung riskant?

Das Risiko ist meist geringer, wenn URLs unverändert bleiben. Probleme können trotzdem durch Ausfälle, langsamere Server, fehlerhafte DNS-Einstellungen, andere Sicherheitskonfigurationen oder versehentlich blockierte Ressourcen entstehen. Testen Sie Erreichbarkeit, Antwortzeiten und Crawling nach der Umstellung.

Was ist besser: alte Inhalte kopieren oder überarbeiten?

Übernehmen Sie die für Nutzer und Suchintention wichtigen Inhalte und verbessern Sie sie dort, wo es fachlich sinnvoll ist. Vermeiden Sie jedoch eine unkontrollierte Komplettüberarbeitung während der technischen Migration. Eine klare Dokumentation hilft, Veränderungen später einzuordnen.

Wie werden gelöschte Seiten behandelt?

Gibt es eine fachlich passende Nachfolgeseite, ist eine Weiterleitung sinnvoll. Existiert kein vergleichbares Ziel, sollte die Seite nicht automatisch auf die Startseite zeigen. Ein passender Fehlerstatus und eine hilfreiche Fehlerseite können in diesem Fall die bessere Lösung sein.

Wann sollte die neue XML-Sitemap eingereicht werden?

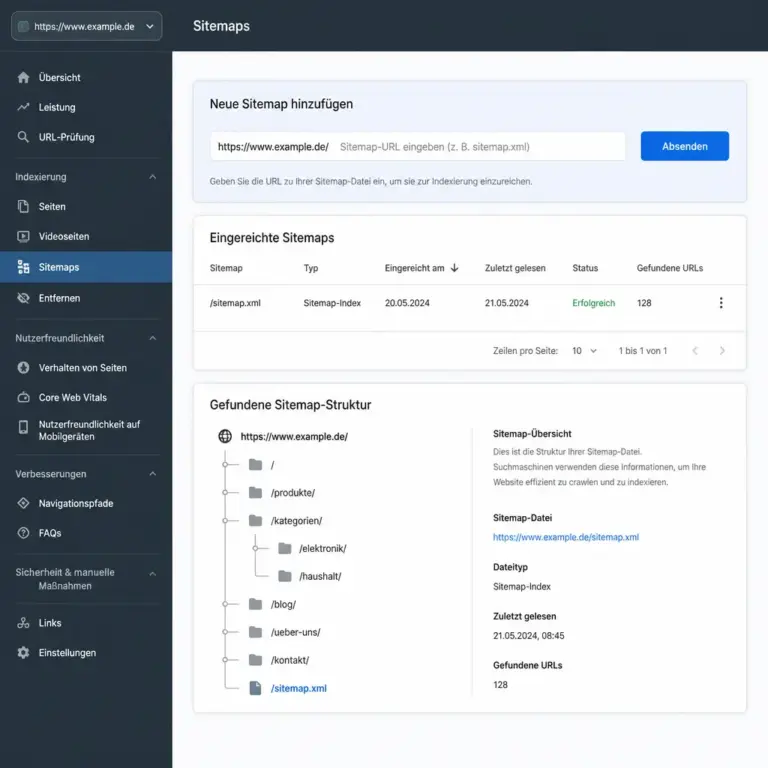
Nach dem Go-live sollte die Sitemap nur aktuelle, kanonische und indexierbare URLs enthalten. Prüfen Sie sie zuvor technisch und stellen Sie sicher, dass die darin aufgeführten Seiten tatsächlich erreichbar sind. Die Sitemap unterstützt die Entdeckung, ersetzt aber keine internen Links oder Weiterleitungen.

Wie erkennt man einen technischen Fehler nach dem Relaunch?

Achten Sie auf abrupte Veränderungen bei Indexierung, Crawling, organischem Traffic und Statuscodes. Prüfen Sie anschließend betroffene URL-Muster, robots.txt, noindex, Canonicals, Weiterleitungen, interne Links und Server-Logs. Ein Vergleich nach Seitentypen ist meist aussagekräftiger als eine reine Gesamtbetrachtung.

Fazit: Website-Umzug ohne Rankingverlust planbar machen

Ein Website-Umzug ohne Rankingverlust erfordert vor allem Vorbereitung und Kontrolle. Dokumentieren Sie die bestehende Website, priorisieren Sie wichtige URLs, ordnen Sie alte und neue Inhalte präzise zu und testen Sie Weiterleitungen direkt. Achten Sie außerdem auf interne Links, Canonicals, hreflang, XML-Sitemaps, Indexierbarkeit und Tracking.

Nach dem Go-live sollten Sie nicht auf eine einzelne Kennzahl reagieren, sondern Veränderungen systematisch untersuchen. Ein schrittweiser, nachvollziehbarer Prozess mit klarer Verantwortlichkeit reduziert Risiken und schafft die Grundlage dafür, dass Nutzer, Suchmaschinen und Ihr Team die neue Website zuverlässig verstehen.

SEO-Check nach einem Relaunch: Der umfassende Leitfaden für stabile Rankings

Ein Relaunch kann Design, Technik, Inhalte und URL-Strukturen einer Website grundlegend verändern. Genau darin liegt die Chance, die Nutzerführung zu verbessern und technische Altlasten zu beseitigen. Gleichzeitig können Weiterleitungen fehlen, wichtige Seiten aus dem Index verschwinden oder interne Verlinkungen ins Leere laufen. Ein gründlicher SEO-Check nach einem Relaunch hilft dabei, solche Probleme früh zu erkennen, ihre Auswirkungen einzuordnen und die organische Sichtbarkeit systematisch zu stabilisieren.

Dieser Ratgeber zeigt, welche Prüfungen unmittelbar nach dem Go-live wichtig sind, welche Daten verglichen werden sollten und wie sich Fehler nach Dringlichkeit priorisieren lassen. Der Ablauf eignet sich für kleine Unternehmensseiten ebenso wie für umfangreiche Shops, Portale und mehrsprachige Websites.

Warum ein SEO-Check nach dem Relaunch unverzichtbar ist

Vor dem Relaunch lässt sich eine Website planen und testen. Nach der Veröffentlichung zeigt sich jedoch erst unter realen Bedingungen, ob alle Bestandteile wie vorgesehen zusammenspielen. Suchmaschinen müssen die neue Website crawlen, alte URLs verarbeiten und die Signale der bisherigen Struktur richtig zuordnen. Nutzerinnen und Nutzer wiederum erwarten, dass bekannte Inhalte, Lesezeichen und Suchergebnisse weiterhin funktionieren.

Ein Relaunch kann unter anderem folgende Veränderungen mit sich bringen:

  • Neue URLs oder eine geänderte Verzeichnisstruktur
  • Entfernte, zusammengeführte oder neu angelegte Inhalte
  • Ein Wechsel des Content-Management-Systems
  • Veränderte interne Links und Navigationselemente
  • Neue Canonical-Tags, Meta-Robots-Angaben oder XML-Sitemaps
  • Andere Ladezeiten, JavaScript-Abhängigkeiten oder Serverkonfigurationen
  • Eine neue Domain, Subdomain, Sprachstruktur oder Protokollvariante

Nicht jeder Rückgang bei Klicks oder Rankings bedeutet automatisch einen Fehler. Nach größeren Änderungen kann sich die Bewertung einer Website zunächst neu einpendeln. Entscheidend ist deshalb eine Kombination aus technischer Kontrolle, Datenvergleich und einer Prüfung der wichtigsten Nutzerpfade.

Der richtige Zeitpunkt und die passende Reihenfolge

Der SEO-Check beginnt nicht erst Wochen nach der Veröffentlichung. Idealerweise wird bereits vor dem Relaunch eine Referenzaufnahme erstellt. Dazu gehören die wichtigsten URLs, organische Klicks und Impressionen, Indexierungsdaten, Rankings, Backlinks, Statuscodes, Seitentitel und zentrale Conversion-Pfade. Ohne diese Vergleichsbasis ist später schwer zu beurteilen, ob eine Veränderung durch den Relaunch oder durch saisonale und externe Faktoren entstanden ist.

Nach dem Go-live empfiehlt sich ein mehrstufiges Vorgehen:

Phase Schwerpunkt Ziel
Unmittelbar nach der Veröffentlichung Erreichbarkeit, Indexierungsblockaden und Weiterleitungen Kritische Fehler schnell ausschließen
In den ersten Tagen Crawling, Statuscodes, Canonicals, Sitemap und interne Links Die technische Verarbeitung der neuen Website prüfen
Nach etwa einer bis zwei Wochen Suchdaten, Landingpages und Fehlermuster Erste Auswirkungen erkennen und priorisieren
In den folgenden Wochen Rankings, Inhalte, Geschwindigkeit und Nutzerverhalten Nachhaltige Verbesserungen umsetzen

Diese Zeiträume sind keine starren Regeln. Bei einem großen Shop, einer Migration auf eine neue Domain oder einem internationalen Relaunch sollten die Kontrollen besonders engmaschig erfolgen.

Technische Erreichbarkeit und Indexierung prüfen

Die erste Frage lautet: Ist die neue Website für Nutzer und Suchmaschinen erreichbar? Öffnen Sie die Startseite, wichtige Kategorie- oder Leistungsseiten, redaktionelle Inhalte und zentrale Kontakt- oder Kaufpfade. Prüfen Sie die Website dabei nicht nur angemeldet oder aus dem eigenen Netzwerk, sondern unter realistischen Bedingungen.

Besonders wichtig sind folgende Kontrollen:

  • Die Website verwendet die gewünschte HTTPS-Version und leitet alternative Varianten korrekt weiter.
  • Die bevorzugte Domain ist eindeutig festgelegt.
  • Es gibt keine versehentlich aktivierte Passwortabfrage oder Wartungsseite.
  • Wichtige Seiten sind nicht durch noindex, nofollow oder eine blockierende robots.txt ausgeschlossen.
  • Die XML-Sitemap ist erreichbar und enthält nur relevante, kanonische URLs.
  • Die wichtigsten Seitentypen können ohne problematische Abhängigkeit von blockiertem JavaScript geladen werden.

Ein häufiger Relaunch-Fehler besteht darin, Testumgebungs-Einstellungen in die Live-Website zu übernehmen. Dazu zählen globale Noindex-Anweisungen, gesperrte Verzeichnisse oder eine nicht öffentlich zugängliche Sitemap. Auch ein einzelner falscher Regelblock in der robots.txt kann große Teile einer Website betreffen. Deshalb sollte die Datei nicht nur vorhanden sein, sondern inhaltlich auf die neue Struktur abgestimmt werden.

Weiterleitungen und alte URLs systematisch kontrollieren

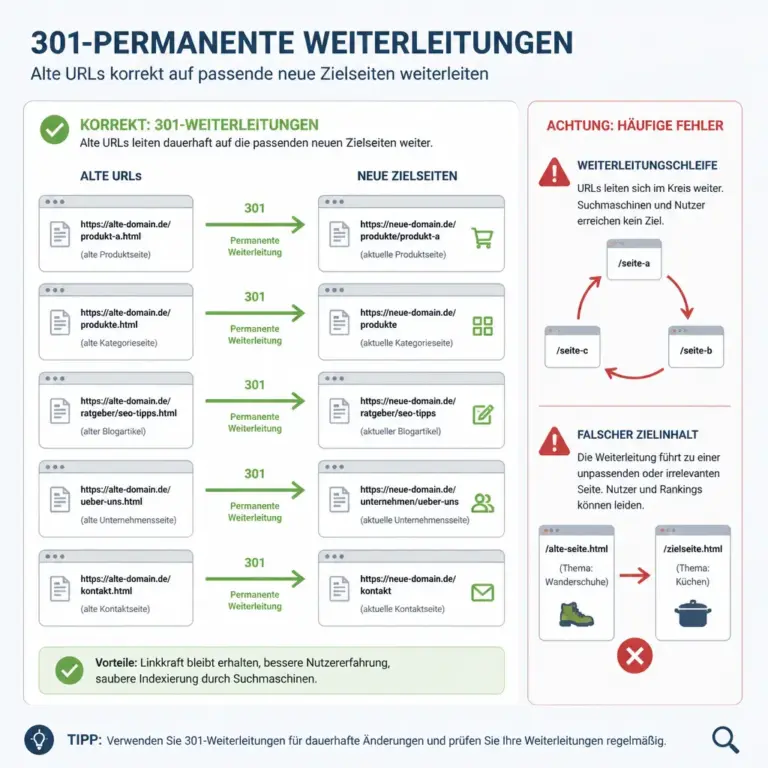
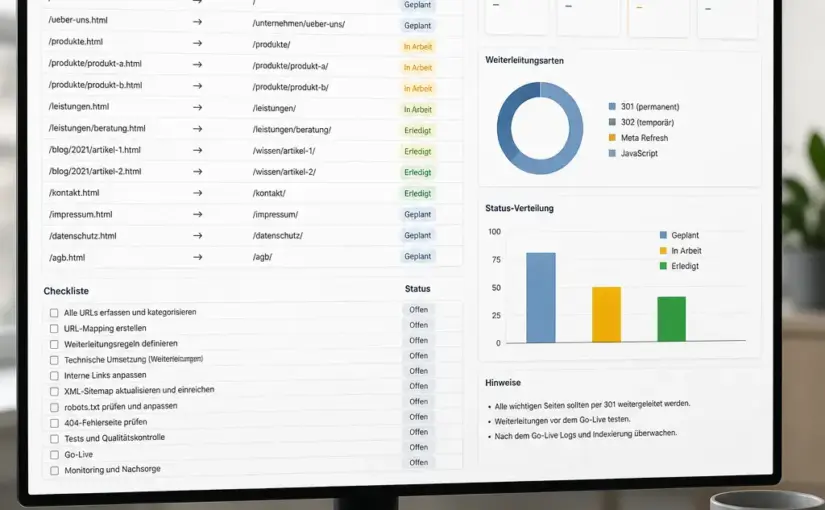
Schaubild zu Weiterleitungen von alten auf passende neue URLs nach einem Relaunch
Passende Weiterleitungen verbinden alte URLs mit den jeweils relevanten neuen Zielseiten.

Die Grafik macht sichtbar, warum eine alte URL nicht pauschal auf die Startseite führen sollte. Entscheidend ist die inhaltliche Zuordnung und eine möglichst direkte Weiterleitung ohne Schleifen.

Wenn URLs geändert wurden, gehören Weiterleitungen zu den wichtigsten Bestandteilen des Relaunches. Eine alte, weiterhin verlinkte oder gut bekannte URL sollte möglichst auf die inhaltlich passende neue Zielseite führen. Eine pauschale Weiterleitung sämtlicher alter URLs auf die Startseite ist meist keine gute Lösung, weil sie den ursprünglichen Such- und Nutzungszweck nicht präzise abbildet.

Erstellen Sie eine Liste aller relevanten alten URLs. Dafür können unter anderem frühere Sitemaps, Serverdaten, Analytics-Daten, Backlink-Auswertungen und bestehende Crawling-Exporte herangezogen werden. Prüfen Sie anschließend:

  • Erreicht jede wichtige alte URL den passenden neuen Inhalt?
  • Antwortet die Weiterleitung direkt mit einem permanenten Weiterleitungsstatus?
  • Gibt es Weiterleitungsketten oder Schleifen?
  • Verweisen interne Links noch auf alte Adressen?
  • Werden nicht mehr benötigte URLs bewusst mit einem passenden Fehlerstatus behandelt?
  • Führen Weiterleitungen nicht auf irrelevante Seiten oder automatisch erzeugte Fehlerseiten?

Eine Weiterleitung ist nicht nur eine technische Maßnahme für Suchmaschinen. Sie schützt auch externe Verweise, gespeicherte Lesezeichen und wiederkehrende Nutzer. Besonders sorgfältig sollten Sie URLs mit vielen externen Links, hoher historischer Sichtbarkeit oder geschäftlicher Bedeutung behandeln.

Canonical-Tags, Statuscodes und Indexsignale

Jede indexierbare Seite sollte ein klares Signal darüber geben, welche URL als bevorzugte Version gilt. Nach einem Relaunch können Canonical-Tags versehentlich auf die alte Domain, eine Testumgebung, eine falsche Sprachvariante oder eine übergeordnete Seite zeigen. Auch selbstreferenzielle Canonicals müssen zur tatsächlich aufgerufenen, dauerhaft gültigen URL passen.

Bei einem technischen Crawl sollten Sie mindestens diese Statusgruppen auswerten:

Status oder Signal Worauf zu achten ist
Erfolgreiche Seitenaufrufe Die Inhalte sind erreichbar und liefern den erwarteten Seitentyp aus.
Permanente Weiterleitungen Die Zieladresse ist relevant und die Weiterleitung erfolgt möglichst ohne unnötige Zwischenstation.
Temporäre Weiterleitungen Sie sollten nur eingesetzt werden, wenn die Änderung tatsächlich vorübergehend ist.
Fehlerseiten Fehlende Inhalte müssen bewusst bewertet und gegebenenfalls sinnvoll ersetzt oder weitergeleitet werden.
Serverfehler Wiederkehrende Fehler können Crawling, Nutzung und Conversion-Prozesse beeinträchtigen.

Vergleichen Sie außerdem die Indexierungsdaten vor und nach dem Relaunch. Ein größerer Rückgang kann auf entfernte Inhalte, technische Sperren, fehlende interne Links oder eine unvollständige Sitemap hinweisen. Ein kurzfristiger Ausschlag allein ist noch keine abschließende Diagnose; das Muster über mehrere Zeitpunkte ist aussagekräftiger.

Interne Verlinkung und Website-Struktur bewerten

Interne Links helfen Nutzern bei der Orientierung und geben Suchmaschinen Hinweise auf die Bedeutung und thematische Verbindung von Seiten. Bei einem Relaunch werden Menüs, Footer, Filter, Breadcrumbs und redaktionelle Verweise häufig neu aufgebaut. Dadurch können wichtige Seiten weniger interne Verweise erhalten oder vollständig isoliert werden.

Prüfen Sie insbesondere:

  • Ob zentrale Seiten von der Startseite oder passenden Übersichtsseiten erreichbar sind
  • Ob Breadcrumbs die tatsächliche Hierarchie widerspiegeln
  • Ob interne Links auf Weiterleitungen oder nicht mehr vorhandene URLs zeigen
  • Ob Ankertexte verständlich und thematisch passend formuliert sind
  • Ob Filter- und Suchseiten unkontrolliert zahlreiche URL-Varianten erzeugen
  • Ob wichtige Inhalte mit vertretbarer Klicktiefe erreichbar sind

Eine klare Struktur ist besonders bei umfangreichen Websites relevant. Kategorien, Leistungen, Produkte und Ratgeber sollten nachvollziehbar miteinander verbunden sein. Dabei geht es nicht darum, möglichst viele Links zu platzieren. Besser sind wenige, kontextbezogene Verweise, die einen echten nächsten Schritt anbieten.

Inhalte, Seitentitel und Suchintention nach dem Relaunch

Ein technischer Relaunch kann inhaltliche Veränderungen verdecken. Prüfen Sie deshalb, ob wichtige Inhalte vollständig übernommen wurden und ob die neue Seite weiterhin die Absicht der jeweiligen Suchanfrage erfüllt. Werden Texte gekürzt, Überschriften geändert oder zentrale Abschnitte entfernt, kann sich die Relevanz einer URL verändern, auch wenn sie technisch erreichbar bleibt.

Eine praktische Inhaltsprüfung umfasst:

  • Seitentitel und Meta-Beschreibungen für wichtige Landingpages
  • Eine eindeutige Hauptüberschrift und logisch gegliederte Zwischenüberschriften
  • Vollständige, verständliche und zielgruppengerechte Texte
  • Passende interne Verweise auf ergänzende Inhalte
  • Beschreibende Alternativtexte für informative Bilder
  • Strukturierte Daten nur dort, wo sie den sichtbaren Inhalt korrekt beschreiben
  • Übernommene oder neu formulierte Inhalte ohne unbeabsichtigte Dopplungen

Ein SEO-Check sollte nicht ausschließlich auf einzelne Keywords ausgerichtet sein. Fragen Sie stattdessen: Welche Aufgabe soll diese Seite erfüllen? Welche Informationen erwartet die Zielgruppe? Ist der nächste Schritt klar? Und unterscheidet sich der Inhalt ausreichend von ähnlichen Seiten der eigenen Website?

Mobile Darstellung, Ladezeit und technische Nutzererfahrung

Ein Relaunch bietet die Gelegenheit, die mobile Nutzung zu verbessern, kann aber auch neue Probleme einführen. Testen Sie wichtige Seiten auf unterschiedlichen Bildschirmgrößen und mit verschiedenen Eingabemethoden. Achten Sie auf abgeschnittene Inhalte, überlappende Elemente, schwer bedienbare Schaltflächen, unleserliche Schrift und störende Einblendungen.

Bei der Ladezeit sollten Sie nicht nur den ersten Seitenaufruf betrachten. Prüfen Sie auch:

  • Ob große Bilder angemessen komprimiert und in passenden Dimensionen ausgeliefert werden
  • Ob unnötige Skripte oder externe Ressourcen die Darstellung verzögern
  • Ob Layout-Verschiebungen durch nachträglich geladene Elemente entstehen
  • Ob zentrale Inhalte auch bei langsamer Verbindung früh sichtbar werden
  • Ob interaktive Funktionen auf mobilen Geräten zuverlässig reagieren

Technische Messwerte sind nützlich, ersetzen aber nicht die qualitative Prüfung. Eine Seite kann einzelne Messwerte erfüllen und sich trotzdem unübersichtlich oder langsam anfühlen. Bewerten Sie deshalb reale Nutzungssituationen und priorisieren Sie Probleme, die wichtige Inhalte, Navigation oder Geschäftsziele beeinträchtigen.

Datenvergleich: Sichtbarkeit, Klicks und wichtige Landingpages

Nach dem Relaunch sollten die organischen Daten regelmäßig mit einem passenden Zeitraum vor der Veröffentlichung verglichen werden. Je nach Website können saisonale Schwankungen, Kampagnen, Marktveränderungen oder technische Ausfälle die Ergebnisse beeinflussen. Ein Vergleich mit einem ähnlichen Zeitraum kann deshalb hilfreicher sein als ein reiner Vergleich mit den unmittelbar vorhergehenden Tagen.

Analysieren Sie nicht nur die Gesamtsumme, sondern segmentieren Sie die Daten nach:

  • Marken- und Nicht-Marken-Suchanfragen
  • Gerätetypen und wichtigen Ländern oder Sprachversionen
  • Seitentypen wie Startseite, Kategorie, Produkt, Leistung und Ratgeber
  • Verzeichnissen oder URL-Mustern
  • Wichtigen Suchanfragen und Landingpages

Ein Rückgang bei einer einzelnen Seite kann eine inhaltliche Ursache haben. Ein Rückgang über einen ganzen Seitentyp deutet eher auf ein strukturelles oder technisches Problem hin. Steigen Impressionen, während Klicks sinken, sollten Titel und Beschreibung sowie die Positionen und Suchintentionen genauer betrachtet werden. Sinkt dagegen die Zahl der Impressionen deutlich, sind Indexierung, Weiterleitungen, Inhalte und interne Verlinkung besonders wichtig.

Fehler priorisieren und einen Maßnahmenplan erstellen

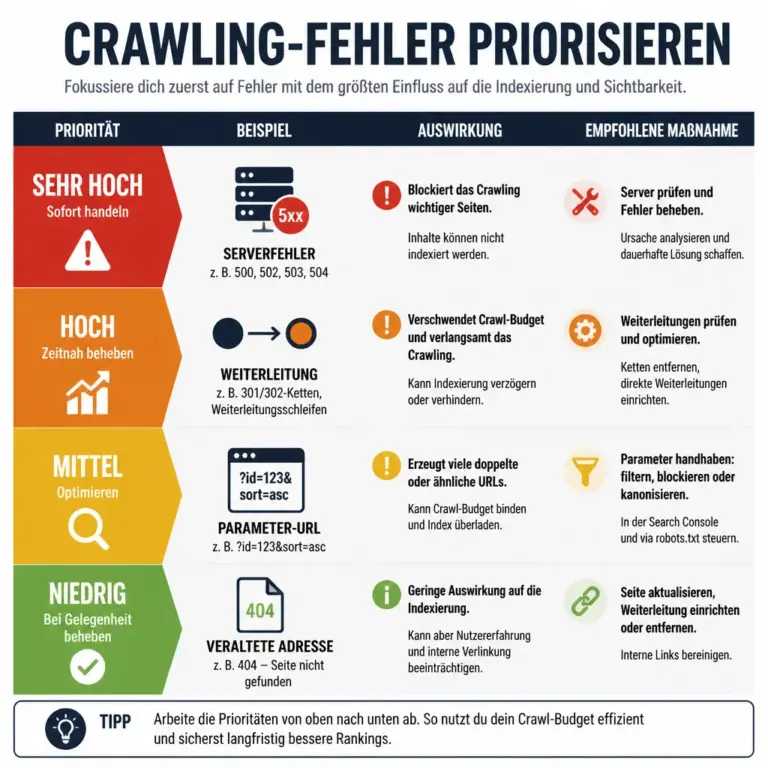
Ein Audit liefert häufig mehr Hinweise, als unmittelbar bearbeitet werden können. Priorisieren Sie deshalb anhand von Auswirkung, Reichweite und Aufwand. Ein Fehler auf einer zentralen Vorlage ist in der Regel dringlicher als ein einzelner defekter Link auf einer wenig besuchten Unterseite.

Priorität Typische Beispiele Empfohlene Reaktion
Sehr hoch Globale Noindex-Sperre, falsche Domain, nicht erreichbare Kernseiten, fehlende Weiterleitungen wichtiger URLs Sofort prüfen, beheben und anschließend erneut kontrollieren
Hoch Fehlerhafte Canonicals, viele Serverfehler, defekte zentrale Navigation, starke mobile Einschränkungen In einem priorisierten technischen Sprint bearbeiten
Mittel Weiterleitungsketten, unvollständige Metadaten, schwache interne Verlinkung einzelner Seitentypen Nach Seitentyp bündeln und systematisch verbessern
Niedrig Einzelne unkritische Altlinks oder redaktionelle Detailprobleme In den laufenden Optimierungsprozess aufnehmen

Dokumentieren Sie für jede Maßnahme die betroffenen URLs, die vermutete Ursache, die verantwortliche Person oder Rolle, den geplanten Termin und das Prüfergebnis. So wird aus einer einmaligen Kontrolle ein nachvollziehbarer Verbesserungsprozess. Nach jeder größeren Änderung sollte der betroffene Bereich erneut gecrawlt oder manuell kontrolliert werden.

Häufige Fehler beim SEO-Check nach einem Relaunch

Nur die Startseite prüfen

Die Startseite kann funktionieren, während wichtige Produkt-, Kategorie- oder Ratgeberseiten Fehler ausgeben. Prüfen Sie deshalb typische Vorlagen und repräsentative URLs jedes wichtigen Seitentyps.

Alte Rankings ohne Kontext vergleichen

Rankings schwanken und hängen von Suchanfrage, Standort, Gerät und Wettbewerb ab. Kombinieren Sie Positionsdaten mit Klicks, Impressionen, Indexierung und der Entwicklung konkreter Landingpages.

Alle alten URLs auf die Startseite leiten

Eine solche Sammellösung ist schnell umgesetzt, passt aber häufig nicht zur ursprünglichen Suchintention. Ordnen Sie alte URLs möglichst präzisen neuen Zielen zu und behandeln Sie ersatzlose Inhalte bewusst.

Weiterleitungen nur einmal kontrollieren

Neue Links, Kampagnen oder nachträgliche Inhaltsänderungen können weitere Fehler verursachen. Ein wiederholter Check nach einigen Tagen und Wochen ist sinnvoll.

Nur technische Kennzahlen betrachten

Ein technisch sauberer Auftritt ist die Grundlage, aber kein vollständiger SEO-Erfolg. Inhalte, Verständlichkeit, interne Verlinkung und die tatsächliche Nutzeraufgabe gehören ebenfalls in die Bewertung.

FAQ

Wie schnell sollte der SEO-Check nach einem Relaunch beginnen?

Die erste Kontrolle sollte direkt nach der Veröffentlichung erfolgen. Erreichbarkeit, Indexierungsblockaden, Weiterleitungen und die wichtigsten Nutzerpfade dürfen nicht erst nach einem deutlichen Sichtbarkeitsverlust geprüft werden. Danach folgen detaillierte Crawls und Datenvergleiche in mehreren Abständen.

Wie lange dauert es, bis sich die Auswirkungen eines Relaunches zeigen?

Das hängt von Größe, Änderungsumfang, Crawling und Aktualisierung der Website ab. Technische Fehler können sofort auffallen, während sich Veränderungen bei Indexierung und Rankings zeitversetzt zeigen. Deshalb sollten kurzfristige Schwankungen nicht isoliert bewertet werden.

Was ist wichtiger: Weiterleitungen oder neue Inhalte?

Beides erfüllt unterschiedliche Aufgaben. Weiterleitungen schützen bestehende URL-Signale und Nutzerpfade, während gute Inhalte die Relevanz der neuen Seiten sichern. Bei einem Relaunch mit geänderten URLs sollten Weiterleitungen zuerst zuverlässig funktionieren; anschließend werden Inhalte und Seitentypen vertieft optimiert.

Wie viele alte URLs müssen geprüft werden?

Mindestens alle alten URLs mit organischem Traffic, externen Links, hoher Bedeutung oder wiederkehrender Nutzung. Bei großen Websites sollte die vollständige URL-Menge automatisiert ausgewertet und zusätzlich eine priorisierte Stichprobe manuell kontrolliert werden.

Ist ein Rückgang der Rankings nach dem Relaunch immer problematisch?

Nein. Eine vorübergehende Veränderung kann durch neue Crawling- und Bewertungsprozesse entstehen. Problematisch wird sie vor allem dann, wenn wichtige Seiten dauerhaft nicht indexiert werden, relevante Weiterleitungen fehlen oder ein Seitentyp deutlich an Sichtbarkeit verliert. Die Ursache muss anhand mehrerer Datenquellen geprüft werden.

Welche Daten sollte ich vor dem Relaunch sichern?

Sinnvoll sind unter anderem wichtige URLs, organische Klicks und Impressionen, Landingpages, Suchanfragen, Rankings, Statuscodes, Seitentitel, Canonicals, interne Links und bekannte Weiterleitungen. Zusätzlich sollten zentrale Conversion- oder Kontaktpfade dokumentiert werden.

Brauche ich für jede Website ein umfassendes SEO-Tool?

Ein Tool kann Crawling, Vergleiche und Priorisierung erleichtern. Für einen grundlegenden Check sind jedoch auch manuelle Browserprüfungen, Server- oder Analysezugänge und eine sorgfältig gepflegte URL-Liste wichtig. Entscheidend ist nicht nur das Werkzeug, sondern die Qualität der Interpretation.

Fazit: Den Relaunch als fortlaufenden Prüfprozess verstehen

Ein SEO-Check nach einem Relaunch sollte technische Erreichbarkeit, Weiterleitungen, Indexierung, interne Verlinkung, Inhalte, mobile Nutzung und organische Daten gemeinsam betrachten. Beginnen Sie mit den potenziell folgenschwersten Fehlern, vergleichen Sie die neue Website mit einer belastbaren Ausgangsbasis und dokumentieren Sie jede Korrektur.

Der Relaunch ist nicht mit dem Go-live abgeschlossen. Regelmäßige Kontrollen helfen dabei, neue Fehler früh zu erkennen und die Website anhand realer Such- und Nutzungsdaten weiterzuentwickeln. So wird aus der einmaligen Migration eine verlässliche Grundlage für langfristige Sichtbarkeit und eine bessere Nutzererfahrung.

Domain analysieren: Darauf kommt es an

Wer eine Domain analysieren möchte, sollte nicht nur auf den Namen oder eine einzelne Kennzahl schauen. Eine belastbare Einschätzung verbindet technische Daten, Suchmaschinen-Signale, Markenwirkung, rechtliche Risiken und die bisherige Nutzung. Das gilt beim Kauf einer gebrauchten Domain ebenso wie bei der Prüfung einer bestehenden Website oder der Auswahl eines neuen Projektnamens.

Dieser Ratgeber zeigt, welche Informationen wirklich relevant sind, wie du die Prüfung sinnvoll strukturierst und welche Warnzeichen besondere Aufmerksamkeit verdienen. Dabei geht es nicht darum, eine scheinbar exakte Bewertung aus wenigen Daten abzuleiten, sondern eine nachvollziehbare Entscheidungsgrundlage zu schaffen.

Was bedeutet es, eine Domain zu analysieren?

Eine Domainanalyse ist eine systematische Prüfung der Internetadresse und ihres Umfelds. Untersucht werden unter anderem die Historie, die technische Erreichbarkeit, die Verlinkung, die Sichtbarkeit in Suchmaschinen, die inhaltliche Ausrichtung und mögliche rechtliche Konflikte. Je nach Ziel kann der Schwerpunkt unterschiedlich ausfallen.

  • Beim Kauf: Du möchtest erkennen, ob die Domain wertvolle Signale, Risiken oder eine problematische Vergangenheit mitbringt.
  • Bei einer bestehenden Website: Du suchst Ursachen für schlechte Sichtbarkeit, technische Fehler oder einen Rückgang des organischen Traffics.
  • Bei einem Relaunch: Du prüfst, welche alten URLs, Weiterleitungen und Inhalte erhalten bleiben sollten.
  • Vor einer Neuregistrierung: Du willst ausschließen, dass der Name bereits mit Spam, Betrug oder einem unpassenden Thema verbunden war.

Wichtig ist die Unterscheidung zwischen einer Domain und einer Website. Die Domain ist zunächst die Adresse. Ihr Wert und ihre Risiken hängen jedoch stark davon ab, welche Inhalte dort veröffentlicht wurden, welche Links auf sie zeigen und wie Suchmaschinen sowie Nutzer sie bisher wahrgenommen haben.

Die wichtigsten Prüfbereiche im Überblick

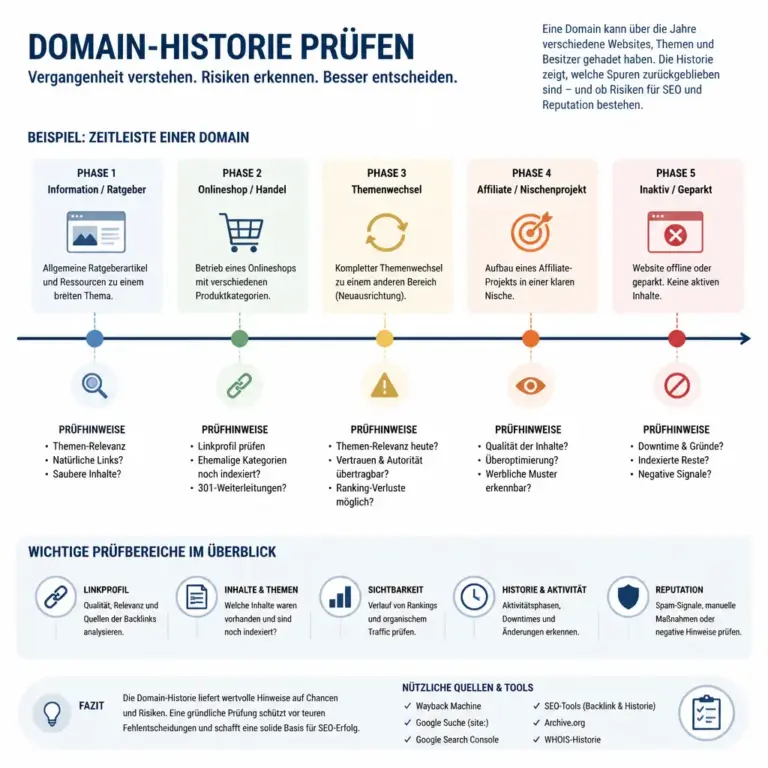
Zeitleiste zur Pru00fcfung der historischen Nutzung einer Domain
Eine Zeitleiste macht frühere Themen und auffällige Wechsel sichtbar.

Die Darstellung zeigt, warum die frühere Nutzung einer Domain nicht nur nach dem Alter beurteilt werden sollte. Achte besonders auf Themenwechsel, längere Leerstände und ungewöhnliche Nutzungsphasen.

Eine gute Analyse lässt sich in mehrere Perspektiven aufteilen. Keine einzelne Kennzahl ersetzt die Gesamtbetrachtung. Ein hoher Wert in einem SEO-Tool kann beispielsweise durch viele minderwertige Links entstehen, während eine Domain mit wenig sichtbarer Historie für eine starke Marke dennoch interessant sein kann.

Prüfbereich Wichtige Fragen Typische Warnzeichen
Historie Welche Inhalte und Themen gab es früher? Häufige Themenwechsel, Spam, automatisch erzeugte Seiten
Backlinks Wer verlinkt, mit welchem Text und aus welchem Umfeld? Linknetzwerke, irrelevante Seiten, unnatürliche Ankertexte
Suchmaschinen Ist die Domain sichtbar und sind wichtige Seiten indexiert? Starker Sichtbarkeitsverlust, viele Ausschlüsse, manuelle Maßnahmen
Technik Funktionieren DNS, HTTPS, Weiterleitungen und Serverantworten? Fehlerhafte Zertifikate, Redirect-Ketten, instabile Erreichbarkeit
Marke und Recht Ist der Name verständlich und rechtlich unbedenklich? Verwechslungsgefahr, geschützte Begriffe, irreführende Schreibweise

Beginne am besten mit einer groben Bestandsaufnahme und vertiefe anschließend auffällige Punkte. So vermeidest du, dich früh an einer einzelnen Metrik festzuhalten.

Domain-Historie und frühere Inhalte prüfen

Die Vergangenheit einer Domain kann ihre heutige Bewertung deutlich beeinflussen. Eine Adresse, die über Jahre thematisch konsistent genutzt wurde, ist anders einzuschätzen als eine Domain, die mehrfach den Besitzer und das Thema gewechselt hat. Für die Prüfung brauchst du keine lückenlose Rekonstruktion jeder einzelnen Unterseite. Entscheidend sind wiederkehrende Muster und besonders auffällige Phasen.

Welche historischen Fragen wichtig sind

  • Seit wann ist die Domain registriert oder öffentlich genutzt?
  • Welche Themen, Sprachen und Zielgruppen waren früher erkennbar?
  • Gab es längere Phasen ohne Inhalte oder mit technischen Fehlern?
  • Wurde die Domain als normale Website, Weiterleitungsseite, Shop, Blog oder Parkplatz genutzt?
  • Gab es Hinweise auf automatisch erstellte Texte, Download-Seiten, Glücksspiel, Erotik oder andere Inhalte, die nicht zum geplanten Projekt passen?
  • Wie oft änderten sich Betreiber, Design, Sprache und Geschäftsmodell?

Archivaufnahmen können einen hilfreichen Eindruck vermitteln, sind aber nicht vollständig. Nicht jede Version einer Website wurde gespeichert, und einzelne Screenshots beweisen nicht, dass eine Domain durchgehend so betrieben wurde. Ergänze die historische Betrachtung daher durch technische Daten, Linkanalysen und öffentlich erkennbare Unternehmensinformationen.

Thematische Kontinuität bewerten

Eine thematische Nähe zwischen früherer und geplanter Nutzung ist häufig vorteilhaft, weil alte Verweise und Erwartungen besser zusammenpassen können. Sie ist jedoch keine Garantie für gute Rankings. Wenn du eine Domain mit einer völlig neuen Ausrichtung übernehmen möchtest, solltest du besonders genau prüfen, ob alte Backlinks noch sinnvoll sind und ob Nutzer nach dem Wechsel auf den erwarteten Inhalt treffen.

Ein harter Themenbruch ist nicht automatisch ein Ausschlusskriterium. Er wird problematisch, wenn zusätzlich viele irrelevante Links, unklare Eigentümerwechsel oder sichtbare Spam-Muster auftreten.

Backlinks sorgfältig analysieren

Backlinks sind Verweise von anderen Websites auf die Domain. Bei ihrer Bewertung zählt nicht die bloße Anzahl, sondern die Qualität und Plausibilität des gesamten Linkprofils. Ein einzelner redaktioneller Link aus einem passenden Fachumfeld kann aussagekräftiger sein als zahlreiche Verweise von Seiten ohne erkennbaren Mehrwert.

Qualität statt Menge

Prüfe zunächst, ob die verlinkenden Seiten selbst vertrauenswürdig und thematisch nachvollziehbar sind. Achte auf echte redaktionelle Inhalte, eine erkennbare Zielgruppe und einen plausiblen Zusammenhang zwischen verlinkender Seite und Zielseite. Links aus verschiedenen, unabhängigen Quellen wirken in der Regel natürlicher als viele nahezu identische Verweise.

Ein Linkprofil sollte außerdem nicht nur aus Startseitenlinks bestehen. Unterschiedliche Zielseiten und natürlich wirkende Linktexte können ein Hinweis auf organisch gewachsene Verlinkung sein. Das ist lediglich ein Indiz, keine abschließende Bewertung.

Warnzeichen im Linkprofil

  • Viele Links von Domains, die keinen erkennbaren redaktionellen Zweck haben.
  • Ungewöhnlich viele Verweise mit exakt gleichem kommerziellem Suchbegriff.
  • Links aus thematisch völlig unpassenden Ländern oder Sprachräumen.
  • Netzwerke mit ähnlichen Layouts, Impressumsangaben oder IP-Strukturen.
  • Verlinkungen von Seiten mit automatisch erzeugten Texten oder offensichtlichem Spam.
  • Sehr viele neue Links in kurzer Zeit ohne nachvollziehbaren Anlass.

Beurteile Links nicht vorschnell nur anhand eines automatischen Qualitätswerts. Solche Werte sind nützlich für die Vorauswahl, ersetzen aber keine Stichprobe. Öffne mehrere verlinkende Seiten, lies den Kontext und prüfe, ob der Link für Nutzer tatsächlich hilfreich ist.

Sichtbarkeit, Indexierung und Suchintention untersuchen

Bei der SEO-Analyse geht es nicht nur darum, ob eine Domain für einzelne Begriffe erscheint. Entscheidend ist, ob die sichtbaren Inhalte zur geplanten Ausrichtung passen, ob wichtige Seiten indexiert sind und ob die Domain offenbar stabile oder stark schwankende Entwicklungen zeigt.

Untersuche möglichst:

  • Welche URLs aktuell in Suchmaschinen auffindbar sind.
  • Für welche Themen und Suchintentionen die Domain sichtbar ist.
  • Ob die wichtigsten Rankings auf hilfreichen, noch erreichbaren Seiten liegen.
  • Ob alte URLs viele externe Verweise erhalten und deshalb beim Relaunch relevant sind.
  • Ob es deutliche Einbrüche oder ungewöhnliche Ausschläge in historischen Sichtbarkeitsdaten gibt.

Tool-Daten sind immer abhängig von Datenbasis, Aktualisierungsintervall und Modell. Deshalb solltest du einen Rückgang nicht automatisch als Abstrafung interpretieren. Mögliche Ursachen sind beispielsweise ein Relaunch, saisonale Nachfrage, technische Nichterreichbarkeit, eine veränderte Suchintention oder die Umstellung eines Suchsystems.

Indexierung ist kein Qualitätsbeweis

Dass Seiten indexiert sind, bedeutet nur, dass sie in den Suchindex aufgenommen wurden. Es sagt nicht automatisch etwas über ihre Qualität oder langfristige Sichtbarkeit aus. Umgekehrt kann eine gute Seite vorübergehend fehlen, wenn sie neu ist, technisch blockiert wird oder noch nicht erneut gecrawlt wurde.

Prüfe daher die Kombination aus Indexierung, Inhalt, internen Verlinkungen, Serverstatus und Suchintention. Besonders kritisch sind wichtige Seiten mit dem Statuscode 200, die für Nutzer kaum Inhalt bieten, sowie zahlreiche nahezu identische URLs.

Technische Domainanalyse

Technische Fehler können die Nutzung, das Crawling und die Weiterleitung von Signalen beeinträchtigen. Die Prüfung sollte sowohl die Domainverwaltung als auch die Website selbst umfassen.

DNS, HTTPS und Erreichbarkeit

  • Zeigen A- und AAAA-Einträge auf die vorgesehenen Server?
  • Funktionieren www- und Nicht-www-Version konsistent?
  • Ist ein gültiges HTTPS-Zertifikat für alle relevanten Hostnamen eingerichtet?
  • Gibt es unnötige Weiterleitungsketten oder Weiterleitungsschleifen?
  • Liefern wichtige URLs den erwarteten Statuscode?
  • Sind E-Mail-DNS-Einträge korrekt, falls die Domain für geschäftliche E-Mails genutzt wird?

Ein sauberer technischer Zustand verhindert nicht allein Rankingprobleme, schafft aber eine verlässliche Grundlage. Dokumentiere bei der Prüfung, welche Variante als Hauptversion gelten soll und wohin alte URLs weiterleiten.

Robots, Sitemap und Canonical

Die Datei robots.txt kann das Crawling steuern, darf aber nicht mit einer vollständigen Deindexierung verwechselt werden. Prüfe, ob wichtige Bereiche versehentlich blockiert werden. Eine XML-Sitemap sollte nur relevante, erreichbare und kanonische URLs enthalten. Canonical-Angaben müssen zur tatsächlichen Seitenstruktur passen und dürfen nicht pauschal auf eine falsche Zielseite zeigen.

Bei einer übernommenen Domain können alte Regeln, Testumgebungen oder temporäre Sperren zurückgeblieben sein. Kontrolliere deshalb Konfigurationen nach einem Besitzerwechsel und entferne nicht blind alle bestehenden Einstellungen.

Markenwirkung und rechtliche Risiken

Eine Domain muss nicht nur technisch funktionieren, sondern auch zur geplanten Marke passen. Kurze Namen sind nicht automatisch besser. Verständlichkeit, Aussprache, Schreibweise, Merkfähigkeit und die Verfügbarkeit passender Social-Media- oder Produktbezeichnungen können wichtiger sein als eine vermeintlich attraktive Kürze.

Vor einer Registrierung oder einem Kauf solltest du prüfen:

  • Ob der Name mit bestehenden Unternehmens-, Produkt- oder Markenbezeichnungen kollidieren könnte.
  • Ob die Schreibweise zu Verwechslungen mit bekannten Angeboten führt.
  • Ob Bindestriche, Sonderzeichen oder ungewöhnliche Endungen die Kommunikation erschweren.
  • Ob der Name in den relevanten Ländern und Sprachen unbeabsichtigte Bedeutungen besitzt.
  • Ob die bisherige Nutzung mit dem Ruf der geplanten Marke vereinbar ist.

Eine Domainanalyse ersetzt keine juristische Beratung. Bei einem geschäftlich wichtigen Projekt oder einem möglichen Kennzeichenkonflikt sollte eine fachkundige Prüfung erfolgen. Besonders riskant ist es, eine Domain nur deshalb zu übernehmen, weil sie ein starkes Schlüsselwort enthält.

Domainalter, Endung und Name richtig einordnen

Das Alter einer Domain kann historische Hinweise liefern, ist aber kein verlässlicher Qualitätsbeweis. Eine alte Domain kann jahrelang ungenutzt oder problematisch betrieben worden sein. Eine neue Domain kann dagegen von Beginn an sauber strukturiert und relevant sein.

Auch die Domainendung sollte zum Zielmarkt und zum Vertrauen der Zielgruppe passen. Eine regionale Endung kann für ein lokal ausgerichtetes Angebot sinnvoll sein, während ein internationales Projekt andere Anforderungen hat. Entscheidend sind Klarheit, Verfügbarkeit, rechtliche Sicherheit und die Erwartungen der Nutzer.

Der eigentliche Domainname sollte möglichst leicht zu diktieren und zu schreiben sein. Teste ihn mit mehreren neutralen Personen aus dem gewünschten Umfeld, ohne die Reaktion vorzugeben. Frage, wie sie den Namen schreiben würden und woran sie sich nach kurzer Zeit erinnern.

Eine praktische Checkliste für die Analyse

Die folgende Reihenfolge hilft, die Prüfung effizient zu organisieren:

  1. Ziel festlegen: Definiere, ob es um Kauf, Relaunch, Risikoprüfung oder eine Neuregistrierung geht.
  2. Identität prüfen: Erfasse Domainendung, Schreibvarianten, frühere Betreiberhinweise und mögliche Markenbezüge.
  3. Historie ansehen: Vergleiche frühere Inhalte, Themen, Sprachen und auffällige Nutzungsphasen.
  4. Linkprofil stichprobenartig bewerten: Öffne verlinkende Seiten und prüfe Kontext, Qualität und Zielseiten.
  5. Sichtbarkeit einordnen: Untersuche Rankings, indexierte URLs, historische Entwicklungen und mögliche Ursachen von Veränderungen.
  6. Technik testen: Kontrolliere HTTPS, DNS, Statuscodes, Weiterleitungen, robots.txt, Sitemap und Canonical-Tags.
  7. Inhalte bewerten: Frage, ob alte Signale und die geplante neue Ausrichtung sinnvoll zusammenpassen.
  8. Risiken dokumentieren: Halte offene Fragen, Belege und Ausschlussgründe getrennt voneinander fest.
  9. Entscheidung treffen: Wäge Nutzen, Bereinigungsaufwand, rechtliche Unsicherheit und Alternativen ab.

Eine einfache Tabelle mit den Spalten „Beobachtung“, „Beleg“, „Risiko“, „Auswirkung“ und „nächster Schritt“ macht die Bewertung nachvollziehbar. So bleibt sichtbar, welche Punkte bestätigt sind und welche nur auf einer Vermutung beruhen.

Häufige Fehler bei der Domainanalyse

Nur eine Kennzahl betrachten

Ein hoher Domainwert, viele Backlinks oder ein hohes Domainalter können nützlich wirken, sagen allein aber wenig über die Eignung aus. Kombiniere quantitative Daten mit manuellen Stichproben und dem geplanten Geschäftsmodell.

Alte Rankings als sicheren Vorteil ansehen

Rankings können verschwinden, wenn Inhalte entfernt, Suchintentionen verändert oder technische Strukturen umgebaut werden. Plane eine Übernahme nicht so, als wären alte Positionen garantiert übertragbar.

Weiterleitungen pauschal setzen

Eine Weiterleitung jeder alten URL auf die Startseite ist selten die beste Lösung. Wenn eine passende neue Zielseite existiert, sollte sie präzise zugeordnet werden. Fehlt eine sinnvolle Entsprechung, ist eine klare Fehlerseite oft ehrlicher als eine thematisch unpassende Weiterleitung.

Rechtliche Prüfung auslassen

Ein attraktiver Domainname kann trotzdem Konflikte verursachen. Prüfe Marken, Unternehmensnamen und relevante Schreibvarianten vor einer verbindlichen Entscheidung.

FAQ

Wie lange dauert es, eine Domain zu analysieren?

Eine erste Sichtprüfung kann in kurzer Zeit erfolgen. Für eine belastbare Entscheidung solltest du jedoch ausreichend Zeit für Historie, Linkprofil, Technik, Sichtbarkeit und rechtliche Fragen einplanen. Je größer die Domain und je wichtiger der Kauf, desto umfangreicher sollte die Stichprobe sein.

Welche Tools brauche ich für eine Domainanalyse?

Für die Prüfung sind je nach Ziel ein Archivdienst, ein Backlink- und Sichtbarkeitstool, DNS- und HTTPS-Prüfungen sowie die Suchmaschinen-Tools der Website hilfreich. Kein Werkzeug liefert allein die vollständige Wahrheit. Aussagekräftig wird die Analyse durch den Vergleich mehrerer Datenquellen und manuelle Kontrolle.

Ist eine alte Domain automatisch wertvoller?

Nein. Das Alter kann ein historischer Hinweis sein, beweist aber weder Vertrauen noch gute Rankings. Eine alte Domain mit Spam-Vergangenheit kann problematischer sein als eine neu registrierte, sauber aufgebaute Adresse.

Wie erkenne ich ein unnatürliches Backlinkprofil?

Auffällig sind beispielsweise viele irrelevante Domains, wiederholte kommerzielle Ankertexte, Linknetzwerke und starke Ausschläge ohne plausiblen Anlass. Prüfe immer mehrere konkrete Links und bewerte ihren redaktionellen Kontext, statt nur einen automatischen Risikowert zu übernehmen.

Kann ein Themenwechsel die Domain schädigen?

Ein Themenwechsel kann Erwartungen von Nutzern und Suchmaschinen verändern, ist aber nicht grundsätzlich verboten oder schädlich. Je größer der Wechsel, desto wichtiger sind eine klare neue Positionierung, passende Inhalte und eine sorgfältige Behandlung alter URLs und Links.

Was sollte ich bei einem Domainkauf vertraglich klären?

Klärung verdienen unter anderem die genaue Domain, der Übergabezeitpunkt, der Zugang zur Verwaltung, bestehende Inhalte, Weiterleitungen, Nutzungsrechte, bekannte Ansprüche und die Verantwortung für offene technische oder rechtliche Probleme. Bei größeren Transaktionen ist eine rechtliche Prüfung sinnvoll.

Wann sollte ich eine Domain lieber nicht übernehmen?

Vorsicht ist angebracht, wenn die Historie überwiegend aus Spam besteht, die Linkquellen nicht plausibel sind, rechtliche Konflikte drohen oder der Bereinigungsaufwand den erwarteten Nutzen übersteigt. Eine gute Alternative kann dann eine neue, klar positionierte Domain sein.

Fazit: Domain analysieren mit einem ganzheitlichen Blick

Wer eine Domain analysiert, sollte Historie, Backlinks, Sichtbarkeit, Technik, Marke und Recht gemeinsam betrachten. Einzelne Kennzahlen können Hinweise liefern, aber keine Entscheidung ersetzen. Besonders wichtig sind nachvollziehbare Belege, manuelle Stichproben und eine klare Trennung zwischen gesicherten Beobachtungen und Annahmen.

Definiere zuerst dein Ziel, dokumentiere anschließend die relevanten Befunde und bewerte schließlich den Aufwand für Übernahme, Bereinigung und Weiterentwicklung. So wird aus einer oberflächlichen Kennzahlenprüfung eine belastbare Grundlage für einen Domainkauf, einen Relaunch oder den Aufbau einer neuen Website.

Warum Rankings schwanken: Ursachen erkennen und SEO nachhaltig verbessern

Schwankende Rankings gehören zum Alltag der Suchmaschinenoptimierung. Eine Seite kann heute auf der ersten Ergebnisseite erscheinen und wenige Tage später deutlich weiter hinten stehen, obwohl am Inhalt nichts verändert wurde. Das wirkt zunächst unberechenbar, ist aber meist auf eine Kombination aus Suchintention, Wettbewerb, technischen Signalen, Messbedingungen und laufenden Veränderungen in den Suchergebnissen zurückzuführen.

Wer verstehen möchte, warum Rankings schwanken, sollte deshalb nicht jede einzelne Positionsänderung als Problem bewerten. Entscheidend ist, kurzfristige Bewegungen von einem anhaltenden Trend zu unterscheiden, Daten sauber zu prüfen und Verbesserungen nach ihrer tatsächlichen Wirkung zu priorisieren. Dieser Ratgeber zeigt, welche Ursachen häufig sind, wie eine systematische Analyse aussieht und welche Maßnahmen langfristig helfen.

Warum Rankings schwanken: Die wichtigsten Ursachen im Überblick

Suchmaschinen bewerten nicht nur eine einzelne Seite, sondern vergleichen sie fortlaufend mit vielen anderen Ergebnissen. Dabei werden unter anderem Inhalt, Relevanz, Nutzerintention, technische Zugänglichkeit, interne Verlinkung und Signale zur Qualität berücksichtigt. Zusätzlich verändert sich die Zusammensetzung der Ergebnisseiten selbst.

Typische Ursachen für Rankingbewegungen sind:

  • Veränderungen an Suchsystemen und deren Bewertungsprozessen
  • Neue oder überarbeitete Inhalte von Wettbewerbern
  • Unterschiedliche Suchintentionen und wechselnde Nachfrage
  • Technische Fehler, Änderungen an Templates oder versehentliche Ausschlüsse
  • Unvollständige oder verzögerte Daten in Analyse- und SEO-Tools
  • Lokalisierung, Gerät, Sprache, Standort und Personalisierung
  • Veränderungen an der Darstellung der Suchergebnisse
  • Geänderte interne Verlinkung, Weiterleitungen oder Seitenstrukturen

Ein einzelner Ausschlag ist daher selten ausreichend, um eine konkrete Ursache zu bestimmen. Aussagekräftiger ist das Muster: Betrifft die Bewegung eine einzelne URL, ein Themencluster, eine ganze Domain oder nur bestimmte Geräte und Regionen?

Kurzfristige Schwankungen von echten Problemen unterscheiden

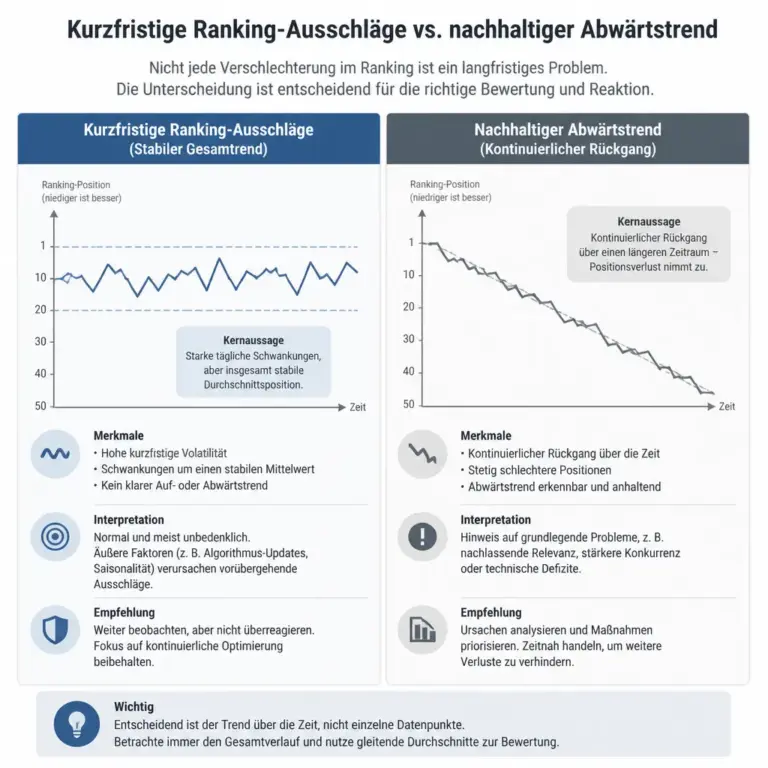
Vergleich zwischen kurzfristigen Ranking-Schwankungen und einem nachhaltigen Abwu00e4rtstrend
Nicht jede Bewegung ist ein nachhaltiger Rankingverlust.

Die Grafik macht sichtbar, warum der Zeitraum für die Bewertung entscheidend ist. Eine einzelne Tagesposition sagt weniger aus als ein klar erkennbarer Trend über mehrere Messpunkte.

Bevor Änderungen umgesetzt werden, sollte zunächst geklärt werden, ob überhaupt ein nachhaltiger Verlust vorliegt. Rankings werden nicht immer als fester Wert gemessen. Je nach Standort, Gerät, Suchhistorie, Datenzentrum, Suchzeitpunkt und Ergebnisdarstellung können unterschiedliche Positionen sichtbar sein.

Eine kurzfristige Bewegung ist oft unkritisch, wenn:

  • sie nur wenige Tage anhält,
  • nur einzelne Suchbegriffe betroffen sind,
  • Klicks und Impressionen insgesamt stabil bleiben,
  • die Sichtbarkeit in mehreren unabhängigen Auswertungen ähnlich aussieht,
  • keine technischen oder redaktionellen Änderungen vorausgegangen sind.

Eine genauere Untersuchung ist sinnvoll, wenn ein Rückgang über einen längeren Zeitraum anhält, viele wichtige Suchbegriffe gleichzeitig betrifft oder mit weniger Impressionen, Klicks und Conversions einhergeht. Auch ein deutlicher Verlust bei einer wichtigen Zielseite verdient Aufmerksamkeit, selbst wenn die Domain insgesamt stabil wirkt.

Wichtig ist die Unterscheidung zwischen Position und Geschäftswert. Eine Seite kann eine Position verlieren, aber weiterhin ähnlich viele qualifizierte Besuche erhalten, wenn sich die Suchergebnisse oder die Nachfrage verändert haben. Umgekehrt kann eine scheinbar stabile Position weniger Klicks erzeugen, wenn zusätzliche Ergebnisfunktionen mehr Aufmerksamkeit auf der Suchergebnisseite binden.

Veränderungen im Suchsystem als mögliche Ursache

Suchmaschinen verbessern ihre Systeme fortlaufend. Solche Anpassungen können die Gewichtung von Relevanz, Qualität, Aktualität, Spam-Signalen oder Nutzerintention verändern. Die Auswirkungen müssen nicht jede Website gleich stark betreffen. Manche Seiten verlieren Sichtbarkeit, andere gewinnen, während ein Teil der Rankings unverändert bleibt.

Ein möglicher Zusammenhang wird wahrscheinlicher, wenn:

  • viele URLs und Themen gleichzeitig betroffen sind,
  • die Veränderungen ungefähr im selben Zeitraum auftreten,
  • ähnliche Websites im gleichen Themenbereich vergleichbare Bewegungen zeigen,
  • der Rückgang nicht durch technische Änderungen erklärt werden kann.

Die falsche Reaktion wäre, sofort jede betroffene Seite umfassend umzuschreiben. Besser ist eine Bestandsaufnahme: Welche Suchintention bedienen die Gewinner? Sind sie aktueller, klarer strukturiert, vollständiger oder fachlich präziser? Gibt es Hinweise darauf, dass die eigene Seite zwar viele Begriffe enthält, die eigentliche Frage der Suchenden aber nicht ausreichend beantwortet?

Eine Anpassung an veränderte Qualitätsanforderungen sollte nicht aus kurzfristigen Tricks bestehen. Nachhaltiger ist es, die Seiten auf einen klaren Zweck auszurichten, unbelegte Aussagen zu vermeiden, relevante Informationen verständlich zu erklären und die tatsächliche Erfahrung der Zielgruppe zu berücksichtigen.

Wettbewerb und Suchintention: Warum gute Inhalte trotzdem verlieren können

SEO ist ein Vergleich. Eine Seite muss nicht nur an sich gut sein, sondern die Suchintention besser oder passender erfüllen als konkurrierende Ergebnisse. Wenn neue Wettbewerber veröffentlichen oder bestehende Seiten ihre Inhalte überarbeiten, kann sich die Reihenfolge ändern, obwohl die eigene URL unverändert bleibt.

Prüfe deshalb bei einem Rankingverlust die aktuellen Ergebnisse für das betroffene Keyword. Achte auf folgende Fragen:

  • Welche Seitentypen dominieren inzwischen: Ratgeber, Kategorie, Produktseite, Vergleich oder lokale Landingpage?
  • Beantworten die vorderen Ergebnisse eine andere Frage als die eigene Seite?
  • Sind die Inhalte aktueller, konkreter oder besser auf eine bestimmte Zielgruppe zugeschnitten?
  • Gibt es mehr praktische Beispiele, Entscheidungshilfen, Tabellen oder klare nächste Schritte?
  • Ist die eigene Seite zu breit, zu oberflächlich oder unnötig ausführlich?

Die Suchintention kann sich außerdem mit der Zeit verändern. Bei einem Thema, das zunächst erklärungsorientiert war, kann später ein stärkerer Vergleichs- oder Kaufwunsch entstehen. Dann passt eine allgemeine Definition möglicherweise weniger gut als eine strukturierte Entscheidungshilfe. Die Lösung ist nicht zwingend mehr Text, sondern eine bessere Passung zwischen Frage, Inhalt und nächstem Handlungsschritt.

Vermeide es, konkurrierende Seiten lediglich nachzuahmen. Eine eigenständige Seite kann durch klare Einordnung, nachvollziehbare Kriterien, Grenzen der Empfehlung und gut erklärte Zusammenhänge wertvoller sein als eine Sammlung bekannter Stichworte.

Technische Gründe für schwankende Rankings

Technische Änderungen können Rankings direkt oder indirekt beeinflussen. Manchmal wird eine Seite nicht mehr zuverlässig gecrawlt oder indexiert. In anderen Fällen ist sie erreichbar, aber die Suchmaschine erkennt aufgrund von Weiterleitungen, Canonical-Angaben oder widersprüchlichen Signalen eine andere URL als bevorzugte Version.

Wichtige technische Prüfpunkte

  • Indexierbarkeit: Prüfe, ob wichtige Seiten durch Robots-Regeln, Meta-Angaben oder Zugriffsbeschränkungen ausgeschlossen werden.
  • Statuscodes: Achte auf unerwartete Fehler, Weiterleitungsketten und nicht beabsichtigte Umleitungen.
  • Canonical-Signale: Kontrolliere, ob die bevorzugte URL auf sich selbst oder auf eine andere, tatsächlich passende Seite verweist.
  • Interne Links: Stelle sicher, dass wichtige Inhalte von relevanten Seiten aus erreichbar und nicht nur über eine schwer auffindbare URL zugänglich sind.
  • Mobile Darstellung: Prüfe Lesbarkeit, Navigation, Interaktion und sichtbare Inhalte auf kleinen Bildschirmen.
  • Ladeverhalten: Identifiziere langsame Vorlagen, große Medien, blockierende Ressourcen und unnötige Skripte.
  • Strukturierte Daten: Verwende sie nur passend, korrekt und im Einklang mit dem sichtbaren Inhalt.

Besonders riskant sind größere Relaunches, Template-Wechsel und Migrationen. Dabei können URL-Strukturen, interne Links, Seitentitel, Überschriften oder Canonical-Angaben unbemerkt verändert werden. Nach solchen Eingriffen sollte eine dokumentierte Vorher-Nachher-Prüfung erfolgen. Sie erleichtert die Zuordnung, falls Rankings erst nach dem Relaunch zurückgehen.

Inhaltliche Ursachen: Qualität, Aktualität und thematische Klarheit

Ein Inhalt kann anfangs gut funktionieren und später an Relevanz verlieren. Informationen veralten, Empfehlungen ändern sich, neue Fragen entstehen oder die Seite deckt wichtige Teilaspekte nicht mehr ab. Auch inhaltliche Überschneidungen innerhalb einer Website können die Orientierung erschweren.

Bei der Überarbeitung helfen diese Fragen:

  • Ist die zentrale Frage bereits in den ersten Abschnitten klar beantwortet?
  • Erklärt der Text Zusammenhänge statt nur Begriffe aufzuzählen?
  • Sind Aussagen nachvollziehbar begründet und klar von Annahmen getrennt?
  • Wird deutlich, für wen die Empfehlung gilt und wann sie nicht passt?
  • Sind Beispiele, Abläufe, Vor- und Nachteile sowie Entscheidungskriterien enthalten?
  • Gibt es veraltete Angaben, tote Links oder widersprüchliche Aussagen?
  • Existieren mehrere Seiten, die dieselbe Suchintention nur leicht unterschiedlich behandeln?

Aktualisieren bedeutet nicht, lediglich das Änderungsdatum zu ersetzen. Eine sinnvolle Überarbeitung verbessert den Nutzen sichtbar: Sie korrigiert Fehler, ergänzt fehlende Informationen, entfernt leere Wiederholungen und ordnet die Inhalte nach den Fragen der Leserinnen und Leser.

Auch die thematische Architektur zählt. Eine einzelne Seite wird besser verständlich, wenn sie durch passende, intern verlinkte Inhalte unterstützt wird. Dabei sollten die Links einen echten Mehrwert bieten und nicht nur möglichst viele Suchbegriffe wiederholen.

Messfehler und Datenqualität richtig bewerten

Nicht jede auffällige Bewegung in einem SEO-Bericht entspricht einer tatsächlichen Verschlechterung. Tools verwenden unterschiedliche Datenquellen, Zeitfenster und Berechnungen. Manche zeigen eine durchschnittliche Position, andere eine einzelne Momentaufnahme. Deshalb sollten mehrere Signale gemeinsam betrachtet werden.

Für eine belastbare Analyse gehören mindestens diese Vergleiche dazu:

  • aktuelle und vorherige Zeiträume gleicher Länge,
  • Marken- und Nicht-Marken-Suchanfragen getrennt voneinander,
  • Desktop und Mobilgeräte getrennt,
  • wichtige Länder oder Regionen separat,
  • Suchbegriffe nach URL, Suchintention und Themencluster gruppiert,
  • Impressionen, Klicks, Klickrate und Conversions gemeinsam.

Ein Vergleich mit dem unmittelbar vorherigen Tag kann stark verzerren, etwa durch Wochentage, saisonale Nachfrage oder einzelne ungewöhnliche Ereignisse. Längere Zeiträume liefern meist ein stabileres Bild. Bei saisonalen Themen sollte zusätzlich ein vergleichbarer Zeitraum aus der Vergangenheit betrachtet werden, sofern passende Daten vorhanden sind.

Auch die Suchergebnisseite selbst verändert die Klickwahrscheinlichkeit. Ein Informationskasten, ein lokales Ergebnis, Videos, Bilder oder andere Elemente können organische Treffer weiter nach unten verschieben. Dann sinkt die Klickrate möglicherweise, obwohl die Position einer URL nur geringfügig verändert wurde. Die Auswertung sollte deshalb immer den Kontext der konkreten Suchergebnisse berücksichtigen.

Ein systematischer Prüfprozess bei Rankingverlusten

Eine feste Reihenfolge verhindert hektische Maßnahmen. Der folgende Prozess eignet sich als wiederverwendbare Checkliste.

1. Zeitraum und Umfang bestimmen

Notiere, wann die Bewegung begonnen hat und ob sie einzelne Begriffe, URLs, Verzeichnisse, Geräte oder Regionen betrifft. Ein klar begrenztes Muster liefert oft bereits einen ersten Hinweis.

2. Änderungen dokumentieren

Vergleiche Veröffentlichungen, Inhaltsänderungen, technische Releases, Weiterleitungen, interne Links und externe Kampagnen mit dem Zeitraum des Rückgangs. Ein Änderungsprotokoll ist dafür besonders hilfreich.

3. Indexierung und Crawling prüfen

Kontrolliere die betroffenen URLs auf Erreichbarkeit, Statuscode, Indexierbarkeit, Canonical-Angaben und interne Verlinkung. Prüfe auch, ob versehentlich eine Test- oder Staging-Version veröffentlicht wurde.

4. Suchintention und Wettbewerbsumfeld analysieren

Vergleiche die aktuellen vorderen Ergebnisse nicht nur nach Textmenge, sondern nach Seitentyp, Aktualität, Struktur, Belegen, praktischer Hilfe und Zielgruppe.

5. Daten segmentieren

Trenne Suchanfragen nach Thema, URL, Gerät, Region und Marke. So wird sichtbar, ob ein allgemeines Problem oder nur ein bestimmter Bereich betroffen ist.

6. Eine Hypothese formulieren

Beschreibe die wahrscheinlichste Ursache in einem Satz, zum Beispiel: „Die betroffenen Seiten erfüllen die aktuelle Vergleichsintention weniger klar als die führenden Ergebnisse.“ Eine Hypothese verhindert, dass wahllos Änderungen vorgenommen werden.

7. Wenige, nachvollziehbare Maßnahmen umsetzen

Überarbeite zuerst die wichtigsten Seiten und dokumentiere, was verändert wurde. Werden zu viele Faktoren gleichzeitig geändert, lässt sich die Wirkung später kaum zuordnen.

8. Ausreichend lange beobachten

Bewerte nicht nach einzelnen Tagen. Beobachte, ob sich Rankings, Impressionen, Klicks und qualifizierte Handlungen gemeinsam verbessern. Bei technischen Problemen sollte die Behebung zunächst überprüft werden, bevor weitere inhaltliche Änderungen folgen.

Welche SEO-Maßnahmen langfristig stabilisieren können

Stabile Rankings entstehen nicht durch eine einzelne Optimierung, sondern durch kontinuierliche Qualität und saubere Prozesse. Besonders wirkungsvoll sind Maßnahmen, die den Nutzen der Seite direkt verbessern:

  • eine klare Zuordnung zwischen Suchanfrage und Zielseite,
  • ein verständlicher Aufbau mit aussagekräftigen Überschriften,
  • konkrete Antworten statt allgemeiner Floskeln,
  • transparente Grenzen und nachvollziehbare Entscheidungskriterien,
  • regelmäßige Pflege wichtiger Inhalte,
  • eine logisch aufgebaute interne Verlinkung,
  • technische Stabilität bei Vorlagen, Migrationen und Veröffentlichungen,
  • ein dokumentierter Prozess für Messung und Änderungen.

Vermeide kurzfristige Reaktionen wie unnatürliches Wiederholen des Keywords, massenhaftes Löschen schwächerer Seiten ohne Prüfung oder das Kopieren konkurrierender Inhalte. Solche Maßnahmen lösen die eigentliche Ursache oft nicht und können die Verständlichkeit der Website verschlechtern.

Auch externe Signale sollten nicht isoliert betrachtet werden. Sichtbarkeit kann durch Erwähnungen, Verlinkungen und Markenbekanntheit unterstützt werden, doch künstliche oder thematisch unpassende Maßnahmen sind kein verlässlicher Ersatz für relevante Inhalte und eine gute Nutzerführung.

FAQ

Warum schwanken Rankings von einem Tag auf den anderen?

Kurzfristige Bewegungen können durch laufende Bewertungen, unterschiedliche Suchergebnisse, regionale Daten, Gerätetypen, Wettbewerb und Messzeitpunkte entstehen. Ein einzelner Tag ist deshalb selten aussagekräftig. Aussagekräftiger sind Trends über einen angemessenen Zeitraum und mehrere Kennzahlen.

Sind Ranking-Schwankungen immer ein Zeichen für eine Abstrafung?

Nein. Eine Schwankung bedeutet zunächst nur, dass sich die Position verändert hat. Eine manuelle Maßnahme oder ein technisches Problem sollte erst dann vermutet werden, wenn zusätzliche Hinweise vorliegen, etwa ein breiter und anhaltender Verlust, Indexierungsfehler oder eine dokumentierte Verletzung von Qualitätsanforderungen.

Wie lange sollte man nach einer SEO-Änderung warten?

Das hängt von Umfang und Art der Änderung ab. Technische Fehler sollten nach der Behebung zeitnah kontrolliert werden. Bei inhaltlichen Anpassungen ist eine Bewertung über mehrere Wochen meist sinnvoller als eine Reaktion auf einzelne Tageswerte. Der Zeitraum sollte zur bisherigen Datenmenge und zur Bedeutung der Seite passen.

Warum schwanken Rankings nur auf Mobilgeräten?

Mobilgeräte können andere Ergebnisdarstellungen und Nutzerkontexte aufweisen. Zusätzlich wirken sich Probleme mit Darstellung, Lesbarkeit, Interaktion oder Ladeverhalten besonders auf kleinen Bildschirmen aus. Prüfe deshalb mobile Vorlagen, sichtbare Inhalte, Navigation und technische Zugänglichkeit separat.

Kann ein neues Konkurrenzangebot meine Rankings verschlechtern?

Ja. Wenn eine neue oder überarbeitete Seite die Suchintention passender erfüllt, kann sie in den Ergebnissen vor der eigenen URL erscheinen. Das ist kein Beweis, dass die eigene Seite grundsätzlich schlecht ist. Es zeigt, dass der aktuelle Vergleich geprüft und der eigene Mehrwert klarer herausgearbeitet werden sollte.

Sollte man bei einem Rankingverlust sofort den Inhalt ändern?

Nicht unbedingt. Zuerst sollten Daten, Zeitraum, Indexierung, technische Änderungen und Suchintention geprüft werden. Wenn die Ursache unklar ist, können umfangreiche Änderungen die Analyse erschweren. Besser ist eine begründete Hypothese mit wenigen, dokumentierten Anpassungen.

Welche Kennzahl ist wichtiger: Position, Klicks oder Sichtbarkeit?

Keine Kennzahl erklärt allein den Erfolg. Die Position zeigt eine relative Platzierung, Impressionen zeigen Sichtbarkeit und Klicks zeigen tatsächliche Besuche. Für ein Geschäfts- oder Informationsziel sind zusätzlich qualifizierte Handlungen relevant. Die Kombination dieser Werte liefert das bessere Bild.

Fazit: Rankings mit Ruhe und System analysieren

Wer sich fragt, warum Rankings schwanken, sollte nicht automatisch von einem Fehler oder einer Abstrafung ausgehen. Suchsysteme, Wettbewerber, Suchintentionen, technische Rahmenbedingungen und Messdaten verändern sich fortlaufend. Entscheidend ist, ob eine einzelne Position kurzzeitig bewegt wird oder ob sich ein stabiler, geschäftlich relevanter Abwärtstrend zeigt.

Eine belastbare Analyse verbindet Zeitverlauf, URL, Suchintention, Technik, Wettbewerb und Nutzersignale. Mit einem dokumentierten Prüfprozess lassen sich Ursachen besser eingrenzen und Maßnahmen gezielter priorisieren. Langfristig profitieren vor allem Seiten, die konkrete Fragen zuverlässig beantworten, ihre Grenzen transparent machen, technisch erreichbar bleiben und regelmäßig anhand echter Nutzungsbedürfnisse weiterentwickelt werden.

Technik-Ranking und SEO-Ranking vergleichen: Ein praxisnaher Ratgeber

Wer die Sichtbarkeit einer Website verbessern möchte, stößt schnell auf zwei unterschiedliche Bewertungswelten: das Technik-Ranking und das SEO-Ranking. Beide können Hinweise auf Schwachstellen liefern, verfolgen jedoch nicht dasselbe Ziel. Ein guter technischer Zustand garantiert noch keine vorderen Positionen in den Suchergebnissen. Umgekehrt kann eine Seite trotz kleiner technischer Mängel für bestimmte Suchanfragen gut ranken.

In diesem Ratgeber erfahren Sie, wie Sie Technik-Ranking und SEO-Ranking vergleichen, welche Kennzahlen wirklich aussagekräftig sind und wie Sie aus den Ergebnissen sinnvolle Maßnahmen ableiten. Im Mittelpunkt stehen nicht möglichst hohe Punktzahlen, sondern eine bessere Nutzererfahrung, verständliche Inhalte und eine dauerhaft crawl- und indexierbare Website.

Was bedeuten Technik-Ranking und SEO-Ranking?

Ein Technik-Ranking fasst in der Regel technische Prüfungen einer Website zusammen. Je nach Werkzeug fließen beispielsweise Ladezeiten, mobile Darstellung, Statuscodes, interne Verlinkung, strukturierte Daten, Sicherheitskonfigurationen oder Indexierungsprobleme ein. Das Ergebnis wird häufig als Score, Note oder Prioritätenliste dargestellt.

Ein SEO-Ranking beschreibt dagegen die Sichtbarkeit einer Website im Verhältnis zu bestimmten Suchbegriffen, Suchintentionen, Wettbewerbern oder Zeiträumen. Dabei kann es um eine einzelne URL, eine Domain, ein Verzeichnis oder ein gesamtes Keyword-Set gehen. Die Position in den Suchergebnissen ist immer abhängig von der Suchanfrage, dem Standort, dem Gerät, der Suchhistorie und weiteren Kontextfaktoren.

Die beiden Begriffe sind daher nicht vollständig vergleichbar. Das Technik-Ranking bewertet überwiegend Voraussetzungen und Risiken. Das SEO-Ranking zeigt ein Ergebnis der gesamten Suchmaschinenoptimierung. Dazu gehören Technik, Inhalte, interne Signale, externe Verweise, Markenbekanntheit und die Frage, wie gut eine Seite die jeweilige Suchintention erfüllt.

Warum ein direkter Vergleich oft irreführend ist

Infografik mit den wichtigsten Unterschieden zwischen Technik-Ranking und SEO-Ranking
Technische Voraussetzungen und Suchsichtbarkeit ergänzen sich, messen aber unterschiedliche Aspekte.

Die Grafik macht sichtbar, dass beide Rankings verschiedene Fragen beantworten. Sie hilft dabei, technische Befunde nicht mit einem direkten Maß für Sucherfolg zu verwechseln.

Ein technischer Score wirkt objektiv, ist aber immer vom Prüfmodell des jeweiligen Tools abhängig. Ein System kann fehlende Bildattribute stark gewichten, während ein anderes vor allem Indexierungsfehler oder Web-Vitals-Signale berücksichtigt. Ein Wert von 90 Punkten ist deshalb nicht automatisch besser als ein Wert von 82 Punkten aus einem anderen System.

Auch ein SEO-Ranking ist keine feste Eigenschaft einer Website. Eine Produktseite kann für eine konkrete Kaufanfrage auf der ersten Ergebnisseite erscheinen und für eine allgemeinere Informationsanfrage kaum sichtbar sein. Deshalb sollten Rankings immer mit dem verwendeten Keyword-Set, dem Beobachtungszeitraum und der passenden Suchintention dokumentiert werden.

Der sinnvollere Ansatz lautet: Prüfen Sie zuerst, ob technische Probleme die Auffindbarkeit oder Nutzung beeinträchtigen. Bewerten Sie anschließend, ob die Inhalte die Bedürfnisse der Zielgruppe erfüllen. Erst danach sollten Sie die Veränderungen anhand von Rankings, organischem Traffic, qualifizierten Anfragen oder anderen passenden Geschäftszielen einordnen.

Die wichtigsten Unterschiede im Überblick

Merkmal Technik-Ranking SEO-Ranking
Bewertungsgegenstand Technischer Zustand und Zugänglichkeit einer Website Sichtbarkeit für konkrete Suchanfragen
Typische Daten Crawling, Ladeverhalten, Statuscodes, Indexierung, mobile Darstellung Positionen, Sichtbarkeit, Suchintention, Wettbewerbsumfeld
Perspektive Voraussetzungen und Fehlerquellen Ergebnis der gesamten Suchleistung
Veränderung Oft direkt durch technische Anpassungen beeinflussbar Kann durch viele Faktoren und zeitversetzt reagieren
Hauptnutzen Probleme finden und priorisieren Relevanz und Reichweite im Suchumfeld beurteilen

Die Tabelle zeigt: Ein Technik-Ranking sollte nicht als Ersatz für ein SEO-Ranking dienen. Beide Perspektiven ergänzen sich. Eine technische Analyse beantwortet eher die Frage „Kann die Website zuverlässig gefunden und genutzt werden?“. Ein SEO-Ranking hilft bei der Frage „Wie gut wird die Website für relevante Suchanfragen gefunden?“.

Technik-Ranking sinnvoll bewerten

Beginnen Sie nicht mit der Gesamtnote, sondern mit den einzelnen Befunden. Ein kleiner Fehler bei einer unwichtigen Archivseite kann weniger relevant sein als ein einzelner falscher Statuscode auf einer zentralen Produkt- oder Leistungsseite. Entscheidend sind Umfang, Auswirkung und Dringlichkeit.

Indexierbarkeit und Crawling

Suchmaschinen müssen wichtige Inhalte crawlen und indexieren können. Prüfen Sie, ob zentrale URLs versehentlich durch noindex, robots.txt-Regeln oder Zugriffsbeschränkungen ausgeschlossen werden. Achten Sie außerdem auf Weiterleitungsketten, fehlerhafte Canonical-Tags und XML-Sitemaps, die nicht erreichbare oder irrelevante URLs enthalten.

Ein Technik-Tool kann einen formalen Fehler melden, obwohl die betroffene URL bewusst aus dem Index ausgeschlossen wurde. Die richtige Bewertung erfordert deshalb Kontext: Ist die Seite wichtig? Soll sie in den Suchergebnissen erscheinen? Gibt es eine bessere Ziel-URL? Erst diese Fragen machen aus einem Prüfhinweis eine belastbare Entscheidung.

Ladeverhalten und mobile Nutzung

Langsame Seiten können die Nutzung erschweren, insbesondere bei mobilen Verbindungen oder älteren Geräten. Untersuchen Sie nicht nur die Startseite, sondern repräsentative Vorlagen: Artikel, Kategorie, Produkt, Kontakt und gegebenenfalls Checkout. Häufig entstehen Probleme durch große Bilder, unnötige Skripte, blockierende Ressourcen oder schlecht konfigurierte Caches.

Bewerten Sie Messwerte als Diagnose, nicht als Selbstzweck. Eine Verbesserung der technischen Leistung ist besonders wertvoll, wenn sie dazu führt, dass Inhalte schneller sichtbar werden, Interaktionen zuverlässiger funktionieren oder weniger Nutzer vor dem Laden abspringen. Bei der Interpretation sollten reale Nutzungssituationen und wiederholbare Messungen berücksichtigt werden.

Struktur, Links und Statuscodes

Eine nachvollziehbare URL-Struktur und eine verständliche interne Verlinkung erleichtern Orientierung und Crawling. Prüfen Sie, ob wichtige Seiten von relevanten Bereichen aus erreichbar sind und ob interne Links auf aktuelle Ziele zeigen. 404-Fehler, unnötige Weiterleitungen und verwaiste Seiten sollten nach ihrer Bedeutung priorisiert werden.

Nicht jeder nicht verlinkte URL-Fund ist automatisch ein Problem. Manche Seiten sind bewusst nur über Suchfunktionen, Filter oder Formulare erreichbar. Problematisch wird es, wenn eine wichtige Seite weder sinnvoll intern verlinkt noch anderweitig auffindbar ist.

SEO-Ranking richtig einordnen

Ein Rankingvergleich wird erst aussagekräftig, wenn die Suchanfragen sauber definiert sind. Gruppieren Sie Keywords nach Suchintention, Thema, Zielgruppe und Funnel-Stufe. Informationsorientierte Suchanfragen benötigen häufig andere Inhalte als vergleichende, lokale oder transaktionale Anfragen.

Suchintention vor Position

Eine gute Position für ein unpassendes Keyword kann weniger wertvoll sein als eine etwas schlechtere Position für eine Suchanfrage mit hoher Relevanz. Fragen Sie daher: Sucht die Person nach einer Erklärung, einem Vergleich, einem konkreten Anbieter oder einer Lösung? Passt die bestehende Seite zu dieser Erwartung?

Wenn eine Seite für einen Begriff rankt, aber viele Besucher schnell wieder zurückkehren, kann das auf eine Diskrepanz zwischen Suchintention und Inhalt hindeuten. Dieses Signal sollte vorsichtig interpretiert werden, weil viele Faktoren hineinspielen. Es ist jedoch ein Anlass, Überschrift, Einleitung, Inhaltsstruktur und Handlungsoptionen zu überprüfen.

Rankingverlauf statt Momentaufnahme

Ein einzelner Messwert ist nur eine Momentaufnahme. Beobachten Sie Veränderungen über einen sinnvollen Zeitraum und dokumentieren Sie wichtige Ereignisse wie Relaunches, neue Inhalte, Änderungen am internen Linkaufbau oder technische Migrationen. Vergleichen Sie möglichst dieselben Länder, Geräte, Suchmaschinen und Keyword-Gruppen.

Bei starken Schwankungen sollte zunächst geprüft werden, ob sich die Messbedingungen verändert haben. Unterschiedliche Standorte, personalisierte Ergebnisse, lokale Suchergebnisse und wechselnde Suchergebnisfunktionen können Werte beeinflussen. Ein seriöser Vergleich macht diese Rahmenbedingungen transparent.

Wettbewerb und Suchergebnisfunktionen

Rankingpositionen entstehen nicht im luftleeren Raum. Die Konkurrenz kann Inhalte verbessern, neue Formate veröffentlichen oder ihre Autorität ausbauen. Zusätzlich können Karten, Videos, Nachrichten, direkte Antworten oder andere Suchergebnisfunktionen die sichtbare Fläche verändern.

Prüfen Sie deshalb neben der Position auch, welche Seitentypen tatsächlich erscheinen. Wenn für ein Thema überwiegend ausführliche Ratgeber angezeigt werden, reicht eine kurze Leistungsseite möglicherweise nicht aus. Wenn lokale Ergebnisse dominieren, sollten Standortinformationen und lokale Signale berücksichtigt werden.

Technik-Ranking und SEO-Ranking vergleichen: Ein belastbarer Ablauf

Ein strukturierter Ablauf verhindert, dass einzelne Scores überbewertet werden. Die folgenden Schritte eignen sich für regelmäßige Audits ebenso wie für die Bewertung eines Relaunches.

1. Ziel und Vergleichseinheit festlegen

Definieren Sie zunächst, was verglichen werden soll: eine einzelne URL, ein Seitentyp, ein Themencluster oder die gesamte Domain. Legen Sie außerdem fest, welches Ziel zählt. Das kann bessere Auffindbarkeit, mehr qualifizierter Traffic, mehr Anfragen oder eine höhere Nutzungsqualität sein.

2. Technische Basis prüfen

Erstellen Sie eine Liste wichtiger URLs und prüfen Sie Indexierbarkeit, Statuscodes, Canonical-Signale, interne Links, mobile Darstellung und Ladeverhalten. Trennen Sie echte Blockaden von Empfehlungen mit geringer Priorität. Ein Fehler auf einer geschäftlich zentralen Seite verdient in der Regel mehr Aufmerksamkeit als ein Hinweis auf einer unwichtigen Testseite.

3. Keyword- und URL-Zuordnung erstellen

Ordnen Sie jedem wichtigen Themenbereich eine passende Ziel-URL zu. So erkennen Sie, ob mehrere Seiten um dieselbe Suchanfrage konkurrieren oder ob ein relevantes Thema noch keine geeignete Zielseite besitzt. Halten Sie Suchintention, Status der Seite und gewünschte nächste Aktion fest.

4. Sichtbarkeit im Kontext messen

Vergleichen Sie Rankings nach Keyword-Gruppe und Seitentyp. Ergänzen Sie die Betrachtung um Impressionen, Klicks und gegebenenfalls qualifizierte Conversions. Achten Sie dabei auf saisonale Schwankungen und auf die Größe der jeweiligen Datenbasis. Ein Anstieg der Impressionen ohne passende Klicks kann beispielsweise auf eine verbesserungsfähige Darstellung in den Suchergebnissen hindeuten.

5. Maßnahmen nach Wirkung priorisieren

Priorisieren Sie Maßnahmen nach erwarteter Wirkung, Aufwand und Risiko. Technische Blockaden, die wichtige Inhalte aus dem Index halten, sollten meist zuerst geprüft werden. Danach folgen Verbesserungen an besonders relevanten Inhalten, internen Verlinkungen und Vorlagen. Kleine Detailkorrekturen können sinnvoll sein, sollten aber nicht größere Hebel verdrängen.

6. Änderungen dokumentieren und erneut prüfen

Notieren Sie, was geändert wurde, wann die Änderung live ging und welche URLs betroffen waren. Prüfen Sie anschließend sowohl die technische Umsetzung als auch die Entwicklung der Sichtbarkeit. Eine Verbesserung lässt sich nur dann sinnvoll bewerten, wenn die Ausgangslage und die Vergleichsbedingungen bekannt sind.

Welche Kennzahlen zusammen betrachtet werden sollten

Es gibt keine universelle Kennzahl, die den Erfolg einer Website vollständig beschreibt. Aussagekräftiger ist ein kleines, auf das Ziel abgestimmtes Kennzahlen-Set:

  • Technische Erreichbarkeit: Sind wichtige URLs erreichbar, indexierbar und korrekt verlinkt?
  • Leistung: Werden zentrale Seiten unter realistischen Bedingungen schnell und stabil dargestellt?
  • Rankingentwicklung: Verändern sich relevante Suchbegriffe und Themencluster in die gewünschte Richtung?
  • Organische Reichweite: Entwickeln sich Impressionen und Klicks passend zur Zielgruppe?
  • Inhaltsqualität: Beantworten die Seiten die wesentlichen Fragen klar, vollständig und nachvollziehbar?
  • Geschäftsrelevanz: Entstehen aus der organischen Sichtbarkeit passende Anfragen, Verkäufe oder andere definierte Aktionen?

Die Auswahl sollte zur Website passen. Ein Informationsportal benötigt andere Erfolgsindikatoren als ein lokaler Dienstleister oder ein Onlineshop. Entscheidend ist, dass technische Daten, Suchdaten und Nutzungsziele gemeinsam interpretiert werden.

Typische Fehler beim Vergleich

Ein Score wird zum Gesamtziel

Ein möglichst hoher Technik-Score kann zu unnötigen Änderungen führen. Nicht jeder Warnhinweis hat dieselbe Bedeutung, und nicht jede empfohlene Optimierung verbessert die Sichtbarkeit. Fragen Sie immer nach dem konkreten Risiko und dem erwarteten Nutzen.

Rankingverluste werden vorschnell der Technik zugeschrieben

Ein Rückgang kann mit technischen Änderungen zusammenhängen, aber auch durch veränderte Nachfrage, neue Wettbewerber, andere Suchergebnisfunktionen oder eine veränderte Suchintention entstehen. Prüfen Sie zeitliche Zusammenhänge und betroffene Seitengruppen, bevor Sie eine Ursache festlegen.

Inhalte werden nur für Suchmaschinen überarbeitet

Technische Optimierung schafft bessere Voraussetzungen, ersetzt aber keine hilfreichen Inhalte. Texte sollten verständlich, präzise und auf die tatsächlichen Fragen der Zielgruppe ausgerichtet sein. Vermeiden Sie künstliche Wiederholungen des Hauptbegriffs und konzentrieren Sie sich auf klare Antworten, belastbare Einordnung und gute Navigation.

Keine Priorisierung nach Geschäftsrelevanz

Ein Audit mit hunderten Befunden kann lähmen. Gruppieren Sie ähnliche Probleme, bestimmen Sie betroffene Vorlagen und verbinden Sie jede Maßnahme mit einem Ziel. So wird aus einer langen Fehlerliste ein umsetzbarer Arbeitsplan.

Wann welches Ranking besonders nützlich ist

Das Technik-Ranking eignet sich vor allem für technische Audits, Relaunches, Migrationen und die regelmäßige Kontrolle wichtiger Vorlagen. Es hilft, Barrieren zu erkennen, bevor sie sich auf viele URLs oder Nutzer auswirken. Besonders wertvoll ist die Prüfung, wenn sich Crawling, URL-Struktur, Hosting, Content-Management-System oder Templates verändert haben.

Das SEO-Ranking ist besonders nützlich, wenn Sie Themen priorisieren, Wettbewerber beobachten oder die Wirkung von Inhalten beurteilen möchten. Es zeigt, für welche Suchanfragen eine Website bereits sichtbar ist und wo relevante Lücken bestehen. Die Interpretation sollte immer mit der Qualität und Passung der jeweiligen Zielseite verbunden werden.

Gemeinsam liefern beide Perspektiven ein vollständigeres Bild: Technik zeigt, ob die Grundlage funktioniert, während SEO-Daten sichtbar machen, ob diese Grundlage für relevante Suchanfragen Wirkung entfaltet.

FAQ

Ist ein hohes Technik-Ranking eine Garantie für gute SEO-Positionen?

Nein. Ein guter technischer Zustand kann die Auffindbarkeit und Nutzung unterstützen, garantiert aber keine vorderen Positionen. Inhalte, Suchintention, Wettbewerb, interne Signale und viele weitere Faktoren beeinflussen das SEO-Ranking.

Welches Ranking sollte zuerst verbessert werden?

Beginnen Sie mit technischen Problemen, die wichtige Inhalte blockieren oder die Nutzung deutlich beeinträchtigen. Danach sollten Sie relevante Inhalte und ihre Suchintention prüfen. Die Reihenfolge hängt von Ziel, Umfang und Risiko der jeweiligen Website ab.

Wie oft sollte man beide Rankings vergleichen?

Technische Prüfungen können regelmäßig und zusätzlich nach größeren Änderungen stattfinden. SEO-Rankings sollten in einem festen Rhythmus unter gleichbleibenden Bedingungen beobachtet werden. Die passende Frequenz hängt von Aktualisierungsrate, Wettbewerb und Bedeutung der Website ab.

Warum unterscheiden sich Rankingdaten aus verschiedenen Tools?

Tools verwenden unterschiedliche Datenquellen, Keyword-Sets, Standorte, Geräte und Messmethoden. Auch personalisierte Ergebnisse und Suchergebnisfunktionen können Unterschiede verursachen. Vergleichen Sie daher möglichst innerhalb eines Systems und dokumentieren Sie die Einstellungen.

Welche technischen Fehler sind besonders kritisch?

Kritisch können beispielsweise unbeabsichtigte Indexierungsausschlüsse, falsche Weiterleitungen, nicht erreichbare zentrale Seiten oder fehlerhafte Canonical-Signale sein. Die konkrete Priorität hängt davon ab, wie wichtig die betroffenen URLs für Nutzer und Geschäftsziele sind.

Kann eine Seite trotz technischer Fehler gut ranken?

Ja. Einzelne technische Schwächen verhindern nicht automatisch gute Positionen, insbesondere wenn sie wichtige Inhalte nicht betreffen. Dennoch können sich kleine Probleme bei großen Websites summieren oder die Nutzung erschweren. Deshalb sollte die Bedeutung jedes Befunds separat bewertet werden.

Welche Rolle spielt die Inhaltsqualität beim Vergleich?

Sie verbindet technische Voraussetzungen mit tatsächlichem SEO-Erfolg. Eine erreichbare, schnelle Seite ist nur dann hilfreich, wenn sie die Frage der Zielgruppe verständlich und angemessen beantwortet. Analysieren Sie daher Inhalt, Struktur, Aktualität und Suchintention gemeinsam mit den Messwerten.

Fazit: Beide Perspektiven gemeinsam nutzen

Wer Technik-Ranking und SEO-Ranking vergleichen möchte, sollte keine direkte Rangliste zwischen zwei unterschiedlichen Bewertungsarten erstellen. Besser ist ein gemeinsamer Analyseprozess: technische Hindernisse erkennen, wichtige Seiten priorisieren, Suchintentionen und Inhalte prüfen und anschließend die Entwicklung relevanter Sichtbarkeits- und Geschäftskennzahlen beobachten.

Ein Technik-Ranking liefert Hinweise auf die Qualität der Grundlage. Ein SEO-Ranking zeigt, wie sich diese Grundlage im Suchumfeld auswirkt. Erst die Verbindung beider Perspektiven führt zu Entscheidungen, die nicht nur einen Score verbessern, sondern die Website für Menschen zugänglicher, verständlicher und nützlicher machen.

Crawling-Fehler schnell erkennen: Der praktische Ratgeber für eine bessere Indexierung

Wenn wichtige Seiten einer Website nicht in den Suchergebnissen erscheinen, liegt die Ursache nicht immer bei den Inhalten oder den Rankings. Häufig verhindern technische Crawling-Fehler, dass Suchmaschinen bestimmte URLs zuverlässig abrufen, verstehen oder zur Indexierung vormerken können. Wer Crawling-Fehler schnell erkennen möchte, braucht deshalb eine klare Prüfroutine statt einzelner Vermutungen.

Dieser Ratgeber zeigt, wie Sie Crawl-Probleme systematisch einordnen, welche Werkzeuge dabei helfen und welche Fehler zuerst behoben werden sollten. Im Mittelpunkt stehen nachvollziehbare Prüfungen, saubere Prioritäten und Maßnahmen, die sich auch ohne tiefgehende Programmierkenntnisse umsetzen lassen.

Was Crawling-Fehler eigentlich bedeuten

Beim Crawling ruft ein Suchmaschinen-Bot öffentlich erreichbare URLs auf und verarbeitet deren Inhalte. Dabei folgt er unter anderem internen Links, XML-Sitemaps und Weiterleitungen. Ein Crawling-Fehler bedeutet, dass dieser Abruf oder die Verarbeitung einer URL nicht wie vorgesehen funktioniert hat.

Das ist nicht automatisch ein schwerwiegendes SEO-Problem. Eine absichtlich entfernte Seite darf beispielsweise einen Fehlerstatus zurückgeben. Kritisch wird es, wenn wichtige Inhalte betroffen sind: etwa Kategorieseiten, Produktseiten, Leistungsseiten, Ratgeber oder zentrale Landingpages.

Wichtig ist die Unterscheidung zwischen Crawling und Indexierung. Crawling beschreibt den Abruf einer Seite. Indexierung beschreibt die Entscheidung, ob und wie diese Seite in den Suchindex aufgenommen wird. Eine Seite kann erfolgreich gecrawlt, aber wegen geringer Eigenständigkeit, widersprüchlicher Signale oder eines noindex-Hinweises nicht indexiert werden. Umgekehrt kann eine technisch erreichbare Seite kaum gecrawlt werden, wenn sie schlecht intern verlinkt ist.

Die häufigsten Crawling-Fehler im Überblick

Für eine schnelle erste Einschätzung hilft es, die Meldungen nach ihrer Ursache zu sortieren. Die genaue Bezeichnung kann je nach Werkzeug anders lauten, die dahinterliegenden Probleme ähneln sich jedoch häufig.

  • Serverfehler: Die Website liefert beispielsweise einen Statuscode aus dem Bereich 500. Das kann auf Überlastung, fehlerhafte Serverkonfigurationen, Anwendungsfehler oder zeitweise Ausfälle hindeuten.
  • Clientfehler: Ein Statuscode wie 404 zeigt, dass eine angeforderte URL nicht gefunden wurde. Bei wichtigen oder stark verlinkten Seiten sollte die Ursache geprüft werden.
  • Weiterleitungsketten: Eine URL führt nicht direkt zum Ziel, sondern über mehrere Zwischenstationen. Das erschwert die Verarbeitung und macht die technische Struktur unnötig komplex.
  • Weiterleitungsschleifen: Zwei oder mehrere URLs verweisen gegenseitig aufeinander. Der Abruf kann dadurch nicht zu einer endgültigen Zielseite gelangen.
  • Durch robots.txt blockiert: Eine Regel in der Datei robots.txt verhindert den Abruf bestimmter Pfade. Das kann beabsichtigt oder ein versehentlicher Ausschluss sein.
  • Kein Zugriff: Ein Server verweigert den Abruf, etwa durch eine Zugangssperre, eine Sicherheitsregel oder eine fehlerhafte Berechtigung.
  • DNS- oder Verbindungsprobleme: Die Domain kann vorübergehend nicht aufgelöst oder der Server nicht erreicht werden.
  • Ungewöhnlich langsame Antwort: Eine Seite antwortet so langsam, dass der Abruf abbricht oder unzuverlässig wird.
  • Blockierte Ressourcen: Wichtige JavaScript-, CSS- oder Bilddateien sind nicht erreichbar. Die HTML-Seite kann zwar geladen werden, wird aber möglicherweise nicht vollständig verstanden.

Nicht jede Warnung verlangt dieselbe Reaktion. Entscheidend sind URL-Typ, Bedeutung für Nutzer, interne Verlinkung, Statuscode und die Frage, ob der Zustand beabsichtigt ist.

Eine schnelle Prüfroutine für Crawling-Fehler

Eine strukturierte Reihenfolge verhindert, dass Sie sich in Einzelfällen verlieren. Beginnen Sie mit den wichtigsten URLs und arbeiten Sie sich anschließend zu weniger kritischen Meldungen vor.

1. Betroffene URL und Seitentyp erfassen

Notieren Sie zunächst die konkrete URL und ihren Zweck. Handelt es sich um die Startseite, eine wichtige Kategorie, einen Artikel, eine Produktseite oder eine technische URL? Eine einzelne veraltete Filter-URL hat meist eine andere Priorität als eine zentrale Seite, die in der Hauptnavigation verlinkt ist.

Prüfen Sie außerdem, ob mehrere betroffene URLs einem gemeinsamen Muster folgen. Treten Fehler nur bei URLs mit bestimmten Parametern, Verzeichnissen oder Sprachvarianten auf, deutet das eher auf eine systematische Konfiguration als auf einen Einzelfall hin.

2. Den aktuellen HTTP-Status prüfen

Der HTTP-Status zeigt, wie der Server auf eine Anfrage reagiert. Für eine erste Prüfung reicht ein HTTP-Header-Checker oder die technische Detailansicht eines geeigneten SEO-Werkzeugs. Entscheidend ist, ob die URL aktuell dieselbe Antwort liefert wie zum Zeitpunkt der Fehlermeldung.

Eine Seite mit dem Statuscode 200 ist grundsätzlich erreichbar. Das bedeutet jedoch nicht automatisch, dass sie indexierbar ist. Prüfen Sie zusätzlich Weiterleitungen, Canonical-Angaben, Robots-Meta-Direktiven und den tatsächlich ausgelieferten Inhalt.

Bei einer dauerhaft entfernten Seite kann ein passender Fehlerstatus korrekt sein. Wurde der Inhalt dagegen verschoben, ist eine direkte Weiterleitung auf die relevanteste neue URL meist sinnvoller als eine allgemeine Weiterleitung auf die Startseite.

3. Blockierungen und Indexierungssignale vergleichen

Vergleichen Sie anschließend die wichtigsten technischen Signale:

  • Ist die URL in robots.txt für den relevanten Bot gesperrt?
  • Enthält die HTML-Seite ein noindex oder eine vergleichbare Anweisung?
  • Verweist das Canonical-Element auf diese URL oder auf eine andere Variante?
  • Ist die Seite über interne Links erreichbar?
  • Ist sie in einer XML-Sitemap enthalten, obwohl sie absichtlich ausgeschlossen werden soll?
  • Werden wichtige Inhalte erst nach einer problematischen JavaScript-Ausführung sichtbar?

Diese Signale sollten zusammenpassen. Eine URL, die in der Sitemap als wichtig dargestellt wird, aber gleichzeitig per noindex ausgeschlossen ist, erzeugt ein widersprüchliches Bild. Ebenso sollte eine wichtige indexierbare Seite nicht ausschließlich über schwer zugängliche Skript-Elemente erreichbar sein.

4. Einen Live-Abruf durchführen

Historische Crawling-Berichte können veraltet sein. Deshalb ist ein aktueller Live-Test wichtig. Er zeigt, ob der Fehler noch besteht, ob die URL inzwischen weiterleitet oder ob sich die Serverantwort verändert hat.

Beachten Sie, dass ein Live-Abruf nicht jede Situation vollständig abbildet. Temporäre Serverprobleme, unterschiedliche Bot-Anfragen, Geoblocking, WAF-Regeln oder Lastspitzen können zu abweichenden Ergebnissen führen. Wiederholen Sie die Prüfung bei unklaren Fällen und beziehen Sie Server- oder Hosting-Protokolle ein, wenn die Ursache nicht sichtbar wird.

So priorisieren Sie Crawling-Fehler richtig

Priorisierung verschiedener Crawling-Fehler nach ihrer Dringlichkeit
Eine Priorisierung hilft, wichtige Crawling-Probleme zuerst zu beheben.

Die Grafik zeigt, warum nicht jede Fehlermeldung gleich dringend ist. Besonders wichtig sind Fehler auf zentralen Seiten, während absichtlich entfernte oder unwichtige URLs meist nachrangig behandelt werden können.

Eine lange Liste technischer Meldungen wirkt schnell dringender, als sie tatsächlich ist. Priorisieren Sie nach dem möglichen Schaden und nicht allein nach der Anzahl der betroffenen URLs.

Priorität Typischer Fall Empfohlene Reaktion
Sehr hoch Wichtige Seite liefert einen Serverfehler, ist gesperrt oder führt in eine Schleife. Ursache zeitnah beheben, danach erneut live prüfen.
Hoch Zentrale Seite ist verschwunden, falsch weitergeleitet oder nicht intern verlinkt. Ziel, Weiterleitung und Verlinkung korrigieren.
Mittel Viele ähnliche URLs entstehen durch Filter, Parameter oder doppelte Varianten. URL-Konzept, interne Links und Crawling-Signale bereinigen.
Niedrig Veraltete, absichtlich entfernte oder unwichtige URL wird weiterhin gemeldet. Absicht dokumentieren und unnötige Signale möglichst reduzieren.

Beziehen Sie zusätzlich die Bedeutung für Nutzer ein. Ein Fehler auf einer kaum besuchten Archivseite ist anders zu bewerten als ein Fehler auf einer Seite, die viele interne Links, externe Verweise oder geschäftlich wichtige Inhalte bündelt.

Typische Ursachen und passende Lösungen

404-Fehler durch entfernte oder geänderte URLs

Ein 404-Fehler ist nicht grundsätzlich falsch. Er ist passend, wenn eine URL dauerhaft nicht mehr existiert und keine sinnvolle Ersatzseite vorhanden ist. Problematisch wird er, wenn eine Seite versehentlich gelöscht, beim Relaunch umbenannt oder aus internen Links nicht angepasst wurde.

Ermitteln Sie zunächst, ob es eine inhaltlich nahe Ersatz-URL gibt. Falls ja, richten Sie eine direkte Weiterleitung ein und aktualisieren Sie interne Verweise, Sitemaps und gegebenenfalls externe Kommunikationsmittel. Falls keine Ersatzseite existiert, entfernen Sie unnötige interne Links und prüfen Sie, ob die URL noch in einer Sitemap auftaucht.

Serverfehler und instabile Erreichbarkeit

Bei Serverfehlern sollte nicht sofort nur die betroffene URL betrachtet werden. Prüfen Sie, ob zur gleichen Zeit weitere Seiten, Verzeichnisse oder die gesamte Domain betroffen waren. Ein einzelner Fehler kann auf eine fehlerhafte Vorlage hindeuten; viele zeitgleiche Fehler sprechen eher für Hosting-, Datenbank-, Cache- oder Deployment-Probleme.

Hilfreich sind Serverprotokolle, Anwendungslogs und der zeitliche Abgleich mit Änderungen. Auch Sicherheitsdienste können legitime Abrufe blockieren. Lassen Sie Regeln prüfen, die bestimmte User-Agents, IP-Bereiche, Länder oder ungewöhnliche Anfragefolgen ausfiltern.

Falsch gesetzte robots.txt-Regeln

Die Datei robots.txt steuert, welche Pfade ein Bot abrufen darf. Ein versehentlich zu weit gefasster Ausschluss kann ganze Verzeichnisse blockieren. Kontrollieren Sie deshalb besonders Regeln für Verzeichnisse, Wildcards und neu eingeführte URL-Strukturen.

Eine robots.txt-Regel ersetzt keinen zuverlässigen Indexierungsschutz für sensible Inhalte. Wenn Inhalte wirklich nicht öffentlich zugänglich sein sollen, benötigen sie eine geeignete Zugriffskontrolle. Für SEO ist außerdem wichtig: Eine blockierte URL kann unter Umständen weiterhin durch externe Hinweise bekannt werden, obwohl ihr Inhalt nicht abgerufen werden darf.

Weiterleitungen, Ketten und Schleifen

Eine gute Weiterleitung führt möglichst direkt von der alten URL zur passenden Zielseite. Ketten entstehen oft, wenn frühere Weiterleitungen bei späteren URL-Änderungen nicht aktualisiert wurden. Prüfen Sie daher nicht nur die erste Antwort, sondern die vollständige Abfolge bis zum endgültigen Ziel.

Bei Schleifen helfen ein Vergleich von HTTP- und HTTPS-Version, www- und nicht-www-Variante, Groß- und Kleinschreibung sowie Sprach- und Trailing-Slash-Regeln. Auch widersprüchliche Vorgaben aus Serverkonfiguration, Content-Management-System und Plugins können eine Schleife verursachen.

Langsame oder überlastete Seiten

Eine langsame Antwort kann durch große Datenbankabfragen, nicht optimierte Medien, externe Dienste, fehlerhafte Caches oder hohe Serverlast entstehen. Prüfen Sie, ob die Verzögerung dauerhaft, nur zu bestimmten Zeiten oder nur bei bestimmten Seitentypen auftritt.

Reduzieren Sie unnötige Abfragen, optimieren Sie Medien und überprüfen Sie Cache-Regeln. Dabei sollte nicht blind jede Funktion entfernt werden. Ziel ist eine stabile, vollständige Auslieferung der Inhalte, nicht lediglich eine kurzfristig niedrigere Ladezeit in einem einzelnen Test.

Interne Verlinkung und XML-Sitemap als Kontrollpunkte

Suchmaschinen entdecken URLs über verschiedene Wege. Interne Links sind dabei ein wichtiges Signal für Struktur und Bedeutung. Eine wichtige Seite sollte von relevanten, selbst erreichbaren Seiten aus verlinkt sein. Vermeiden Sie, dass zentrale Inhalte ausschließlich über Suchfelder, Filter oder Skript-Interaktionen erreichbar sind.

Die XML-Sitemap sollte vor allem die URLs enthalten, die Sie als relevante, kanonische und grundsätzlich indexierbare Seiten betrachten. Entfernen Sie Fehler-URLs, Weiterleitungen, doppelte Varianten und absichtlich nicht indexierbare Adressen. Eine Sitemap repariert keinen Crawling-Fehler, erleichtert aber die Kontrolle über die gewünschte URL-Menge.

Vergleichen Sie regelmäßig drei Mengen: URLs in der Sitemap, intern stark verlinkte URLs und URLs mit tatsächlichen Crawling- oder Indexierungsproblemen. Große Überschneidungen können Hinweise auf ein strukturelles Problem liefern.

Welche Werkzeuge bei der Fehlersuche helfen

Sie benötigen nicht zwingend eine große Sammlung von Tools. Wichtiger ist, dass jedes Werkzeug eine konkrete Frage beantwortet.

  • Suchmaschinen-Tools: Sie zeigen bekannte Crawling-, Indexierungs- und Sitemapsignale und erlauben bei vielen Systemen eine Prüfung einzelner URLs.
  • HTTP-Header-Prüfer: Sie machen Statuscodes, Weiterleitungen und Antwortketten sichtbar.
  • Crawler für die eigene Website: Sie finden interne 404-Links, Weiterleitungsketten, Canonical-Abweichungen und blockierte Ressourcen in größerem Umfang.
  • Server- und Anwendungsprotokolle: Sie zeigen, welche Anfragen tatsächlich ankamen und ob dabei Fehler, Zeitüberschreitungen oder Sicherheitsblockaden auftraten.
  • Browser-Entwicklerwerkzeuge: Sie helfen, fehlende Ressourcen, Skriptfehler und Ladeprobleme aus Sicht eines normalen Abrufs zu untersuchen.

Dokumentieren Sie bei jeder Prüfung URL, Datum, Status, Ursache, Maßnahme und Ergebnis der Nachkontrolle. So erkennen Sie wiederkehrende Muster und vermeiden, denselben Fehler mehrfach zu untersuchen.

Was nach der Behebung wichtig ist

Nach einer technischen Änderung ist der Fehler nicht automatisch aus allen Berichten verschwunden. Prüfen Sie zunächst live, ob die URL jetzt die gewünschte Antwort liefert. Kontrollieren Sie anschließend Weiterleitung, Canonical, Robots-Meta, interne Links und Sitemap.

Bei einer wichtigen URL kann eine erneute Prüfung über das zuständige Suchmaschinenwerkzeug sinnvoll sein. Danach braucht die Verarbeitung Zeit. Eine sofortige Änderung der Sichtbarkeit ist nicht garantiert und sollte nicht mit einem technischen Fehler verwechselt werden.

Beobachten Sie die betroffene URL und ähnliche URLs über einen angemessenen Zeitraum. Treten neue Fehler auf, vergleichen Sie sie mit den letzten Änderungen an Templates, Plugins, Serverregeln oder URL-Strukturen. Ein kleines Änderungsprotokoll erleichtert die Ursachenanalyse erheblich.

FAQ

Was ist der schnellste Weg, Crawling-Fehler zu erkennen?

Beginnen Sie mit dem Bericht Ihres Suchmaschinen-Tools und prüfen Sie anschließend wichtige URLs live. Kontrollieren Sie Statuscode, Weiterleitungen, robots.txt, Robots-Meta, Canonical und interne Verlinkung. Diese Reihenfolge trennt schnell zwischen Serverproblem, Blockierung und fehlender Indexierbarkeit.

Ist jeder 404-Fehler schlecht für SEO?

Nein. Ein 404-Status kann korrekt sein, wenn eine URL dauerhaft entfernt wurde und keine passende Ersatzseite existiert. Problematisch wird der Fehler, wenn eine wichtige Seite versehentlich gelöscht wurde, viele interne Links darauf zeigen oder eine relevante Ersatzseite fehlt.

Was ist der Unterschied zwischen robots.txt und noindex?

robots.txt steuert vor allem, ob ein Bot einen Pfad abrufen darf. noindex ist ein Signal zur Nichtaufnahme in den Index, das der Bot beim Abruf der Seite verarbeiten muss. Die beiden Mechanismen erfüllen daher unterschiedliche Aufgaben und sollten nicht widersprüchlich eingesetzt werden.

Warum wird eine Seite mit Statuscode 200 trotzdem nicht indexiert?

Ein erfolgreicher Abruf ist nur eine technische Voraussetzung. Die Seite kann dennoch ein noindex enthalten, auf eine andere Canonical-URL verweisen, sehr ähnliche Inhalte haben oder aus Sicht der Suchmaschine nicht ausreichend eigenständig sein. Prüfen Sie deshalb neben dem Statuscode alle Indexierungssignale und den tatsächlichen Inhalt.

Wie oft sollte ich Crawling-Fehler prüfen?

Die passende Frequenz hängt von Größe und Änderungsrate der Website ab. Wichtige Websites sollten nach Relaunches, URL-Änderungen, Serverumstellungen und größeren Plugin- oder Template-Updates gezielt geprüft werden. Zusätzlich ist eine regelmäßige Kontrolle sinnvoll, damit schleichende Fehler nicht unbemerkt bleiben.

Kann ein SEO-Plugin alle Crawling-Fehler beheben?

Ein Plugin kann bestimmte Metadaten, Sitemaps oder Weiterleitungen verwalten. Serverfehler, DNS-Probleme, Sicherheitsblockaden und fehlerhafte Anwendungslogik liegen jedoch oft außerhalb seines Zuständigkeitsbereichs. Verwenden Sie Plugins als Teil der Prüfung, nicht als Ersatz für eine vollständige technische Analyse.

Wann sollte ich den Hosting-Anbieter oder die Entwicklung einbeziehen?

Das ist sinnvoll, wenn Serverfehler wiederkehren, die Antwortzeiten stark schwanken, Sicherheitsregeln legitime Abrufe blockieren oder die Ursache in Server-, Datenbank- oder Anwendungseinstellungen liegt. Stellen Sie möglichst konkrete Informationen bereit: URL, Zeitpunkt, Statuscode, Anfrageverlauf und beobachtete Fehlermeldung.

Fazit: Crawling-Fehler schnell erkennen und sinnvoll beheben

Crawling-Fehler lassen sich am zuverlässigsten erkennen, wenn Sie nicht nur einzelne Meldungen betrachten, sondern URL, Statuscode, Blockierungen, Weiterleitungen, interne Links und Sitemap gemeinsam bewerten. Priorisieren Sie wichtige Seiten, unterscheiden Sie beabsichtigte von unbeabsichtigten Zuständen und prüfen Sie Änderungen anschließend live.

Eine klare Dokumentation macht die Fehlersuche schneller und hilft, wiederkehrende Ursachen zu finden. So wird aus einer unübersichtlichen Liste technischer Warnungen eine überschaubare Arbeitsroutine, die die Erreichbarkeit und Wartbarkeit Ihrer Website langfristig verbessert.

Sitemap bei Google einreichen: Anleitung, Fehlerbehebung und SEO-Tipps

Eine Sitemap hilft Suchmaschinen dabei, wichtige URLs einer Website zu entdecken und ihre Zusammenhänge besser zu verstehen. Besonders bei neuen, umfangreichen oder regelmäßig aktualisierten Websites kann es sinnvoll sein, die Sitemap bei Google einzureichen. Der Vorgang ist unkompliziert, ersetzt jedoch weder hochwertige Inhalte noch eine technisch erreichbare Website.

In diesem Ratgeber erfahren Sie, was eine Sitemap leistet, wie Sie sie in der Google Search Console einreichen, welche Dateiformate geeignet sind und wie Sie typische Fehler systematisch beheben. Außerdem geht es darum, wann eine Einreichung sinnvoll ist und welche Erwartungen realistisch sind.

Was ist eine Sitemap?

Eine Sitemap ist eine maschinenlesbare Datei, in der wichtige URLs einer Website aufgeführt werden. Für klassische Websites wird meist eine XML-Sitemap verwendet. Sie kann Suchmaschinen zusätzliche Hinweise zu Seiten, Beiträgen, Bildern oder Videos geben und die Orientierung in einer größeren Website erleichtern.

Eine XML-Sitemap ist keine vollständige Kopie der Website und auch kein Inhaltsverzeichnis für Besucher. Sie sollte vor allem URLs enthalten, die tatsächlich in den Google-Index aufgenommen werden sollen. Nicht relevante, doppelte, gelöschte oder ausdrücklich gesperrte Seiten gehören in der Regel nicht hinein.

Viele Content-Management-Systeme und SEO-Erweiterungen erzeugen eine Sitemap automatisch. Häufig liegt sie beispielsweise unter einer Adresse wie https://www.beispiel.de/sitemap.xml. Bei manchen Systemen gibt es stattdessen eine Sitemap-Indexdatei, die auf mehrere einzelne Sitemaps verweist.

Warum sollte man eine Sitemap bei Google einreichen?

Eingabebereich zum Einreichen einer Sitemap in einer Suchmaschinenverwaltung
Die Sitemap wird über den dafür vorgesehenen Bereich der Search Console übermittelt.

Die Abbildung zeigt, wo der Pfad der Sitemap eingetragen wird und warum die Auswahl der richtigen Website-Property wichtig ist. Leser sollten auf die vollständige URL und den anschließenden Statusbericht achten.

Google kann Sitemaps häufig auch selbst entdecken, etwa über interne Links oder einen Eintrag in der Datei robots.txt. Die manuelle Einreichung über die Google Search Console schafft jedoch einen klaren Kommunikationsweg und liefert zusätzliche Informationen zum Verarbeitungsstatus.

  • Bessere Auffindbarkeit: Neue oder tief verschachtelte URLs können leichter entdeckt werden, sofern sie technisch zugänglich sind.
  • Mehr Übersicht: Die Search Console zeigt, ob Google die angegebene Sitemap abrufen und verarbeiten konnte.
  • Frühere Fehlererkennung: Ungültige URLs, Abrufprobleme oder Formatfehler werden eher sichtbar.
  • Unterstützung bei großen Websites: Viele URLs lassen sich strukturierter an Google übermitteln.
  • Hilfreich bei Änderungen: Nach einem Relaunch oder einer größeren Überarbeitung kann die aktuelle Sitemap die Orientierung unterstützen.

Wichtig ist die richtige Erwartung: Eine eingereichte Sitemap garantiert weder eine Indexierung noch gute Rankings. Google entscheidet für jede URL unabhängig, ob sie gecrawlt, indexiert und in den Suchergebnissen angezeigt wird.

Voraussetzungen vor der Einreichung

Bevor Sie die Sitemap bei Google einreichen, sollten einige Grundlagen stimmen. Dadurch vermeiden Sie, dass die Search Console zwar eine Datei akzeptiert, diese aber viele problematische URLs enthält.

Die richtige Website-Property auswählen

Für die Google Search Console benötigen Sie eine bestätigte Property. Dabei muss die Sitemap zur richtigen Website und zum passenden Protokoll gehören. Eine Sitemap für https://www.beispiel.de sollte nicht versehentlich in einer Property für eine andere Domain oder ausschließlich für http:// eingereicht werden.

Bei Domain-Properties werden mehrere Varianten einer Domain zusammengefasst. Bei URL-Präfix-Properties ist der erfasste Bereich enger. Prüfen Sie deshalb vor dem Absenden, ob Sie sich in der richtigen Property befinden.

Die Sitemap muss erreichbar sein

Rufen Sie die Sitemap zunächst selbst im Browser auf. Sie sollte ohne Login, Blockierung oder Weiterleitungskette erreichbar sein. Eine XML-Datei muss nicht besonders lesefreundlich aussehen; entscheidend ist, dass der Server sie korrekt ausliefert und der Inhalt gültig ist.

Prüfen Sie außerdem, ob die Sitemap nicht versehentlich durch eine Firewall, ein Sicherheits-Plugin oder eine Zugriffsbeschränkung blockiert wird. Bei einer geschützten Entwicklungsumgebung kann Google die Datei nicht zuverlässig abrufen.

Nur kanonische und indexierbare URLs aufnehmen

Die enthaltenen URLs sollten grundsätzlich erreichbar sein und eine sinnvolle Indexierung ermöglichen. Entfernen Sie insbesondere URLs, die auf eine andere Adresse weiterleiten, einen Fehlerstatus liefern oder per noindex von der Indexierung ausgeschlossen sind.

Auch Parameter-URLs, interne Suchergebnisse, Filterkombinationen und nahezu identische Varianten können eine Sitemap unnötig aufblähen. Die Datei sollte die wichtigsten Inhalte priorisieren, nicht jede technisch erzeugbare URL dokumentieren.

Sitemap bei Google einreichen: Schritt für Schritt

Die Einreichung erfolgt in der Google Search Console. Die Bezeichnungen der Oberfläche können sich gelegentlich ändern, das grundlegende Vorgehen bleibt jedoch ähnlich.

1. Google Search Console öffnen

Melden Sie sich mit dem Google-Konto an, das Zugriff auf die betreffende Property besitzt. Wählen Sie anschließend im Auswahlfeld die Website aus, für die Sie die Sitemap einreichen möchten.

2. Zum Bereich für Sitemaps wechseln

Öffnen Sie in der Navigation den Bereich Sitemaps. Dort finden Sie ein Eingabefeld, über das eine neue Sitemap übermittelt werden kann. Bereits bekannte Dateien und deren Status werden meist darunter angezeigt.

3. Sitemap-URL eintragen

Bei vielen Properties tragen Sie nicht die komplette Domain, sondern nur den Pfad der Sitemap ein, zum Beispiel sitemap.xml oder sitemap_index.xml. Achten Sie genau auf Schreibweise, Groß- und Kleinschreibung sowie den verwendeten Dateinamen.

Wenn die Search Console bereits einen Teil der URL vorausfüllt, ergänzen Sie nur den fehlenden Pfad. Prüfen Sie vor dem Absenden, ob die daraus entstehende vollständige Adresse tatsächlich auf die gewünschte Datei zeigt.

4. Übermittlung absenden

Klicken Sie auf die Schaltfläche zum Einreichen. Google versucht anschließend, die Datei abzurufen und zu verarbeiten. Das Ergebnis kann je nach Umfang, Serverreaktion und aktueller Verarbeitung nicht sofort vollständig sichtbar sein.

5. Status kontrollieren

Sehen Sie später erneut im Sitemap-Bericht nach. Ein erfolgreicher Abruf bedeutet, dass Google die Datei erreichen und grundsätzlich verarbeiten konnte. Das ist jedoch nicht dasselbe wie die Indexierung jeder einzelnen enthaltenen URL.

Bei einer Sitemap-Indexdatei kann Google zusätzlich einzelne untergeordnete Sitemaps verarbeiten. Kontrollieren Sie auch diese Einträge, wenn im Bericht Warnungen oder Fehler auftauchen.

Welche Sitemap-Formate unterstützt Google?

Für die meisten Websites ist eine XML-Sitemap die beste Wahl. Sie kann einzelne Seiten-URLs oder Verweise auf weitere Sitemap-Dateien enthalten. Eine Sitemap-Indexdatei ist besonders praktisch, wenn die Website so groß ist, dass mehrere Dateien verwaltet werden müssen.

Je nach Website-Typ können außerdem spezielle Sitemaps für Bilder, Videos oder Nachrichten relevant sein. Sie sind nicht automatisch für jede Website erforderlich. Entscheidend ist, ob der betreffende Inhalt tatsächlich einen zusätzlichen strukturierten Hinweis benötigt und ob das verwendete System ihn korrekt erzeugt.

Eine HTML-Seite mit einer Liste von Links ist keine XML-Sitemap im engeren Sinn. Sie kann für Besucher und interne Verlinkung nützlich sein, wird aber in der Search Console nicht wie eine XML-Sitemap behandelt.

Was gehört in eine gute XML-Sitemap?

Eine gute Sitemap ist aktuell, übersichtlich und auf wertvolle Inhalte konzentriert. Für jede URL sollten mehrere Kriterien erfüllt sein:

  • Die Adresse verwendet das bevorzugte Protokoll, üblicherweise HTTPS.
  • Die URL ist mit dem Statuscode 200 erreichbar oder wird technisch korrekt ausgeliefert.
  • Die Seite ist nicht durch noindex ausgeschlossen.
  • Die URL entspricht der bevorzugten kanonischen Version.
  • Der Inhalt ist für Nutzer relevant und nicht bloß eine technische Variante.
  • Die Datei enthält keine veralteten oder dauerhaft entfernten Adressen.

Das Änderungsdatum einer URL, häufig als lastmod angegeben, sollte nur gepflegt werden, wenn sich der wesentliche Inhalt tatsächlich geändert hat. Ein bei jedem Aufruf automatisch aktualisiertes Datum liefert keinen verlässlichen Hinweis und kann die Aussagekraft der Sitemap schwächen.

Die Prioritätsangaben und Änderungsfrequenzen, die manche Generatoren anbieten, sind kein Ersatz für eine gute Website-Struktur. Verwenden Sie solche Angaben nur, wenn Ihr System sie sinnvoll und konsistent erzeugt.

Typische Fehler beim Einreichen einer Sitemap

Wenn Google eine Sitemap nicht verarbeiten kann, liegt die Ursache häufig nicht bei der Search Console selbst. Prüfen Sie die Datei und die betroffenen URLs in mehreren Schritten.

Die Sitemap wurde nicht gefunden

Eine Meldung wie Sitemap konnte nicht abgerufen werden kann auf eine falsche URL, einen Serverfehler, eine Blockierung oder eine kurzfristige Nichterreichbarkeit hindeuten. Öffnen Sie die Datei im Browser und prüfen Sie zusätzlich die Server- und Sicherheitsprotokolle.

Ungültiges XML oder falsche Kodierung

XML verlangt eine korrekte Struktur. Nicht maskierte Sonderzeichen, beschädigte Zeichenkodierungen, zusätzliche Inhalte vor der XML-Deklaration oder fehlerhafte Tags können die Verarbeitung verhindern. Lassen Sie die Datei gegebenenfalls mit einem geeigneten XML-Prüfwerkzeug validieren.

URLs aus einer anderen Domain

Die Sitemap sollte zum vorgesehenen Website-Bereich passen. Verweise auf eine fremde Domain oder eine nicht passende Subdomain können zu Warnungen führen. Prüfen Sie auch, ob www- und non-www-Varianten sowie HTTP und HTTPS konsistent verwendet werden.

Weiterleitungen und Fehlerseiten

Eine Sitemap mit vielen Weiterleitungen, nicht gefundenen Seiten oder Serverfehlern ist ein deutliches Wartungssignal. Aktualisieren Sie den Generator, entfernen Sie gelöschte URLs und ersetzen Sie alte Adressen durch ihre aktuelle kanonische Version.

Die Sitemap ist blockiert

Die Datei darf nicht durch robots.txt, Zugriffsschutz oder eine Serverregel unerreichbar sein. Die robots.txt kann zusätzlich die vollständige Sitemap-Adresse nennen, etwa mit einer Zeile wie Sitemap: https://www.beispiel.de/sitemap.xml. Das ersetzt die Einreichung in der Search Console nicht zwingend, verbessert aber die Auffindbarkeit.

Sitemap nach einem Relaunch oder einer Migration

Nach einem Domainwechsel, einer Umstellung auf HTTPS oder einer neuen URL-Struktur sollten Sie besonders sorgfältig vorgehen. Richten Sie zunächst die passenden Properties in der Search Console ein und stellen Sie sicher, dass die neue Sitemap ausschließlich die neuen, erreichbaren URLs enthält.

Weiterleitungen von alten auf neue Adressen sollten dauerhaft und inhaltlich passend eingerichtet werden. Eine Sitemap mit alten URLs hilft nach einer Migration nur begrenzt. Sie sollte vielmehr den aktuellen Zielzustand abbilden, während interne Links, kanonische Angaben und Weiterleitungen konsistent auf die neue Struktur verweisen.

Bei einer größeren Umstellung empfiehlt sich eine technische Prüfung nach dem Livegang. Kontrollieren Sie unter anderem wichtige Statuscodes, die robots.txt, Canonical-Tags, interne Verlinkung und die Abdeckung relevanter Seiten. Die Sitemap ist dabei ein Kontrollinstrument, aber keine vollständige Relaunch-Prüfung.

Wie oft sollte man eine Sitemap einreichen?

Eine Sitemap muss normalerweise nicht nach jeder kleinen Änderung erneut eingereicht werden. Wenn die Datei unter derselben URL automatisch aktualisiert wird, kann Google die Änderungen bei späteren Abrufen erkennen.

Eine erneute Übermittlung kann sinnvoll sein, wenn sich der Dateipfad geändert hat, eine neue Sitemap-Indexdatei verwendet wird oder die Website nach einer größeren technischen Änderung aktualisiert wurde. Das wiederholte Einreichen derselben unveränderten Datei beschleunigt die Indexierung nicht automatisch.

Wichtiger als häufiges Absenden sind eine stabile Erreichbarkeit, korrekte URLs und eine nachvollziehbare Website-Struktur. Für einzelne besonders wichtige neue Seiten kann zusätzlich die Funktion zur Prüfung einer einzelnen URL in der Search Console relevant sein. Auch sie garantiert jedoch keine sofortige Aufnahme in den Index.

Sitemap und SEO: Was sie leisten und was nicht

Eine Sitemap verbessert nicht direkt die Qualität eines Textes, die Nutzererfahrung oder die Autorität einer Website. Sie kann Google jedoch helfen, bereits vorhandene Inhalte effizienter zu entdecken. Der größte Nutzen entsteht deshalb, wenn die technischen Grundlagen und die Inhalte gleichzeitig gepflegt werden.

Für eine nachhaltige Suchmaschinenoptimierung sind unter anderem klare interne Links, hilfreiche und eigenständige Inhalte, eine gute mobile Darstellung, kurze Ladezeiten sowie verständliche Seitentitel und Beschreibungen wichtig. Eine Sitemap kann diese Maßnahmen ergänzen, aber nicht ersetzen.

Bei kleinen Websites mit gut verlinkten Seiten ist der zusätzliche Effekt oft begrenzt. Bei großen Onlineshops, Nachrichtenseiten, Portalen, vielen Beiträgen oder neuen Websites mit wenigen externen Verweisen kann eine gepflegte Sitemap dagegen besonders nützlich sein.

Praktische Checkliste für die Einreichung

  • Ist die richtige Property in der Google Search Console ausgewählt?
  • Ist die Sitemap-URL ohne Login und ohne unerwartete Blockierung erreichbar?
  • Enthält die Datei nur aktuelle, kanonische und indexierbare URLs?
  • Verwendet die Sitemap die richtige Domain- und Protokollvariante?
  • Sind Weiterleitungen, Fehlerseiten und gelöschte URLs entfernt?
  • Ist die XML-Struktur gültig?
  • Wird ein realistisches Änderungsdatum verwendet?
  • Wurde der Status nach der Übermittlung kontrolliert?
  • Passt die Sitemap zur aktuellen Website-Struktur und zum letzten Relaunch?

Wenn Sie diese Punkte regelmäßig prüfen, wird die Sitemap zu einem verlässlichen Bestandteil der technischen Website-Pflege. Bei sehr großen Websites kann es zusätzlich sinnvoll sein, Sitemaps nach Inhaltstyp, Verzeichnis oder Aktualität zu strukturieren, solange die Aufteilung nachvollziehbar bleibt.

FAQ

Muss jede Website eine Sitemap haben?

Nein. Kleine, gut intern verlinkte Websites können auch ohne manuell eingereichte Sitemap gefunden werden. Sie ist dennoch eine sinnvolle Ergänzung, wenn viele URLs, häufige Änderungen, neue Inhalte oder eine komplexe Struktur vorliegen.

Garantiert das Einreichen die Indexierung?

Nein. Die Sitemap übermittelt Hinweise zu URLs, garantiert aber weder Crawling noch Indexierung oder Rankings. Google bewertet zusätzlich technische Zugänglichkeit, Qualität, Eigenständigkeit, Relevanz und weitere Signale.

Wo finde ich die Sitemap meiner WordPress-Website?

Viele WordPress-Installationen stellen automatisch eine Sitemap bereit. Je nach Version, Theme oder Erweiterung kann der Pfad unterschiedlich sein. Prüfen Sie die Einstellungen Ihrer Website und rufen Sie die vermutete Adresse direkt auf. Vermeiden Sie es, mehrere konkurrierende Sitemap-Systeme unkontrolliert parallel zu betreiben.

Kann ich mehrere Sitemaps einreichen?

Ja. Das kann bei großen Websites oder verschiedenen Inhaltstypen sinnvoll sein. Häufig wird dafür eine Sitemap-Indexdatei verwendet, die auf einzelne Dateien verweist. Jede Datei sollte korrekt aufgebaut sein und einen klar abgegrenzten URL-Bestand enthalten.

Was bedeutet der Status „Erfolgreich“?

Der Status zeigt in der Regel, dass Google die Sitemap abrufen und verarbeiten konnte. Er bestätigt nicht, dass jede enthaltene URL indexiert wurde. Für einzelne Seiten müssen Sie die Indexierungsinformationen separat betrachten.

Wie lange dauert es, bis Google die Sitemap verarbeitet?

Das lässt sich nicht pauschal vorhersagen. Die Verarbeitung hängt unter anderem von Serververfügbarkeit, Umfang und Aktualität der Website ab. Eine Sitemap ist ein Hinweis, kein Auftrag zur sofortigen Indexierung.

Ist eine Sitemap für Bilder oder Videos immer nötig?

Nein. Spezielle Sitemaps können bei umfangreichen Bild- oder Videobeständen hilfreich sein, sind aber nicht für jede Website erforderlich. Entscheidend ist, ob sie zusätzliche, korrekt gepflegte Informationen liefern und vom verwendeten System zuverlässig erzeugt werden.

Fazit: Sitemap gezielt und sauber einreichen

Eine Sitemap bei Google einzureichen ist schnell erledigt, wenn die Datei korrekt erzeugt wird und die richtige Search-Console-Property ausgewählt ist. Der nachhaltige Nutzen entsteht jedoch erst durch eine laufende Pflege: Die Sitemap sollte aktuelle, erreichbare und tatsächlich relevante URLs enthalten.

Kontrollieren Sie nach der Einreichung den Verarbeitungsstatus, beheben Sie technische Fehler und betrachten Sie die Sitemap als Teil eines größeren SEO-Prozesses. Gute Inhalte, sinnvolle interne Verlinkung und eine stabile technische Grundlage bleiben entscheidend dafür, dass Google Ihre Website nicht nur findet, sondern ihre Seiten auch sinnvoll bewerten kann.

Canonical oder Noindex? Der praktische SEO-Ratgeber zur richtigen Entscheidung

Canonical oder Noindex? Beide Signale helfen dabei, Suchmaschinen bei der Bewertung ähnlicher oder unerwünschter URLs zu unterstützen. Sie verfolgen jedoch unterschiedliche Ziele: Ein Canonical weist auf die bevorzugte Version mehrerer ähnlicher Seiten hin, während noindex verhindern soll, dass eine konkrete Seite in den Suchergebnissen erscheint. Die falsche Wahl kann dazu führen, dass wichtige Inhalte aus dem Index verschwinden oder doppelte URLs weiterhin unnötige Aufmerksamkeit erhalten.

Dieser Ratgeber erklärt die Unterschiede, zeigt typische Anwendungsfälle und bietet eine praktische Entscheidungshilfe für Websites, Onlineshops, Blogs und technische Plattformen. Dabei gilt: Keine der beiden Maßnahmen ersetzt eine saubere Informationsarchitektur, verständliche Inhalte und eine sorgfältige technische Prüfung.

Was bedeuten Canonical und Noindex?

Canonical und Noindex sind zwei verschiedene Steuerungssignale für Suchmaschinen. Sie werden häufig gemeinsam genannt, weil beide bei ähnlichen, doppelten oder nicht gewünschten URLs zum Einsatz kommen können. Inhaltlich sind sie aber nicht austauschbar.

Canonical: Welche URL ist die bevorzugte Version?

Mit einem Canonical-Link wird eine bevorzugte URL für inhaltlich gleiche oder sehr ähnliche Seiten angegeben. Das Signal lautet sinngemäß: „Von mehreren erreichbaren Varianten ist diese URL die wichtigste Version.“

Ein Canonical wird im <head> einer HTML-Seite eingebunden:

<link rel="canonical" href="https://www.beispiel.de/ratgeber/canonical-noindex">

In vielen Fällen verweist eine Seite auf sich selbst. Das wird als selbstreferenzierendes Canonical bezeichnet. Bei URL-Varianten kann eine alternative Seite hingegen auf eine andere, bevorzugte URL verweisen. Suchmaschinen können dieses Signal bei der Auswahl der indexierten und in Suchergebnissen angezeigten URL berücksichtigen.

Wichtig ist die Formulierung „Signal“: Ein Canonical ist keine absolute Anweisung. Suchmaschinen prüfen zusätzlich den Inhalt, interne Verlinkungen, Weiterleitungen, Sitemap-Einträge und weitere technische Hinweise. Ein Canonical sollte daher zu den übrigen Signalen der Website passen.

Noindex: Diese konkrete URL soll nicht in den Suchergebnissen erscheinen

noindex ist eine Anweisung beziehungsweise ein starkes Robots-Meta-Signal, eine bestimmte Seite nicht in den Suchindex aufzunehmen oder dort wieder zu entfernen. Die Seite kann weiterhin erreichbar sein und von Nutzern verwendet werden.

Typischerweise wird das Signal so im <head> hinterlegt:

<meta name="robots" content="noindex, follow">

Die häufig verwendete Kombination noindex, follow bedeutet: Die Seite selbst soll nicht in den Suchergebnissen erscheinen; Links auf der Seite dürfen grundsätzlich weiterhin entdeckt und verfolgt werden. Das follow ist meist nicht notwendig, weil Suchmaschinen Links auch ohne diese ausdrückliche Angabe verarbeiten können. Entscheidend ist der Teil noindex.

Damit Suchmaschinen das Meta-Tag sehen können, darf die URL nicht durch die robots.txt vom Crawling ausgeschlossen sein. Eine blockierte URL kann das enthaltene Noindex-Signal unter Umständen nicht zuverlässig übermitteln.

Der wichtigste Unterschied zwischen Canonical und Noindex

Infografik zum Unterschied zwischen Canonical und Noindex 1
Frage Canonical Noindex
Was wird gesteuert? Die bevorzugte URL innerhalb ähnlicher Versionen Die Aufnahme einer konkreten URL in den Suchindex
Bleibt die Seite erreichbar? Ja Ja, sofern keine andere Zugriffsbeschränkung besteht
Wird die Seite aus dem Index entfernt? Nicht zwingend Das ist das Ziel des Signals
Wofür ist es besonders geeignet? Duplikate und URL-Varianten mit einem bevorzugten Original Interne Seiten, dünne Inhalte oder nicht suchrelevante Bereiche
Was passiert mit Linksignalen? Signale können der bevorzugten URL zugeordnet werden Die Seite wird nicht als Suchergebnis gewünscht; die interne Verlinkung bleibt gesondert zu bewerten

Die Kurzform lautet: Canonical bündelt ähnliche Varianten auf eine bevorzugte URL, Noindex schließt eine konkrete URL aus den Suchergebnissen aus. Diese Kurzform hilft bei der ersten Einordnung, ersetzt aber nicht die Prüfung des jeweiligen Seitentyps.

Canonical oder Noindex: Eine praktische Entscheidungshilfe

Bevor eine technische Maßnahme gesetzt wird, sollte die eigentliche Absicht klar sein. Stelle dir nacheinander diese Fragen:

  1. Existiert eine andere URL mit demselben oder nahezu demselben Inhalt? Wenn ja, kann ein Canonical auf die bevorzugte Version passen.
  2. Soll die konkrete URL grundsätzlich nicht in der Suche erscheinen? Dann ist Noindex meist das passendere Signal.
  3. Hat die Seite einen eigenständigen Nutzen für Suchende? Wenn der Inhalt eine eigene Suchintention vollständig beantwortet, sollte er nicht vorschnell auf eine andere URL kanonisiert oder auf Noindex gesetzt werden.
  4. Ist die Seite nur eine technische oder funktionale Variante? Filter-, Sortier-, Warenkorb- oder interne Suchseiten benötigen oft eine andere Behandlung als redaktionelle Landingpages.
  5. Kann die bevorzugte Ziel-URL gecrawlt und indexiert werden? Ein Canonical auf eine blockierte, weitergeleitete oder ebenfalls nicht indexierbare URL ist häufig widersprüchlich.

Eine einfache Entscheidungsregel lautet: Gibt es ein sichtbares, eigenständiges Suchergebnisziel, sollte die Seite zunächst als mögliche Indexierungsseite betrachtet werden. Gibt es dagegen mehrere nahezu gleiche URLs und nur eine soll als Hauptversion dienen, ist ein Canonical naheliegend. Soll keine der Varianten in den Suchergebnissen auftauchen, reicht ein Canonical allein nicht aus; dann muss die Indexierungsabsicht ausdrücklich geprüft werden.

Typische Anwendungsfälle für ein Canonical

URL-Parameter für Tracking

Eine redaktionelle Seite kann durch Tracking-Parameter in mehreren URL-Varianten erreichbar sein, etwa durch Kampagnen- oder Analyseparameter. Wenn der Seiteninhalt gleich bleibt und die Parameter keine eigene Suchintention abbilden, kann die saubere Haupt-URL als Canonical angegeben werden.

Zusätzlich sollten interne Links möglichst direkt auf die bevorzugte URL zeigen. Das Canonical ist kein Ersatz für eine konsistente Verlinkung. Werden beide Varianten dauerhaft in der Website verlinkt, bleibt für Suchmaschinen und Nutzer unnötige URL-Komplexität bestehen.

Sortierung und Darstellung in einem Katalog

Ein Katalog kann dieselben Produkte oder Beiträge nach Preis, Aktualität, Farbe oder anderen Kriterien sortieren. Wenn die Sortieransichten keinen eigenständigen, suchrelevanten Inhalt bieten, kann die Hauptansicht als bevorzugte URL definiert werden.

Ob ein Canonical genügt, hängt davon ab, ob die Varianten weiterhin sinnvoll crawlbar sein sollen und ob sie für Nutzer oder externe Verweise benötigt werden. Bei umfangreichen Filterkombinationen ist eine Gesamtlösung aus URL-Konzept, interner Verlinkung, Crawl-Steuerung und gegebenenfalls Noindex oft sinnvoller als ein pauschales Signal auf jeder Variante.

Druckansicht oder alternative Layout-Version

Eine Druckansicht enthält häufig denselben Text wie die normale Seite, aber eine veränderte Darstellung. Wenn sie öffentlich erreichbar bleiben soll, jedoch nicht als eigenständiges Suchergebnis gewünscht ist, kann eine kanonische Zuordnung zur normalen Inhaltsseite geprüft werden. Bei rein funktionalen Varianten kann je nach Ziel auch Noindex angemessen sein.

Ähnliche Produkt- oder Beitragsseiten

Ein Canonical ist nicht automatisch richtig, nur weil zwei Seiten thematisch ähnlich sind. Wenn zwei Seiten unterschiedliche Fragen beantworten, verschiedene Produkte beschreiben oder jeweils einen eigenständigen Nutzen besitzen, sollten sie nicht ohne sorgfältige Prüfung zusammengelegt werden.

Bei echten Duplikaten oder nahezu identischen Varianten ist ein Canonical plausibler. Bei nur oberflächlicher Ähnlichkeit sollte stattdessen geprüft werden, ob beide Seiten durch bessere Abgrenzung, zusätzliche Informationen oder eine neue Informationsarchitektur eigenständig werden können.

Typische Anwendungsfälle für Noindex

Interne Suchergebnisse

Interne Suchseiten werden häufig automatisch aus Suchbegriffen erzeugt. Sie können für die Website-Navigation hilfreich sein, sind aber nicht grundsätzlich als öffentliche Landingpages gedacht. Wenn diese Seiten keinen kuratierten, stabilen und eigenständigen Inhalt besitzen, ist Noindex oft eine passende Option.

Warenkorb, Kasse und persönliche Bereiche

Warenkorb-, Konto-, Login- und vergleichbare Funktionsseiten richten sich an konkrete Nutzeraktionen. Sie sollen in der Regel nicht als informative Suchergebnisse gefunden werden. Hier ist Noindex meist näher an der eigentlichen Absicht als ein Canonical, weil nicht eine andere Inhaltsversion bevorzugt, sondern die Funktion aus dem Suchindex herausgehalten werden soll.

Vorläufige oder dünne Seiten

Eine noch nicht fertige Vorschauseite, ein interner Entwurf oder eine Seite mit sehr wenig eigenständigem Inhalt kann vorübergehend mit Noindex versehen werden. Vor einer späteren Veröffentlichung sollte die Maßnahme wieder entfernt und die Seite technisch wie redaktionell geprüft werden.

Mehrere Varianten ohne brauchbare Hauptversion

Manchmal existieren viele nahezu gleiche URLs, aber keine davon ist als dauerhaftes Suchergebnis sinnvoll. In diesem Fall kann ein Canonical auf eine nicht passende Seite das Problem nur verschieben. Noindex kann dann geeigneter sein, sofern die URLs weiterhin erreichbar sein müssen. Langfristig ist jedoch eine Bereinigung der URL-Erzeugung meist die robustere Lösung.

Wann Canonical und Noindex nicht einfach kombiniert werden sollten

Ein häufiges Missverständnis ist die Kombination aus Noindex und Canonical auf derselben Seite mit dem Gedanken, beide Signale würden sich gegenseitig verstärken. Das kann widersprüchlich sein: Einerseits wird die Seite als nicht indexierbar markiert, andererseits wird eine bevorzugte URL genannt. Suchmaschinen können das Canonical unter solchen Bedingungen weniger zuverlässig berücksichtigen.

Wenn eine Seite nicht im Index erscheinen soll, sollte zunächst Noindex die klare Hauptabsicht ausdrücken. Wenn mehrere indexierbare Varianten auf eine bevorzugte Version verweisen sollen, sollte das Canonical sauber und konsistent eingesetzt werden. Eine Kombination kann in speziellen technischen Szenarien sinnvoll sein, sollte aber nicht als pauschale Standardlösung verwendet werden.

Ebenso problematisch ist ein Canonical auf eine URL, die selbst noindex trägt. Die Zielseite sollte normalerweise als gültige, indexierbare Hauptversion vorgesehen sein. Widersprüchliche Signale erschweren die Verarbeitung und machen die gewünschte Indexierungslogik weniger eindeutig.

Technische Umsetzung und Qualitätskontrolle

Die korrekte Syntax ist nur der erste Schritt. Nach der Implementierung sollte geprüft werden, ob die Maßnahme tatsächlich zur URL-Strategie passt.

Checkliste für Canonical

  • Die Canonical-URL ist vollständig und verwendet das gewünschte Protokoll sowie die gewünschte Host-Version.
  • Die Ziel-URL ist erreichbar und liefert nicht dauerhaft auf eine andere Adresse weiter.
  • Die Zielseite ist nicht absichtlich mit Noindex versehen.
  • Die Zielseite enthält den gleichen oder den klar bevorzugten Inhalt.
  • Interne Links, XML-Sitemap und hreflang-Verweise widersprechen der bevorzugten URL nicht.
  • Es gibt keine unnötigen Ketten von Canonical-Verweisen.
  • Die URL verwendet eine konsistente Schreibweise, etwa bei Großschreibung, abschließendem Schrägstrich und Parametern.

Checkliste für Noindex

  • Das Robots-Meta-Tag steht in der ausgelieferten HTML-Seite oder wird zuverlässig über einen passenden HTTP-Header gesetzt.
  • Die URL ist für Suchmaschinen erreichbar, damit das Noindex-Signal gelesen werden kann.
  • Die Seite soll tatsächlich nicht als Suchergebnis erscheinen.
  • Wichtige Inhalte wurden nicht versehentlich mit Noindex versehen.
  • Die Seite wird nicht unnötig in XML-Sitemaps als indexierbare Ziel-URL geführt.
  • Interne Links verweisen nur dann prominent auf die URL, wenn sie für Nutzer weiterhin eine wichtige Funktion erfüllt.
  • Bei einer zeitlich begrenzten Maßnahme ist dokumentiert, wann die Einstellung erneut geprüft wird.

Häufige Fehler bei Canonical und Noindex

Canonical als Ersatz für eine Weiterleitung

Wenn eine alte URL dauerhaft auf eine neue URL umziehen soll und Nutzer ebenfalls automatisch weitergeleitet werden sollen, ist eine serverseitige Weiterleitung meist die passendere Lösung. Ein Canonical lässt die alte URL erreichbar und informiert vor allem Suchmaschinen über die bevorzugte Variante. Beide Maßnahmen verfolgen also nicht dasselbe Ziel.

Noindex für jede ähnliche Seite

Ähnliche Themen sind nicht automatisch doppelte Inhalte. Wer vorschnell viele Seiten auf Noindex setzt, kann wertvolle Suchintentionen und nützliche Einstiegsseiten verlieren. Vor der Entscheidung sollte geklärt werden, ob die Seite eine eigene Frage beantwortet und ob sie für Besucher einen eigenständigen Nutzen hat.

Blockierung in der robots.txt statt Noindex

Ein Crawling-Verbot und ein Noindex-Signal sind nicht gleichbedeutend. Wenn eine URL gar nicht abgerufen werden darf, kann ihr Inhalt nicht zuverlässig auf ein Meta-Tag geprüft werden. Soll eine Seite aus dem Index verschwinden, muss die technische Umsetzung diesen Unterschied berücksichtigen.

Canonical auf die Startseite

Die Startseite ist nicht automatisch die passende Sammelstelle für fehlerhafte, dünne oder doppelte URLs. Ein Canonical sollte auf die inhaltlich passende Hauptversion zeigen. Ist keine solche Version vorhanden, sind eine Überarbeitung, eine Weiterleitung oder Noindex möglicherweise sinnvoller.

Nach der Veröffentlichung nicht kontrollieren

CMS, Plugins, Shopsysteme und Templates können Canonical- oder Noindex-Angaben automatisch erzeugen. Nach Änderungen sollten deshalb nicht nur die Einstellungen im Backend, sondern auch der tatsächlich ausgelieferte Quelltext und die betroffenen URL-Muster geprüft werden.

Eine sinnvolle Vorgehensweise bei großen Websites

Bei vielen URLs sollte die Entscheidung nicht einzeln und zufällig getroffen werden. Besser ist ein wiederholbarer Prozess:

  1. URL-Muster erfassen: Gruppiere Seiten nach Parametern, Filterkombinationen, Seitentypen, Sprachversionen und Funktionen.
  2. Suchintention bewerten: Notiere, welche Gruppen für Suchende eigenständige Antworten oder Angebote liefern.
  3. Hauptversion bestimmen: Lege bei echten Duplikaten eine klare, stabile bevorzugte URL fest.
  4. Signal auswählen: Nutze Canonical für bevorzugte Varianten und Noindex für Seiten, die nicht in den Suchergebnissen erscheinen sollen.
  5. Begleitsignale angleichen: Prüfe interne Links, Sitemaps, Weiterleitungen, hreflang und strukturierte Daten.
  6. Ergebnis beobachten: Kontrolliere nach der Umsetzung, ob die Suchmaschinen die gewünschte URL-Auswahl und Indexierung nachvollziehbar verarbeiten.

Besonders wichtig ist eine Dokumentation: Für jedes URL-Muster sollte festgehalten werden, welche Seiten indexierbar sein sollen, welche Hauptversion gilt und warum eine bestimmte Maßnahme gewählt wurde. Das erleichtert spätere Relaunches, Plugin-Wechsel und Fehleranalysen.

FAQ

Ist Canonical dasselbe wie Noindex?

Nein. Canonical nennt eine bevorzugte URL unter ähnlichen Varianten. Noindex weist darauf hin, dass eine konkrete URL nicht in den Suchergebnissen erscheinen soll. Beide Signale beantworten unterschiedliche Fragen.

Was ist besser bei doppelten Seiten: Canonical oder Noindex?

Wenn eine Version als Hauptseite erhalten bleiben und die Varianten auf sie verweisen sollen, ist Canonical meist passend. Wenn keine der betreffenden URLs als Suchergebnis erscheinen soll, kann Noindex näher an der gewünschten Absicht liegen. Bei dauerhaft identischen URLs kann zusätzlich eine URL-Bereinigung oder Weiterleitung sinnvoll sein.

Kann eine noindex-Seite trotzdem gecrawlt werden?

Ja. Noindex verhindert grundsätzlich nicht, dass die Seite erreichbar oder abrufbar ist. Damit das Signal verarbeitet werden kann, darf der Zugriff für den relevanten Crawler nicht gleichzeitig durch die robots.txt blockiert sein.

Verhindert ein Canonical garantiert die Indexierung der URL?

Nein. Ein Canonical ist ein starkes Signal, aber keine absolute Garantie. Suchmaschinen bewerten zusätzlich Inhalt, interne Verlinkung, technische Erreichbarkeit und weitere Signale. Die bevorzugte URL sollte deshalb eindeutig und konsistent ausgezeichnet werden.

Soll jede Seite ein selbstreferenzierendes Canonical haben?

Ein selbstreferenzierendes Canonical kann bei vielen indexierbaren Seiten eine klare technische Grundlage schaffen, ist aber kein Ersatz für ein durchdachtes URL-Konzept. Entscheidend ist, dass die Angabe korrekt, konsistent und für den jeweiligen Seitentyp sinnvoll ist.

Was sollte ich bei Filterseiten im Onlineshop verwenden?

Das hängt davon ab, ob ein Filter eine eigene, dauerhaft nützliche Suchintention bedient. Für rein technische Kombinationen kann eine kanonische Hauptseite oder eine andere Crawl- und Indexierungsstrategie passen. Wertvolle Filter-Landingpages sollten dagegen nicht pauschal auf Noindex gesetzt werden.

Kann ich eine URL mit Noindex in der XML-Sitemap lassen?

Technisch kann sie dort stehen, sinnvoll ist es normalerweise nicht. Eine XML-Sitemap sollte vor allem URLs enthalten, die als wichtige, indexierbare Seiten vorgesehen sind. Widersprüchliche Signale erschweren die klare Kommunikation der Website-Struktur.

Wie lange dauert es, bis Noindex oder Canonical verarbeitet wird?

Das lässt sich nicht pauschal festlegen. Die Verarbeitung hängt unter anderem davon ab, wann die URL erneut gecrawlt wird und welche weiteren Signale vorliegen. Nach einer Änderung sollte deshalb nicht sofort aus einzelnen Suchergebnissen auf den endgültigen Zustand geschlossen werden.

Fazit: Die Absicht entscheidet

Bei der Frage „Canonical oder Noindex?“ ist nicht die technische Kürze des Signals entscheidend, sondern die gewünschte Funktion der URL. Ein Canonical bündelt ähnliche Varianten unter einer bevorzugten Adresse. Noindex hält eine konkrete Seite aus den Suchergebnissen heraus, während sie für Nutzer weiterhin erreichbar bleiben kann.

Prüfe deshalb zuerst die Suchintention, den eigenständigen Nutzen und die Rolle der URL in der Website. Setze anschließend ein eindeutiges Signal und gleiche interne Links, Sitemaps, Weiterleitungen und weitere technische Angaben daran an. Eine regelmäßige Kontrolle des tatsächlich ausgelieferten Codes verhindert, dass CMS-Einstellungen oder URL-Parameter die geplante SEO-Struktur unbemerkt wieder auflösen.

Noindex richtig verwenden: Anleitung für WordPress und SEO

Das Meta-Tag noindex ist ein präzises Werkzeug für die Suchmaschinenoptimierung. Es teilt Suchmaschinen mit, dass eine bestimmte Seite nicht in den Suchergebnissen erscheinen soll. Richtig eingesetzt, hilft es dabei, dünne, doppelte oder intern wenig hilfreiche Inhalte aus dem Suchindex herauszuhalten. Falsch eingesetzt, kann es jedoch wichtige Seiten unsichtbar machen.

In diesem Ratgeber erfahren Sie, wann Noindex richtig verwenden sinnvoll ist, wie sich noindex von robots.txt und einem Canonical-Tag unterscheidet und wie Sie die Einstellung in WordPress kontrolliert umsetzen. Außerdem finden Sie eine praktische Prüfliste, typische Fehler und Antworten auf häufige Fragen.

Was bedeutet „noindex“?

noindex ist eine Anweisung im HTML-Code einer Seite oder im HTTP-Header. Sie richtet sich an Suchmaschinen-Crawler und bedeutet sinngemäß: Diese URL soll nicht in den Suchergebnissen gelistet werden.

Die häufigste Variante steht im <head>-Bereich des Dokuments:

<meta name="robots" content="noindex, follow">

Die Kombination noindex, follow verhindert die Aufnahme der Seite in den Index, erlaubt aber grundsätzlich weiterhin das Verfolgen von Links auf dieser Seite. Alternativ kann eine Seite mit noindex, nofollow versehen werden. Damit wird zusätzlich signalisiert, dass Links auf der Seite nicht verfolgt werden sollen.

Für die meisten redaktionellen Anwendungsfälle ist noindex, follow die differenziertere Einstellung. Sie sollten nofollow nicht pauschal ergänzen, nur weil eine Seite selbst nicht indexiert werden soll.

Wann ist Noindex sinnvoll?

Noindex eignet sich für URLs, die technisch erreichbar oder intern nützlich sind, aber keinen eigenständigen Wert für Suchende haben. Entscheidend ist nicht, ob eine Seite existiert, sondern ob sie als eigenständiges Suchergebnis hilfreich wäre.

Typische Anwendungsfälle

  • Interne Suchergebnisse: Suchseiten mit frei kombinierbaren Suchbegriffen liefern häufig wechselnde oder sehr ähnliche Inhalte.
  • Filter- und Sortier-URLs: Parameter wie Farbe, Größe, Sortierung oder Ansicht können zahlreiche Varianten derselben Seite erzeugen.
  • Doppelte Archivseiten: Datums-, Autoren- oder Schlagwortarchive sind nicht automatisch problematisch, können aber bei geringer eigener Aussagekraft entbehrlich sein.
  • Interne Hilfsseiten: Bestellbestätigungen, Warenkörbe, Login-Seiten oder bestimmte Kontoansichten sind normalerweise keine sinnvollen öffentlichen Suchergebnisse.
  • Test- und Übergangsseiten: Vor der Veröffentlichung kann eine Seite vorübergehend aus dem Suchindex herausgehalten werden.
  • Inhalte mit sehr geringem eigenständigem Nutzen: Dazu können automatisch erzeugte Übersichten oder fast leere Taxonomien gehören.

Die Entscheidung sollte immer URL für URL oder anhand einer klar definierten Regel getroffen werden. Eine pauschale Noindex-Regel für ganze Verzeichnisse oder Inhaltstypen kann leicht wertvolle Seiten erfassen.

Noindex, robots.txt und Canonical im Vergleich

Vergleich von Noindex, robots.txt und Canonical in einer SEO-Infografik
Die drei Signale erfüllen unterschiedliche Aufgaben bei der technischen SEO.

Die Grafik macht sichtbar, dass Noindex, robots.txt und Canonical nicht austauschbar sind. Besonders wichtig ist die Trennung zwischen Zugriff auf eine URL und ihrer Aufnahme in den Suchindex.

Diese drei SEO-Maßnahmen werden häufig verwechselt, verfolgen aber unterschiedliche Ziele. Eine gute technische Strategie beginnt damit, ihre Funktionen sauber zu trennen.

Maßnahme Hauptzweck Wichtiger Hinweis
noindex Eine URL soll nicht in den Suchindex aufgenommen oder dort entfernt werden. Die Suchmaschine muss die Anweisung abrufen können, um sie zuverlässig zu sehen.
robots.txt Crawler sollen bestimmte Bereiche möglichst nicht abrufen. Eine blockierte URL kann dadurch daran gehindert werden, ein Noindex-Signal auszulesen.
Canonical Eine bevorzugte URL unter mehreren ähnlichen oder doppelten Varianten angeben. Ein Canonical ist ein Hinweis, keine Garantie für die Auswahl durch die Suchmaschine.

Wenn eine URL sicher nicht indexiert werden soll, darf sie nicht zugleich in der robots.txt blockiert sein, sofern die Suchmaschine das Noindex-Signal noch auslesen muss. Die beiden Maßnahmen lösen unterschiedliche Probleme: Die Datei robots.txt steuert den Zugriff, während noindex die Indexierung betrifft.

Ein Canonical ist dagegen oft besser geeignet, wenn mehrere URL-Varianten denselben wichtigen Inhalt darstellen und eine Hauptversion in den Suchergebnissen erscheinen soll. Noindex wäre in diesem Fall möglicherweise zu streng, weil damit auch eine eigenständige Suchintention verloren gehen kann.

Noindex richtig verwenden: Entscheidungskriterien

Bevor Sie eine Seite auf Noindex setzen, helfen einige konkrete Fragen. Sie verhindern, dass die Einstellung nur als schnelle Lösung für ein ungeklärtes Strukturproblem dient.

1. Hat die URL eine eigene Suchintention?

Prüfen Sie, ob Nutzer nach genau diesem Inhalt suchen könnten und ob die Seite diese Erwartung erfüllt. Eine eigenständige Kategorie mit verständlicher Beschreibung kann wertvoll sein. Eine automatisch erzeugte Kombination aus drei Filtern ist dagegen oft kein sinnvolles Ziel für die organische Suche.

2. Ist der Inhalt ausreichend vollständig?

Eine kurze Seite ist nicht automatisch schlecht. Problematisch wird es, wenn sie die Frage des Nutzers nicht beantwortet, fast ausschließlich aus Navigation besteht oder nur minimale Unterschiede zu vielen anderen URLs aufweist. In manchen Fällen ist eine Überarbeitung die bessere Lösung als Noindex.

3. Gibt es eine bessere Haupt-URL?

Wenn mehrere Seiten denselben Zweck erfüllen, sollten Sie entscheiden, ob eine URL gestärkt und die anderen zusammengeführt, per Canonical bevorzugt oder aus dem Index ausgeschlossen werden sollen. Noindex ist nicht automatisch die richtige Maßnahme gegen jede Form von Duplicate Content.

4. Brauchen Besucher diese Seite direkt?

Eine nicht indexierte Seite kann weiterhin über interne Links, Lesezeichen oder direkte Verweise erreichbar sein. Das ist bei Konto-, Warenkorb- oder Bestätigungsseiten sinnvoll. Prüfen Sie aber, ob sensible Inhalte wirklich angemessen geschützt sind: Noindex ist kein Zugriffsschutz.

5. Soll die Einstellung dauerhaft gelten?

Bei einer temporären Baustelle ist es wichtig, später eine Wiedervorlage einzuplanen. Bei dauerhaft unnötigen URLs können Sie zusätzlich die interne Verlinkung, URL-Struktur oder Erzeugungslogik verbessern.

Noindex in WordPress umsetzen

In WordPress wird Noindex meist über ein SEO-Plugin, die Einstellungen des jeweiligen Inhaltstyps oder eine individuelle technische Konfiguration gesetzt. Die genaue Bezeichnung kann je nach Plugin und Version abweichen. Suchen Sie nach Optionen wie „Suchmaschinen erlauben, diesen Beitrag in den Suchergebnissen anzuzeigen?“ oder „Indexierung erlauben“.

Einzelne Seite oder einzelnen Beitrag ausschließen

  1. Öffnen Sie den betreffenden Beitrag oder die Seite im WordPress-Editor.
  2. Rufen Sie die SEO-Einstellungen des Dokuments auf.
  3. Deaktivieren Sie die Option, die eine Indexierung erlaubt, beziehungsweise wählen Sie „noindex“.
  4. Speichern oder aktualisieren Sie den Inhalt.
  5. Rufen Sie den Quelltext der veröffentlichten URL auf und suchen Sie nach noindex.

Verlassen Sie sich nicht ausschließlich auf die Anzeige im Editor. Entscheidend ist, was die öffentlich ausgelieferte URL tatsächlich enthält. Caching, mehrere SEO-Erweiterungen oder individuelle Theme-Funktionen können die Ausgabe beeinflussen.

Archiv- und Taxonomieseiten steuern

Für Kategorien, Schlagwörter, Autoren- oder Datumsarchive bieten viele Plugins globale Einstellungen. Hier ist besondere Vorsicht erforderlich. Eine sinnvolle Kategorieübersicht kann Suchenden Orientierung geben und sollte nicht allein deshalb auf Noindex stehen, weil sie ein Archiv ist.

Bewerten Sie zunächst die Qualität und Funktion der jeweiligen Archivart. Wenn Sie eine Taxonomie dauerhaft nicht benötigen, kann das Entfernen oder Zusammenführen leerer Begriffe besser sein. Wenn die Archive intern nützlich, aber für Suchmaschinen nicht relevant sind, ist Noindex eine mögliche kontrollierte Einstellung.

Robots-Meta-Tag und X-Robots-Tag

HTML-Dokumente verwenden häufig das Robots-Meta-Tag im <head>. Bei nicht-HTML-Dateien wie PDF-Dokumenten kann der Server stattdessen einen HTTP-Header ausliefern:

X-Robots-Tag: noindex

Die technische Umsetzung des Headers hängt vom Webserver, dem Hosting und der verwendeten Infrastruktur ab. Änderungen an Serverregeln sollten Sie erst nach einer Sicherung und mit einer nachvollziehbaren Rückfallmöglichkeit durchführen. Bei Unsicherheit ist die Dokumentation des Hosters oder die Unterstützung einer fachkundigen Person sinnvoll.

Kontrolle und Prüfung nach der Änderung

Eine Noindex-Einstellung ist erst dann zuverlässig bewertet, wenn Sie die veröffentlichte Ausgabe und die technischen Rahmenbedingungen kontrollieren. Arbeiten Sie am besten mit einer kleinen, wiederholbaren Prüfroutine.

  • Quelltext prüfen: Suchen Sie nach einem Robots-Meta-Tag und kontrollieren Sie, ob es tatsächlich noindex enthält.
  • HTTP-Antwort prüfen: Bei Dateien und speziellen Konfigurationen kann ein X-Robots-Tag relevant sein.
  • Robots.txt kontrollieren: Stellen Sie sicher, dass die URL nicht blockiert wird, wenn das Noindex-Signal noch abgerufen werden muss.
  • Interne Links prüfen: Entfernen Sie unnötige Links zu ausgeschlossenen Seiten, ohne wichtige Nutzerwege zu zerstören.
  • Sitemap prüfen: Nicht indexierbare URLs sollten normalerweise nicht in der XML-Sitemap stehen. Die genaue Sitemap-Konfiguration hängt vom System ab.
  • Weiterleitungen und Canonicals ansehen: Eine Noindex-Seite sollte nicht versehentlich gleichzeitig auf eine andere URL weiterleiten oder ein widersprüchliches Canonical ausgeben.
  • Nachkontrolle einplanen: Caches, Plugin-Updates und Template-Änderungen können technische Signale verändern.

Eine URL-Prüfung in einem Suchmaschinen-Tool kann zusätzliche Hinweise liefern. Dabei sollten Sie die dort angezeigten Informationen als Diagnosehilfe verstehen und mit dem tatsächlich ausgelieferten Quelltext abgleichen. Die Entfernung einer bereits bekannten URL aus einem Index kann außerdem zeitversetzt erfolgen.

Häufige Fehler beim Einsatz von Noindex

Die komplette Website auf Noindex setzen

Ein falsch gesetztes globales Robots-Signal kann alle wichtigen Inhalte betreffen. Prüfen Sie deshalb nach Änderungen an Theme, SEO-Plugin oder Hosting besonders die Startseite, wichtige Landingpages, Kategorien und Beiträge.

Noindex mit Zugriffsschutz verwechseln

Jede Person, die die URL kennt oder über einen Link erreicht, kann eine nicht indexierte Seite weiterhin aufrufen, sofern keine Authentifizierung oder andere Schutzmaßnahme greift. Für vertrauliche Inhalte benötigen Sie einen echten Zugriffsschutz.

Die URL in robots.txt sperren und Noindex erwarten

Wenn ein Crawler eine URL wegen der robots.txt nicht abrufen darf, sieht er möglicherweise auch das Meta-Tag nicht. Eine Sperre kann deshalb die gewünschte Verarbeitung des Noindex-Signals verhindern.

Wichtige Inhalte wegen geringer Wortzahl ausschließen

Die Länge allein entscheidet nicht über den Nutzen. Eine kompakte Kontakt-, Produkt- oder Hilfeseite kann für Besucher sehr relevant sein. Bewerten Sie Inhalt, Suchintention, Aktualität und Nutzerführung gemeinsam.

Noindex als Ersatz für eine schlechte Informationsarchitektur nutzen

Wenn tausende Filter-URLs entstehen, ist es oft besser, die URL-Erzeugung, interne Verlinkung und Crawling-Steuerung grundsätzlich zu analysieren. Noindex kann eine sinnvolle Maßnahme sein, sollte aber nicht die einzige Antwort auf strukturelle Probleme bleiben.

Praktische Noindex-Checkliste

Die folgende Checkliste eignet sich für einzelne Seiten ebenso wie für größere WordPress-Bereinigungen:

  1. Definieren Sie, warum die konkrete URL nicht in den Suchergebnissen erscheinen soll.
  2. Prüfen Sie, ob Überarbeitung, Zusammenlegung, Weiterleitung oder Canonical die passendere Lösung wäre.
  3. Setzen Sie Noindex gezielt auf der betroffenen URL oder in einer klar begrenzten Regel.
  4. Vermeiden Sie widersprüchliche Einstellungen in SEO-Plugin, Theme, Server und robots.txt.
  5. Entfernen Sie die URL aus der XML-Sitemap, sofern sie dort nicht benötigt wird.
  6. Kontrollieren Sie Meta-Tag oder HTTP-Header in der veröffentlichten Version.
  7. Dokumentieren Sie den Grund und prüfen Sie bei temporären Maßnahmen ein Ablaufdatum.
  8. Beobachten Sie wichtige Seiten nach Plugin-, Theme- oder Serveränderungen erneut.

FAQ

Ist Noindex schlecht für SEO?

Nein. Noindex ist zunächst eine Steuerungsanweisung. Sie kann SEO unterstützen, wenn unwichtige oder nicht eigenständige URLs aus dem Index herausgehalten werden. Problematisch wird sie nur, wenn relevante Seiten versehentlich ausgeschlossen werden.

Kann eine Noindex-Seite weiterhin aufgerufen werden?

Ja. Noindex verhindert grundsätzlich die Aufnahme in Suchergebnisse, sperrt aber nicht den direkten Zugriff. Für private oder geschützte Inhalte brauchen Sie Authentifizierung, Berechtigungen oder eine andere geeignete Zugriffskontrolle.

Soll ich noindex mit nofollow kombinieren?

Nicht automatisch. Wenn die Seite selbst nicht indexiert werden soll, Links darauf aber weiterhin für die interne Navigation relevant sind, kann noindex, follow passender sein. Die Wahl hängt vom Zweck der Seite und Ihrer Linkstrategie ab.

Wie unterscheidet sich Noindex von einem Canonical?

Noindex weist darauf hin, dass eine URL nicht gelistet werden soll. Ein Canonical nennt dagegen eine bevorzugte Version aus mehreren ähnlichen URLs. Wenn eine Variante weiterhin als Suchergebnis infrage kommt, kann ein Canonical die passendere Lösung sein.

Kann ich Noindex in der robots.txt eintragen?

Nein, noindex ist kein regulärer Ersatz für eine Robots.txt-Regel. Das Signal wird typischerweise im HTML-Meta-Tag oder über den X-Robots-Tag im HTTP-Header übertragen. Die robots.txt steuert vor allem, welche URLs ein Crawler abrufen darf.

Wie schnell verschwindet eine URL aus dem Index?

Das lässt sich nicht pauschal festlegen. Die Suchmaschine muss die URL erneut abrufen und das Signal verarbeiten. Eine Änderung im Quelltext führt daher nicht zwingend sofort zu einer sichtbaren Änderung der Suchergebnisse.

Soll eine Noindex-Seite aus der Sitemap entfernt werden?

In der Regel ja, weil eine XML-Sitemap bevorzugt URLs enthalten sollte, die Suchmaschinen indexieren dürfen und sollen. Prüfen Sie jedoch die konkrete Sitemap-Konfiguration und beheben Sie die Ursache, wenn ausgeschlossene URLs automatisch wieder aufgenommen werden.

Fazit: Noindex gezielt statt pauschal einsetzen

Noindex richtig verwenden bedeutet, die Anweisung als präzises Steuerungswerkzeug zu betrachten. Nicht jede kurze, doppelte oder technisch erzeugte URL muss automatisch ausgeschlossen werden. Entscheidend sind Suchintention, eigenständiger Nutzen, Zugriffszweck und die Frage, ob eine andere SEO-Maßnahme besser passt.

Setzen Sie Noindex möglichst gezielt, vermeiden Sie Konflikte mit robots.txt und Canonical, prüfen Sie die tatsächlich ausgelieferte Version und dokumentieren Sie wichtige Änderungen. So bleibt Ihre WordPress-Website für Besucher zugänglich, während der Suchindex auf die Inhalte konzentriert wird, die dort wirklich einen eigenständigen Beitrag leisten.