Sitemap bei Google einreichen: Anleitung, Fehlerbehebung und SEO-Tipps

Eine Sitemap hilft Suchmaschinen dabei, wichtige URLs einer Website zu entdecken und ihre Zusammenhänge besser zu verstehen. Besonders bei neuen, umfangreichen oder regelmäßig aktualisierten Websites kann es sinnvoll sein, die Sitemap bei Google einzureichen. Der Vorgang ist unkompliziert, ersetzt jedoch weder hochwertige Inhalte noch eine technisch erreichbare Website.

In diesem Ratgeber erfahren Sie, was eine Sitemap leistet, wie Sie sie in der Google Search Console einreichen, welche Dateiformate geeignet sind und wie Sie typische Fehler systematisch beheben. Außerdem geht es darum, wann eine Einreichung sinnvoll ist und welche Erwartungen realistisch sind.

Was ist eine Sitemap?

Eine Sitemap ist eine maschinenlesbare Datei, in der wichtige URLs einer Website aufgeführt werden. Für klassische Websites wird meist eine XML-Sitemap verwendet. Sie kann Suchmaschinen zusätzliche Hinweise zu Seiten, Beiträgen, Bildern oder Videos geben und die Orientierung in einer größeren Website erleichtern.

Eine XML-Sitemap ist keine vollständige Kopie der Website und auch kein Inhaltsverzeichnis für Besucher. Sie sollte vor allem URLs enthalten, die tatsächlich in den Google-Index aufgenommen werden sollen. Nicht relevante, doppelte, gelöschte oder ausdrücklich gesperrte Seiten gehören in der Regel nicht hinein.

Viele Content-Management-Systeme und SEO-Erweiterungen erzeugen eine Sitemap automatisch. Häufig liegt sie beispielsweise unter einer Adresse wie https://www.beispiel.de/sitemap.xml. Bei manchen Systemen gibt es stattdessen eine Sitemap-Indexdatei, die auf mehrere einzelne Sitemaps verweist.

Warum sollte man eine Sitemap bei Google einreichen?
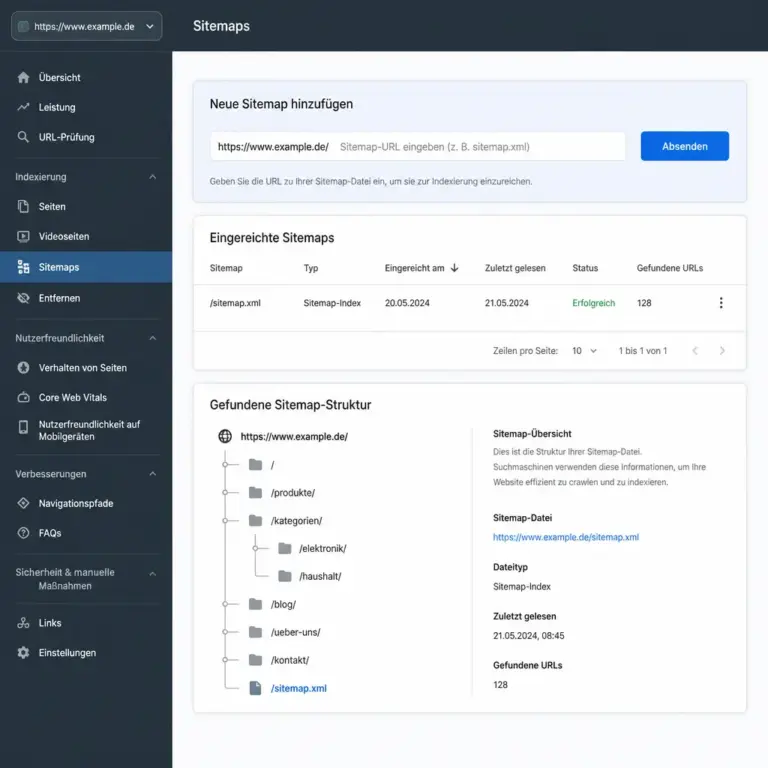
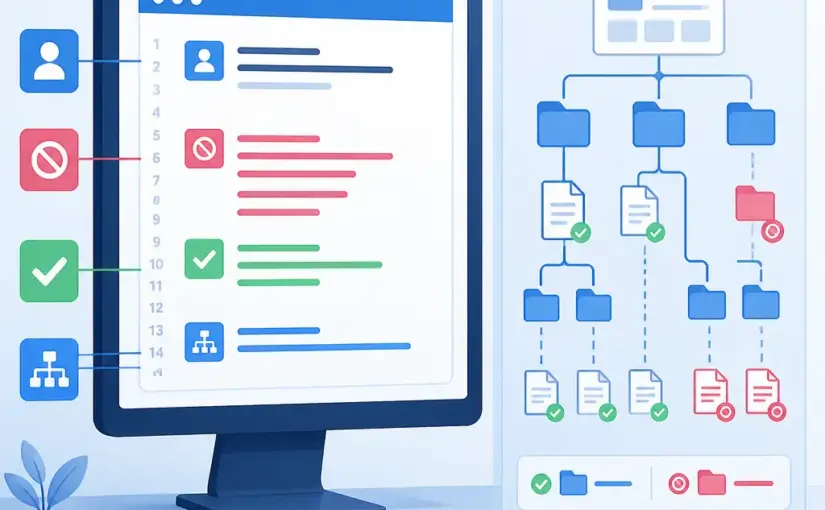
Eingabebereich zum Einreichen einer Sitemap in einer Suchmaschinenverwaltung
Die Sitemap wird über den dafür vorgesehenen Bereich der Search Console übermittelt.

Die Abbildung zeigt, wo der Pfad der Sitemap eingetragen wird und warum die Auswahl der richtigen Website-Property wichtig ist. Leser sollten auf die vollständige URL und den anschließenden Statusbericht achten.

Google kann Sitemaps häufig auch selbst entdecken, etwa über interne Links oder einen Eintrag in der Datei robots.txt. Die manuelle Einreichung über die Google Search Console schafft jedoch einen klaren Kommunikationsweg und liefert zusätzliche Informationen zum Verarbeitungsstatus.

  • Bessere Auffindbarkeit: Neue oder tief verschachtelte URLs können leichter entdeckt werden, sofern sie technisch zugänglich sind.
  • Mehr Übersicht: Die Search Console zeigt, ob Google die angegebene Sitemap abrufen und verarbeiten konnte.
  • Frühere Fehlererkennung: Ungültige URLs, Abrufprobleme oder Formatfehler werden eher sichtbar.
  • Unterstützung bei großen Websites: Viele URLs lassen sich strukturierter an Google übermitteln.
  • Hilfreich bei Änderungen: Nach einem Relaunch oder einer größeren Überarbeitung kann die aktuelle Sitemap die Orientierung unterstützen.

Wichtig ist die richtige Erwartung: Eine eingereichte Sitemap garantiert weder eine Indexierung noch gute Rankings. Google entscheidet für jede URL unabhängig, ob sie gecrawlt, indexiert und in den Suchergebnissen angezeigt wird.

Voraussetzungen vor der Einreichung

Bevor Sie die Sitemap bei Google einreichen, sollten einige Grundlagen stimmen. Dadurch vermeiden Sie, dass die Search Console zwar eine Datei akzeptiert, diese aber viele problematische URLs enthält.

Die richtige Website-Property auswählen

Für die Google Search Console benötigen Sie eine bestätigte Property. Dabei muss die Sitemap zur richtigen Website und zum passenden Protokoll gehören. Eine Sitemap für https://www.beispiel.de sollte nicht versehentlich in einer Property für eine andere Domain oder ausschließlich für http:// eingereicht werden.

Bei Domain-Properties werden mehrere Varianten einer Domain zusammengefasst. Bei URL-Präfix-Properties ist der erfasste Bereich enger. Prüfen Sie deshalb vor dem Absenden, ob Sie sich in der richtigen Property befinden.

Die Sitemap muss erreichbar sein

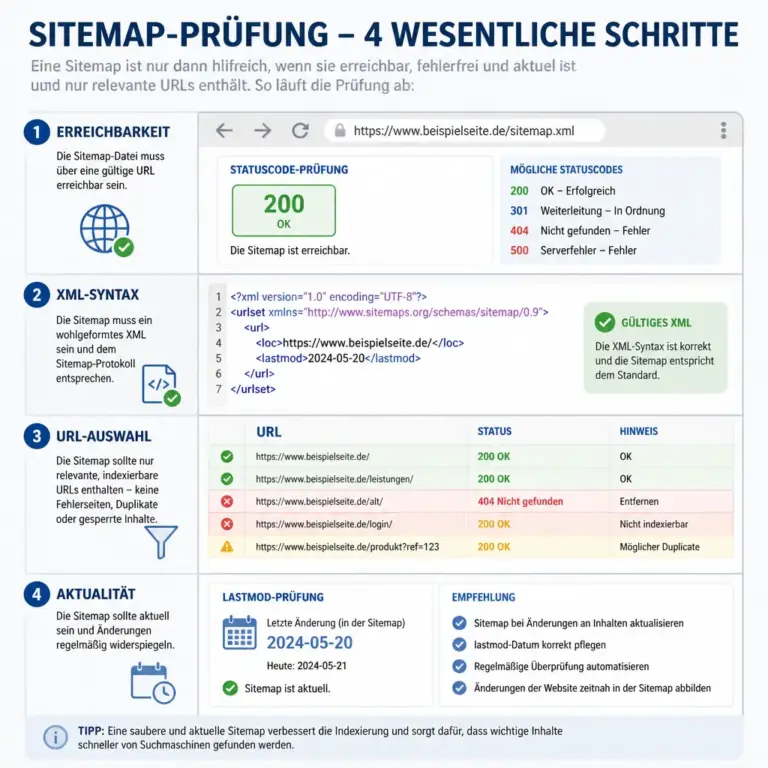
Rufen Sie die Sitemap zunächst selbst im Browser auf. Sie sollte ohne Login, Blockierung oder Weiterleitungskette erreichbar sein. Eine XML-Datei muss nicht besonders lesefreundlich aussehen; entscheidend ist, dass der Server sie korrekt ausliefert und der Inhalt gültig ist.

Prüfen Sie außerdem, ob die Sitemap nicht versehentlich durch eine Firewall, ein Sicherheits-Plugin oder eine Zugriffsbeschränkung blockiert wird. Bei einer geschützten Entwicklungsumgebung kann Google die Datei nicht zuverlässig abrufen.

Nur kanonische und indexierbare URLs aufnehmen

Die enthaltenen URLs sollten grundsätzlich erreichbar sein und eine sinnvolle Indexierung ermöglichen. Entfernen Sie insbesondere URLs, die auf eine andere Adresse weiterleiten, einen Fehlerstatus liefern oder per noindex von der Indexierung ausgeschlossen sind.

Auch Parameter-URLs, interne Suchergebnisse, Filterkombinationen und nahezu identische Varianten können eine Sitemap unnötig aufblähen. Die Datei sollte die wichtigsten Inhalte priorisieren, nicht jede technisch erzeugbare URL dokumentieren.

Sitemap bei Google einreichen: Schritt für Schritt

Die Einreichung erfolgt in der Google Search Console. Die Bezeichnungen der Oberfläche können sich gelegentlich ändern, das grundlegende Vorgehen bleibt jedoch ähnlich.

1. Google Search Console öffnen

Melden Sie sich mit dem Google-Konto an, das Zugriff auf die betreffende Property besitzt. Wählen Sie anschließend im Auswahlfeld die Website aus, für die Sie die Sitemap einreichen möchten.

2. Zum Bereich für Sitemaps wechseln

Öffnen Sie in der Navigation den Bereich Sitemaps. Dort finden Sie ein Eingabefeld, über das eine neue Sitemap übermittelt werden kann. Bereits bekannte Dateien und deren Status werden meist darunter angezeigt.

3. Sitemap-URL eintragen

Bei vielen Properties tragen Sie nicht die komplette Domain, sondern nur den Pfad der Sitemap ein, zum Beispiel sitemap.xml oder sitemap_index.xml. Achten Sie genau auf Schreibweise, Groß- und Kleinschreibung sowie den verwendeten Dateinamen.

Wenn die Search Console bereits einen Teil der URL vorausfüllt, ergänzen Sie nur den fehlenden Pfad. Prüfen Sie vor dem Absenden, ob die daraus entstehende vollständige Adresse tatsächlich auf die gewünschte Datei zeigt.

4. Übermittlung absenden

Klicken Sie auf die Schaltfläche zum Einreichen. Google versucht anschließend, die Datei abzurufen und zu verarbeiten. Das Ergebnis kann je nach Umfang, Serverreaktion und aktueller Verarbeitung nicht sofort vollständig sichtbar sein.

5. Status kontrollieren

Sehen Sie später erneut im Sitemap-Bericht nach. Ein erfolgreicher Abruf bedeutet, dass Google die Datei erreichen und grundsätzlich verarbeiten konnte. Das ist jedoch nicht dasselbe wie die Indexierung jeder einzelnen enthaltenen URL.

Bei einer Sitemap-Indexdatei kann Google zusätzlich einzelne untergeordnete Sitemaps verarbeiten. Kontrollieren Sie auch diese Einträge, wenn im Bericht Warnungen oder Fehler auftauchen.

Welche Sitemap-Formate unterstützt Google?

Für die meisten Websites ist eine XML-Sitemap die beste Wahl. Sie kann einzelne Seiten-URLs oder Verweise auf weitere Sitemap-Dateien enthalten. Eine Sitemap-Indexdatei ist besonders praktisch, wenn die Website so groß ist, dass mehrere Dateien verwaltet werden müssen.

Je nach Website-Typ können außerdem spezielle Sitemaps für Bilder, Videos oder Nachrichten relevant sein. Sie sind nicht automatisch für jede Website erforderlich. Entscheidend ist, ob der betreffende Inhalt tatsächlich einen zusätzlichen strukturierten Hinweis benötigt und ob das verwendete System ihn korrekt erzeugt.

Eine HTML-Seite mit einer Liste von Links ist keine XML-Sitemap im engeren Sinn. Sie kann für Besucher und interne Verlinkung nützlich sein, wird aber in der Search Console nicht wie eine XML-Sitemap behandelt.

Was gehört in eine gute XML-Sitemap?

Eine gute Sitemap ist aktuell, übersichtlich und auf wertvolle Inhalte konzentriert. Für jede URL sollten mehrere Kriterien erfüllt sein:

  • Die Adresse verwendet das bevorzugte Protokoll, üblicherweise HTTPS.
  • Die URL ist mit dem Statuscode 200 erreichbar oder wird technisch korrekt ausgeliefert.
  • Die Seite ist nicht durch noindex ausgeschlossen.
  • Die URL entspricht der bevorzugten kanonischen Version.
  • Der Inhalt ist für Nutzer relevant und nicht bloß eine technische Variante.
  • Die Datei enthält keine veralteten oder dauerhaft entfernten Adressen.

Das Änderungsdatum einer URL, häufig als lastmod angegeben, sollte nur gepflegt werden, wenn sich der wesentliche Inhalt tatsächlich geändert hat. Ein bei jedem Aufruf automatisch aktualisiertes Datum liefert keinen verlässlichen Hinweis und kann die Aussagekraft der Sitemap schwächen.

Die Prioritätsangaben und Änderungsfrequenzen, die manche Generatoren anbieten, sind kein Ersatz für eine gute Website-Struktur. Verwenden Sie solche Angaben nur, wenn Ihr System sie sinnvoll und konsistent erzeugt.

Typische Fehler beim Einreichen einer Sitemap

Wenn Google eine Sitemap nicht verarbeiten kann, liegt die Ursache häufig nicht bei der Search Console selbst. Prüfen Sie die Datei und die betroffenen URLs in mehreren Schritten.

Die Sitemap wurde nicht gefunden

Eine Meldung wie Sitemap konnte nicht abgerufen werden kann auf eine falsche URL, einen Serverfehler, eine Blockierung oder eine kurzfristige Nichterreichbarkeit hindeuten. Öffnen Sie die Datei im Browser und prüfen Sie zusätzlich die Server- und Sicherheitsprotokolle.

Ungültiges XML oder falsche Kodierung

XML verlangt eine korrekte Struktur. Nicht maskierte Sonderzeichen, beschädigte Zeichenkodierungen, zusätzliche Inhalte vor der XML-Deklaration oder fehlerhafte Tags können die Verarbeitung verhindern. Lassen Sie die Datei gegebenenfalls mit einem geeigneten XML-Prüfwerkzeug validieren.

URLs aus einer anderen Domain

Die Sitemap sollte zum vorgesehenen Website-Bereich passen. Verweise auf eine fremde Domain oder eine nicht passende Subdomain können zu Warnungen führen. Prüfen Sie auch, ob www- und non-www-Varianten sowie HTTP und HTTPS konsistent verwendet werden.

Weiterleitungen und Fehlerseiten

Eine Sitemap mit vielen Weiterleitungen, nicht gefundenen Seiten oder Serverfehlern ist ein deutliches Wartungssignal. Aktualisieren Sie den Generator, entfernen Sie gelöschte URLs und ersetzen Sie alte Adressen durch ihre aktuelle kanonische Version.

Die Sitemap ist blockiert

Die Datei darf nicht durch robots.txt, Zugriffsschutz oder eine Serverregel unerreichbar sein. Die robots.txt kann zusätzlich die vollständige Sitemap-Adresse nennen, etwa mit einer Zeile wie Sitemap: https://www.beispiel.de/sitemap.xml. Das ersetzt die Einreichung in der Search Console nicht zwingend, verbessert aber die Auffindbarkeit.

Sitemap nach einem Relaunch oder einer Migration

Nach einem Domainwechsel, einer Umstellung auf HTTPS oder einer neuen URL-Struktur sollten Sie besonders sorgfältig vorgehen. Richten Sie zunächst die passenden Properties in der Search Console ein und stellen Sie sicher, dass die neue Sitemap ausschließlich die neuen, erreichbaren URLs enthält.

Weiterleitungen von alten auf neue Adressen sollten dauerhaft und inhaltlich passend eingerichtet werden. Eine Sitemap mit alten URLs hilft nach einer Migration nur begrenzt. Sie sollte vielmehr den aktuellen Zielzustand abbilden, während interne Links, kanonische Angaben und Weiterleitungen konsistent auf die neue Struktur verweisen.

Bei einer größeren Umstellung empfiehlt sich eine technische Prüfung nach dem Livegang. Kontrollieren Sie unter anderem wichtige Statuscodes, die robots.txt, Canonical-Tags, interne Verlinkung und die Abdeckung relevanter Seiten. Die Sitemap ist dabei ein Kontrollinstrument, aber keine vollständige Relaunch-Prüfung.

Wie oft sollte man eine Sitemap einreichen?

Eine Sitemap muss normalerweise nicht nach jeder kleinen Änderung erneut eingereicht werden. Wenn die Datei unter derselben URL automatisch aktualisiert wird, kann Google die Änderungen bei späteren Abrufen erkennen.

Eine erneute Übermittlung kann sinnvoll sein, wenn sich der Dateipfad geändert hat, eine neue Sitemap-Indexdatei verwendet wird oder die Website nach einer größeren technischen Änderung aktualisiert wurde. Das wiederholte Einreichen derselben unveränderten Datei beschleunigt die Indexierung nicht automatisch.

Wichtiger als häufiges Absenden sind eine stabile Erreichbarkeit, korrekte URLs und eine nachvollziehbare Website-Struktur. Für einzelne besonders wichtige neue Seiten kann zusätzlich die Funktion zur Prüfung einer einzelnen URL in der Search Console relevant sein. Auch sie garantiert jedoch keine sofortige Aufnahme in den Index.

Sitemap und SEO: Was sie leisten und was nicht

Eine Sitemap verbessert nicht direkt die Qualität eines Textes, die Nutzererfahrung oder die Autorität einer Website. Sie kann Google jedoch helfen, bereits vorhandene Inhalte effizienter zu entdecken. Der größte Nutzen entsteht deshalb, wenn die technischen Grundlagen und die Inhalte gleichzeitig gepflegt werden.

Für eine nachhaltige Suchmaschinenoptimierung sind unter anderem klare interne Links, hilfreiche und eigenständige Inhalte, eine gute mobile Darstellung, kurze Ladezeiten sowie verständliche Seitentitel und Beschreibungen wichtig. Eine Sitemap kann diese Maßnahmen ergänzen, aber nicht ersetzen.

Bei kleinen Websites mit gut verlinkten Seiten ist der zusätzliche Effekt oft begrenzt. Bei großen Onlineshops, Nachrichtenseiten, Portalen, vielen Beiträgen oder neuen Websites mit wenigen externen Verweisen kann eine gepflegte Sitemap dagegen besonders nützlich sein.

Praktische Checkliste für die Einreichung

  • Ist die richtige Property in der Google Search Console ausgewählt?
  • Ist die Sitemap-URL ohne Login und ohne unerwartete Blockierung erreichbar?
  • Enthält die Datei nur aktuelle, kanonische und indexierbare URLs?
  • Verwendet die Sitemap die richtige Domain- und Protokollvariante?
  • Sind Weiterleitungen, Fehlerseiten und gelöschte URLs entfernt?
  • Ist die XML-Struktur gültig?
  • Wird ein realistisches Änderungsdatum verwendet?
  • Wurde der Status nach der Übermittlung kontrolliert?
  • Passt die Sitemap zur aktuellen Website-Struktur und zum letzten Relaunch?

Wenn Sie diese Punkte regelmäßig prüfen, wird die Sitemap zu einem verlässlichen Bestandteil der technischen Website-Pflege. Bei sehr großen Websites kann es zusätzlich sinnvoll sein, Sitemaps nach Inhaltstyp, Verzeichnis oder Aktualität zu strukturieren, solange die Aufteilung nachvollziehbar bleibt.

FAQ

Muss jede Website eine Sitemap haben?

Nein. Kleine, gut intern verlinkte Websites können auch ohne manuell eingereichte Sitemap gefunden werden. Sie ist dennoch eine sinnvolle Ergänzung, wenn viele URLs, häufige Änderungen, neue Inhalte oder eine komplexe Struktur vorliegen.

Garantiert das Einreichen die Indexierung?

Nein. Die Sitemap übermittelt Hinweise zu URLs, garantiert aber weder Crawling noch Indexierung oder Rankings. Google bewertet zusätzlich technische Zugänglichkeit, Qualität, Eigenständigkeit, Relevanz und weitere Signale.

Wo finde ich die Sitemap meiner WordPress-Website?

Viele WordPress-Installationen stellen automatisch eine Sitemap bereit. Je nach Version, Theme oder Erweiterung kann der Pfad unterschiedlich sein. Prüfen Sie die Einstellungen Ihrer Website und rufen Sie die vermutete Adresse direkt auf. Vermeiden Sie es, mehrere konkurrierende Sitemap-Systeme unkontrolliert parallel zu betreiben.

Kann ich mehrere Sitemaps einreichen?

Ja. Das kann bei großen Websites oder verschiedenen Inhaltstypen sinnvoll sein. Häufig wird dafür eine Sitemap-Indexdatei verwendet, die auf einzelne Dateien verweist. Jede Datei sollte korrekt aufgebaut sein und einen klar abgegrenzten URL-Bestand enthalten.

Was bedeutet der Status „Erfolgreich“?

Der Status zeigt in der Regel, dass Google die Sitemap abrufen und verarbeiten konnte. Er bestätigt nicht, dass jede enthaltene URL indexiert wurde. Für einzelne Seiten müssen Sie die Indexierungsinformationen separat betrachten.

Wie lange dauert es, bis Google die Sitemap verarbeitet?

Das lässt sich nicht pauschal vorhersagen. Die Verarbeitung hängt unter anderem von Serververfügbarkeit, Umfang und Aktualität der Website ab. Eine Sitemap ist ein Hinweis, kein Auftrag zur sofortigen Indexierung.

Ist eine Sitemap für Bilder oder Videos immer nötig?

Nein. Spezielle Sitemaps können bei umfangreichen Bild- oder Videobeständen hilfreich sein, sind aber nicht für jede Website erforderlich. Entscheidend ist, ob sie zusätzliche, korrekt gepflegte Informationen liefern und vom verwendeten System zuverlässig erzeugt werden.

Fazit: Sitemap gezielt und sauber einreichen

Eine Sitemap bei Google einzureichen ist schnell erledigt, wenn die Datei korrekt erzeugt wird und die richtige Search-Console-Property ausgewählt ist. Der nachhaltige Nutzen entsteht jedoch erst durch eine laufende Pflege: Die Sitemap sollte aktuelle, erreichbare und tatsächlich relevante URLs enthalten.

Kontrollieren Sie nach der Einreichung den Verarbeitungsstatus, beheben Sie technische Fehler und betrachten Sie die Sitemap als Teil eines größeren SEO-Prozesses. Gute Inhalte, sinnvolle interne Verlinkung und eine stabile technische Grundlage bleiben entscheidend dafür, dass Google Ihre Website nicht nur findet, sondern ihre Seiten auch sinnvoll bewerten kann.
Indexierung einer Website überprüfen: Der umfassende Ratgeber

Wer organischen Traffic gewinnen möchte, muss zuerst sicherstellen, dass Suchmaschinen die wichtigen Seiten einer Website finden, crawlen und in ihren Index aufnehmen können. Eine technisch erreichbare Seite ist nämlich nicht automatisch auch in den Suchergebnissen sichtbar. Mit einer systematischen Prüfung lassen sich fehlende Seiten, versehentliche Sperren und Qualitätsprobleme meist deutlich schneller erkennen.

Dieser Ratgeber zeigt, wie Sie die Indexierung einer Website überprüfen, welche Werkzeuge dafür geeignet sind und wie Sie typische Ursachen für fehlende Sichtbarkeit unterscheiden. Dabei geht es nicht nur um einzelne URLs, sondern um das Zusammenspiel aus Crawling, Indexierung, internen Verlinkungen, Inhaltsqualität und technischen Signalen.

Was bedeutet Indexierung?

Beim Crawling ruft ein Suchmaschinenbot eine URL ab und analysiert deren Inhalt. Bei der Indexierung entscheidet die Suchmaschine anschließend, ob und in welcher Form die Seite in ihren Suchindex aufgenommen wird. Erst danach kann sie für passende Suchanfragen als Ergebnis erscheinen.

Diese Schritte sind voneinander zu unterscheiden:

  • Entdeckung: Die Suchmaschine erhält Kenntnis von einer URL, zum Beispiel über einen Link, eine XML-Sitemap oder bereits bekannte Daten.
  • Crawling: Ein Bot ruft die URL ab und versucht, den Inhalt technisch zu verarbeiten.
  • Indexierung: Die Seite wird bewertet und gegebenenfalls in den Index aufgenommen.
  • Ausspielung: Die indexierte Seite kann bei geeigneten Suchanfragen sichtbar werden.

Eine Seite kann also gecrawlt, aber nicht indexiert sein. Ebenso kann sie indexiert sein, ohne für ein wichtiges Keyword eine gute Position zu erreichen. Deshalb sollte eine Indexierungsprüfung nicht mit einer einfachen Suche nach dem Domainnamen enden.

Warum die Indexierung einer Website regelmäßig überprüft werden sollte

Werkzeuge zur Pru00fcfung der Website-Indexierung
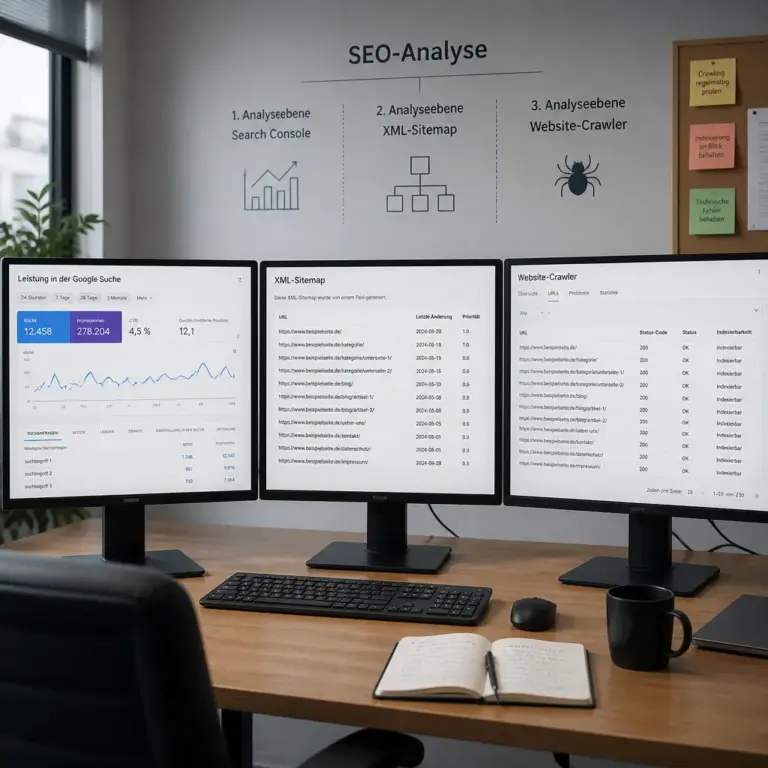
Mehrere Datenquellen ergänzen sich bei der Indexierungsprüfung.

Die Darstellung sollte zeigen, dass eine verlässliche Prüfung nicht auf einem einzigen Werkzeug beruht. Besonders wichtig ist der Abgleich zwischen URL-Status, Sitemap und technischer Website-Analyse.

Neue Websites, Relaunches und größere technische Änderungen bringen häufig unbeabsichtigte Folgen mit sich. Eine Entwicklungsumgebung kann beispielsweise eine globale Noindex-Anweisung enthalten, die beim Livegang übersehen wird. Auch Änderungen an Canonical-Tags, Weiterleitungen, URL-Strukturen oder internen Links können die Auffindbarkeit beeinflussen.

Eine regelmäßige Kontrolle hilft unter anderem dabei, folgende Probleme früh zu erkennen:

  • wichtige Seiten mit einem versehentlichen noindex-Meta-Tag,
  • gesperrte Verzeichnisse in der robots.txt,
  • fehlerhafte oder nicht erreichbare XML-Sitemaps,
  • verwaiste Seiten ohne interne Links,
  • mehrere URLs mit nahezu identischem Inhalt,
  • falsche Canonical-Verweise,
  • Serverfehler, Weiterleitungsketten oder Soft-404-Seiten,
  • Seiten, die zwar indexiert sind, aber keinen ausreichenden eigenständigen Nutzen bieten.

Die Prüfung ist besonders wichtig, wenn sich die Anzahl indexierter URLs stark verändert. Ein Rückgang muss nicht automatisch eine Strafe bedeuten; er kann durch eine technische Bereinigung, entfernte Inhalte oder eine veränderte Erfassung entstehen. Entscheidend ist, ob die betroffenen URLs absichtlich entfernt wurden und ob die wichtigen Seiten weiterhin verfügbar sind.

Die wichtigsten Werkzeuge für eine Indexierungsprüfung

Kein einzelnes Werkzeug zeigt die gesamte Situation perfekt. Aussagekräftiger wird die Analyse, wenn mehrere Datenquellen miteinander verglichen werden.

Google Search Console

Für Websites in der Google-Suche ist die Search Console eine zentrale Anlaufstelle. Im Bericht zur Indexierung lässt sich nachvollziehen, welche URLs als indexiert gelten und welche ausgeschlossen wurden. Die jeweiligen Gründe liefern wichtige Hinweise, etwa „Durch noindex ausgeschlossen“, „Duplikat“ oder „Gecrawlt – derzeit nicht indexiert“.

Mit der URL-Prüfung können Sie einzelne Seiten untersuchen. Sie erhalten unter anderem Informationen zur zuletzt bekannten Version, zur Indexierbarkeit und zum ausgewählten Canonical. Die Live-Prüfung kann zusätzlich zeigen, ob eine Seite aktuell abrufbar ist. Sie ersetzt jedoch keine vollständige Qualitäts- oder Rankinganalyse.

Bing Webmaster Tools

Wenn Sichtbarkeit in mehreren Suchmaschinen relevant ist, sollten auch die Bing Webmaster Tools berücksichtigt werden. Die Berichte können zusätzliche Hinweise zu Crawling, Sitemaps und technischen Auffälligkeiten geben. Unterschiedliche Suchmaschinen können dieselbe Website unterschiedlich verarbeiten; ein Vergleich ist daher sinnvoll.

Suchoperatoren als schneller Plausibilitätscheck

Eine Suche mit site:beispiel.de zeigt eine Auswahl von Seiten, die eine Suchmaschine der Domain zuordnet. Das ist ein schneller Hinweis, aber keine vollständige und exakte Bestandsaufnahme. Die angezeigte Anzahl kann schwanken, und nicht jede indexierte URL wird immer in der sichtbaren Trefferliste dargestellt.

Zusätzliche Suchabfragen können helfen, problematische Muster zu finden, etwa bestimmte Verzeichnisse, Parameter oder alte URL-Strukturen. Solche Abfragen sollten als Ergänzung und nicht als Ersatz für die Search Console verstanden werden.

Crawler und eigene URL-Listen

Ein Website-Crawler kann interne Links, Statuscodes, Canonical-Tags, Meta-Robots-Anweisungen, Weiterleitungen und viele weitere Merkmale erfassen. Für größere Websites ist eine solche technische Bestandsaufnahme besonders hilfreich. Die Ergebnisse sollten anschließend mit einer Liste der tatsächlich gewünschten indexierbaren Seiten verglichen werden.

Eine einfache Tabelle mit URL, Seitentyp, gewünschtem Indexierungsstatus, HTTP-Status, Canonical und Priorität schafft dabei Transparenz. So wird sichtbar, ob beispielsweise Produktseiten, Ratgeberartikel oder Kategorieseiten unterschiedlich behandelt werden müssen.

Indexierung einer Website überprüfen: Schritt-für-Schritt-Anleitung

1. Gewünschte indexierbare Seiten definieren

Bevor Sie Fehler suchen, sollten Sie festlegen, welche Seitentypen überhaupt in den Suchindex gehören. Das können beispielsweise hochwertige Leistungsseiten, Produktseiten, redaktionelle Ratgeber oder lokale Standortseiten sein. Nicht jede URL muss indexiert werden. Interne Suchergebnisse, Warenkorbseiten, persönliche Kontobereiche und viele Filterkombinationen sind häufig keine eigenständigen Suchergebnisse.

Erstellen Sie deshalb eine Zielvorstellung: Welche Seiten sollen gefunden werden, welche dürfen zugänglich bleiben, sollen aber nicht im Index erscheinen, und welche URLs können vollständig entfernt oder weitergeleitet werden? Ohne diese Unterscheidung wirkt eine hohe Zahl ausgeschlossener URLs schnell wie ein Fehler, obwohl sie beabsichtigt sein kann.

2. Die Indexierungsberichte auswerten

Beginnen Sie mit der Search Console und betrachten Sie nicht nur die Gesamtzahl, sondern vor allem die konkreten Ausschlussgründe. Prüfen Sie, ob sich die betroffenen URLs auf wichtige Seitentypen konzentrieren. Ein Ausschluss ist nicht automatisch problematisch; problematisch wird er, wenn eine wertvolle Zielseite betroffen ist.

Priorisieren Sie die Analyse nach geschäftlicher und redaktioneller Bedeutung. Eine einzelne wichtige Angebotsseite kann dringender sein als viele bewusst ausgeschlossene Parameter-URLs. Dokumentieren Sie für jeden relevanten Fall die vermutete Ursache, die gewünschte Lösung und den Zeitpunkt der erneuten Prüfung.

3. Einzelne wichtige URLs mit der URL-Prüfung kontrollieren

Wählen Sie repräsentative URLs aus: die Startseite, wichtige Kategorie- oder Leistungsseiten, neue Inhalte, stark verlinkte Artikel und Seiten mit auffälligen Zugriffsrückgängen. Prüfen Sie, ob die URL indexiert ist und ob die angezeigte Canonical-URL der eigenen Absicht entspricht.

Wenn eine Seite nicht indexiert ist, kontrollieren Sie die Live-Version zusätzlich. Eine Diskrepanz zwischen der zuletzt gespeicherten Version und dem aktuellen Zustand kann darauf hindeuten, dass Änderungen noch nicht verarbeitet wurden oder dass die technische Situation inzwischen anders ist.

4. Technische Indexierungssignale prüfen

Für jede wichtige Seite sollten mehrere Signale zusammenpassen:

  • Der Server liefert einen erfolgreichen Statuscode, normalerweise 200.
  • Die Seite ist ohne Anmeldung erreichbar und wird nicht durch eine fehlerhafte Weiterleitung ersetzt.
  • Es gibt kein unbeabsichtigtes noindex im HTML oder in einem HTTP-Header.
  • Die robots.txt blockiert den benötigten Abruf nicht.
  • Der Canonical verweist auf die bevorzugte, indexierbare URL.
  • Die Seite enthält eigenständigen und nützlichen Inhalt.
  • Sie ist über sinnvolle interne Links erreichbar.

Wichtig ist das Zusammenspiel dieser Signale. Ein Canonical-Tag kann eine Präferenz ausdrücken, ersetzt aber keine sinnvolle URL-Struktur. Eine XML-Sitemap kann eine URL bekannt machen, hebt eine Noindex-Anweisung jedoch nicht automatisch auf.

5. XML-Sitemap und interne Verlinkung abgleichen

Die XML-Sitemap sollte bevorzugt URLs enthalten, die dauerhaft erreichbar, kanonisch und tatsächlich indexierbar sind. Entfernen Sie dort nach Möglichkeit Weiterleitungen, Fehlerseiten, nicht kanonische Varianten und Seiten, die ausdrücklich nicht in den Index sollen.

Vergleichen Sie die Sitemap anschließend mit den internen Links und den Search-Console-Daten. Fehlt eine wichtige Seite in der Sitemap, kann sie trotzdem indexiert werden, sollte aber nicht unnötig schwer auffindbar sein. Umgekehrt ist ein Eintrag in der Sitemap keine Garantie für eine Indexierung.

Besonders kritisch sind verwaiste Seiten. Wenn eine URL nur in der Sitemap steht, aber von keiner relevanten Seite intern verlinkt wird, fehlen Suchmaschinen und Nutzern wichtige Kontextsignale. Ergänzen Sie passende Links in thematisch verwandten Inhalten, Navigationselementen oder Übersichtsseiten.

6. Inhalte auf eigenständigen Nutzen prüfen

Technische Erreichbarkeit allein reicht nicht immer aus. Suchmaschinen können Seiten mit sehr wenig eigenständigem Inhalt, automatisch erzeugten Varianten oder stark ähnlichen Texten nicht prominent berücksichtigen oder gar nicht indexieren. Prüfen Sie deshalb, ob eine Seite eine klar erkennbare Suchintention beantwortet und gegenüber ähnlichen URLs einen eigenen Zweck erfüllt.

Hilfreiche Fragen sind:

  • Welche konkrete Frage oder Aufgabe beantwortet diese URL?
  • Ist der Inhalt verständlich, aktuell und ausreichend präzise?
  • Enthält die Seite Informationen, die nicht nur aus austauschbaren Standardtexten bestehen?
  • Kann ein Nutzer nach dem Lesen eine sinnvolle Entscheidung treffen oder einen nächsten Schritt ausführen?
  • Gibt es eine andere URL auf der Website, die dieselbe Aufgabe besser erfüllt?

Wenn mehrere URLs nahezu denselben Zweck haben, können eine Zusammenführung, eine klare Canonical-Strategie oder eine gezielte Aussonderung sinnvoller sein. Die richtige Lösung hängt vom Inhalt und von der Nutzerführung ab.

Häufige Gründe für fehlende Indexierung

Noindex-Anweisung

Ein Meta-Robots-Tag mit noindex oder ein entsprechender HTTP-Header weist Suchmaschinen an, die Seite nicht in den Index aufzunehmen. Das ist bei nicht öffentlichen oder funktionalen Seiten nützlich, wird aber bei Relaunches oder durch fehlerhafte Vorlagen manchmal versehentlich auf wichtige Inhalte übertragen.

Blockierung durch robots.txt

Die robots.txt steuert, welche Bereiche gecrawlt werden dürfen. Eine Sperre kann den Abruf einer Seite verhindern, ist aber nicht das geeignete Mittel, um eine bereits bekannte URL zuverlässig aus dem Index zu entfernen. Prüfen Sie Regeln immer im Zusammenhang mit dem gewünschten Ziel und vermeiden Sie pauschale Sperren ganzer Verzeichnisse, wenn darin wichtige Inhalte liegen.

Falsches Canonical

Verweist das Canonical einer Seite auf eine andere URL, kann die Suchmaschine diese andere Adresse als bevorzugte Version behandeln. Ein Fehler entsteht beispielsweise, wenn viele unterschiedliche Seiten auf die Startseite oder eine alte URL kanonisiert werden. Das Canonical sollte zur tatsächlichen Inhaltsstruktur passen und auf eine erreichbare, indexierbare Zielseite zeigen.

„Gecrawlt – derzeit nicht indexiert“

Dieser Status bedeutet nicht zwangsläufig einen technischen Defekt. Er kann darauf hindeuten, dass die Seite zwar abgerufen wurde, aber derzeit keinen ausreichenden eigenständigen Wert erkennen lässt, sehr ähnlich zu anderen URLs ist oder noch nicht verarbeitet wurde. Prüfen Sie Inhalt, interne Verlinkung, Seitentyp und technische Signale gemeinsam, statt die URL lediglich mehrfach zur Indexierung einzureichen.

Server- und Weiterleitungsfehler

Statuscodes wie 404 oder 410 sind bei absichtlich entfernten Inhalten normal, bei wichtigen Landingpages jedoch problematisch. Auch dauerhafte Weiterleitungen sollten möglichst direkt auf das passende Ziel führen. Ketten, Schleifen und wechselnde Weiterleitungsziele erschweren die Verarbeitung und verschlechtern die Nutzererfahrung.

JavaScript und schwer zugängliche Inhalte

Moderne Websites können Inhalte dynamisch laden. Wenn der wesentliche Text erst durch fehlerhaftes JavaScript erscheint oder wichtige Links nicht als normale, verarbeitbare Verknüpfungen vorliegen, kann die Verarbeitung erschwert werden. Prüfen Sie daher, ob der Hauptinhalt auch in einer technisch robusten Auslieferung vorhanden ist und ob zentrale Navigationswege funktionieren.

Wie Sie Indexierungsprobleme sinnvoll beheben

Beginnen Sie mit der Ursache und nicht mit dem erneuten Einreichen jeder betroffenen URL. Entfernen Sie eine unbeabsichtigte Noindex-Anweisung, korrigieren Sie den Canonical, beheben Sie den Serverfehler oder verbessern Sie die interne Verlinkung. Bei Qualitätsproblemen sollte zuerst der Inhalt überarbeitet werden.

Danach können Sie die betroffene URL in der Search Console erneut prüfen lassen oder eine Validierung des entsprechenden Problems anstoßen. Die Verarbeitung benötigt Zeit und ist keine Garantie für eine Aufnahme. Kontrollieren Sie nach angemessener Wartezeit, ob sich der Status und die Sichtbarkeit tatsächlich verändert haben.

Bei vielen URLs empfiehlt sich ein kontrolliertes Vorgehen:

  1. Problem und betroffene URL-Gruppe dokumentieren.
  2. Ursache anhand von Quellcode, Serverantwort, robots.txt, Sitemap und internen Links bestätigen.
  3. Änderung zunächst an repräsentativen URLs testen.
  4. Die technische Umsetzung auf weitere URLs ausrollen.
  5. Nachverfolgen, ob die wichtigen Seiten erreichbar, indexierbar und in den Berichten korrekt eingeordnet sind.

Messbare Kriterien für eine verlässliche Kontrolle

Eine gute Prüfung beschränkt sich nicht auf „indexiert“ oder „nicht indexiert“. Sinnvolle Kontrollgrößen sind unter anderem:

Kriterium Worauf Sie achten sollten
Indexierbare Zielseiten Wichtige URLs sind technisch erreichbar, nicht versehentlich gesperrt und eindeutig zugeordnet.
Ausschlussgründe Bewusste Ausschlüsse sind nachvollziehbar; wichtige Inhalte tauchen nicht unerwartet darin auf.
XML-Sitemap Sie enthält aktuelle, kanonische und indexierbare URLs ohne unnötige Varianten.
Interne Verlinkung Relevante Seiten sind über thematisch passende Links erreichbar.
Statuscodes Wichtige Inhalte liefern eine passende erfolgreiche Antwort und keine Fehler- oder Umleitungskette.
Organische Sichtbarkeit Indexierung und Suchleistung werden getrennt bewertet; eine indexierte Seite muss nicht automatisch gut ranken.

Für kleine Websites reicht oft eine monatliche oder anlassbezogene Kontrolle, etwa nach einem Relaunch. Größere Websites mit häufigen Veröffentlichungen sollten technische Warnungen, Sitemap-Änderungen und wichtige URL-Gruppen enger überwachen. Der passende Rhythmus richtet sich nach Änderungsfrequenz und Risiko.

FAQ

Wie kann ich schnell prüfen, ob eine einzelne Seite indexiert ist?

Geben Sie die vollständige URL in die URL-Prüfung der Google Search Console ein. Als ergänzenden Plausibilitätscheck können Sie nach der exakten URL oder mit dem Operator site: suchen. Die Search Console liefert für die eigene bestätigte Website in der Regel die aussagekräftigere technische Einordnung.

Ist eine Website mit einer Suche nach „site:Domain“ vollständig geprüft?

Nein. Der Suchoperator zeigt keine garantiert vollständige Liste und kann eine ungenaue oder schwankende Anzahl anzeigen. Er eignet sich für einen schnellen Überblick, sollte aber mit Search-Console-Berichten, einer Sitemap und einer technischen URL-Analyse kombiniert werden.

Warum wird eine Seite trotz XML-Sitemap nicht indexiert?

Eine Sitemap macht eine URL bekannt, erzwingt aber keine Indexierung. Gründe können unter anderem eine Noindex-Anweisung, ein falsches Canonical, sehr ähnlicher Inhalt, fehlende interne Verlinkung, technische Fehler oder ein noch nicht abgeschlossener Verarbeitungsprozess sein.

Wie lange dauert es, bis eine Änderung berücksichtigt wird?

Das lässt sich nicht pauschal vorhersagen. Es hängt unter anderem von der Website, der URL, der Änderungsfrequenz und der technischen Situation ab. Nach einer Korrektur sollten Sie die Seite erneut prüfen, aber nicht aus einer kurzen Verzögerung sofort auf einen dauerhaften Fehler schließen.

Sollten alle Seiten einer Website indexiert werden?

Nein. Funktionale Seiten, interne Suchergebnisse, bestimmte Filtervarianten oder private Bereiche haben oft keinen eigenständigen Nutzen für Suchende. Entscheidend ist, dass die für Nutzer und Suchmaschinen relevanten Seiten gezielt indexierbar sind und unnötige Varianten nicht die Website-Struktur verwässern.

Was ist der Unterschied zwischen Crawling und Indexierung?

Crawling bezeichnet den Abruf und die Verarbeitung einer URL durch einen Suchmaschinenbot. Indexierung ist die anschließende Entscheidung, ob und wie diese Seite im Suchindex gespeichert wird. Eine gecrawlte Seite kann deshalb trotzdem nicht indexiert sein.

Kann eine indexierte Seite trotzdem unsichtbar wirken?

Ja. Indexierung bedeutet nur, dass eine Seite grundsätzlich im Index vorhanden sein kann. Sie kann für ein bestimmtes Keyword eine sehr niedrige Position haben, eine andere Suchintention bedienen oder in einer personalisierten beziehungsweise lokal unterschiedlichen Suche nicht prominent erscheinen. Für die Bewertung müssen Indexierung, Suchintention und Ranking getrennt betrachtet werden.

Fazit: Indexierung systematisch statt zufällig prüfen

Wer die Indexierung einer Website überprüfen möchte, sollte mehrere Ebenen verbinden: gewünschte Zielseiten, Search-Console-Daten, technische Signale, XML-Sitemap, interne Verlinkung und die Qualität der Inhalte. Eine einzelne Suchabfrage oder ein einzelner Status reicht selten für eine verlässliche Diagnose.

Am effizientesten ist ein priorisiertes Vorgehen. Definieren Sie zunächst, welche URLs sichtbar sein sollen, prüfen Sie danach deren technische Erreichbarkeit und untersuchen Sie erst anschließend größere URL-Mengen. So unterscheiden Sie bewusste Ausschlüsse von echten Fehlern und investieren Ihre Zeit dort, wo die Website und ihre Nutzer am meisten profitieren.

Suchmaschinen-Crawling verbessern: Ein praxisnaher Leitfaden für Websites

Wenn Suchmaschinen eine Website regelmäßig und vollständig crawlen können, werden neue und überarbeitete Inhalte schneller entdeckt und in den Suchindex aufgenommen. Crawling allein garantiert zwar keine guten Rankings, ist aber eine wichtige technische Grundlage für organische Sichtbarkeit. Dieser Ratgeber zeigt, wie Sie das Suchmaschinen-Crawling verbessern, typische Hindernisse erkennen und technische Maßnahmen sinnvoll priorisieren.

Im Mittelpunkt stehen keine kurzfristigen Tricks, sondern eine saubere Website-Struktur, eindeutig erreichbare Inhalte und verlässliche technische Signale. Die Empfehlungen eignen sich für kleinere Websites ebenso wie für umfangreichere Projekte mit vielen Unterseiten.

Was bedeutet Suchmaschinen-Crawling?

Beim Crawling rufen Suchmaschinen automatisiert Webseiten auf. Dafür folgen ihre Crawler, häufig auch Bots oder Suchroboter genannt, Links, lesen technische Hinweise und prüfen Inhalte. Die gefundenen Seiten können anschließend verarbeitet und – sofern sie die jeweiligen Voraussetzungen erfüllen – in den Suchindex aufgenommen werden.

Crawling und Indexierung sind nicht dasselbe. Eine Suchmaschine kann eine URL kennen und aufrufen, ohne sie in den Index aufzunehmen. Umgekehrt kann eine wichtige Seite schwer auffindbar sein, wenn sie intern schlecht verlinkt ist oder technische Barrieren bestehen. Wer das Suchmaschinen-Crawling verbessern möchte, sollte deshalb die gesamte Kette betrachten:

  • Entdeckung: Kann der Crawler die URL über Links oder eine XML-Sitemap finden?
  • Zugriff: Darf der Crawler die URL abrufen und erhält er eine verwertbare Antwort?
  • Verarbeitung: Sind Inhalt, Canonical-Signal und technische Auszeichnung eindeutig?
  • Priorisierung: Ist erkennbar, welche Seiten wichtig und aktuell sind?

Ein Crawling-Problem zeigt sich daher nicht immer als vollständiger Ausschluss. Auch unnötig häufige Aufrufe von unwichtigen URLs können Aufmerksamkeit und Ressourcen von relevanten Seiten abziehen.

Die wichtigsten Grundlagen für besseres Crawling

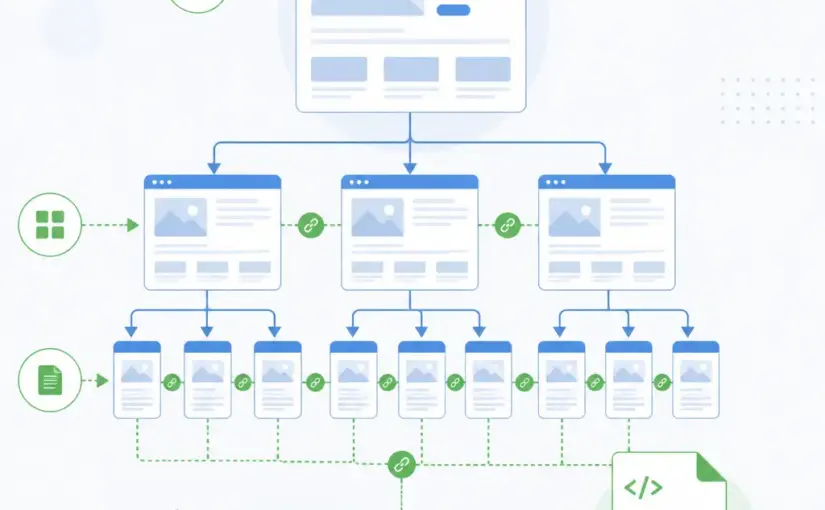
u00dcbersichtliche Website-Struktur mit Kategorien, Inhaltsseiten und internen Verbindungen
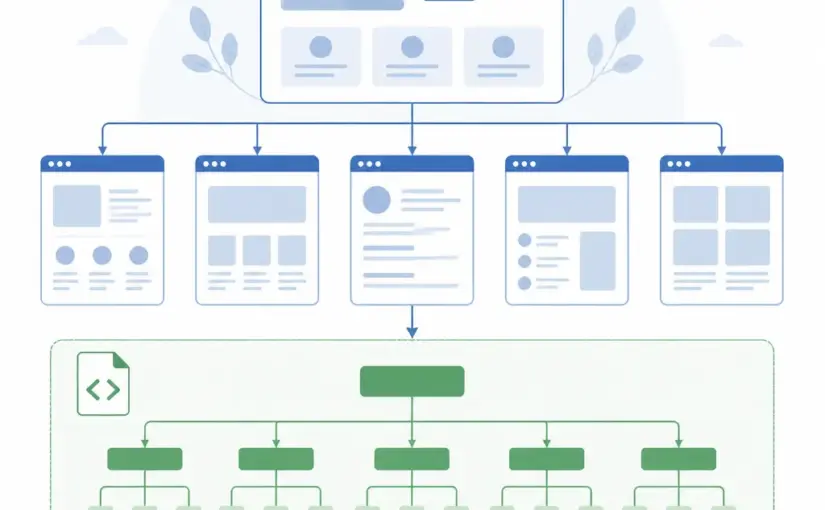
Eine klare Website-Struktur erleichtert die Auffindbarkeit wichtiger Inhalte.

Die Grafik zeigt, wie Startseite, Übersichtsseiten und Inhalte sinnvoll miteinander verbunden werden können. Achten Sie besonders darauf, dass wichtige Seiten nicht als isolierte Endpunkte erscheinen.

Eine logisch aufgebaute Website-Struktur schaffen

Eine klare Informationsarchitektur erleichtert Menschen und Suchmaschinen die Orientierung. Ordnen Sie Inhalte nach nachvollziehbaren Themen und sorgen Sie dafür, dass wichtige Seiten mit wenigen sinnvollen Klicks erreichbar sind. Die genaue Klicktiefe ist kein alleiniger Qualitätsmaßstab, aber sehr verschachtelte Strukturen erschweren die Pflege und die Entdeckung von Inhalten.

Jede zentrale Seite sollte mindestens einen thematisch passenden internen Link von einer anderen erreichbaren Seite erhalten. Vermeiden Sie Strukturen, in denen wichtige Inhalte ausschließlich über eine interne Suche, Filter oder JavaScript-Interaktionen erreichbar sind. Ein sichtbarer HTML-Link mit einer verständlichen Zieladresse ist in der Regel die robusteste Grundlage.

Interne Links gezielt einsetzen

Interne Verlinkung verbindet Inhalte und hilft dabei, ihre Bedeutung innerhalb der Website einzuordnen. Verlinken Sie beispielsweise einen ausführlichen Leitfaden aus passenden Ratgeberartikeln, Kategorien und relevanten Übersichtsseiten. Der Linktext sollte kurz beschreiben, was auf der Zielseite zu erwarten ist.

Prüfen Sie regelmäßig, ob Links auf Fehlerseiten, Weiterleitungsketten oder veraltete URLs führen. Ein Linknetz mit vielen defekten Verbindungen erschwert die Navigation und kann dazu führen, dass wichtige Inhalte weniger zuverlässig entdeckt werden.

XML-Sitemap aktuell halten

Eine XML-Sitemap kann Suchmaschinen eine zusätzliche Übersicht über wichtige URLs geben. Sie ersetzt keine interne Verlinkung, ist aber besonders bei größeren Websites, häufigen Änderungen oder neuen Projekten hilfreich.

In die Sitemap gehören grundsätzlich nur URLs, die tatsächlich indexierbar sein sollen. Entfernen Sie nach Möglichkeit Seiten mit einem dauerhaften Ausschluss, nicht kanonische Varianten, Weiterleitungen und offensichtliche Fehler-URLs. Achten Sie außerdem auf gültige absolute URLs, einen erreichbaren Sitemap-Pfad und eine Aktualisierung nach relevanten Änderungen.

Die Sitemap sollte nicht als vollständiges Archiv jeder jemals erzeugten URL verstanden werden. Ihre Aufgabe ist es, Suchmaschinen eine kuratierte Liste wichtiger, gültiger und zugänglicher Seiten zu liefern.

Robots.txt, Meta-Robots und Zugriffssignale richtig verwenden

Die Datei robots.txt kann Crawlern mitteilen, welche Bereiche sie nicht abrufen sollen. Sie ist jedoch kein zuverlässiger Schutz für vertrauliche Inhalte. Nicht öffentlich bestimmte Informationen gehören hinter eine geeignete Zugriffskontrolle und sollten nicht allein durch robots.txt verborgen werden.

Ein zu großzügiger Ausschluss kann das Crawling erheblich behindern. Prüfen Sie deshalb jede Disallow-Regel darauf, ob sie wirklich notwendig ist. Besonders riskant sind pauschale Regeln für Verzeichnisse, in denen sich neben unwichtigen Parametervarianten auch redaktionell relevante Inhalte befinden.

Ein wichtiger Unterschied: Ein Crawling-Ausschluss in robots.txt verhindert in erster Linie den Abruf. Ein noindex-Signal wird dagegen erst ausgewertet, wenn die betreffende Seite abgerufen werden kann. Wer eine Seite gezielt aus dem Index entfernen möchte, sollte die passende Methode im jeweiligen technischen Umfeld sorgfältig prüfen und nicht mehrere widersprüchliche Signale ohne Plan kombinieren.

Typische Fehler bei robots.txt

  • Die gesamte Website wird versehentlich mit einer allgemeinen Regel blockiert.
  • CSS- oder JavaScript-Ressourcen werden gesperrt, obwohl sie für die Darstellung oder Verarbeitung relevant sind.
  • Eine alte Testregel bleibt nach dem Relaunch bestehen.
  • Parameter werden pauschal blockiert, obwohl dadurch wichtige Zielseiten nicht mehr erreichbar sind.
  • Die Sitemap wird mit einer falschen oder nicht erreichbaren Adresse angegeben.

Nach Änderungen sollten Sie die Datei aus Sicht verschiedener URL-Typen prüfen: Startseite, wichtige Inhaltsseite, Kategorie, Medien- oder Produktseite sowie eine bewusst auszuschließende URL.

URL-Struktur, Statuscodes und Weiterleitungen prüfen

Eine verständliche URL-Struktur hilft bei der Verwaltung und reduziert unnötige Varianten. Vermeiden Sie, wenn möglich, mehrere URLs für denselben Inhalt, unkontrolliert erzeugte Parameter und dauerhaft wechselnde Pfade. URLs sollten stabil bleiben und den Inhalt nicht durch übermäßig viele technische Kennungen verschleiern.

Der HTTP-Statuscode liefert dem Crawler einen wichtigen Hinweis:

  • 200: Die Ressource wurde erfolgreich ausgeliefert.
  • 3xx: Die Anfrage wird weitergeleitet oder benötigt eine weitere Verarbeitung.
  • 4xx: Die angeforderte Ressource ist aus Sicht des Servers nicht verfügbar.
  • 5xx: Der Server konnte die Anfrage nicht erfolgreich verarbeiten.

Einzelne Fehler sind auf jeder größeren Website möglich. Problematisch wird es, wenn interne Links regelmäßig auf nicht vorhandene URLs zeigen, Weiterleitungen in Ketten auftreten oder viele relevante Seiten vorübergehend mit Serverfehlern antworten. Korrigieren Sie interne Links möglichst direkt und leiten Sie dauerhaft verschobene Inhalte auf die passendste neue URL weiter.

Beachten Sie auch, dass eine Weiterleitung kein Ersatz für eine konsequente interne Verlinkung ist. Wenn eine Seite dauerhaft umgezogen ist, sollten die wichtigsten Links auf die endgültige Adresse zeigen.

Duplicate Content und URL-Varianten reduzieren

Technische Systeme erzeugen häufig mehrere URLs mit gleichem oder sehr ähnlichem Inhalt. Beispiele sind Filter, Sortierungen, Tracking-Parameter, Druckansichten, Session-Kennungen oder unterschiedliche Schreibweisen. Dadurch kann eine Website unnötig viele crawlbare Adressen erzeugen.

Der erste Schritt ist eine Bestandsaufnahme: Welche URL-Varianten existieren, welche davon werden intern verlinkt und welche sollen überhaupt in den Suchindex gelangen? Danach lassen sich passende Maßnahmen auswählen:

  • Parameter nur dann verwenden, wenn sie einen echten Zweck erfüllen.
  • Für gleichartige Inhalte eine bevorzugte kanonische URL festlegen.
  • Unnötige Varianten vermeiden oder technisch kontrolliert behandeln.
  • Interne Links konsequent auf die gewünschte Hauptversion richten.
  • Bei dauerhaft zusammengeführten Inhalten geeignete Weiterleitungen einsetzen.

Das rel="canonical"-Element ist ein Hinweis auf die bevorzugte Version, aber keine pauschale Garantie für die Auswahl durch eine Suchmaschine. Es sollte nur auf eine inhaltlich passende, erreichbare und indexierbare Ziel-URL verweisen. Ein Canonical auf eine thematisch unpassende Seite kann die technische Klarheit verschlechtern.

JavaScript, Rendering und wichtige Inhalte

Moderne Websites laden Inhalte teilweise nachträglich über JavaScript. Das kann funktionieren, macht die Verarbeitung aber komplexer als eine direkt ausgelieferte HTML-Struktur. Besonders wichtige Informationen sollten deshalb nicht ausschließlich nach einer Interaktion, einem Scrollvorgang oder einem clientseitigen Datenabruf erscheinen.

Prüfen Sie, ob der zentrale Text, interne Links, Überschriften und relevante Metadaten im ausgelieferten Dokument oder nach der vorgesehenen Verarbeitung zuverlässig vorhanden sind. Achten Sie außerdem darauf, dass Links echte, erreichbare Zieladressen besitzen und nicht nur durch Klick-Handler simuliert werden.

Eine gute Praxis ist die schrittweise Prüfung: Zuerst sollte die Seite ohne unnötige Abhängigkeiten eine verständliche Grundstruktur liefern. Danach können dynamische Funktionen die Darstellung und Bedienung erweitern. Bei einem Relaunch empfiehlt sich ein Vergleich wichtiger Seiten vor und nach der technischen Umstellung.

Serverleistung und Crawling-Budget verstehen

Suchmaschinen verfügen nicht über unbegrenzte Kapazitäten für jede Website. Die verfügbare Aufmerksamkeit hängt unter anderem von der Größe, Aktualität, Qualität, Erreichbarkeit und technischen Stabilität eines Projekts ab. Für kleine Websites ist das sogenannte Crawling-Budget oft kein akutes Problem. Bei großen oder stark parameterisierten Websites kann es jedoch wichtig werden.

Die sinnvollste Maßnahme ist nicht, Crawler um jeden Preis zu einer höheren Abruffrequenz zu bewegen. Stattdessen sollte die Website möglichst wenige unnötige URLs erzeugen und wichtige Inhalte zuverlässig ausliefern. Dazu gehören:

  • stabile Serverantworten und möglichst geringe Ausfallzeiten,
  • eine Begrenzung nutzloser Filter- und Parameterkombinationen,
  • eine nachvollziehbare interne Verlinkung,
  • aktuelle Sitemaps ohne Fehler- und Weiterleitungs-URLs,
  • regelmäßige Kontrolle von Serverprotokollen und technischen Reports.

Langsame Ladezeiten sind nicht ausschließlich ein Crawling-Thema. Sie beeinflussen auch die Nutzung und die technische Verarbeitung. Priorisieren Sie daher die Ursachen: überlastete Server, unnötig große Ressourcen, fehlerhafte Caches oder ineffiziente Datenbankabfragen sollten getrennt untersucht werden.

Nach einem Relaunch das Crawling absichern

Ein Relaunch verändert häufig URLs, Navigation, Templates, interne Links und technische Regeln gleichzeitig. Deshalb sollte die Crawling-Prüfung bereits vor der Veröffentlichung beginnen. Erstellen Sie eine Liste der wichtigsten alten URLs und ordnen Sie ihnen – falls erforderlich – passende neue Zieladressen zu.

Direkt nach dem Start sollten Sie mindestens diese Punkte kontrollieren:

  • Ist die Website öffentlich erreichbar und nicht versehentlich blockiert?
  • Funktionieren wichtige alte und neue URLs mit dem vorgesehenen Statuscode?
  • Gibt es Weiterleitungsketten oder massenhaft nicht gefundene Seiten?
  • Enthält die neue Sitemap nur gültige Zieladressen?
  • Sind Canonical- und Meta-Robots-Signale korrekt gesetzt?
  • Führen interne Links nicht mehr auf alte oder falsche Pfade?
  • Sind zentrale Inhalte auch ohne problematische Interaktionen auffindbar?

Die Nachkontrolle sollte nicht auf einen einzigen Tag beschränkt bleiben. Beobachten Sie technische Fehler und auffällige URL-Muster über einen angemessenen Zeitraum, da manche Probleme erst durch das erneute Crawling sichtbar werden.

Werkzeuge für die technische Kontrolle

Für die Analyse stehen verschiedene Werkzeugarten zur Verfügung. Nutzen Sie keine einzelne Quelle als vollständige Wahrheit, sondern vergleichen Sie die Perspektiven:

  • Suchmaschinen-Tools: Sie zeigen häufig erkannte Indexierungs-, Abruf- oder Sitemap-Probleme für die jeweilige Property.
  • Serverprotokolle: Sie dokumentieren, welche URLs tatsächlich von welchen Crawlern angefragt wurden und welche Antworten der Server zurückgab.
  • Crawler für technische Audits: Sie können interne Links, Statuscodes, Canonicals, Weiterleitungen und viele URL-Varianten systematisch erfassen.
  • Browser- und Entwicklerwerkzeuge: Sie helfen bei der Prüfung von Netzwerkaufrufen, gerendertem Inhalt und blockierten Ressourcen.

Bewerten Sie Ergebnisse immer im Kontext. Eine einzelne nicht gecrawlte URL ist weniger aussagekräftig als ein wiederkehrendes Muster aus vielen fehlerhaften Seiten, widersprüchlichen Signalen oder ständig neuen Parameteradressen. Dokumentieren Sie Befunde mit URL, Ursache, Priorität und geplanter Lösung.

Eine sinnvolle Priorisierung der Maßnahmen

Nicht jede technische Auffälligkeit verdient dieselbe Aufmerksamkeit. Beginnen Sie mit Problemen, die viele wichtige URLs betreffen oder den Zugriff grundsätzlich verhindern. Eine praktikable Reihenfolge lautet:

  1. Zugriff sichern: Blockierungen, Serverfehler und falsche Weiterleitungen beheben.
  2. Wichtige URLs eindeutig machen: Canonicals, interne Links und Zieladressen vereinheitlichen.
  3. Unnötige URL-Mengen reduzieren: Parameter, Filter und doppelte Varianten kontrollieren.
  4. Sitemap und Architektur bereinigen: wichtige Inhalte klar auffindbar und korrekt gelistet halten.
  5. Rendering und Leistung verbessern: zentrale Inhalte zuverlässig ausliefern und technische Engpässe reduzieren.
  6. Kontinuierlich überwachen: Änderungen dokumentieren und wiederkehrende Fehler erkennen.

Die Priorität sollte sich nach Auswirkungen, Umfang und Aufwand richten. Eine kleine Korrektur an einer robots.txt kann wichtiger sein als zahlreiche Detailverbesserungen an einzelnen Seiten. Umgekehrt lohnt sich eine aufwendige Bereinigung großer URL-Mengen erst dann, wenn die grundlegenden Zugriffsprobleme gelöst sind.

FAQ

Wie kann ich das Suchmaschinen-Crawling verbessern?

Beginnen Sie mit einer klaren internen Verlinkung, einer aktuellen XML-Sitemap und einer korrekten robots.txt. Prüfen Sie zusätzlich Statuscodes, Weiterleitungen, Canonical-Signale, URL-Varianten und die Erreichbarkeit wichtiger Inhalte. Entscheidend ist eine Kombination dieser Maßnahmen, nicht ein einzelner technischer Schalter.

Wie schnell werden Änderungen gecrawlt?

Das lässt sich nicht allgemein garantieren. Die Geschwindigkeit hängt unter anderem von Websitegröße, Aktualität, technischer Stabilität und der Bedeutung der jeweiligen URL ab. Nach wichtigen Änderungen sollten Sie die technische Erreichbarkeit sofort kontrollieren und die weitere Entwicklung anhand geeigneter Berichte beobachten.

Ist eine XML-Sitemap für jede Website notwendig?

Eine kleine, gut intern verlinkte Website kann auch ohne Sitemap auffindbar sein. Eine XML-Sitemap ist dennoch oft eine hilfreiche zusätzliche Orientierung, insbesondere bei vielen URLs, neuen Websites, häufigen Änderungen oder schwer überschaubaren Strukturen. Sie sollte gepflegt sein und keine beliebigen URL-Varianten enthalten.

Blockiert robots.txt eine Seite dauerhaft aus dem Index?

Robots.txt steuert in erster Linie, ob ein Crawler eine Ressource abrufen darf. Das ist nicht dasselbe wie ein garantiertes Entfernen aus dem Index. Für Ausschlüsse sollten Sie die gewünschte Wirkung, die Erreichbarkeit der Seite und vorhandene Meta- oder HTTP-Signale gemeinsam prüfen.

Was ist wichtiger: Sitemap oder interne Links?

Beides erfüllt unterschiedliche Aufgaben. Interne Links verbinden Inhalte innerhalb der Website und unterstützen ihre Auffindbarkeit und Einordnung. Die Sitemap bietet eine zusätzliche URL-Übersicht. Eine Sitemap sollte daher keine schwache interne Struktur kaschieren.

Kann JavaScript das Crawling verschlechtern?

JavaScript ist nicht automatisch ein Problem. Schwierigkeiten entstehen, wenn wichtige Inhalte, Links oder technische Signale nur unzuverlässig nachgeladen werden. Prüfen Sie deshalb, ob die zentrale Seitenstruktur auch bei der vorgesehenen Verarbeitung vollständig und verständlich verfügbar ist.

Wie erkenne ich unnötige Crawl-Varianten?

Achten Sie in Serverprotokollen, technischen Crawls und Suchmaschinenberichten auf wiederkehrende Parameter, Filterkombinationen, Session-IDs, Druckversionen oder verschiedene Schreibweisen derselben Inhalte. Vergleichen Sie diese Adressen mit Ihren internen Links und entscheiden Sie für jede Gruppe, ob sie indexierbar sein soll.

Fazit: Suchmaschinen-Crawling nachhaltig verbessern

Wer das Suchmaschinen-Crawling verbessern möchte, sollte zuerst die technische Grundlage ordnen: wichtige Inhalte müssen erreichbar, sinnvoll verlinkt, eindeutig adressiert und zuverlässig ausgeliefert werden. Eine aktuelle Sitemap, sorgfältig eingesetzte Zugriffssignale und kontrollierte URL-Varianten unterstützen diesen Prozess.

Besonders nachhaltig ist ein regelmäßiger Prüfablauf. Kontrollieren Sie nach Relaunches und größeren Änderungen die wichtigsten URLs, beobachten Sie Server- und Suchmaschinenberichte und dokumentieren Sie wiederkehrende Fehler. So wird Crawling nicht zu einer einmaligen Reparatur, sondern zu einem festen Bestandteil der Website-Qualität.

Häufige Fehler in der robots.txt: Anleitung zur Prüfung und Behebung

Die Datei robots.txt wirkt unscheinbar, kann aber maßgeblich beeinflussen, welche Bereiche einer Website Suchmaschinen-Crawler erreichen. Ein einzelner zu weit gefasster Pfad, ein falsch gesetztes Zeichen oder eine veraltete Regel kann dazu führen, dass wichtige Inhalte seltener gecrawlt werden oder gar nicht erst in den Suchindex gelangen. Gleichzeitig wird die robots.txt häufig überschätzt: Sie ist kein sicherer Zugriffsschutz und ersetzt weder Authentifizierung noch technische Sicherheitsmaßnahmen.

Dieser Ratgeber zeigt die häufigsten Fehler in der robots.txt, erklärt ihre Auswirkungen und bietet eine systematische Vorgehensweise zur Prüfung. Dabei geht es nicht nur um einzelne Direktiven, sondern auch um den Zusammenhang mit internen Links, XML-Sitemaps, Meta-Robots-Anweisungen, Weiterleitungen und der tatsächlichen Website-Struktur.

Was die robots.txt tatsächlich steuert

Die robots.txt liegt normalerweise im Hauptverzeichnis einer Domain, zum Beispiel unter https://www.beispiel.de/robots.txt. Crawler rufen diese Datei ab, bevor sie URLs derselben Website crawlen. Darin können Regeln stehen, die bestimmten User-Agents den Zugriff auf bestimmte Pfade erlauben oder untersagen.

Wichtig ist die Unterscheidung zwischen Crawling und Indexierung. Eine Disallow-Regel sagt im Kern: Der betreffende Crawler soll den angegebenen Pfad nicht abrufen. Sie garantiert jedoch nicht, dass eine URL niemals im Index auftaucht. Wenn eine blockierte URL von anderen Seiten verlinkt wird, kann eine Suchmaschine ihre Existenz unter Umständen trotzdem erkennen und die URL ohne ausgelesenen Inhalt anzeigen.

Die robots.txt ist deshalb vor allem ein Werkzeug zur Steuerung des Crawlings. Für den Schutz vertraulicher Inhalte sind beispielsweise Zugriffsbeschränkungen, Serverberechtigungen oder eine geeignete Authentifizierung erforderlich. Für die Steuerung der Indexierung kommen unter anderem Meta-Robots-Anweisungen oder HTTP-Header wie X-Robots-Tag infrage, sofern der Crawler die betreffende Ressource abrufen darf.

Die häufigsten Fehler in der robots.txt

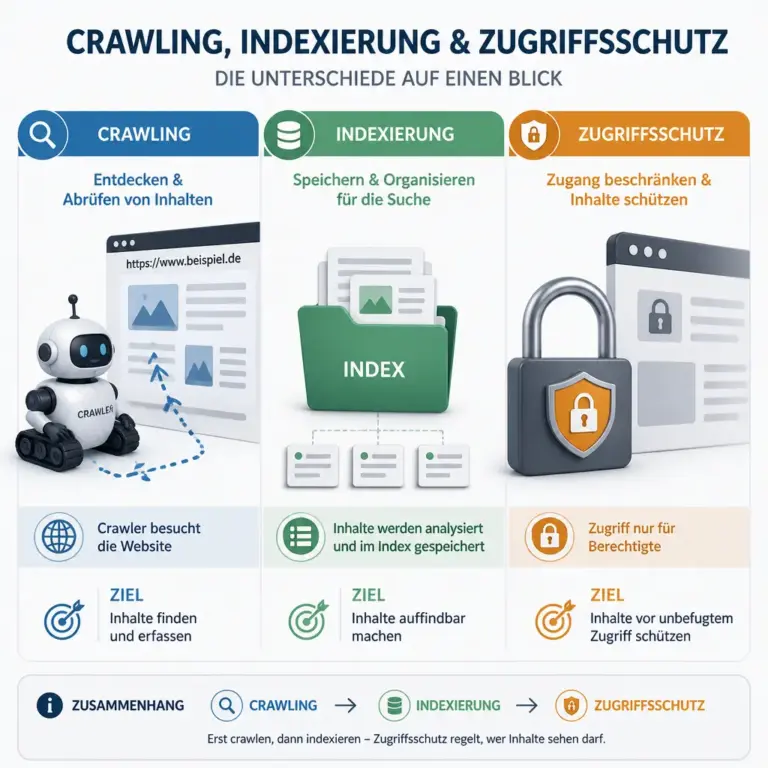
Infografik zum Unterschied zwischen Crawling, Indexierung und Zugriffsschutz
Die robots.txt steuert vor allem das Crawling und ersetzt keinen Zugriffsschutz.

Die Grafik sollte zeigen, dass eine robots.txt den Abruf bestimmter Pfade beeinflusst, aber keine vertraulichen Inhalte schützt. Der getrennte Bereich für Indexierung macht sichtbar, warum Disallow und Noindex nicht dasselbe sind.

Die gesamte Website versehentlich blockieren

Der folgenreichste Fehler ist eine Regel, die nahezu alle URLs blockiert:

User-agent: *
Disallow: /

Diese Kombination kann in einer Entwicklungsumgebung sinnvoll sein, wenn eine nicht öffentliche Website nicht von Suchmaschinen gecrawlt werden soll. Auf einer produktiven Website verhindert sie jedoch das Crawling praktisch aller Pfade. Besonders kritisch ist, wenn die Regel beim Umzug, bei einem Relaunch oder durch die Übernahme einer Staging-Konfiguration aktiv bleibt.

Prüfen Sie daher nach jedem Relaunch, jeder Migration und jedem Wechsel des Hosting-Systems, ob die Datei noch zur Produktionsumgebung passt. Die Website sollte außerdem über eine eindeutige Umgebungskontrolle verfügen: Eine Regel, die auf einer Testdomain sinnvoll ist, darf nicht ungeprüft auf der Live-Domain eingesetzt werden.

Wichtige Verzeichnisse zu weit sperren

Ein Pfad kann harmlos wirken, obwohl darunter wichtige Inhalte liegen. Beispiele sind pauschale Sperren für /wp-content/, /assets/, /media/ oder /static/. Werden dort Bilder, Stylesheets, JavaScript-Dateien oder eingebundene Inhalte gespeichert, kann ein Crawler die Darstellung und den funktionalen Aufbau einer Seite möglicherweise nicht vollständig beurteilen.

Früher wurden technische Ressourcen oft pauschal blockiert, um Crawl-Budget zu sparen. In vielen Fällen ist das jedoch kontraproduktiv. Suchmaschinen müssen eine Seite in ihrer ausgelieferten Form verstehen können. Statt ganze Verzeichnisse zu sperren, sollte geprüft werden, ob tatsächlich problematische URL-Muster existieren und ob diese auf andere Weise bereinigt werden können.

Besonders sorgfältig sollten Sie Regeln behandeln, die ein übergeordnetes Verzeichnis betreffen. Eine Sperre für /shop/ erfasst in der Regel auch /shop/produkte/, /shop/kategorien/ und weitere Unterpfade. Die gewünschte Wirkung sollte deshalb immer anhand konkreter Beispiel-URLs kontrolliert werden.

Fehlerhafte Schreibweise von User-agent und Direktiven

Die Grundstruktur einer Regel besteht aus einem User-Agent-Block und einer oder mehreren Direktiven:

User-agent: *
Disallow: /intern/

Typische Schreibfehler sind fehlende Doppelpunkte, vertauschte Feldnamen, zusätzliche Sonderzeichen oder eine unklare Mischung aus mehreren Blöcken. Die Namen der Direktiven sollten korrekt geschrieben werden, insbesondere User-agent, Disallow und Allow. Unbekannte oder nicht unterstützte Anweisungen werden nicht automatisch so interpretiert, wie der Verfasser es beabsichtigt hat.

Auch Kommentare sollten sauber mit einem # beginnen. Ein Kommentar kann bei der Pflege helfen, darf aber nicht versehentlich einen Teil einer wirksamen Regel ausblenden. Für eine verständliche Datei sind kurze, sachliche Kommentare sinnvoll, etwa zur Kennzeichnung einer temporären Ausnahme oder eines bewusst gesperrten Suchparameters.

Allow und Disallow falsch miteinander kombinieren

Mit Allow können Ausnahmen innerhalb eines gesperrten Bereichs formuliert werden, sofern der jeweilige Crawler diese Direktive unterstützt und die Regeln nach seinen Prioritätsregeln auswertet. Ein Beispiel ist:

User-agent: *
Disallow: /bereich/
Allow: /bereich/oeffentlich/

Solche Ausnahmen sind fehleranfällig, wenn mehrere Regeln ähnliche Pfade betreffen. Entscheidend ist nicht nur die Reihenfolge der Zeilen. Je nach Auswertung spielen unter anderem die konkretere Übereinstimmung und die unterstützte Syntax eine Rolle. Verlassen Sie sich daher nicht auf ein Bauchgefühl, sondern prüfen Sie konkrete URLs mit einem geeigneten Validator oder einer dokumentierten Testmethode.

Oft ist eine einfachere Struktur besser: Wenn nur wenige private Verzeichnisse nicht gecrawlt werden sollen, können diese direkt genannt werden. Eine lange Kette aus verschachtelten Ausnahmen erschwert die spätere Wartung und erhöht die Gefahr widersprüchlicher Regeln.

Wildcards unpräzise oder zu großzügig verwenden

Wildcards können wiederkehrende Muster erfassen, etwa URLs mit bestimmten Parametern. Eine zu breite Regel kann jedoch weit mehr blockieren als beabsichtigt. Ein Muster wie Disallow: /*? zielt beispielsweise auf URLs mit einem Fragezeichen. Je nach Website können darunter aber auch nützliche, indexierbare URLs liegen, die nicht bloß Sortierungen oder Tracking-Parameter enthalten.

Vor jeder Wildcard-Regel sollten Sie eine Liste realer URLs betrachten. Welche Parameter erzeugen Duplikate? Welche verändern den eigentlichen Seiteninhalt? Welche werden intern verlinkt? Eine pauschale Sperre ist nicht automatisch die beste Lösung, denn sie kann auch das Crawling wertvoller Varianten unterbinden. Häufig sind eine saubere interne Verlinkung, kanonische Angaben und eine konsistente URL-Logik langfristig robuster.

Slash, Groß- und Kleinschreibung sowie Pfadgrenzen übersehen

Pfadangaben müssen zur tatsächlichen URL-Struktur passen. /admin und /administrator sind unterschiedliche Pfade. Ebenso kann /shop je nach Regelwerk nicht dieselbe Bedeutung haben wie /shop/. Eine Regel, die einen Pfad ohne abschließenden Schrägstrich erfasst, sollte deshalb auf ihre Wirkung bei ähnlichen Pfaden geprüft werden.

Auch die Schreibweise kann relevant sein. Wenn der Server zwischen Groß- und Kleinschreibung unterscheidet, sind /Download/ und /download/ nicht zwingend identisch. Verwenden Sie exakt die Pfade, die auf der Website ausgeliefert werden, und prüfen Sie Varianten, Weiterleitungen sowie mögliche alternative URL-Schreibweisen.

Die Sitemap falsch oder veraltet angeben

Ein häufiger Fehler ist eine Sitemap-Adresse, die nicht erreichbar ist, auf eine andere Domain zeigt oder nur für eine frühere Website-Version gilt. Eine Sitemap kann am Ende der robots.txt genannt werden:

Sitemap: https://www.beispiel.de/sitemap.xml

Die absolute URL sollte zur tatsächlichen Domain und zum verwendeten Protokoll passen. Bei einer Website mit mehreren Sprachversionen, Subdomains oder getrennten Sitemaps müssen die Einträge bewusst verwaltet werden. Eine robots.txt auf shop.beispiel.de sollte nicht automatisch auf eine Sitemap einer völlig anderen Host-Adresse verweisen, wenn diese nicht die relevanten URLs enthält.

Die Sitemap ersetzt keine gute interne Verlinkung und hebt eine Disallow-Regel nicht auf. Wenn eine URL in der Sitemap steht und gleichzeitig durch die robots.txt blockiert wird, entsteht ein widersprüchliches Signal. Die Sitemap sollte daher nur URLs enthalten, die erreichbar, technisch gültig und für die Indexierung grundsätzlich vorgesehen sind.

Vertrauliche Inhalte nur durch robots.txt schützen

Eine robots.txt ist öffentlich erreichbar. Jeder kann ihre Inhalte abrufen und daraus ableiten, welche Pfade der Betreiber möglicherweise verborgen halten möchte. Außerdem sind Crawler nicht verpflichtet, freiwillige Regeln einzuhalten. Schadsoftware, aggressive Bots oder neugierige Personen können die Datei ignorieren.

Bereiche mit persönlichen Daten, internen Dokumenten, Administrationsfunktionen oder nicht veröffentlichten Projekten gehören deshalb hinter eine Zugriffskontrolle. Entfernen Sie vertrauliche Dateien vom öffentlich erreichbaren Server oder schützen Sie sie mit geeigneten technischen Maßnahmen. Eine Disallow-Regel kann zusätzlich die Crawl-Steuerung verbessern, ist aber keine Sicherheitsbarriere.

Typische Probleme bei WordPress-Websites

Bei WordPress entsteht die robots.txt häufig dynamisch, sofern keine eigene Datei im Webroot angelegt wurde. Zusätzlich können SEO-Plugins oder Hosting-Konfigurationen Regeln beeinflussen. Dadurch ist nicht immer auf den ersten Blick erkennbar, welche Version tatsächlich ausgeliefert wird.

Prüfen Sie zunächst die öffentlich erreichbare Adresse und vergleichen Sie sie mit den Einstellungen in WordPress sowie im verwendeten Plugin. Nach einem Plugin-Wechsel oder einer Änderung der Lesbarkeitseinstellungen kann sich die Ausgabe verändern. Auch Cache-Systeme und Content-Delivery-Netzwerke können eine ältere Version ausliefern. Änderungen sollten daher nach der Veröffentlichung erneut direkt im Browser und möglichst aus verschiedenen Netzwerkperspektiven kontrolliert werden.

Ein weiterer Fehler ist, die robots.txt als Ersatz für die WordPress-Einstellung zur Sichtbarkeit in Suchmaschinen zu betrachten. Diese Einstellung kann zusätzliche technische Signale auslösen, die nicht mit einer einzelnen Zeile in der robots.txt identisch sind. Bei einem Relaunch sollten deshalb die WordPress-Konfiguration, die robots.txt, Meta-Robots-Anweisungen, Canonical-URLs und die XML-Sitemap gemeinsam geprüft werden.

So prüfen Sie eine robots.txt systematisch

1. Die tatsächlich ausgelieferte Datei abrufen

Beginnen Sie mit der URL der produktiven Domain und rufen Sie die Datei direkt auf. Prüfen Sie dabei auch Varianten mit und ohne www, falls beide Hostnamen erreichbar sind. Eine Weiterleitung kann technisch funktionieren, sollte aber bewusst eingerichtet und zur bevorzugten Domain passend sein.

Achten Sie auf Statuscode, Inhalt, Zeichencodierung und ungewöhnliche Fehlermeldungen. Eine HTML-Fehlerseite anstelle einer Textdatei, ein Serverfehler oder eine unerwartete Weiterleitung sind wichtige Hinweise. Die Datei sollte nicht nur im lokalen Editor korrekt aussehen, sondern auch genau so vom Server ausgeliefert werden.

2. Die wichtigsten URL-Gruppen sammeln

Erstellen Sie eine kleine Prüfliste mit repräsentativen URLs: Startseite, wichtige Kategorie- und Produktseiten, redaktionelle Inhalte, Bilder, CSS- und JavaScript-Ressourcen, Suchergebnisse, Filterseiten, Login-Bereiche und bekannte technische Pfade. Nehmen Sie sowohl URLs auf, die erreichbar sein sollen, als auch solche, die bewusst nicht gecrawlt werden sollen.

Diese Auswahl macht sichtbar, ob eine Regel zu breit oder zu schmal greift. Eine robots.txt sollte nicht abstrakt, sondern anhand konkreter URL-Beispiele bewertet werden. Bei großen Websites können Server-Logs, Crawling-Daten und URL-Listen aus dem CMS die Auswahl unterstützen.

3. Regeln mit Suchmaschinen-Tools und Validatoren vergleichen

Nutzen Sie ein aktuelles Prüfwerkzeug, das die robots.txt-Syntax und die Wirkung auf konkrete URLs nachvollziehbar darstellt. Ein Tool ersetzt jedoch nicht die fachliche Prüfung: Nicht jede Suchmaschine unterstützt jede Erweiterung gleich, und ein Tester bildet möglicherweise nur einen bestimmten User-Agent ab.

Vergleichen Sie die Ergebnisse mit den realen Anforderungen der Website. Wenn ein Tool eine URL als erlaubt meldet, bedeutet das nicht automatisch, dass die Seite indexiert wird. Umgekehrt kann eine blockierte URL weiterhin über externe Links bekannt werden. Für eine belastbare Diagnose müssen Crawling, Indexierung und Zugriffsschutz getrennt betrachtet werden.

4. Googlebot, allgemeine Crawler und Sonderfälle auseinanderhalten

Ein Block für User-agent: * richtet sich grundsätzlich an Crawler, die diesen allgemeinen Block berücksichtigen. Ein zusätzlicher spezifischer Block kann für einen bestimmten Crawler gelten. Dadurch entstehen leicht Missverständnisse, wenn eine Regel für einen User-Agent getestet wird, aber ein anderer Crawler sie anders auswertet.

Definieren Sie spezifische Blöcke nur, wenn es dafür einen klaren Grund gibt. Je mehr Ausnahmen und Agenten enthalten sind, desto schwieriger wird die Datei. Dokumentieren Sie die Absicht hinter Sonderregeln und entfernen Sie sie, sobald der ursprüngliche Anwendungsfall nicht mehr besteht.

5. Nach der Änderung erneut kontrollieren

Speichern Sie die Datei in einer kontrollierten Änderung und prüfen Sie anschließend erneut die Live-Version. Kontrollieren Sie nicht nur die geänderte URL, sondern auch wichtige Nachbarpfade. Eine Änderung an /shop/ kann beispielsweise viele Unterbereiche betreffen.

Beobachten Sie danach die Server-Logs und die Berichte der verfügbaren Suchmaschinen-Werkzeuge. Änderungen an Crawling-Signalen wirken nicht immer sofort. Ein kurzfristig unveränderter Bericht beweist daher weder, dass die Änderung wirkungslos ist, noch dass sie vollständig verarbeitet wurde.

Praktische Entscheidungskriterien für Regeln

Vor einer neuen Disallow-Regel sollten Sie fünf Fragen beantworten:

  • Welches konkrete Problem soll gelöst werden? Geht es um Serverlast, URL-Parameter, doppelte Inhalte, interne Suchseiten oder einen nicht öffentlichen Bereich?
  • Welche exakten URLs sind betroffen? Beschreiben Sie einige erlaubte und gesperrte Beispiele, statt nur ein allgemeines Verzeichnis zu nennen.
  • Ist Crawling-Sperrung wirklich das richtige Mittel? Für vertrauliche Inhalte, Indexierungssteuerung oder technische Fehler können andere Maßnahmen passender sein.
  • Welche Nebenwirkungen entstehen? Prüfen Sie Ressourcen, Unterverzeichnisse, Sprachversionen, Weiterleitungen und Links aus Sitemaps.
  • Wer pflegt die Regel später? Eine verständliche, kurze Datei mit dokumentierter Absicht ist sicherer als ein kaum nachvollziehbares Geflecht aus Ausnahmen.

Ein gutes Ergebnis ist nicht die längste oder technisch ausgefeilteste robots.txt, sondern eine Datei, deren Regeln eine klar erkennbare Aufgabe erfüllen. Wenn keine belastbare Begründung für eine Sperre existiert, sollte sie nicht allein aus Gewohnheit übernommen werden.

FAQ

Kann eine fehlerhafte robots.txt das Ranking direkt verschlechtern?

Eine falsche Sperre kann verhindern, dass wichtige Inhalte oder benötigte Ressourcen gecrawlt werden. Dadurch können Suchmaschinen Seiten schlechter verstehen oder neue Inhalte später entdecken. Die robots.txt verändert jedoch nicht als direkte Bewertungszahl die Qualität einer Seite. Die konkrete Auswirkung hängt davon ab, welche URLs betroffen sind und welche anderen Signale vorliegen.

Ist Disallow dasselbe wie Noindex?

Nein. Disallow steuert das Crawling und verhindert den Abruf eines Pfads für den jeweiligen Crawler. Noindex ist ein Signal zur Indexierung und kann nur zuverlässig verarbeitet werden, wenn die Seite oder Ressource abgerufen werden darf. Wer eine URL aus dem Index entfernen möchte, sollte daher nicht ausschließlich auf eine robots.txt-Sperre setzen.

Warum sollte ich CSS- und JavaScript-Dateien nicht pauschal sperren?

Diese Ressourcen können für die Darstellung und das Verständnis einer Seite relevant sein. Wenn ein Crawler sie nicht laden darf, kann seine Einschätzung der ausgelieferten Seite unvollständig sein. Sperren Sie technische Dateien nur dann, wenn ein konkreter Grund besteht, und prüfen Sie vorher, ob sie für wichtige Seiten benötigt werden.

Kann die robots.txt geheime Verzeichnisse verstecken?

Nein. Die Datei ist öffentlich und freiwillige Regeln können ignoriert werden. Außerdem macht eine Disallow-Regel einen Pfad nicht unsichtbar, wenn er beispielsweise verlinkt wird. Vertrauliche Bereiche benötigen Zugriffsschutz oder dürfen gar nicht öffentlich ausgeliefert werden.

Wie oft sollte die robots.txt geprüft werden?

Eine feste allgemeine Frist ist weniger wichtig als anlassbezogene Kontrollen. Prüfen Sie die Datei bei Relaunches, Domainwechseln, Änderungen an CMS oder SEO-Plugins, neuen Verzeichnisstrukturen und größeren Änderungen an Sitemaps. Zusätzlich kann eine regelmäßige technische Überwachung sinnvoll sein, damit unerwartete Änderungen schnell auffallen.

Ist eine leere robots.txt problematisch?

Eine leere Datei enthält keine Sperrregeln und lässt Crawler grundsätzlich auf die erreichbaren Pfade zugreifen. Das ist nicht automatisch falsch. Ob die Konfiguration sinnvoll ist, hängt von der Website ab. Auch bei einer leeren Datei bleiben andere Themen wie Indexierungsregeln, URL-Parameter, interne Suchseiten und Zugriffsschutz relevant.

Was bedeutet ein Sternchen bei User-agent oder Wildcards?

Bei User-agent: * steht das Sternchen für einen allgemeinen User-Agent-Block. In Pfadangaben kann ein Sternchen als Platzhalter für Zeichenfolgen verwendet werden, sofern der jeweilige Crawler diese Syntax unterstützt. Weil Wildcards schnell zu weit greifen, sollten sie immer mit konkreten URLs und einem passenden Testwerkzeug überprüft werden.

Fazit: Die robots.txt bewusst und nachvollziehbar pflegen

Die häufigsten Fehler in der robots.txt entstehen durch pauschale Sperren, veraltete Konfigurationen, unpräzise Wildcards und die Verwechslung von Crawling, Indexierung und Sicherheit. Eine wirksame Prüfung beginnt deshalb mit der tatsächlich ausgelieferten Datei und führt über konkrete URL-Beispiele bis zur Kontrolle von Sitemap, Ressourcen und Website-Umgebung.

Halten Sie Regeln so kurz wie möglich, dokumentieren Sie ungewöhnliche Ausnahmen und testen Sie Änderungen nach jedem wichtigen technischen Eingriff erneut. So wird die robots.txt zu einem nachvollziehbaren Bestandteil der technischen Suchmaschinenoptimierung, statt selbst zur Ursache schwer erkennbarer Crawling-Probleme zu werden.

Warum jede Website eine Sitemap braucht: Der umfassende Ratgeber

Eine Sitemap ist kein sichtbares Gütesiegel und auch kein direkter Garant für bessere Rankings. Dennoch gehört sie für die meisten Websites zu den wichtigsten technischen Grundlagen der Suchmaschinenoptimierung. Sie hilft Suchmaschinen dabei, relevante URLs zu entdecken, die Struktur einer Website besser zu verstehen und Änderungen effizienter zu verarbeiten.

In diesem Ratgeber erfahren Sie, warum jede Website eine Sitemap braucht, welche Sitemap-Arten es gibt, wann sie besonders wichtig ist und wie Sie eine Sitemap sinnvoll erstellen, prüfen und dauerhaft pflegen. Dabei geht es nicht nur um Suchmaschinen: Eine gut geplante Sitemap kann auch die interne Organisation und die technische Qualität eines Webauftritts verbessern.

Was ist eine Sitemap?

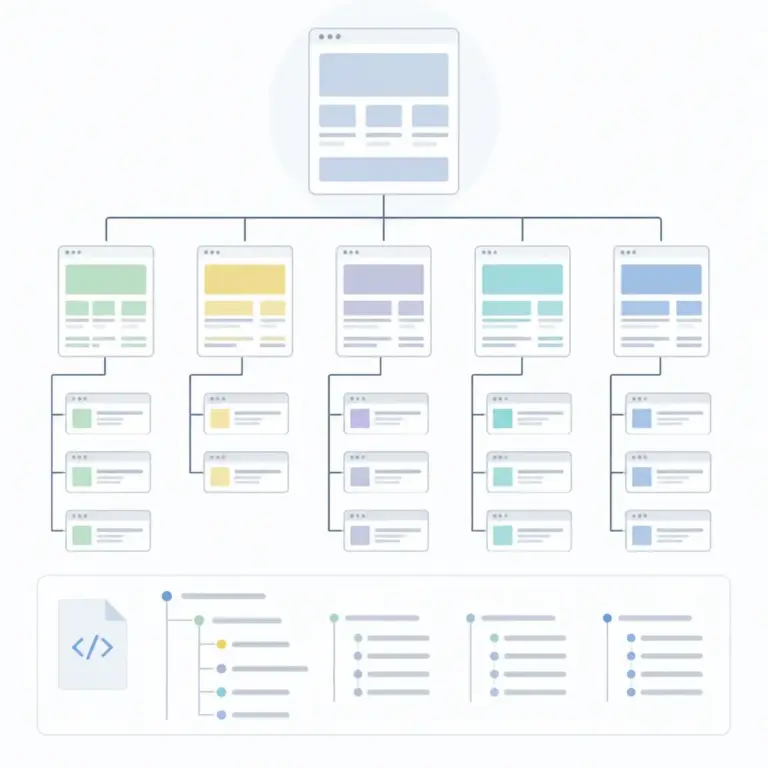
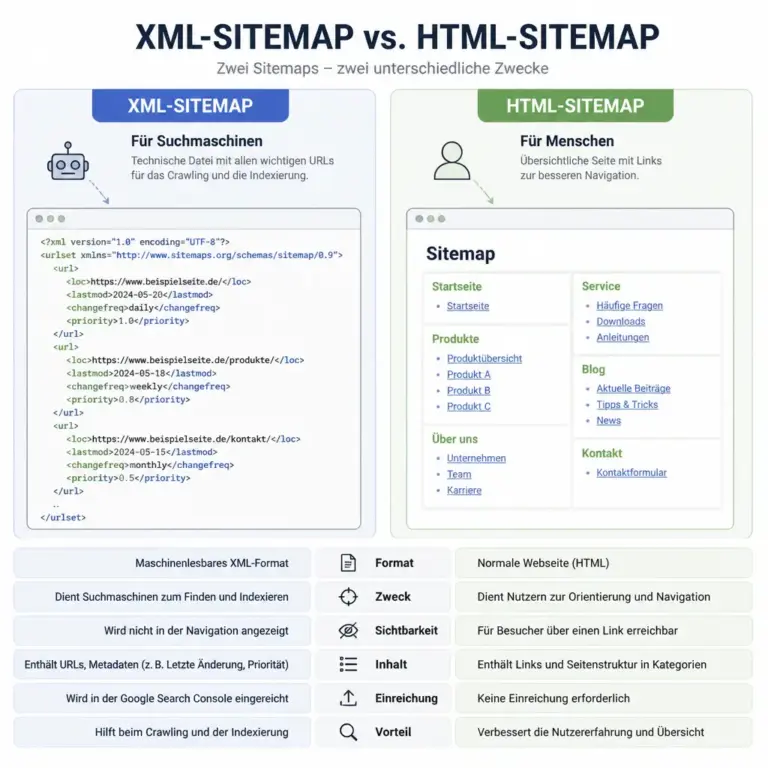
Vergleich zwischen XML-Sitemap fu00fcr Suchmaschinen und HTML-Sitemap fu00fcr Besucher
Eine XML-Sitemap unterstützt Suchmaschinen, während eine HTML-Sitemap Menschen Orientierung bietet.

Die Abbildung macht sichtbar, dass beide Sitemap-Arten unterschiedliche Aufgaben erfüllen. Die technische Liste ist nicht als Ersatz für die sichtbare Navigation gedacht.

Eine Sitemap ist eine strukturierte Übersicht wichtiger Seiten, Dateien oder Inhalte einer Website. Im Zusammenhang mit Suchmaschinen ist meist die XML-Sitemap gemeint. Sie wird in einem standardisierten Format bereitgestellt und enthält vor allem URLs, die von Suchmaschinen gefunden und berücksichtigt werden sollen.

Eine XML-Sitemap kann zusätzliche Informationen enthalten, beispielsweise den Zeitpunkt der letzten wesentlichen Änderung. Diese Angaben sind Hinweise, keine Anweisungen. Eine Suchmaschine entscheidet selbst, welche URL sie crawlt, wie häufig sie sie besucht und ob sie in den Suchindex aufgenommen wird.

Daneben gibt es die HTML-Sitemap. Sie richtet sich hauptsächlich an Besucherinnen und Besucher und stellt wichtige Bereiche einer Website als übersichtliche Linkliste dar. Bei kleinen Websites ist eine HTML-Sitemap nicht immer erforderlich, bei umfangreichen oder komplex strukturierten Angeboten kann sie jedoch die Orientierung erleichtern.

Wichtig ist die Unterscheidung zwischen einer Sitemap und der Navigation. Die Navigation dient der täglichen Nutzung durch Menschen. Die XML-Sitemap dient vor allem dazu, Suchmaschinen und anderen technischen Systemen eine zusätzliche, strukturierte Orientierung zu geben. Sie ersetzt weder eine logische Menüführung noch eine gute interne Verlinkung.

Warum jede Website eine Sitemap braucht

Die zentrale Aufgabe einer Sitemap besteht darin, wichtige URLs auffindbar zu machen. Suchmaschinen folgen zwar Links und entdecken dadurch viele Inhalte, doch dieser Prozess ist nicht bei jeder Website gleich zuverlässig. Neue, tief verschachtelte, selten verlinkte oder technisch schwer erreichbare Seiten können leichter übersehen werden.

Neue Inhalte schneller auffindbar machen

Wenn ein Blogartikel, eine Produktseite oder ein wichtiger Ratgeber veröffentlicht wird, muss eine Suchmaschine zunächst von dieser URL erfahren. Eine automatisch aktualisierte Sitemap kann die neue Seite als Teil des vorhandenen Inhaltsbestands sichtbar machen. Das bedeutet nicht, dass die URL sofort gecrawlt oder indexiert wird. Die Entdeckung wird jedoch grundsätzlich erleichtert.

Besonders nützlich ist das bei Websites, auf denen regelmäßig neue Inhalte entstehen. Dazu zählen Nachrichtenportale, Onlineshops, Wissensdatenbanken, Veranstaltungsseiten und große Unternehmenswebsites. Auch eine kleine Website profitiert davon, wenn zentrale neue Seiten nicht lange nur über wenige interne Links erreichbar sind.

Große Websites besser strukturieren

Bei mehreren Hundert oder Tausenden von URLs wird die technische Kontrolle anspruchsvoller. Eine Sitemap kann dabei helfen, den vorgesehenen Inhaltsbestand von zufälligen oder unwichtigen URLs zu trennen. So lässt sich leichter prüfen, ob wichtige Bereiche enthalten sind und ob sich unerwartete URLs eingeschlichen haben.

Eine Sitemap ist deshalb auch ein Kontrollinstrument für Betreiber. Wer regelmäßig überprüft, welche URLs darin stehen, erkennt häufig technische Probleme: versehentlich veröffentlichte Testseiten, veraltete Produktadressen, fehlerhafte Weiterleitungen oder Seiten, die trotz ihrer Bedeutung nicht erfasst werden.

Websites mit schwacher interner Verlinkung unterstützen

Eine Sitemap kann fehlende interne Links nicht reparieren. Sie kann aber als zusätzliche Entdeckungshilfe dienen, wenn bestimmte Seiten nur wenige eingehende Links besitzen. Das betrifft beispielsweise Landingpages aus Kampagnen, Archive, Filterkombinationen oder spezielle Informationsseiten.

Die richtige Schlussfolgerung lautet daher nicht: „Mit einer Sitemap sind interne Links überflüssig.“ Besser ist: „Die Sitemap ergänzt eine starke interne Verlinkung.“ Wichtige Inhalte sollten weiterhin von passenden, gut erreichbaren Seiten aus verlinkt werden.

Technische Änderungen transparenter machen

Bei Migrationen, Relaunches oder umfangreichen Überarbeitungen ist eine Sitemap besonders hilfreich. Sie kann nach dem Umzug die neue URL-Struktur abbilden und als Grundlage für Kontrollen dienen. Gemeinsam mit Weiterleitungen, einer aktuellen internen Verlinkung und einer technischen Prüfung entsteht ein belastbareres Bild der Website.

Auch nach größeren Änderungen sollte geprüft werden, ob nur die gewünschten URLs in der Sitemap stehen. Eine veraltete Sitemap mit alten Adressen kann die technische Auswertung erschweren und unnötige Signale senden.

XML-Sitemap, HTML-Sitemap und Bild-Sitemap im Vergleich

Sitemap-Art Hauptzweck Typische Zielgruppe Besonderheit
XML-Sitemap Wichtige URLs strukturiert mitteilen Suchmaschinen und technische Systeme Für SEO und Crawling besonders relevant
HTML-Sitemap Inhalte als übersichtliche Linkliste zeigen Besucherinnen und Besucher Kann Orientierung und interne Verlinkung verbessern
Bild-Sitemap Relevante Bilder zusätzlich beschreiben Bildersuchsysteme Vor allem bei bildorientierten Websites interessant
Video-Sitemap Videoinhalte strukturiert kennzeichnen Suchmaschinen Für umfangreiche Videobibliotheken sinnvoll

Die meisten Websites benötigen zunächst eine gepflegte XML-Sitemap. Bild- oder Video-Sitemaps sind keine Pflicht für jedes Projekt. Sie können sich lohnen, wenn Bilder oder Videos einen wesentlichen Teil des Angebots ausmachen und technisch relevante Zusatzinformationen vorhanden sind.

Welche URLs gehören in eine Sitemap?

In eine XML-Sitemap gehören grundsätzlich die kanonischen, öffentlich erreichbaren URLs, die für Nutzerinnen und Nutzer einen eigenständigen Wert haben. Dazu zählen beispielsweise Startseiten, wichtige Leistungsseiten, Ratgeber, redaktionelle Beiträge, Produktseiten und relevante Kategorieseiten.

Nicht jede technisch erreichbare URL sollte aufgenommen werden. Eine Sitemap ist keine vollständige Liste aller Adressen, die ein Server ausliefern kann. Sie sollte vielmehr den gewünschten, qualitativ relevanten Bestand der Website abbilden.

Geeignete URLs

  • Seiten mit einem erfolgreichen Serverstatus, normalerweise einer erreichbaren HTML-Antwort.
  • Indexierbare Inhalte, die nicht ausdrücklich von Suchmaschinen ausgeschlossen werden.
  • Kanonische URLs, auf die keine andere Adresse als bevorzugte Version verweist.
  • Inhalte, die für die Zielgruppe nützlich und dauerhaft relevant sind.
  • Neue oder wesentlich aktualisierte Seiten, sofern sie weiterhin veröffentlicht bleiben sollen.

Ungeeignete URLs

  • Seiten mit einer Weiterleitung oder einem Fehlerstatus.
  • URLs mit einem Ausschluss durch Robots-Meta-Angaben oder andere technische Vorgaben.
  • Doppelte Inhalte, alternative Parameter-Varianten und interne Suchergebnisse.
  • Warenkorb-, Kassen-, Login- oder persönliche Kontoseiten.
  • Temporäre Testseiten, Vorschauen und nicht fertige Entwürfe.
  • Seiten, die zwar technisch existieren, aber keinen eigenständigen Nutzen bieten.

Eine wichtige Qualitätsprüfung lautet: Würde diese URL auch dann für Suchmaschinen relevant sein, wenn sie über einen normalen Link entdeckt wird? Wenn die Antwort klar nein lautet, gehört sie meist nicht in die Sitemap.

Wie wird eine Sitemap erstellt?

Der beste Weg hängt vom verwendeten System und vom Umfang der Website ab. Viele Content-Management-Systeme erzeugen automatisch eine Sitemap. Häufig ist sie unter einer Adresse wie /sitemap.xml erreichbar. Bei größeren Websites kann das System mehrere Sitemap-Dateien erstellen und über eine Sitemap-Indexdatei miteinander verbinden.

Bei einer manuellen Erstellung werden die gewünschten URLs in einem gültigen XML-Format hinterlegt. Das ist für kleine, selten veränderte Websites möglich, erfordert aber regelmäßige Pflege. Schon eine einzelne veraltete oder falsch formatierte Adresse kann die Qualität der Datei beeinträchtigen.

Bei dynamischen Websites ist eine automatische Generierung meist sinnvoller. Sie sollte jedoch nicht blind aktiviert werden. Manche Erweiterungen nehmen standardmäßig Archive, Parameterseiten oder andere URL-Typen auf, die nicht zum gewünschten Index gehören. Die Einstellungen sollten deshalb nach der Einrichtung kontrolliert werden.

Worauf sollte das XML-Format achten?

Eine XML-Sitemap muss technisch gültig sein und die vorgesehenen Elemente korrekt verwenden. URLs sollten vollständig angegeben werden und die tatsächliche bevorzugte Version der Adresse darstellen. Einheitlichkeit ist wichtig: Werden beispielsweise sichere und unsichere Protokollvarianten oder verschiedene Hostnamen vermischt, entsteht unnötige Unklarheit.

Das Änderungsdatum sollte nur dann aktualisiert werden, wenn sich der Inhalt tatsächlich wesentlich verändert hat. Ein tägliches Aktualisieren aller URLs ohne inhaltlichen Grund liefert keinen verlässlichen Hinweis. Auch die optionale Angabe einer Priorität sollte nicht als direkte Rankingsteuerung missverstanden werden.

Sitemap bei Suchmaschinen einreichen

Eine Sitemap kann über die robots.txt referenziert werden. Dort wird die vollständige URL der Datei angegeben. Zusätzlich kann sie in den jeweiligen Bereichen für Website-Verwaltung und Suchanalyse eingereicht werden. Das erleichtert die Zuordnung zur richtigen Website und stellt häufig nützliche Statusinformationen bereit.

Das Einreichen bedeutet nicht, dass jede enthaltene Seite indexiert wird. Es teilt vielmehr mit, welche URLs der Betreiber als relevant betrachtet. Suchmaschinen vergleichen diese Angaben mit ihren eigenen Erkenntnissen, etwa mit gefundenen Links, Statuscodes, Weiterleitungen und Qualitätsmerkmalen.

Nach einer Einreichung sollten Betreiber auf Warnungen und Fehler achten. Ein einzelner Fehler in einer Datei ist nicht automatisch ein schweres Problem. Wiederkehrende Abweichungen zwischen Sitemap und tatsächlichem Websitezustand deuten jedoch auf Pflege- oder Konfigurationsbedarf hin.

Sitemap und Crawling: Was sie leisten kann und was nicht

Eine Sitemap verbessert die Möglichkeit, URLs zu entdecken. Sie garantiert weder Crawling noch Indexierung und schon gar nicht eine bestimmte Position in den Suchergebnissen. Suchmaschinen bewerten unter anderem die Zugänglichkeit, den Inhalt, die interne Verlinkung, technische Signale und die erwartete Bedeutung einer Seite.

Auch die Crawling-Belastung wird durch eine Sitemap nicht automatisch gelöst. Wenn eine Website sehr viele minderwertige oder doppelte URLs enthält, sollte das Problem an der URL-Struktur gelöst werden. Eine Sitemap, die lediglich alle vorhandenen Adressen auflistet, kann die Übersicht sogar verschlechtern.

Für eine gute technische Grundlage sollten deshalb mehrere Elemente zusammenpassen:

  • eine klare Informationsarchitektur,
  • relevante interne Links,
  • korrekte Statuscodes und Weiterleitungen,
  • eine konsistente Canonical-Konfiguration,
  • eine sinnvolle Steuerung von indexierbaren und nicht indexierbaren Bereichen,
  • eine aktuelle, fehlerarme Sitemap.

Die Sitemap ist damit ein wichtiges Puzzleteil, aber kein Ersatz für eine insgesamt saubere Website.

Besondere Fälle: kleine Websites, Onlineshops und Relaunches

Kleine Unternehmenswebsite

Bei einer kleinen Website mit wenigen, gut verlinkten Seiten ist eine Sitemap nicht immer zwingend erforderlich. Trotzdem ist sie meist mit geringem Aufwand verfügbar und schafft eine zusätzliche technische Absicherung. Gerade bei Änderungen oder einem späteren Ausbau kann sie wertvoll sein.

Blog oder redaktionelles Portal

Regelmäßig wachsende Websites profitieren besonders von einer automatisch gepflegten Sitemap. Neue Beiträge, Kategorien und Aktualisierungen sollten nach einer passenden Strategie berücksichtigt werden. Alte Inhalte sollten nicht automatisch entfernt werden, wenn sie weiterhin nützlich und erreichbar sind.

Onlineshop

Shops müssen besonders sorgfältig zwischen wertvollen Produktseiten und wenig hilfreichen URL-Varianten unterscheiden. Filter, Sortierungen, Suchergebnisse und Sitzungsparameter können eine große Zahl ähnlicher Adressen erzeugen. In die Sitemap gehören in der Regel die gewünschten, kanonischen Produkt- und Kategorieseiten, nicht jede Filterkombination.

Website-Relaunch

Vor einem Relaunch sollte bekannt sein, welche URLs künftig bestehen bleiben, geändert oder entfernt werden. Nach dem Start muss die Sitemap die neue Struktur abbilden. Alte Adressen gehören nicht einfach weiter in die neue Datei, sondern sollten passend weitergeleitet oder bewusst mit einem geeigneten Status beendet werden.

Sitemap regelmäßig prüfen und pflegen

Eine Sitemap ist nur dann dauerhaft nützlich, wenn sie dem tatsächlichen Websitezustand entspricht. Für kleine Websites genügt oft eine Prüfung nach größeren Änderungen. Bei Shops, Portalen und stark wachsenden Projekten sollte die Kontrolle in einen festen technischen Prozess integriert werden.

Eine praktische Prüfung kann folgende Fragen enthalten:

  • Sind alle enthaltenen URLs erreichbar?
  • Gibt es Weiterleitungen oder Fehlerseiten in der Datei?
  • Stimmen Protokoll, Domain und bevorzugte URL-Version?
  • Sind ausgeschlossene oder nicht öffentliche Bereiche enthalten?
  • Fehlen wichtige neue Seiten?
  • Entsprechen Änderungsdaten den tatsächlichen inhaltlichen Änderungen?
  • Wird die Sitemap nach einem Relaunch automatisch oder manuell aktualisiert?

Zusätzlich lohnt sich ein Vergleich zwischen Sitemap, intern verlinkten Seiten und den Berichten der Suchmaschinenverwaltung. Abweichungen sind nicht immer Fehler, liefern aber Hinweise für eine genauere Untersuchung.

Häufige Fehler bei Sitemaps

Zu den häufigsten Problemen gehört eine Sitemap, die zu viele URLs enthält. Je größer die Datei, desto wichtiger ist die Auswahl. Ebenso problematisch sind URLs, die auf Weiterleitungen zeigen, nicht erreichbar sind oder durch widersprüchliche technische Angaben ausgeschlossen werden.

Ein weiterer Fehler ist die Annahme, dass die Sitemap Rankings erzwingt. Sie kann die Entdeckung unterstützen, aber keinen schwachen Inhalt, eine schlechte Nutzerführung oder technische Barrieren ausgleichen. Auch eine veraltete Sitemap nach einem Domainwechsel oder Relaunch kann zu unnötigen Unklarheiten führen.

Manche Betreiber erstellen außerdem eine Sitemap, reichen sie einmal ein und vergessen sie danach. Sinnvoller ist ein Prozess, bei dem die Datei automatisch gepflegt und in regelmäßigen Abständen stichprobenartig kontrolliert wird.

FAQ

Ist eine Sitemap für jede Website verpflichtend?

Nein. Eine Sitemap ist normalerweise keine allgemeine Pflicht. Für die meisten Websites ist sie dennoch empfehlenswert, weil sie die Entdeckung wichtiger URLs erleichtert und eine zusätzliche Kontrolle über den veröffentlichten Inhaltsbestand ermöglicht.

Verbessert eine Sitemap automatisch das Ranking?

Nein. Eine Sitemap ist kein direkter Rankingfaktor im Sinne einer garantierten Verbesserung. Sie kann Suchmaschinen helfen, relevante Inhalte zu finden. Ob eine Seite indexiert wird und wie sie bewertet wird, hängt von vielen weiteren technischen und inhaltlichen Signalen ab.

Reicht eine Sitemap allein für gute SEO aus?

Nein. Sie ergänzt unter anderem interne Verlinkung, eine klare Seitenstruktur, gute Inhalte, korrekte Statuscodes und eine sinnvolle Indexierungssteuerung. Eine Sitemap kann grundlegende Probleme nicht ersetzen oder verdecken.

Wie oft sollte eine Sitemap aktualisiert werden?

Sie sollte aktualisiert werden, sobald sich der gewünschte Bestand wichtiger URLs ändert. Bei dynamischen Websites geschieht das idealerweise automatisch. Das Änderungsdatum einzelner URLs sollte trotzdem nur bei wesentlichen Änderungen angepasst werden.

Kann eine Sitemap zu viele URLs enthalten?

Ja. Eine Sitemap sollte nicht jede technisch erzeugbare Adresse enthalten. Doppelte, unwichtige, private, weitergeleitete oder ausgeschlossene URLs gehören normalerweise nicht hinein. Eine kleinere, sorgfältig ausgewählte Datei ist hilfreicher als eine vollständige Liste aller Varianten.

Braucht eine kleine Website zusätzlich eine HTML-Sitemap?

Nicht unbedingt. Wenn die Navigation übersichtlich ist und alle wichtigen Seiten gut erreichbar sind, kann eine HTML-Sitemap entbehrlich sein. Bei vielen Unterseiten, älteren Inhalten oder einer komplexen Struktur kann sie Besucherinnen und Besuchern dennoch zusätzliche Orientierung geben.

Was passiert, wenn die Sitemap fehlerhafte URLs enthält?

Einzelne Fehler führen nicht automatisch zu einem großen Problem. Häufen sich jedoch falsche URLs, kann die Datei ihre Funktion als verlässliche Übersicht verlieren. Die fehlerhaften Adressen sollten geprüft und entfernt oder korrigiert werden. Wichtig ist außerdem, die Ursache in der automatischen Generierung zu beheben.

Fazit: Eine Sitemap schafft technische Klarheit

Warum jede Website eine Sitemap braucht, lässt sich vor allem mit drei Punkten beantworten: Sie unterstützt die Entdeckung wichtiger URLs, schafft Transparenz über den gewünschten Inhaltsbestand und erleichtert die Kontrolle bei Wachstum oder technischen Änderungen. Besonders große, regelmäßig aktualisierte oder komplex strukturierte Websites profitieren davon.

Eine gute Sitemap ist nicht möglichst umfangreich, sondern möglichst präzise. Sie enthält indexierbare, kanonische und wertvolle URLs, wird automatisch oder zuverlässig aktualisiert und regelmäßig auf Fehler geprüft. Zusammen mit einer verständlichen Navigation, einer starken internen Verlinkung und technisch sauberen Seiten bildet sie eine solide Grundlage für eine gut auffindbare Website.

Sitemap.xml prüfen und optimieren: Der umfassende Ratgeber für bessere Crawlbarkeit

Eine gut gepflegte sitemap.xml hilft Suchmaschinen dabei, wichtige URLs einer Website effizient zu entdecken und regelmäßig zu crawlen. Sie ersetzt weder eine klare interne Verlinkung noch hochwertige Inhalte, kann aber besonders bei großen, neuen oder häufig veränderten Websites wertvolle Orientierung geben. In diesem Ratgeber erfahren Sie, wie Sie Ihre Sitemap.xml prüfen, typische Fehler erkennen und die Datei dauerhaft sinnvoll optimieren.

Was ist eine Sitemap.xml und welche Aufgabe hat sie?

Eine XML-Sitemap ist eine maschinenlesbare Datei, in der die indexierbaren URLs einer Website aufgelistet werden. Sie liegt häufig unter einer Adresse wie https://www.beispiel.de/sitemap.xml oder verweist als Sitemap-Index auf mehrere einzelne Sitemaps. Suchmaschinen können diese URLs abrufen und mit den Informationen aus der Sitemap abgleichen.

Wichtig ist die richtige Einordnung: Eine Sitemap ist keine Liste von Seiten, die automatisch indexiert werden. Sie ist vielmehr ein Hinweis an Suchmaschinen, welche URLs Sie für relevant halten. Ob eine Seite tatsächlich gecrawlt und in den Suchindex aufgenommen wird, hängt zusätzlich von Faktoren wie Inhalt, interner Verlinkung, Zugriffsmöglichkeit, Canonical-Angabe und technischen Signalen ab.

Für kleine Websites mit wenigen, gut verlinkten Seiten ist eine Sitemap nicht immer entscheidend. Dennoch gehört sie heute meist zur technischen Grundausstattung. Besonders nützlich ist sie in folgenden Situationen:

  • Die Website enthält viele Seiten oder wird regelmäßig erweitert.
  • Neue Inhalte sind nur über wenige interne Links erreichbar.
  • Es gibt Archive, Filterseiten oder andere große URL-Strukturen, die sorgfältig gesteuert werden müssen.
  • Die Website enthält Bilder, Videos oder Nachrichteninhalte mit speziellen Anforderungen.
  • Die interne Verlinkung ist noch nicht vollständig ausgebaut.
  • Nach einem Relaunch sollen wichtige URLs schneller erkannt werden.

Sitemap.xml prüfen: Die wichtigsten Kontrollen im Überblick

Infografik mit den wichtigsten Pru00fcfschritten fu00fcr eine Sitemap.xml
Diese Übersicht zeigt die zentralen Prüfschritte einer Sitemap-Kontrolle.

Achten Sie in der Grafik auf die Verbindung zwischen technischer Erreichbarkeit und der Qualität der enthaltenen URLs. Eine Sitemap ist erst dann hilfreich, wenn sie sowohl gültig ausgeliefert wird als auch relevante, indexierbare Seiten enthält.

Beim Prüfen der Sitemap geht es nicht nur darum, ob die Datei technisch erreichbar ist. Entscheidend ist, ob sie konsistente und tatsächlich wertvolle URLs enthält. Eine kurze, saubere Sitemap ist in der Regel nützlicher als eine sehr große Datei mit zahlreichen Weiterleitungen, Fehlerseiten oder irrelevanten Parametervarianten.

Prüfbereich Worauf Sie achten sollten Typische Maßnahme
Erreichbarkeit Die Datei liefert eine erfolgreiche HTTP-Antwort und ist öffentlich abrufbar. Server, URL und Zugriffsregeln kontrollieren.
Format Die XML-Struktur ist gültig und sauber codiert. XML-Validator oder Suchmaschinen-Tool verwenden.
URL-Auswahl Nur kanonische, indexierbare und relevante URLs sind enthalten. Weiterleitungen, Fehlerseiten und Ausschlussseiten entfernen.
Aktualität Neue, geänderte oder entfernte Inhalte werden korrekt berücksichtigt. Generierung und Aktualisierungslogik prüfen.
Abdeckung Wichtige Seitentypen werden vollständig erfasst. Stichproben mit Website-Struktur und Indexbericht vergleichen.
Technische Grenzen Datei- und URL-Grenzen werden eingehalten. Sitemap-Index für größere Websites einsetzen.

Erreichbarkeit und Statuscode kontrollieren

Rufen Sie die Sitemap direkt im Browser oder über ein technisches Prüfwerkzeug auf. Sie sollte ohne Anmeldung, Cookie-Abfrage oder JavaScript-Ausführung erreichbar sein. Prüfen Sie außerdem, ob die Datei den erwarteten Inhalt ausliefert und nicht versehentlich auf eine HTML-Fehlerseite, eine Startseite oder eine veraltete Domain weiterleitet.

Ein erfolgreicher Statuscode allein reicht nicht immer aus. Manche Server liefern bei nicht vorhandenen Dateien eine eigene Fehlerseite mit einem technisch erfolgreichen Statuscode aus. Deshalb sollte auch der Inhalt überprüft werden: Beginnt die Datei mit einer gültigen XML-Struktur und enthält sie die erwarteten Sitemap-Elemente?

XML-Syntax und Zeichencodierung prüfen

Eine Sitemap muss syntaktisch korrekt sein. Achten Sie unter anderem auf korrekt geschlossene Elemente, gültige URLs und eine passende Zeichencodierung. Sonderzeichen in URLs müssen korrekt behandelt werden. Auch unzulässige Steuerzeichen oder fehlerhafte Einträge können dazu führen, dass Teile der Datei nicht verarbeitet werden.

Die grundlegende Struktur einer URL-Sitemap sieht beispielsweise so aus:

<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://www.beispiel.de/wichtige-seite/</loc>
  </url>
</urlset>

Die Beispielstruktur ist bewusst einfach gehalten. Zusätzliche Elemente wie lastmod können sinnvoll sein, wenn der angegebene Änderungszeitpunkt zuverlässig gepflegt wird.

Welche URLs gehören in eine Sitemap?

Die zentrale Entscheidungsfrage lautet: Würde die Website diese URL einem Suchmaschinen-Crawler und einem potenziellen Besucher als eigenständige, wertvolle Seite empfehlen? Wenn die Antwort eindeutig Nein lautet, gehört die URL meist nicht in die Sitemap.

In der Regel sollten enthalten sein:

  • kanonische URLs mit dem bevorzugten Protokoll und Hostnamen,
  • öffentlich erreichbare Seiten mit relevantem, eigenständigem Inhalt,
  • indexierbare Kategorien, Produkte, Dienstleistungen oder Ratgeberseiten,
  • wichtige Seiten, die dauerhaft Bestandteil der Website bleiben,
  • aktualisierte URLs, wenn deren Inhalt tatsächlich überarbeitet wurde.

Eine URL sollte möglichst gleichzeitig mehrere Bedingungen erfüllen: Sie ist mit dem HTTP-Statuscode 200 erreichbar, nicht durch noindex ausgeschlossen, nicht per robots.txt blockiert und verweist über das Canonical-Element auf sich selbst oder wird von der Website als kanonische Variante behandelt.

Welche URLs sollten ausgeschlossen werden?

Häufige Kandidaten für den Ausschluss sind:

  • Weiterleitungsziele, wenn die alte URL selbst noch in der Sitemap steht,
  • 404- und 410-Seiten,
  • URLs mit noindex,
  • interne Suchergebnisse, Warenkörbe und Konto-Seiten,
  • Session-IDs und unnötige Tracking-Parameter,
  • technische Varianten mit falschem Protokoll oder falschem Hostnamen,
  • doppelte Inhalte ohne eigenständigen Suchwert,
  • unvollständige oder vorläufige Seiten.

Ein häufiger Fehler ist die automatische Aufnahme jeder URL, die ein Content-Management-System erzeugt. Dazu können beispielsweise Autorenarchive, Schlagwortseiten, Druckversionen, facettierte Filter oder paginierte Varianten gehören. Diese URL-Typen müssen nicht grundsätzlich ausgeschlossen werden. Entscheidend ist, ob sie einen eigenständigen Nutzen haben und bewusst indexiert werden sollen.

Die Sitemap.xml sinnvoll optimieren

Die Optimierung beginnt mit einer klaren Trennung zwischen wichtigen Inhalts-URLs und technischen Nebenprodukten. Ziel ist kein möglichst umfangreiches Verzeichnis, sondern ein verlässliches Signal über die Seiten, die Suchmaschinen tatsächlich berücksichtigen sollen.

Nur kanonische URLs verwenden

Wenn eine Seite unter mehreren Varianten erreichbar ist, sollte nur die bevorzugte Version in der Sitemap stehen. Typische Varianten entstehen durch HTTP und HTTPS, verschiedene Hostnamen, Groß- und Kleinschreibung, abschließende Schrägstriche oder Parameter. Legen Sie eine konsistente URL-Struktur fest und verwenden Sie sie überall: in der Sitemap, in Canonical-Tags, in internen Links und möglichst auch in Weiterleitungen.

Die Sitemap darf nicht als Ort dienen, an dem Suchmaschinen zwischen mehreren konkurrierenden URL-Varianten wählen müssen. Je klarer das Signal, desto leichter lässt sich die technische Struktur prüfen.

Das Änderungsdatum vorsichtig einsetzen

Das Element lastmod beschreibt, wann sich der Inhalt einer URL zuletzt wesentlich geändert hat. Es sollte nicht bei jedem automatischen Seitenaufruf oder jeder kleinen Systemänderung aktualisiert werden. Ein ständig wechselndes Datum ohne relevante Inhaltsänderung verliert an Aussagekraft.

Verwenden Sie lastmod vor allem dann, wenn die Daten zuverlässig aus dem Redaktionssystem stammen. Eine echte Überarbeitung eines Ratgebers, eine Änderung zentraler Produktinformationen oder eine wichtige Aktualisierung eines Leistungsangebots sind plausible Anlässe. Das Datum sollte sich auf den Inhalt beziehen, nicht lediglich auf das technische Erstellungsdatum einer neuen Sitemap-Datei.

Priorität und Änderungsfrequenz nicht überschätzen

Ältere Sitemap-Felder wie eine allgemeine Priorität oder eine Änderungsfrequenz werden von modernen Suchmaschinen nicht als verbindliche Steuerung verstanden. Sie ersetzen keine gute Informationsarchitektur und garantieren keinen häufigeren Crawl. Konzentrieren Sie sich daher auf korrekte URLs, verlässliche Änderungsdaten und eine sinnvolle Auswahl.

Sitemap-Index für umfangreiche Websites einsetzen

Große Websites können mehrere thematische oder technische Sitemaps verwenden, etwa getrennt nach Produkten, Ratgebern, Kategorien oder Sprachen. Ein Sitemap-Index bündelt diese Dateien. Das erleichtert die Wartung und ermöglicht eine gezielte Fehleranalyse.

Achten Sie auf eine verständliche Benennung. Eine Aufteilung nach Seitentypen kann sinnvoller sein als eine rein zufällige Aufteilung nach Dateigröße. Wenn bei einem Relaunch nur die Produkt-Sitemap fehlerhaft ist, lässt sich das Problem schneller eingrenzen, wenn die Struktur klar erkennbar ist.

Sitemap.xml und robots.txt richtig verbinden

Die robots.txt-Datei und die Sitemap erfüllen unterschiedliche Aufgaben. Die robots.txt kann das Crawling bestimmter Bereiche einschränken. Die Sitemap listet URLs auf, die als relevant und zugänglich betrachtet werden. Sie sollten deshalb keine URL in der Sitemap angeben, deren Abruf Sie gleichzeitig über robots.txt verhindern.

Ein Verweis in der robots.txt kann die Auffindbarkeit der Sitemap verbessern. Er kann beispielsweise auf die vollständige absolute URL der Sitemap oder des Sitemap-Index zeigen. Prüfen Sie dabei, dass der Hostname und das Protokoll genau zur Website passen.

Beachten Sie außerdem: Eine robots.txt-Sperre ist kein verlässlicher Ersatz für noindex, wenn eine URL aus dem Suchindex entfernt werden soll. Ist eine Seite bereits bekannt, kann eine reine Crawling-Sperre verhindern, dass Suchmaschinen das gewünschte Ausschlusssignal abrufen. Technische Maßnahmen sollten daher nach dem konkreten Ziel ausgewählt werden.

Sitemap in Suchmaschinen-Tools einreichen und überwachen

Reichen Sie die Sitemap beziehungsweise den Sitemap-Index in den passenden Verwaltungsoberflächen der Suchmaschinen ein. Das ist meist nur ein Hinweis und keine Garantie für Crawling oder Indexierung. Der Vorteil liegt vor allem in der Überwachung: Sie können erkennen, ob die Datei abgerufen wurde, ob Fehler gemeldet werden und wie sich bekannte URLs im Verhältnis zu den tatsächlich indexierten Seiten entwickeln.

Vergleichen Sie die Sitemap nicht unkritisch mit jeder URL, die in einem Indexbericht auftaucht. Suchmaschinen können URLs entdecken, die nicht in Ihrer Sitemap stehen, beispielsweise über interne oder externe Links. Umgekehrt kann eine URL in der Sitemap stehen, ohne indexiert zu werden. Diese Abweichung ist ein Anlass zur Analyse, aber nicht automatisch ein technischer Fehler.

Für eine belastbare Prüfung kombinieren Sie mehrere Perspektiven:

  • Sitemap-Inhalt und Sitemap-Fehlermeldungen,
  • Crawling- und Indexierungsberichte,
  • Server-Logs oder Crawling-Daten, sofern verfügbar,
  • interne Verlinkung und Website-Struktur,
  • Stichproben bei wichtigen Seitentypen,
  • Weiterleitungen, Canonical-Tags und Statuscodes.

Typische Fehler beim Prüfen und Optimieren

Die Sitemap enthält jede automatisch erzeugte URL

Eine automatische Generierung ist bequem, aber nicht automatisch sinnvoll. Prüfen Sie die Regeln des eingesetzten Systems. Manche Erweiterungen nehmen standardmäßig Archive, Filter oder Medienseiten auf, obwohl diese für die organische Suche keine eigenständige Rolle spielen sollen.

Die Datei ist aktuell, aber inhaltlich unzuverlässig

Eine täglich neu geschriebene Sitemap ist nicht automatisch besser. Wenn entfernte Seiten, alte Weiterleitungen oder falsche Änderungsdaten enthalten bleiben, entsteht ein dauerhaftes Qualitätsproblem. Entscheidend ist die Logik hinter der Generierung: Wird vor der Ausgabe geprüft, ob eine URL indexierbar, erreichbar und kanonisch ist?

Wichtige Seiten fehlen trotz vorhandener Sitemap

Manchmal wird nur die Startseite oder nur eine bestimmte Kategorie erfasst. Prüfen Sie deshalb nicht nur die Datei selbst, sondern auch die Seitentypen, die das System einbezieht. Ein Vergleich mit der XML-Struktur, der Navigation und einer repräsentativen URL-Liste zeigt häufig, ob Produkte, Beiträge, Landingpages oder regionale Seiten fehlen.

Sitemap und interne Links werden verwechselt

Eine URL in der Sitemap ist kein Ersatz für eine gute interne Verlinkung. Wichtige Seiten sollten über nachvollziehbare Menüs, Kategorien, kontextbezogene Links oder thematische Übersichten erreichbar sein. Die Sitemap kann die Entdeckung unterstützen, vermittelt aber nicht automatisch die inhaltliche Bedeutung einer Seite.

Nach dem Relaunch bleiben alte URLs enthalten

Bei Domainwechseln, Strukturänderungen und Migrationen sollte die Sitemap Bestandteil der Abnahmekontrolle sein. Entfernen Sie alte URLs, die dauerhaft weiterleiten oder nicht mehr existieren, und stellen Sie sicher, dass die neue Sitemap nur die aktuelle Zielstruktur enthält. Prüfen Sie außerdem, ob Verweise in der robots.txt und in Suchmaschinen-Tools aktualisiert wurden.

Praktische Checkliste für die regelmäßige Kontrolle

Eine wiederkehrende Prüfung muss nicht kompliziert sein. Die folgende Checkliste eignet sich als monatlicher oder anlassbezogener Ablauf:

  1. Öffnen Sie die Sitemap oder den Sitemap-Index direkt und kontrollieren Sie die Erreichbarkeit.
  2. Prüfen Sie die XML-Syntax und achten Sie auf Fehlermeldungen.
  3. Überprüfen Sie stichprobenartig wichtige URLs auf Statuscode, Canonical und Indexierbarkeit.
  4. Suchen Sie nach Weiterleitungen, Fehlerseiten, gesperrten URLs und noindex-Seiten.
  5. Vergleichen Sie die Sitemap mit den wichtigsten Seitentypen der Website.
  6. Kontrollieren Sie, ob neue Inhalte erscheinen und entfernte Inhalte verschwinden.
  7. Bewerten Sie die Aussagekraft der Änderungsdaten.
  8. Prüfen Sie Sitemap-Index, robots.txt und Einreichungen in den Suchmaschinen-Tools.
  9. Dokumentieren Sie größere Änderungen, etwa nach einem Relaunch oder einer CMS-Umstellung.

Für Websites mit vielen Veröffentlichungen, häufigen Produktänderungen oder mehreren Sprachversionen kann eine automatisierte Überwachung sinnvoll sein. Lassen Sie dabei nicht nur die Verfügbarkeit, sondern auch Stichproben der URL-Qualität und auffällige Mengenänderungen prüfen.

FAQ

Wie oft sollte man eine Sitemap.xml prüfen?

Für eine stabile kleine Website genügt meist eine regelmäßige Kontrolle in größeren Abständen sowie eine Prüfung nach wichtigen technischen Änderungen. Bei häufig aktualisierten oder großen Websites ist eine laufende beziehungsweise monatliche Überwachung sinnvoll. Nach einem Relaunch, einer Migration oder einer Änderung des CMS sollte die Sitemap sofort kontrolliert werden.

Garantiert eine Sitemap die Indexierung aller enthaltenen URLs?

Nein. Eine Sitemap ist ein Hinweis auf bevorzugte URLs, aber keine Indexierungsgarantie. Suchmaschinen bewerten zusätzlich Qualität, Einzigartigkeit, interne Verlinkung, technische Erreichbarkeit und weitere Signale. Wenn viele URLs aus der Sitemap nicht indexiert werden, sollten Sie die Auswahl und den Nutzen dieser Seiten prüfen.

Sollten Seiten mit „noindex“ in der Sitemap stehen?

In der Regel nicht. Die Sitemap sollte möglichst konsistent mit Ihrem Indexierungsziel sein. Wenn eine URL bewusst mit noindex versehen wurde, gehört sie normalerweise nicht in die Liste der URLs, die Sie als indexierbar empfehlen.

Kann eine Sitemap zu groß sein?

Ja. XML-Sitemaps unterliegen technischen Grenzen für Dateigröße und URL-Anzahl. Große Websites sollten deshalb einen Sitemap-Index und mehrere einzelne Dateien verwenden. Unabhängig von der Dateigröße ist eine überfüllte Sitemap mit irrelevanten URLs auch inhaltlich problematisch.

Ist eine HTML-Sitemap besser als eine XML-Sitemap?

Beide Formate haben unterschiedliche Aufgaben. Eine HTML-Sitemap kann Besuchern und Suchmaschinen bei der Navigation helfen und die interne Verlinkung verbessern. Eine XML-Sitemap ist dagegen speziell für maschinenlesbare URL-Hinweise gedacht. Je nach Website können beide Varianten sinnvoll sein.

Was bedeutet es, wenn eine Sitemap nicht alle indexierten URLs enthält?

Das ist nicht automatisch ein Fehler. Suchmaschinen können URLs über Links oder andere Signale entdecken. Die Sitemap sollte sich auf Ihre bevorzugten und relevanten URLs konzentrieren. Wenn wichtige Seiten fehlen, sollten Sie jedoch die Generierungsregeln und die technische Abdeckung überprüfen.

Wie erkennt man falsche lastmod-Daten?

Vergleichen Sie die angegebenen Änderungsdaten mit dem tatsächlichen Redaktionsverlauf oder dem Inhalt der Seiten. Wenn viele URLs dasselbe aktuelle Datum erhalten, obwohl sich ihre Inhalte nicht geändert haben, ist die Datenquelle wahrscheinlich zu pauschal. In diesem Fall sollte die Generierung auf echte Inhaltsänderungen abgestimmt werden.

Fazit: Sitemap.xml prüfen und optimieren

Eine gute Sitemap.xml ist übersichtlich, technisch gültig und auf die wirklich wichtigen URLs konzentriert. Prüfen Sie nicht nur, ob die Datei erreichbar ist, sondern auch, ob ihre Einträge mit Canonical-Tags, Statuscodes, Indexierungsregeln und der tatsächlichen Website-Struktur übereinstimmen. Entfernen Sie Weiterleitungen, Fehlerseiten und irrelevante technische Varianten. Nutzen Sie einen Sitemap-Index, wenn die Website umfangreich ist, und behandeln Sie Änderungsdaten mit der nötigen Sorgfalt.

Die beste Wirkung entsteht im Zusammenspiel mit einer klaren Informationsarchitektur, sinnvoller interner Verlinkung und hochwertigen Inhalten. Wer die Sitemap nach größeren Änderungen und in regelmäßigen Abständen kontrolliert, schafft ein verlässliches technisches Signal und erkennt Probleme meist, bevor sie die Auffindbarkeit wichtiger Seiten beeinträchtigen.