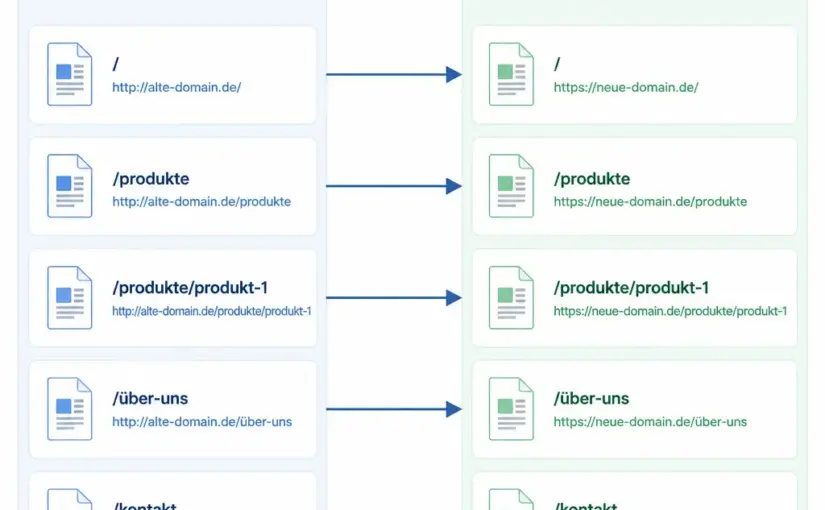
Domain-Weiterleitung richtig bewerten: Der umfassende Ratgeber

Eine Domain-Weiterleitung wirkt auf den ersten Blick wie eine einfache technische Einstellung: Eine Adresse wird auf eine andere URL verwiesen, und die Besucherinnen und Besucher landen am gewünschten Ziel. In der Praxis entscheidet jedoch die konkrete Konfiguration darüber, ob Suchmaschinen die Weiterleitung sinnvoll verstehen, alte Verweise erhalten bleiben und Nutzer nicht in unnötigen Schleifen oder auf falschen Seiten landen.

Wer eine Domain-Weiterleitung richtig bewerten möchte, sollte deshalb nicht nur prüfen, ob die Zielseite erreichbar ist. Entscheidend sind unter anderem der Zweck der Weiterleitung, der passende HTTP-Statuscode, die Zielstruktur, HTTPS, interne Verlinkungen, mögliche Weiterleitungsketten und die langfristige Pflege. Dieser Ratgeber zeigt, wie sich solche Weiterleitungen systematisch beurteilen lassen.

Was ist eine Domain-Weiterleitung?

Bei einer Domain-Weiterleitung wird eine aufgerufene Webadresse automatisch zu einer anderen Adresse geführt. Das kann eine komplette Domain, eine einzelne Unterseite oder eine Variante derselben Adresse betreffen. Typische Beispiele sind:

  • Eine alte Domain wird auf eine neue Domain weitergeleitet.
  • Die Variante mit www verweist auf die Variante ohne www oder umgekehrt.
  • Eine unverschlüsselte HTTP-Adresse wird auf HTTPS umgeleitet.
  • Eine umbenannte Unterseite wird auf ihre neue URL geführt.
  • Eine nicht mehr passende Kampagnen-URL wird auf eine aktuelle Zielseite verwiesen.

Technisch kommuniziert der Server dabei meist mit einem HTTP-Weiterleitungsstatus. Der Browser ruft zunächst die ursprüngliche Adresse auf, erhält die Information über das neue Ziel und lädt anschließend diese Zieladresse. Für Menschen ist der Vorgang oft kaum sichtbar. Für Suchmaschinen ist er jedoch ein wichtiges Signal zur Bewertung von URL-Änderungen und möglichen Inhaltsübereinstimmungen.

Warum die Bewertung mehr als einen Funktionstest erfordert
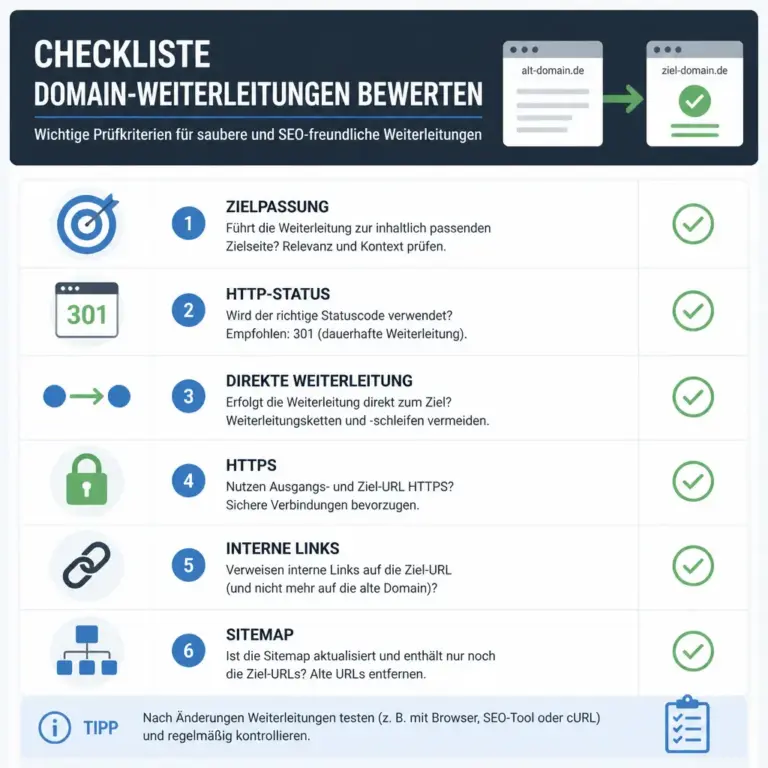
Checkliste zur systematischen Bewertung einer Domain-Weiterleitung
Diese Prüfpunkte helfen, eine Domain-Weiterleitung systematisch zu beurteilen.

Die Grafik fasst die wichtigsten Kontrollbereiche aus diesem Abschnitt auf einen Blick zusammen. Besonders wichtig ist, dass technische Funktion und inhaltliche Zielpassung gemeinsam geprüft werden.

Ein oberflächlicher Test beantwortet nur die Frage: „Kommt die Zielseite auf?“ Für eine belastbare Bewertung sind weitere Fragen notwendig:

  • Ist das Ziel fachlich und inhaltlich passend?
  • Wird der richtige Weiterleitungsstatus verwendet?
  • Funktioniert die Weiterleitung auf verschiedenen Geräten und mit unterschiedlichen URL-Varianten?
  • Entsteht eine Kette aus mehreren Weiterleitungen?
  • Bleiben wichtige alte Unterseiten und externe Verweise sinnvoll erreichbar?
  • Werden HTTPS, Canonical-Tags, interne Links und XML-Sitemaps konsistent eingesetzt?
  • Ist die Weiterleitung nur vorübergehend oder dauerhaft gedacht?

Eine Weiterleitung kann technisch funktionieren und trotzdem fachlich schlecht sein. So führt eine alte Produktseite möglicherweise auf die Startseite, obwohl eine thematisch passende Nachfolge-Seite existiert. Für Nutzer ist das verwirrend; für Suchmaschinen ist das Ziel unter Umständen kein gleichwertiger Ersatz. Domain-Weiterleitung richtig bewerten bedeutet daher, Technik, Inhalt und Nutzerführung gemeinsam zu betrachten.

Die wichtigsten Arten von Weiterleitungen

301: dauerhaft verschobene Adresse

Eine 301-Weiterleitung signalisiert, dass eine Adresse dauerhaft an einen neuen Ort umgezogen ist. Sie passt beispielsweise bei einem Domainwechsel, einer dauerhaften Änderung der URL-Struktur oder der Zusammenlegung zweier inhaltlich ähnlicher Seiten. Das Ziel sollte die bestmögliche inhaltliche Entsprechung sein, nicht automatisch die Startseite.

Eine dauerhafte Weiterleitung sollte erst eingerichtet werden, wenn die neue Zielstruktur feststeht. Häufige Zieländerungen lassen sich zwar technisch korrigieren, erzeugen aber zusätzliche Komplexität und erschweren die spätere Analyse.

302 und 307: vorübergehende Weiterleitung

Eine 302-Weiterleitung wird klassischerweise verwendet, wenn die ursprüngliche Adresse vorübergehend auf ein anderes Ziel führt. Ein Beispiel wäre eine zeitlich begrenzte Aktion, bei der die ursprüngliche Seite später wieder zurückkehren soll. Die 307-Variante bewahrt zusätzlich die HTTP-Methode und wird in bestimmten technischen Szenarien gezielt eingesetzt.

Für einen dauerhaften Domainumzug ist eine vorübergehende Weiterleitung normalerweise nicht die passende Wahl. Die Entscheidung sollte sich am tatsächlichen Zweck orientieren und nicht daran, welcher Statuscode im Verwaltungsbereich am leichtesten auszuwählen ist.

Meta-Refresh und JavaScript als Ausweichlösung

Weiterleitungen über HTML-Meta-Tags oder JavaScript können in Einzelfällen funktionieren, sind für grundlegende Domain- und URL-Umzüge aber meist nicht die erste Wahl. Sie sind stärker von der Verarbeitung im Browser abhängig und können die Nutzerführung sowie die technische Auswertung erschweren. Wenn der Server korrekt konfiguriert werden kann, ist eine serverseitige Weiterleitung in der Regel die klarere Lösung.

Domain-Weiterleitung richtig bewerten: Die zentrale Prüfliste

1. Ziel und Anlass eindeutig dokumentieren

Beginnen Sie mit einer kurzen Bestandsaufnahme. Welche Adresse soll weiterleiten, warum wird die Änderung vorgenommen und wie lange soll sie gelten? Ein Domainumzug, eine Markenänderung, eine technische Vereinheitlichung und eine saisonale Kampagne haben unterschiedliche Anforderungen.

Dokumentieren Sie mindestens die alte Adresse, die neue Adresse, den gewünschten Statuscode, den Starttermin, die verantwortliche Person oder Stelle sowie mögliche Ausnahmen. Bei vielen Unterseiten ist eine Zuordnungstabelle sinnvoll. Sie verhindert, dass alle alten Adressen pauschal auf ein einziges Ziel zeigen.

2. Inhaltliche Passung des Ziels prüfen

Die neue URL sollte die Erwartung erfüllen, die durch die alte URL ausgelöst wird. Eine alte Anleitung gehört möglichst zu einer aktualisierten Anleitung, eine frühere Produktseite zu einem passenden Nachfolgeprodukt und eine umbenannte Kategorieseite zur entsprechenden neuen Kategorie.

Existiert kein gleichwertiges Ziel mehr, kann eine verständliche Fehlerseite sinnvoller sein als eine erzwungene Weiterleitung auf die Startseite. Entscheidend ist, dass Besucher einen plausiblen nächsten Schritt erhalten. Die Startseite ist nur dann ein gutes Ziel, wenn sie die ursprüngliche Anfrage tatsächlich sinnvoll auffängt.

3. Statuscode und Dauer abgleichen

Prüfen Sie, ob die technische Kennzeichnung zur geplanten Dauer passt. Bei einem dauerhaften Umzug sollte ein dauerhafter Status verwendet werden; bei einer bewusst temporären Maßnahme ein vorübergehender. Die Auswahl sollte mit den Personen abgestimmt werden, die für Server, Website und Suchmaschinenoptimierung verantwortlich sind.

Besonders bei Hosting- oder Content-Management-Systemen lohnt sich ein Blick in die konkrete Konfiguration. Eine Oberfläche kann vereinfachte Begriffe verwenden, während im Hintergrund andere Regeln gelten. Entscheidend ist die tatsächlich ausgelieferte Serverantwort.

4. Weiterleitungsketten und Schleifen ausschließen

Eine Weiterleitungskette entsteht, wenn die alte URL zunächst auf Adresse B und anschließend auf Adresse C verweist. Noch problematischer ist eine Schleife, bei der sich zwei oder mehrere Adressen gegenseitig weiterleiten. Beides kann Ladezeiten erhöhen, Crawling erschweren und Besucher an der Zielseite hindern.

Das ideale Ziel ist eine direkte Verbindung von der ursprünglichen URL zur endgültigen Zieladresse. Überprüfen Sie auch ältere Regeln, die bei einem früheren Domain- oder Relaunch-Projekt angelegt wurden. Neue Regeln sollten nicht unbemerkt auf bestehende Zwischenziele treffen.

5. Alle relevanten Varianten testen

Eine Domain kann in mehreren Varianten aufgerufen werden. Prüfen Sie mindestens:

  • HTTP und HTTPS
  • mit und ohne www, sofern beide Varianten erreichbar sind
  • Groß- und Kleinschreibung bei Systemen, die dabei unterscheiden
  • alte Unterseiten mit unterschiedlichen Pfaden
  • URLs mit und ohne abschließenden Schrägstrich
  • Parameter, sofern diese für Tracking oder Funktion relevant sind

Der Test sollte nicht ausschließlich im Browser erfolgen. Browser können Antworten zwischenspeichern oder automatisch mehrere Schritte ausführen. Eine technische Prüfung der Antwortkette zeigt genauer, welcher Statuscode und welches Ziel tatsächlich ausgeliefert werden.

6. HTTPS und Zertifikate berücksichtigen

Bei einem Wechsel von HTTP zu HTTPS muss die verschlüsselte Zieladresse zuverlässig erreichbar sein. Das Zertifikat sollte zur Domain passen und darf nicht erst nach einem Warnhinweis im Browser greifen. Prüfen Sie außerdem, ob interne Ressourcen wie Bilder, Stylesheets oder Skripte ebenfalls über sichere URLs eingebunden werden.

Eine Weiterleitung von HTTP zu HTTPS ist nicht automatisch ausreichend, wenn anschließend einzelne Inhalte unsicher geladen werden oder die Website intern weiterhin auf alte HTTP-Adressen verlinkt. Die technische Umstellung sollte deshalb mit einer Bereinigung der internen Verweise verbunden werden.

7. Interne Links und Sitemaps aktualisieren

Weiterleitungen sind kein Ersatz für eine saubere interne Verlinkung. Nach einem Domain- oder URL-Wechsel sollten Navigation, Breadcrumbs, Footer-Links, Bilder, strukturierte Inhalte und redaktionelle Verweise direkt auf die neuen Adressen zeigen. Dadurch entstehen weniger zusätzliche Aufrufe und die Website bleibt leichter zu pflegen.

Auch XML-Sitemaps sollten nur die bevorzugten, erreichbaren Zieladressen enthalten. Alte URLs gehören normalerweise nicht als dauerhafte Einträge in eine aktuelle Sitemap, selbst wenn sie noch weiterleiten. Prüfen Sie außerdem Canonical-Tags, hreflang-Verweise und gegebenenfalls strukturierte Daten auf alte Domains oder Pfade.

Technische und inhaltliche Kriterien im Vergleich

Prüfbereich Gute Umsetzung Warnsignal
Zweck Der Anlass und die geplante Dauer sind dokumentiert. Niemand weiß, ob die Regel dauerhaft oder vorübergehend gedacht ist.
Zielseite Das Ziel passt inhaltlich zur alten Adresse. Viele unterschiedliche URLs landen pauschal auf der Startseite.
Statuscode Der Status entspricht der tatsächlichen Dauer der Änderung. Ein temporärer Status wird für einen dauerhaften Umzug verwendet.
Weiterleitungspfad Die alte URL führt direkt zum endgültigen Ziel. Mehrere Sprünge oder eine Schleife treten auf.
Protokoll HTTPS funktioniert ohne Warnung und wird intern konsequent verlinkt. Gemischte Inhalte oder Zertifikatsprobleme bleiben bestehen.
Pflege Regeln, Ausnahmen und Zuständigkeiten sind nachvollziehbar. Alte Regeln überschneiden sich oder werden nicht mehr geprüft.

Typische Fehler bei Domain-Weiterleitungen

Alle alten Adressen auf die Startseite leiten

Das ist schnell eingerichtet, aber selten die beste Lösung. Besucher verlieren den erwarteten Kontext, und die Startseite beantwortet die ursprüngliche Frage möglicherweise nicht. Besser ist eine individuelle Zuordnung zu passenden neuen Seiten. Nur wenn keine sinnvolle Entsprechung existiert, sollte die Startseite als allgemeines Ziel dienen.

Weiterleitungen mit widersprüchlichen Regeln kombinieren

Regeln können auf Serverebene, im Content-Management-System, beim Hosting und über zusätzliche Erweiterungen hinterlegt sein. Wenn mehrere Stellen dieselben URLs bearbeiten, entstehen schwer nachvollziehbare Ergebnisse. Führen Sie eine zentrale Liste und entfernen Sie veraltete oder doppelte Regeln.

Die Weiterleitung zu früh löschen

Bei einem dauerhaften Umzug sollten alte Adressen nicht unmittelbar nach der Umstellung entfernt werden. Externe Websites, Lesezeichen und Suchmaschineneinträge können noch auf die bisherigen URLs verweisen. Wie lange eine Regel benötigt wird, hängt vom Projekt, den Zugriffen und der Bedeutung der alten Adresse ab. Eine pauschale Frist ist deshalb nicht seriös anzugeben.

Nur die Startseite testen

Eine funktionierende Startseite sagt wenig über alte Unterseiten aus. Gerade wichtige Artikel, Produktseiten, Downloads oder Kampagnen-URLs müssen einzeln überprüft werden. Priorisieren Sie dabei Adressen mit vielen Zugriffen, wertvollen externen Verweisen oder hoher Bedeutung für den Geschäftsbetrieb.

Ein praxistauglicher Ablauf für die Prüfung

  1. Inventar erstellen: Sammeln Sie alte Domains, Unterseiten, Subdomains und relevante URL-Varianten.
  2. Ziele zuordnen: Legen Sie für jede wichtige alte Adresse ein passendes endgültiges Ziel fest.
  3. Regeln planen: Dokumentieren Sie Statuscode, Priorität, Ausnahmen und den geplanten Geltungsbereich.
  4. In einer kontrollierten Umgebung prüfen: Testen Sie Regeln, bevor sie auf einer stark besuchten Website aktiv werden.
  5. Technische Antworten kontrollieren: Prüfen Sie Statuscodes, Ziel-URLs, Ketten, Schleifen und Fehlerantworten.
  6. Website-Signale aktualisieren: Bereinigen Sie interne Links, Canonical-Tags, Sitemaps und gegebenenfalls Sprachverweise.
  7. Nach dem Start beobachten: Achten Sie auf Fehlermeldungen, ungewöhnliche Zugriffsmuster und nicht erwartete Zielseiten.
  8. Dokumentation pflegen: Halten Sie Änderungen, Ausnahmen und Verantwortlichkeiten aktuell.

Für eine belastbare Bewertung sollten sowohl einzelne Stichproben als auch eine automatisierte Prüfung des URL-Bestands stattfinden. Stichproben zeigen, ob die wichtigsten Fälle korrekt funktionieren. Eine vollständige Prüfung deckt zusätzlich vergessene Unterseiten und unerwartete Regelüberschneidungen auf.

Wann ist professionelle Unterstützung sinnvoll?

Bei wenigen, klaren URLs lässt sich die Prüfung oft mit überschaubarem Aufwand durchführen. Unterstützung ist besonders sinnvoll, wenn mehrere Domains, Subdomains, Sprachversionen oder große URL-Bestände beteiligt sind. Auch bei einem Wechsel des Content-Management-Systems, einer komplexen Shop-Struktur oder vielen historischen Weiterleitungsregeln kann eine unabhängige Prüfung Risiken reduzieren.

Wichtig ist, dass nicht nur eine technische Liste von Statuscodes geliefert wird. Eine gute Bewertung berücksichtigt auch die inhaltliche Zuordnung, die interne Verlinkung, die Messbarkeit und die Frage, ob Besucher am Ziel tatsächlich weiterkommen. Lassen Sie sich die Regeln, Annahmen und offenen Risiken verständlich dokumentieren.

FAQ

Was ist der wichtigste Punkt bei einer Domain-Weiterleitung?

Die Zielseite muss fachlich zur alten Adresse passen. Zusätzlich müssen Statuscode, Weiterleitungsdauer und technische Umsetzung zusammenpassen. Eine Weiterleitung ist nicht gut, nur weil sie im Browser funktioniert.

Ist eine Weiterleitung auf die Startseite immer falsch?

Nein. Sie kann sinnvoll sein, wenn es kein passendes Unterseiten-Ziel gibt und die Startseite die Anfrage verständlich auffängt. Bei zahlreichen thematisch unterschiedlichen alten URLs ist sie jedoch meist keine gute Standardlösung.

Welcher Statuscode passt zu einem Domainumzug?

Bei einem dauerhaft geplanten Umzug wird üblicherweise ein dauerhafter Weiterleitungsstatus verwendet. Für eine vorübergehende Maßnahme kommt ein temporärer Status infrage. Entscheidend ist der tatsächliche Zweck der Regel, nicht die Bezeichnung im Verwaltungsmenü.

Wie erkenne ich eine Weiterleitungskette?

Sie verfolgen die Antwort der alten URL Schritt für Schritt bis zum endgültigen Ziel. Wenn zunächst eine Zwischenadresse geladen wird, liegt eine Kette vor. Am übersichtlichsten ist eine technische Prüfung, die alle Statusantworten und Zieladressen sichtbar macht.

Sollten alte URLs in der XML-Sitemap bleiben?

Eine aktuelle Sitemap sollte normalerweise die bevorzugten, direkt erreichbaren Zieladressen enthalten. Alte URLs, die nur weiterleiten, gehören in der Regel nicht als reguläre Einträge hinein. Die endgültige Entscheidung sollte zur gesamten Website- und Umzugsstrategie passen.

Wie lange sollte eine Weiterleitung bestehen bleiben?

Das hängt von der Bedeutung der alten Adresse, den Zugriffen, externen Verweisen und dem Projektumfang ab. Eine wichtige alte Domain oder Unterseite sollte nicht vorschnell entfernt werden. Prüfen Sie regelmäßig, ob noch relevante Zugriffe oder Verweise vorhanden sind.

Kann eine Weiterleitung die Suchmaschinenoptimierung beeinflussen?

Ja. Statuscode, Zielqualität, Ketten, widersprüchliche Canonical-Tags und eine uneinheitliche interne Verlinkung können die Verarbeitung von URL-Änderungen erschweren. Eine saubere, direkte und inhaltlich passende Weiterleitung unterstützt eine nachvollziehbare Website-Struktur, ersetzt aber keine vollständige technische Prüfung.

Fazit: Domain-Weiterleitung richtig bewerten

Eine gute Domain-Weiterleitung verbindet die richtige alte Adresse direkt mit einem passenden neuen Ziel. Für die Bewertung zählen deshalb nicht nur Erreichbarkeit und Geschwindigkeit, sondern auch Zweck, Statuscode, inhaltliche Nähe, HTTPS, interne Links, Sitemaps und die langfristige Pflege.

Wer zunächst ein URL-Inventar erstellt, Ziele sauber zuordnet, Ketten und Schleifen ausschließt und die wichtigsten Varianten technisch prüft, schafft eine verlässliche Grundlage. Nach der Umstellung sollten Fehler und Zugriffe weiter beobachtet werden. So wird aus einer scheinbar kleinen Serverregel eine nachvollziehbare und nutzerfreundliche Lösung.
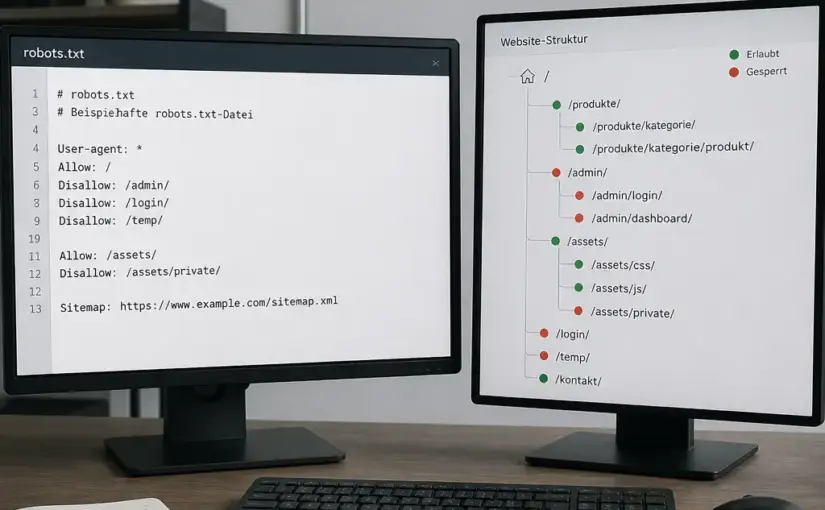
robots.txt prüfen und verstehen: Der umfassende Ratgeber für Website-Betreiber

Die Datei robots.txt gehört zu den kleinsten, aber häufig missverstandenen Bestandteilen einer Website. Sie kann Suchmaschinen-Crawlern Hinweise geben, welche Bereiche sie abrufen dürfen und welche nicht. Gleichzeitig ist sie weder ein sicherer Zugriffsschutz noch eine Garantie dafür, dass Seiten aus dem Suchindex verschwinden. Wer die Datei richtig einordnet, kann Crawling-Ressourcen gezielter steuern, typische SEO-Fehler vermeiden und technische Probleme schneller erkennen.

Dieser Ratgeber zeigt, wie Sie robots.txt prüfen und verstehen, welche Direktiven relevant sind, wie Sie die Datei testen und welche Grenzen sie hat. Die Beispiele sind bewusst allgemein gehalten, damit Sie die Regeln auf unterschiedliche Content-Management-Systeme und Hosting-Umgebungen übertragen können.

Was ist eine robots.txt?

Die Datei robots.txt ist eine einfache Textdatei im Hauptverzeichnis einer Website. Sie ist normalerweise unter dieser Adresse erreichbar:

https://www.beispiel.de/robots.txt

Ein Crawler ruft diese Datei ab, bevor er weitere URLs derselben Website crawlt. Darin können Regeln stehen, die sich an bestimmte Crawler oder an alle Crawler richten. Die Regeln beziehen sich vor allem darauf, welche Pfade ein Crawler abrufen soll oder nicht abrufen soll.

Wichtig ist die Unterscheidung zwischen Crawling und Indexierung. Crawling bedeutet, dass ein Bot eine URL abruft und ihren Inhalt verarbeitet. Indexierung bedeutet, dass eine Suchmaschine eine URL in ihren Suchindex aufnimmt und sie möglicherweise in den Suchergebnissen anzeigt. Eine Sperre in der robots.txt verhindert in erster Linie den Abruf. Sie ist keine zuverlässige Anweisung, eine bereits bekannte URL aus dem Index zu entfernen.

Die Datei ist öffentlich. Jeder kann sie aufrufen und ihren Inhalt lesen. Deshalb sollten Sie dort keine vertraulichen Verzeichnisse, internen Projektnamen oder Hinweise auf sensible Systembereiche aufführen, wenn diese Informationen nicht öffentlich sichtbar sein sollen.

Warum sollte man robots.txt prüfen und verstehen?

Eine fehlerhafte robots.txt kann dazu führen, dass wichtige Inhalte, Produktseiten, Kategorien oder JavaScript- und CSS-Dateien nicht wie erwartet gecrawlt werden. Ein versehentlich gesetztes Disallow: / würde beispielsweise den gesamten Abruf einer Website für den betroffenen Crawler blockieren. Umgekehrt kann eine sehr großzügige Konfiguration unnötige URL-Varianten, Suchergebnisse oder Filterkombinationen crawlen lassen.

Die Prüfung ist besonders sinnvoll, wenn eine Website neu veröffentlicht, migriert oder technisch umgebaut wurde. Auch nach Änderungen am Shopsystem, an einem SEO-Plugin, an der Domainstruktur oder an wichtigen Verzeichnissen lohnt sich ein Blick auf die Datei. Sie sollten außerdem kontrollieren, ob die Datei tatsächlich unter der richtigen Domain und mit dem erwarteten Statuscode erreichbar ist.

Typische Ziele einer Prüfung

  • prüfen, ob wichtige Inhalte versehentlich gesperrt werden;
  • unnötige Crawling-Pfade wie interne Suchseiten oder bestimmte Parameter begrenzen;
  • unbeabsichtigte Unterschiede zwischen www-, nicht-www-, HTTP- und HTTPS-Versionen erkennen;
  • eine Sitemap-URL korrekt bekannt machen;
  • Syntaxfehler und widersprüchliche Regeln identifizieren;
  • feststellen, ob eine robots.txt fälschlich als Zugriffsschutz verwendet wird.

Die wichtigsten Bestandteile einer robots.txt

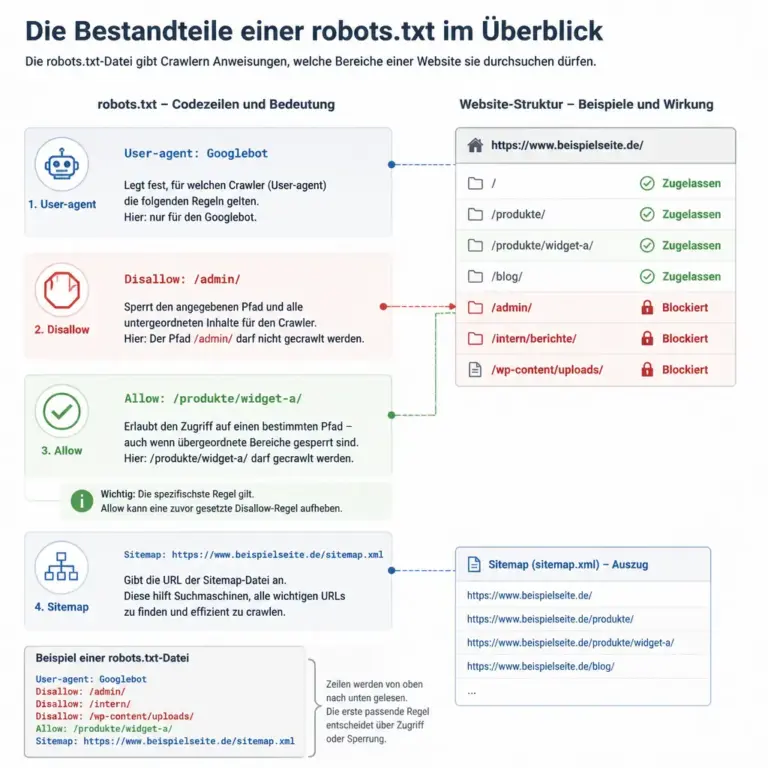
Die wichtigsten Direktiven einer robots.txt im u00dcberblick
Diese Übersicht zeigt, wie zentrale robots.txt-Direktiven zusammenspielen.

Achten Sie auf die Zuordnung zwischen einer Direktive und dem jeweiligen Pfad. Die Darstellung macht sichtbar, dass eine Regel nicht isoliert, sondern immer im Zusammenhang mit dem angesprochenen Crawler gelesen werden sollte.

Eine robots.txt besteht aus einzelnen Anweisungen. Die wichtigsten Elemente sind User-agent, Disallow, Allow und Sitemap. Leerzeilen werden häufig verwendet, um Regelgruppen übersichtlich voneinander zu trennen. Kommentare beginnen mit einem Doppelkreuz und werden von unterstützenden Crawlern ignoriert.

User-agent

Mit User-agent legen Sie fest, für welchen Crawler eine nachfolgende Regelgruppe gilt. Mit dem Sternchen sprechen Sie alle Crawler an:

User-agent: *

Daneben können einzelne Crawler gezielt angesprochen werden. Das ist jedoch nur sinnvoll, wenn Sie einen konkreten technischen Grund haben und genau wissen, wie der jeweilige Crawler seine Regeln verarbeitet. Unterschiedliche Suchmaschinen oder Spezial-Crawler können eigene Bezeichnungen und eigene Interpretationen verwenden.

Disallow

Disallow kennzeichnet einen Pfad, den der betreffende Crawler nicht abrufen soll. Ein leerer Wert bedeutet normalerweise, dass kein Pfad gesperrt wird:

User-agent: *
Disallow:

Ein Pfad mit einem abschließenden Schrägstrich bezieht sich typischerweise auf diesen Verzeichnisbereich und seine Unterpfade:

User-agent: *
Disallow: /admin/

Das ist nicht dasselbe wie ein sicherer Schutz des Verzeichnisses. Der Server kann die angeforderte Ressource weiterhin ausliefern, wenn jemand die URL direkt aufruft.

Allow

Allow kann verwendet werden, um innerhalb eines gesperrten Bereichs einen bestimmten Pfad wieder freizugeben. Die genaue Auswertung kann von der Crawler-Implementierung und von konkurrierenden Regeln abhängen. Deshalb sollten Ausnahmen möglichst klar und sparsam formuliert werden.

User-agent: *
Disallow: /intern/
Allow: /intern/oeffentliches-dokument.pdf

Wenn Regeln kompliziert werden, ist es oft besser, die URL-Struktur oder die technische Auslieferung zu vereinfachen. Eine kurze, verständliche Datei ist leichter zu warten als eine Sammlung vieler Ausnahmen.

Sitemap

Mit Sitemap können Sie Suchmaschinen auf eine XML-Sitemap hinweisen. Die vollständige absolute URL ist empfehlenswert:

Sitemap: https://www.beispiel.de/sitemap.xml

Eine Sitemap ist keine Erlaubnis zum Crawlen und ersetzt auch keine interne Verlinkung. Sie liefert lediglich eine zusätzliche Quelle für URLs, die eine Suchmaschine prüfen kann. In einer robots.txt können auch mehrere Sitemap-URLs angegeben werden, etwa wenn eine Website getrennte Sitemaps für Beiträge, Produkte und Kategorien verwendet.

So prüfen Sie Ihre robots.txt Schritt für Schritt

1. Die richtige Datei aufrufen

Rufen Sie die Datei direkt auf der betreffenden Host- und Protokollvariante auf. Eine robots.txt für https://www.beispiel.de gilt nicht automatisch für eine separate Subdomain wie https://shop.beispiel.de. Ebenso sollten Sie Weiterleitungen, unterschiedliche Domains und mögliche Staging-Umgebungen kontrollieren.

Prüfen Sie, ob die Antwort tatsächlich eine Textdatei mit den erwarteten Regeln ist. Eine HTML-Fehlerseite, ein Login, ein Serverfehler oder eine unerwartete Weiterleitung kann die Funktion beeinträchtigen. Eine temporäre Nichterreichbarkeit ist anders zu bewerten als eine bewusst leere Datei.

2. Inhalt und Format kontrollieren

Die Datei sollte gut lesbar sein und pro Zeile eine Anweisung enthalten. Achten Sie auf Tippfehler bei den Direktiven, überflüssige Leerzeichen, nicht beabsichtigte Sonderzeichen und Pfade, die nicht zur aktuellen Website-Struktur passen. Kommentare können erklären, warum eine Regel existiert und wer sie bei Änderungen überprüfen sollte.

Ein einfacher Anfang kann so aussehen:

User-agent: *
Disallow: /interne-suche/
Disallow: /konto/
Disallow: /warenkorb/
Sitemap: https://www.beispiel.de/sitemap.xml

Ob diese Regeln sinnvoll sind, hängt von Ihrer Website ab. Bei einer redaktionellen Website gibt es andere technische Bereiche als in einem Onlineshop. Übernehmen Sie Beispiele deshalb nicht blind.

3. Jede Regel auf wichtige URLs anwenden

Erstellen Sie eine kleine Liste wichtiger URL-Typen: Startseite, redaktioneller Beitrag, Produktseite, Kategorie, Bild- oder Dokumentseite sowie gegebenenfalls eine paginierte Übersichtsseite. Prüfen Sie anschließend, ob ein Disallow-Muster diese Pfade berührt. Besonders gefährlich sind sehr allgemeine Muster wie ein gesperrter Ordnername, der auch wichtige Inhalte enthält.

Denken Sie außerdem an Verzeichnisse für Ressourcen. Eine Suchmaschine muss nicht jede technische Datei indexieren, benötigt aber gegebenenfalls Zugriff auf Ressourcen, um eine Seite zu rendern und ihre Inhalte richtig zu verstehen. Sperren Sie CSS-, JavaScript- oder Bildpfade daher nicht pauschal, ohne die Auswirkungen zu prüfen.

4. Mit einem geeigneten Testwerkzeug nachprüfen

Für eine zusätzliche Kontrolle können Sie die Prüf- und Berichtsfunktionen der jeweiligen Suchmaschinen-Tools verwenden, sofern sie für Ihre Property verfügbar sind. Solche Werkzeuge helfen dabei, einzelne URLs gegen eine veröffentlichte robots.txt zu beurteilen. Sie ersetzen jedoch nicht die manuelle Prüfung der Datei und der tatsächlichen Serverantwort.

Testen Sie nicht nur eine Muster-URL. Ein erfolgreicher Test für eine Produktseite sagt wenig aus, wenn beispielsweise alle Kategorieseiten oder die Sitemap blockiert sind. Prüfen Sie repräsentative URL-Typen und wiederholen Sie die Kontrolle nach jeder Änderung.

Häufige Fehler und ihre Folgen

Die gesamte Website versehentlich sperren

Diese Regel ist besonders weitreichend:

User-agent: *
Disallow: /

Sie kann in einer Entwicklungsumgebung sinnvoll sein, ist für eine öffentlich auffindbare Produktionswebsite aber meist problematisch. Ein häufiger Fehler besteht darin, diese Einstellung beim Wechsel von Staging zu Live zu übernehmen. Kontrollieren Sie deshalb nach einem Launch sofort die robots.txt und wichtige URLs.

Wichtige Verzeichnisse blockieren

Ein Pfad wie /blog/, /content/ oder /produkte/ kann je nach Website zentrale Inhalte enthalten. Auch scheinbar technische Ordner können Bilder, Skripte oder andere Ressourcen bereitstellen. Prüfen Sie zuerst, welche Dateien und URL-Typen tatsächlich darunter liegen.

robots.txt mit noindex verwechseln

Die robots.txt ist kein zuverlässiger Ersatz für eine noindex-Anweisung. Wenn eine Suchmaschine eine URL nicht abrufen darf, kann sie deren Inhalt und ein dort gesetztes noindex unter Umständen nicht lesen. Für die Indexierungssteuerung müssen Sie die passende Methode verwenden, beispielsweise ein Robots-Meta-Element oder einen entsprechenden HTTP-Header, sofern der Crawler die Seite abrufen darf.

Wenn eine bereits indexierte URL dauerhaft aus den Suchergebnissen verschwinden soll, sind je nach Fall andere Maßnahmen erforderlich. Dazu gehören die korrekte Indexierungsanweisung, die Entfernung oder Weiterleitung des Inhalts und gegebenenfalls die Nutzung von Funktionen zur vorübergehenden Entfernung in den Webmaster-Werkzeugen.

Interne Suchseiten und Parameter unüberlegt blockieren

Interne Suchseiten, Sortierungen und Filter können eine große Zahl ähnlicher URLs erzeugen. Das kann ein berechtigter Anlass sein, bestimmte Pfade zu begrenzen. Eine pauschale Sperre nach einem allgemeinen Parameterzeichen kann jedoch auch wertvolle URLs treffen. Prüfen Sie zuerst, welche Parameter tatsächlich vorkommen und ob sie für Nutzer oder Suchmaschinen relevante Inhalte erzeugen.

Die Sitemap falsch eintragen

Eine Sitemap-Angabe mit Tippfehler, falscher Domain oder nicht erreichbarer Datei hilft nicht weiter. Die Sitemap sollte auf eine gültige, öffentlich abrufbare XML-Datei zeigen. Achten Sie bei mehreren Sprach- oder Domainvarianten darauf, dass die URL zur jeweiligen Website gehört und die enthaltenen URLs zur richtigen Property passen.

robots.txt als Zugriffsschutz: Was sie nicht kann

Die Datei richtet sich an kooperative Crawler. Sie verhindert nicht, dass Menschen eine URL aufrufen, und sie hält keinen böswilligen Bot zuverlässig auf. Auch sensible Daten, Backups, Zugangsdaten, interne Dokumente oder Verwaltungsoberflächen gehören nicht lediglich durch eine robots.txt geschützt ins Internet.

Für vertrauliche Bereiche benötigen Sie eine serverseitige Zugriffskontrolle, beispielsweise Authentifizierung, geeignete Berechtigungen oder eine Beschränkung auf ein internes Netzwerk. Zusätzlich sollten sensible Dateien gar nicht erst öffentlich gespeichert werden. Eine robots.txt darf höchstens ergänzend eingesetzt werden, nicht als Sicherheitsmaßnahme.

Beachten Sie auch, dass gesperrte URLs unter Umständen trotzdem bekannt werden können, etwa durch externe Verweise. Suchmaschinen können dann möglicherweise die URL, aber nicht den Inhalt anzeigen. Daraus folgt: Eine Sperre kann Sichtbarkeit nicht in jedem Fall verhindern.

Praktische Entscheidungsregeln für die eigene Website

Bevor Sie eine neue Regel hinzufügen, beantworten Sie einige konkrete Fragen:

  1. Welches Problem soll gelöst werden? Benennen Sie den konkreten URL-Bereich oder das Crawling-Problem.
  2. Welche URLs sind betroffen? Prüfen Sie echte Beispieladressen und nicht nur die Ordnerbezeichnung.
  3. Soll der Inhalt nicht gecrawlt oder nicht indexiert werden? Wählen Sie die Maßnahme nach dem Ziel aus.
  4. Ist die Sperre für alle Crawler notwendig? Eine allgemeine Regel ist weitreichender als eine gezielte Regel.
  5. Wie wird die Änderung kontrolliert? Legen Sie fest, welche URLs nach der Veröffentlichung getestet werden.
  6. Wer pflegt die Datei? Dokumentieren Sie Verantwortlichkeit und Anlass der Regel, damit sie nicht dauerhaft aus Gewohnheit bestehen bleibt.

In vielen Fällen ist eine saubere interne Verlinkung, eine konsistente URL-Struktur und eine korrekte Indexierungssteuerung nachhaltiger als eine lange Liste von Sperren. Die robots.txt sollte ein gezieltes technisches Werkzeug bleiben.

robots.txt nach einem Relaunch oder Domainwechsel prüfen

Bei einem Relaunch ändern sich häufig Verzeichnisse, Parameter, Weiterleitungen und Sitemap-Adressen gleichzeitig. Führen Sie die Prüfung deshalb als festen Bestandteil der technischen Abnahme durch. Kontrollieren Sie die Datei auf der produktiven Domain, testen Sie die wichtigsten URL-Typen und stellen Sie sicher, dass die Sitemap aktualisiert wurde.

Vergleichen Sie die neue Version mit der alten Datei, aber übernehmen Sie nicht automatisch jede historische Regel. Eine frühere Sperre kann für die neue Struktur falsch sein. Prüfen Sie außerdem, ob ein temporärer Schutz aus der Entwicklungsphase entfernt wurde und ob die Domain nicht versehentlich auf eine fremde oder nicht öffentliche Sitemap verweist.

Nach dem Launch sollten Sie die Berichte der Suchmaschinen beobachten. Ein einzelner Hinweis ist nicht immer ein Beweis für einen Fehler, aber wiederkehrende Crawling- oder Indexierungsprobleme verdienen eine genaue Untersuchung der betroffenen URLs, Serverantworten, Canonicals und robots.txt-Regeln.

FAQ

Wo muss die robots.txt liegen?

Sie gehört in das Hauptverzeichnis der jeweiligen Host- und Protokollvariante und sollte unter /robots.txt erreichbar sein. Eine Datei in einem Unterordner gilt nicht automatisch für die gesamte Domain. Für Subdomains muss die Konfiguration separat betrachtet werden.

Kann robots.txt eine Seite aus Google entfernen?

Eine Sperre verhindert in erster Linie den Abruf und ist keine zuverlässige Entfernung aus dem Index. Für eine kontrollierte Indexierung benötigen Sie eine passende Maßnahme, die der Crawler lesen kann, oder eine andere geeignete Entfernung beziehungsweise Deindexierung im jeweiligen Fall.

Ist eine leere robots.txt problematisch?

Eine leere Datei bedeutet üblicherweise, dass keine Pfade ausdrücklich gesperrt werden. Das kann für eine kleine Website völlig in Ordnung sein. Entscheidend ist, ob die Website besondere Crawling-Probleme hat und ob andere technische Maßnahmen die gewünschten Signale liefern.

Sollte ich CSS und JavaScript sperren?

Eine pauschale Sperre ist meist keine gute Idee. Suchmaschinen können Ressourcen benötigen, um Layout und Inhalte einer Seite zu verstehen. Prüfen Sie einzelne Pfade und sperren Sie nur Bereiche, deren Abruf tatsächlich unnötig ist und keine wichtige Darstellung oder Funktionsweise beeinflusst.

Wie oft sollte man robots.txt prüfen?

Eine feste monatliche Pflicht gibt es nicht. Sinnvoll ist eine Prüfung bei Relaunches, Migrationen, Änderungen am Shopsystem, Wechseln von SEO-Erweiterungen und auffälligen Crawling- oder Indexierungsdaten. Zusätzlich kann eine regelmäßige technische Checkliste helfen, unbemerkte Änderungen zu erkennen.

Kann ich mit robots.txt schädliche Bots blockieren?

Nur kooperative Bots können die Datei freiwillig beachten. Für unerwünschten oder missbräuchlichen Traffic benötigen Sie serverseitige oder vorgeschaltete Schutzmechanismen. Die robots.txt sollte nicht als Sicherheits- oder Lastschutz betrachtet werden.

Was bedeutet ein Pfad mit Schrägstrich am Ende?

Ein abschließender Schrägstrich beschreibt üblicherweise einen Verzeichnisbereich und seine Unterpfade. Ob ein konkretes Muster eine URL erfasst, hängt jedoch von der Schreibweise und der Auswertung des Crawlers ab. Testen Sie daher reale Beispiel-URLs, insbesondere bei ähnlichen Pfaden.

Fazit: robots.txt systematisch prüfen

Wer robots.txt prüfen und verstehen möchte, sollte nicht nur nach einer einzelnen fehlerhaften Zeile suchen. Entscheidend ist das Zusammenspiel aus URL-Struktur, Crawling, Indexierung, Ressourcen, Sitemaps und Zugriffsschutz. Rufen Sie die Datei auf der richtigen Domain auf, lesen Sie jede Regel im Kontext, testen Sie wichtige URL-Typen und dokumentieren Sie bewusst gesetzte Ausnahmen.

Eine gute robots.txt ist nicht möglichst lang, sondern nachvollziehbar und zielgerichtet. Verwenden Sie sie für begrenzte Crawling-Steuerung, aber nicht für vertrauliche Daten oder als Ersatz für noindex. Nach technischen Änderungen sollte die Prüfung Teil der Abnahme sein. So erkennen Sie verhinderte Crawling-Zugriffe früh und schaffen eine verlässlichere Grundlage für die technische Suchmaschinenoptimierung.