Das Meta-Tag noindex ist ein präzises Werkzeug für die Suchmaschinenoptimierung. Es teilt Suchmaschinen mit, dass eine bestimmte Seite nicht in den Suchergebnissen erscheinen soll. Richtig eingesetzt, hilft es dabei, dünne, doppelte oder intern wenig hilfreiche Inhalte aus dem Suchindex herauszuhalten. Falsch eingesetzt, kann es jedoch wichtige Seiten unsichtbar machen.
In diesem Ratgeber erfahren Sie, wann Noindex richtig verwenden sinnvoll ist, wie sich noindex von robots.txt und einem Canonical-Tag unterscheidet und wie Sie die Einstellung in WordPress kontrolliert umsetzen. Außerdem finden Sie eine praktische Prüfliste, typische Fehler und Antworten auf häufige Fragen.
Was bedeutet „noindex“?
noindex ist eine Anweisung im HTML-Code einer Seite oder im HTTP-Header. Sie richtet sich an Suchmaschinen-Crawler und bedeutet sinngemäß: Diese URL soll nicht in den Suchergebnissen gelistet werden.
Die häufigste Variante steht im <head>-Bereich des Dokuments:
<meta name="robots" content="noindex, follow">Die Kombination noindex, follow verhindert die Aufnahme der Seite in den Index, erlaubt aber grundsätzlich weiterhin das Verfolgen von Links auf dieser Seite. Alternativ kann eine Seite mit noindex, nofollow versehen werden. Damit wird zusätzlich signalisiert, dass Links auf der Seite nicht verfolgt werden sollen.
Für die meisten redaktionellen Anwendungsfälle ist noindex, follow die differenziertere Einstellung. Sie sollten nofollow nicht pauschal ergänzen, nur weil eine Seite selbst nicht indexiert werden soll.
Wann ist Noindex sinnvoll?
Noindex eignet sich für URLs, die technisch erreichbar oder intern nützlich sind, aber keinen eigenständigen Wert für Suchende haben. Entscheidend ist nicht, ob eine Seite existiert, sondern ob sie als eigenständiges Suchergebnis hilfreich wäre.
Typische Anwendungsfälle
- Interne Suchergebnisse: Suchseiten mit frei kombinierbaren Suchbegriffen liefern häufig wechselnde oder sehr ähnliche Inhalte.
- Filter- und Sortier-URLs: Parameter wie Farbe, Größe, Sortierung oder Ansicht können zahlreiche Varianten derselben Seite erzeugen.
- Doppelte Archivseiten: Datums-, Autoren- oder Schlagwortarchive sind nicht automatisch problematisch, können aber bei geringer eigener Aussagekraft entbehrlich sein.
- Interne Hilfsseiten: Bestellbestätigungen, Warenkörbe, Login-Seiten oder bestimmte Kontoansichten sind normalerweise keine sinnvollen öffentlichen Suchergebnisse.
- Test- und Übergangsseiten: Vor der Veröffentlichung kann eine Seite vorübergehend aus dem Suchindex herausgehalten werden.
- Inhalte mit sehr geringem eigenständigem Nutzen: Dazu können automatisch erzeugte Übersichten oder fast leere Taxonomien gehören.
Die Entscheidung sollte immer URL für URL oder anhand einer klar definierten Regel getroffen werden. Eine pauschale Noindex-Regel für ganze Verzeichnisse oder Inhaltstypen kann leicht wertvolle Seiten erfassen.
Noindex, robots.txt und Canonical im Vergleich
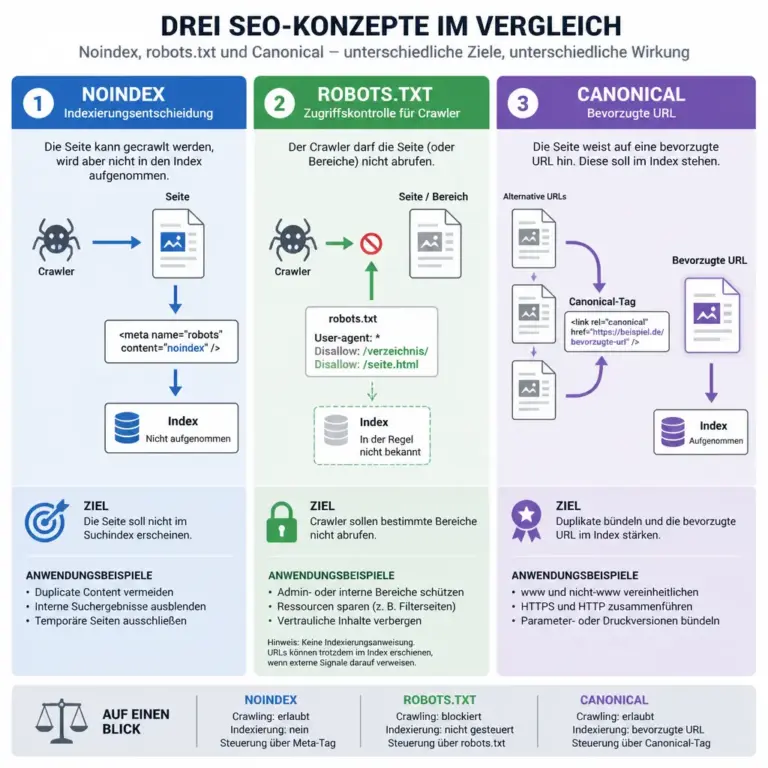
Die Grafik macht sichtbar, dass Noindex, robots.txt und Canonical nicht austauschbar sind. Besonders wichtig ist die Trennung zwischen Zugriff auf eine URL und ihrer Aufnahme in den Suchindex.
Diese drei SEO-Maßnahmen werden häufig verwechselt, verfolgen aber unterschiedliche Ziele. Eine gute technische Strategie beginnt damit, ihre Funktionen sauber zu trennen.
| Maßnahme | Hauptzweck | Wichtiger Hinweis |
|---|---|---|
noindex |
Eine URL soll nicht in den Suchindex aufgenommen oder dort entfernt werden. | Die Suchmaschine muss die Anweisung abrufen können, um sie zuverlässig zu sehen. |
robots.txt |
Crawler sollen bestimmte Bereiche möglichst nicht abrufen. | Eine blockierte URL kann dadurch daran gehindert werden, ein Noindex-Signal auszulesen. |
| Canonical | Eine bevorzugte URL unter mehreren ähnlichen oder doppelten Varianten angeben. | Ein Canonical ist ein Hinweis, keine Garantie für die Auswahl durch die Suchmaschine. |
Wenn eine URL sicher nicht indexiert werden soll, darf sie nicht zugleich in der robots.txt blockiert sein, sofern die Suchmaschine das Noindex-Signal noch auslesen muss. Die beiden Maßnahmen lösen unterschiedliche Probleme: Die Datei robots.txt steuert den Zugriff, während noindex die Indexierung betrifft.
Ein Canonical ist dagegen oft besser geeignet, wenn mehrere URL-Varianten denselben wichtigen Inhalt darstellen und eine Hauptversion in den Suchergebnissen erscheinen soll. Noindex wäre in diesem Fall möglicherweise zu streng, weil damit auch eine eigenständige Suchintention verloren gehen kann.
Noindex richtig verwenden: Entscheidungskriterien
Bevor Sie eine Seite auf Noindex setzen, helfen einige konkrete Fragen. Sie verhindern, dass die Einstellung nur als schnelle Lösung für ein ungeklärtes Strukturproblem dient.
1. Hat die URL eine eigene Suchintention?
Prüfen Sie, ob Nutzer nach genau diesem Inhalt suchen könnten und ob die Seite diese Erwartung erfüllt. Eine eigenständige Kategorie mit verständlicher Beschreibung kann wertvoll sein. Eine automatisch erzeugte Kombination aus drei Filtern ist dagegen oft kein sinnvolles Ziel für die organische Suche.
2. Ist der Inhalt ausreichend vollständig?
Eine kurze Seite ist nicht automatisch schlecht. Problematisch wird es, wenn sie die Frage des Nutzers nicht beantwortet, fast ausschließlich aus Navigation besteht oder nur minimale Unterschiede zu vielen anderen URLs aufweist. In manchen Fällen ist eine Überarbeitung die bessere Lösung als Noindex.
3. Gibt es eine bessere Haupt-URL?
Wenn mehrere Seiten denselben Zweck erfüllen, sollten Sie entscheiden, ob eine URL gestärkt und die anderen zusammengeführt, per Canonical bevorzugt oder aus dem Index ausgeschlossen werden sollen. Noindex ist nicht automatisch die richtige Maßnahme gegen jede Form von Duplicate Content.
4. Brauchen Besucher diese Seite direkt?
Eine nicht indexierte Seite kann weiterhin über interne Links, Lesezeichen oder direkte Verweise erreichbar sein. Das ist bei Konto-, Warenkorb- oder Bestätigungsseiten sinnvoll. Prüfen Sie aber, ob sensible Inhalte wirklich angemessen geschützt sind: Noindex ist kein Zugriffsschutz.
5. Soll die Einstellung dauerhaft gelten?
Bei einer temporären Baustelle ist es wichtig, später eine Wiedervorlage einzuplanen. Bei dauerhaft unnötigen URLs können Sie zusätzlich die interne Verlinkung, URL-Struktur oder Erzeugungslogik verbessern.
Noindex in WordPress umsetzen
In WordPress wird Noindex meist über ein SEO-Plugin, die Einstellungen des jeweiligen Inhaltstyps oder eine individuelle technische Konfiguration gesetzt. Die genaue Bezeichnung kann je nach Plugin und Version abweichen. Suchen Sie nach Optionen wie „Suchmaschinen erlauben, diesen Beitrag in den Suchergebnissen anzuzeigen?“ oder „Indexierung erlauben“.
Einzelne Seite oder einzelnen Beitrag ausschließen
- Öffnen Sie den betreffenden Beitrag oder die Seite im WordPress-Editor.
- Rufen Sie die SEO-Einstellungen des Dokuments auf.
- Deaktivieren Sie die Option, die eine Indexierung erlaubt, beziehungsweise wählen Sie „noindex“.
- Speichern oder aktualisieren Sie den Inhalt.
- Rufen Sie den Quelltext der veröffentlichten URL auf und suchen Sie nach
noindex.
Verlassen Sie sich nicht ausschließlich auf die Anzeige im Editor. Entscheidend ist, was die öffentlich ausgelieferte URL tatsächlich enthält. Caching, mehrere SEO-Erweiterungen oder individuelle Theme-Funktionen können die Ausgabe beeinflussen.
Archiv- und Taxonomieseiten steuern
Für Kategorien, Schlagwörter, Autoren- oder Datumsarchive bieten viele Plugins globale Einstellungen. Hier ist besondere Vorsicht erforderlich. Eine sinnvolle Kategorieübersicht kann Suchenden Orientierung geben und sollte nicht allein deshalb auf Noindex stehen, weil sie ein Archiv ist.
Bewerten Sie zunächst die Qualität und Funktion der jeweiligen Archivart. Wenn Sie eine Taxonomie dauerhaft nicht benötigen, kann das Entfernen oder Zusammenführen leerer Begriffe besser sein. Wenn die Archive intern nützlich, aber für Suchmaschinen nicht relevant sind, ist Noindex eine mögliche kontrollierte Einstellung.
Robots-Meta-Tag und X-Robots-Tag
HTML-Dokumente verwenden häufig das Robots-Meta-Tag im <head>. Bei nicht-HTML-Dateien wie PDF-Dokumenten kann der Server stattdessen einen HTTP-Header ausliefern:
X-Robots-Tag: noindexDie technische Umsetzung des Headers hängt vom Webserver, dem Hosting und der verwendeten Infrastruktur ab. Änderungen an Serverregeln sollten Sie erst nach einer Sicherung und mit einer nachvollziehbaren Rückfallmöglichkeit durchführen. Bei Unsicherheit ist die Dokumentation des Hosters oder die Unterstützung einer fachkundigen Person sinnvoll.
Kontrolle und Prüfung nach der Änderung
Eine Noindex-Einstellung ist erst dann zuverlässig bewertet, wenn Sie die veröffentlichte Ausgabe und die technischen Rahmenbedingungen kontrollieren. Arbeiten Sie am besten mit einer kleinen, wiederholbaren Prüfroutine.
- Quelltext prüfen: Suchen Sie nach einem Robots-Meta-Tag und kontrollieren Sie, ob es tatsächlich
noindexenthält. - HTTP-Antwort prüfen: Bei Dateien und speziellen Konfigurationen kann ein
X-Robots-Tagrelevant sein. - Robots.txt kontrollieren: Stellen Sie sicher, dass die URL nicht blockiert wird, wenn das Noindex-Signal noch abgerufen werden muss.
- Interne Links prüfen: Entfernen Sie unnötige Links zu ausgeschlossenen Seiten, ohne wichtige Nutzerwege zu zerstören.
- Sitemap prüfen: Nicht indexierbare URLs sollten normalerweise nicht in der XML-Sitemap stehen. Die genaue Sitemap-Konfiguration hängt vom System ab.
- Weiterleitungen und Canonicals ansehen: Eine Noindex-Seite sollte nicht versehentlich gleichzeitig auf eine andere URL weiterleiten oder ein widersprüchliches Canonical ausgeben.
- Nachkontrolle einplanen: Caches, Plugin-Updates und Template-Änderungen können technische Signale verändern.
Eine URL-Prüfung in einem Suchmaschinen-Tool kann zusätzliche Hinweise liefern. Dabei sollten Sie die dort angezeigten Informationen als Diagnosehilfe verstehen und mit dem tatsächlich ausgelieferten Quelltext abgleichen. Die Entfernung einer bereits bekannten URL aus einem Index kann außerdem zeitversetzt erfolgen.
Häufige Fehler beim Einsatz von Noindex
Die komplette Website auf Noindex setzen
Ein falsch gesetztes globales Robots-Signal kann alle wichtigen Inhalte betreffen. Prüfen Sie deshalb nach Änderungen an Theme, SEO-Plugin oder Hosting besonders die Startseite, wichtige Landingpages, Kategorien und Beiträge.
Noindex mit Zugriffsschutz verwechseln
Jede Person, die die URL kennt oder über einen Link erreicht, kann eine nicht indexierte Seite weiterhin aufrufen, sofern keine Authentifizierung oder andere Schutzmaßnahme greift. Für vertrauliche Inhalte benötigen Sie einen echten Zugriffsschutz.
Die URL in robots.txt sperren und Noindex erwarten
Wenn ein Crawler eine URL wegen der robots.txt nicht abrufen darf, sieht er möglicherweise auch das Meta-Tag nicht. Eine Sperre kann deshalb die gewünschte Verarbeitung des Noindex-Signals verhindern.
Wichtige Inhalte wegen geringer Wortzahl ausschließen
Die Länge allein entscheidet nicht über den Nutzen. Eine kompakte Kontakt-, Produkt- oder Hilfeseite kann für Besucher sehr relevant sein. Bewerten Sie Inhalt, Suchintention, Aktualität und Nutzerführung gemeinsam.
Noindex als Ersatz für eine schlechte Informationsarchitektur nutzen
Wenn tausende Filter-URLs entstehen, ist es oft besser, die URL-Erzeugung, interne Verlinkung und Crawling-Steuerung grundsätzlich zu analysieren. Noindex kann eine sinnvolle Maßnahme sein, sollte aber nicht die einzige Antwort auf strukturelle Probleme bleiben.
Praktische Noindex-Checkliste
Die folgende Checkliste eignet sich für einzelne Seiten ebenso wie für größere WordPress-Bereinigungen:
- Definieren Sie, warum die konkrete URL nicht in den Suchergebnissen erscheinen soll.
- Prüfen Sie, ob Überarbeitung, Zusammenlegung, Weiterleitung oder Canonical die passendere Lösung wäre.
- Setzen Sie Noindex gezielt auf der betroffenen URL oder in einer klar begrenzten Regel.
- Vermeiden Sie widersprüchliche Einstellungen in SEO-Plugin, Theme, Server und
robots.txt. - Entfernen Sie die URL aus der XML-Sitemap, sofern sie dort nicht benötigt wird.
- Kontrollieren Sie Meta-Tag oder HTTP-Header in der veröffentlichten Version.
- Dokumentieren Sie den Grund und prüfen Sie bei temporären Maßnahmen ein Ablaufdatum.
- Beobachten Sie wichtige Seiten nach Plugin-, Theme- oder Serveränderungen erneut.
FAQ
Ist Noindex schlecht für SEO?
Nein. Noindex ist zunächst eine Steuerungsanweisung. Sie kann SEO unterstützen, wenn unwichtige oder nicht eigenständige URLs aus dem Index herausgehalten werden. Problematisch wird sie nur, wenn relevante Seiten versehentlich ausgeschlossen werden.
Kann eine Noindex-Seite weiterhin aufgerufen werden?
Ja. Noindex verhindert grundsätzlich die Aufnahme in Suchergebnisse, sperrt aber nicht den direkten Zugriff. Für private oder geschützte Inhalte brauchen Sie Authentifizierung, Berechtigungen oder eine andere geeignete Zugriffskontrolle.
Soll ich noindex mit nofollow kombinieren?
Nicht automatisch. Wenn die Seite selbst nicht indexiert werden soll, Links darauf aber weiterhin für die interne Navigation relevant sind, kann noindex, follow passender sein. Die Wahl hängt vom Zweck der Seite und Ihrer Linkstrategie ab.
Wie unterscheidet sich Noindex von einem Canonical?
Noindex weist darauf hin, dass eine URL nicht gelistet werden soll. Ein Canonical nennt dagegen eine bevorzugte Version aus mehreren ähnlichen URLs. Wenn eine Variante weiterhin als Suchergebnis infrage kommt, kann ein Canonical die passendere Lösung sein.
Kann ich Noindex in der robots.txt eintragen?
Nein, noindex ist kein regulärer Ersatz für eine Robots.txt-Regel. Das Signal wird typischerweise im HTML-Meta-Tag oder über den X-Robots-Tag im HTTP-Header übertragen. Die robots.txt steuert vor allem, welche URLs ein Crawler abrufen darf.
Wie schnell verschwindet eine URL aus dem Index?
Das lässt sich nicht pauschal festlegen. Die Suchmaschine muss die URL erneut abrufen und das Signal verarbeiten. Eine Änderung im Quelltext führt daher nicht zwingend sofort zu einer sichtbaren Änderung der Suchergebnisse.
Soll eine Noindex-Seite aus der Sitemap entfernt werden?
In der Regel ja, weil eine XML-Sitemap bevorzugt URLs enthalten sollte, die Suchmaschinen indexieren dürfen und sollen. Prüfen Sie jedoch die konkrete Sitemap-Konfiguration und beheben Sie die Ursache, wenn ausgeschlossene URLs automatisch wieder aufgenommen werden.
Fazit: Noindex gezielt statt pauschal einsetzen
Noindex richtig verwenden bedeutet, die Anweisung als präzises Steuerungswerkzeug zu betrachten. Nicht jede kurze, doppelte oder technisch erzeugte URL muss automatisch ausgeschlossen werden. Entscheidend sind Suchintention, eigenständiger Nutzen, Zugriffszweck und die Frage, ob eine andere SEO-Maßnahme besser passt.
Setzen Sie Noindex möglichst gezielt, vermeiden Sie Konflikte mit robots.txt und Canonical, prüfen Sie die tatsächlich ausgelieferte Version und dokumentieren Sie wichtige Änderungen. So bleibt Ihre WordPress-Website für Besucher zugänglich, während der Suchindex auf die Inhalte konzentriert wird, die dort wirklich einen eigenständigen Beitrag leisten.