Canonical oder Noindex? Beide Signale helfen dabei, Suchmaschinen bei der Bewertung ähnlicher oder unerwünschter URLs zu unterstützen. Sie verfolgen jedoch unterschiedliche Ziele: Ein Canonical weist auf die bevorzugte Version mehrerer ähnlicher Seiten hin, während noindex verhindern soll, dass eine konkrete Seite in den Suchergebnissen erscheint. Die falsche Wahl kann dazu führen, dass wichtige Inhalte aus dem Index verschwinden oder doppelte URLs weiterhin unnötige Aufmerksamkeit erhalten.
Dieser Ratgeber erklärt die Unterschiede, zeigt typische Anwendungsfälle und bietet eine praktische Entscheidungshilfe für Websites, Onlineshops, Blogs und technische Plattformen. Dabei gilt: Keine der beiden Maßnahmen ersetzt eine saubere Informationsarchitektur, verständliche Inhalte und eine sorgfältige technische Prüfung.
Was bedeuten Canonical und Noindex?
Canonical und Noindex sind zwei verschiedene Steuerungssignale für Suchmaschinen. Sie werden häufig gemeinsam genannt, weil beide bei ähnlichen, doppelten oder nicht gewünschten URLs zum Einsatz kommen können. Inhaltlich sind sie aber nicht austauschbar.
Canonical: Welche URL ist die bevorzugte Version?
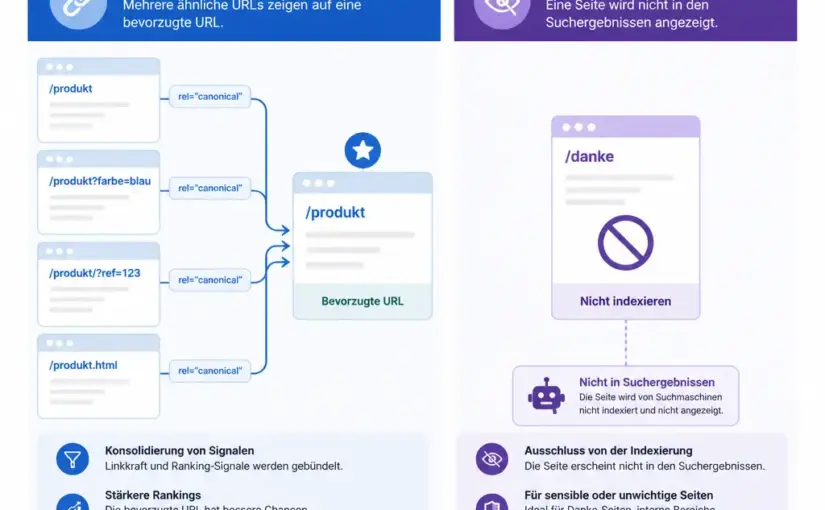
Mit einem Canonical-Link wird eine bevorzugte URL für inhaltlich gleiche oder sehr ähnliche Seiten angegeben. Das Signal lautet sinngemäß: „Von mehreren erreichbaren Varianten ist diese URL die wichtigste Version.“
Ein Canonical wird im <head> einer HTML-Seite eingebunden:
<link rel="canonical" href="https://www.beispiel.de/ratgeber/canonical-noindex">In vielen Fällen verweist eine Seite auf sich selbst. Das wird als selbstreferenzierendes Canonical bezeichnet. Bei URL-Varianten kann eine alternative Seite hingegen auf eine andere, bevorzugte URL verweisen. Suchmaschinen können dieses Signal bei der Auswahl der indexierten und in Suchergebnissen angezeigten URL berücksichtigen.
Wichtig ist die Formulierung „Signal“: Ein Canonical ist keine absolute Anweisung. Suchmaschinen prüfen zusätzlich den Inhalt, interne Verlinkungen, Weiterleitungen, Sitemap-Einträge und weitere technische Hinweise. Ein Canonical sollte daher zu den übrigen Signalen der Website passen.
Noindex: Diese konkrete URL soll nicht in den Suchergebnissen erscheinen
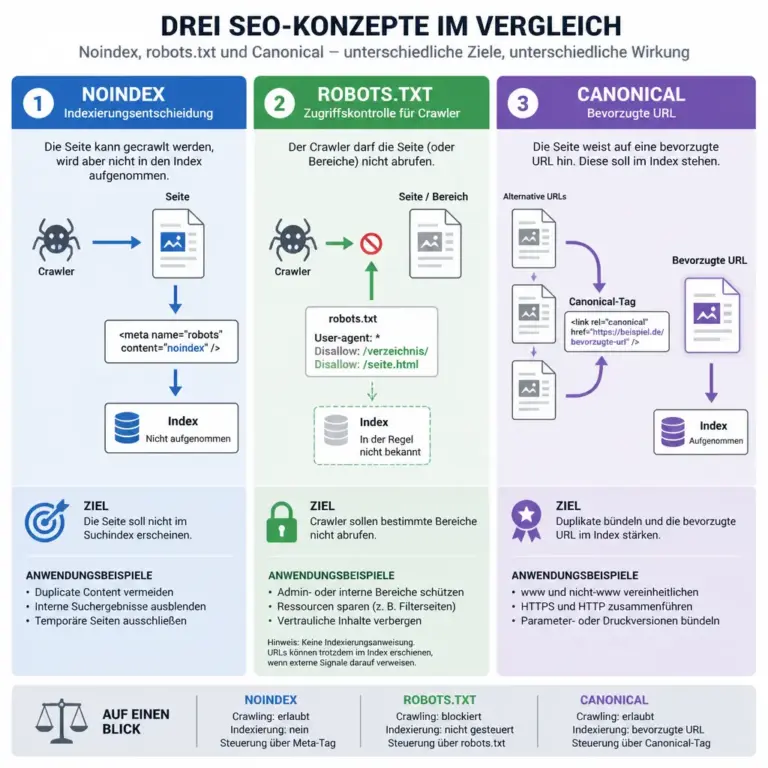
noindex ist eine Anweisung beziehungsweise ein starkes Robots-Meta-Signal, eine bestimmte Seite nicht in den Suchindex aufzunehmen oder dort wieder zu entfernen. Die Seite kann weiterhin erreichbar sein und von Nutzern verwendet werden.
Typischerweise wird das Signal so im <head> hinterlegt:
<meta name="robots" content="noindex, follow">Die häufig verwendete Kombination noindex, follow bedeutet: Die Seite selbst soll nicht in den Suchergebnissen erscheinen; Links auf der Seite dürfen grundsätzlich weiterhin entdeckt und verfolgt werden. Das follow ist meist nicht notwendig, weil Suchmaschinen Links auch ohne diese ausdrückliche Angabe verarbeiten können. Entscheidend ist der Teil noindex.
Damit Suchmaschinen das Meta-Tag sehen können, darf die URL nicht durch die robots.txt vom Crawling ausgeschlossen sein. Eine blockierte URL kann das enthaltene Noindex-Signal unter Umständen nicht zuverlässig übermitteln.
Der wichtigste Unterschied zwischen Canonical und Noindex
| Frage | Canonical | Noindex |
|---|---|---|
| Was wird gesteuert? | Die bevorzugte URL innerhalb ähnlicher Versionen | Die Aufnahme einer konkreten URL in den Suchindex |
| Bleibt die Seite erreichbar? | Ja | Ja, sofern keine andere Zugriffsbeschränkung besteht |
| Wird die Seite aus dem Index entfernt? | Nicht zwingend | Das ist das Ziel des Signals |
| Wofür ist es besonders geeignet? | Duplikate und URL-Varianten mit einem bevorzugten Original | Interne Seiten, dünne Inhalte oder nicht suchrelevante Bereiche |
| Was passiert mit Linksignalen? | Signale können der bevorzugten URL zugeordnet werden | Die Seite wird nicht als Suchergebnis gewünscht; die interne Verlinkung bleibt gesondert zu bewerten |
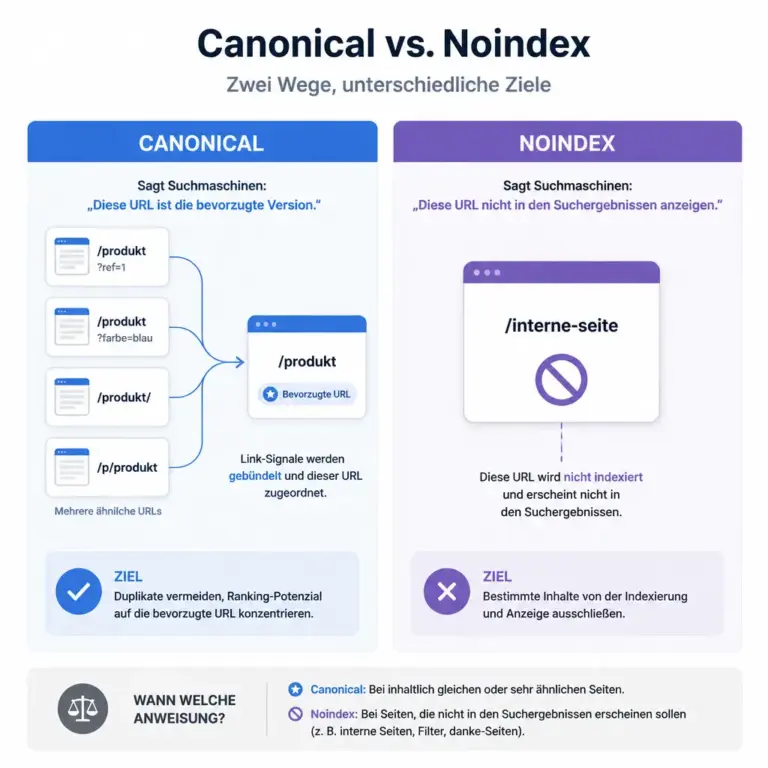
Die Kurzform lautet: Canonical bündelt ähnliche Varianten auf eine bevorzugte URL, Noindex schließt eine konkrete URL aus den Suchergebnissen aus. Diese Kurzform hilft bei der ersten Einordnung, ersetzt aber nicht die Prüfung des jeweiligen Seitentyps.
Canonical oder Noindex: Eine praktische Entscheidungshilfe
Bevor eine technische Maßnahme gesetzt wird, sollte die eigentliche Absicht klar sein. Stelle dir nacheinander diese Fragen:
- Existiert eine andere URL mit demselben oder nahezu demselben Inhalt? Wenn ja, kann ein Canonical auf die bevorzugte Version passen.
- Soll die konkrete URL grundsätzlich nicht in der Suche erscheinen? Dann ist Noindex meist das passendere Signal.
- Hat die Seite einen eigenständigen Nutzen für Suchende? Wenn der Inhalt eine eigene Suchintention vollständig beantwortet, sollte er nicht vorschnell auf eine andere URL kanonisiert oder auf Noindex gesetzt werden.
- Ist die Seite nur eine technische oder funktionale Variante? Filter-, Sortier-, Warenkorb- oder interne Suchseiten benötigen oft eine andere Behandlung als redaktionelle Landingpages.
- Kann die bevorzugte Ziel-URL gecrawlt und indexiert werden? Ein Canonical auf eine blockierte, weitergeleitete oder ebenfalls nicht indexierbare URL ist häufig widersprüchlich.
Eine einfache Entscheidungsregel lautet: Gibt es ein sichtbares, eigenständiges Suchergebnisziel, sollte die Seite zunächst als mögliche Indexierungsseite betrachtet werden. Gibt es dagegen mehrere nahezu gleiche URLs und nur eine soll als Hauptversion dienen, ist ein Canonical naheliegend. Soll keine der Varianten in den Suchergebnissen auftauchen, reicht ein Canonical allein nicht aus; dann muss die Indexierungsabsicht ausdrücklich geprüft werden.
Typische Anwendungsfälle für ein Canonical
URL-Parameter für Tracking
Eine redaktionelle Seite kann durch Tracking-Parameter in mehreren URL-Varianten erreichbar sein, etwa durch Kampagnen- oder Analyseparameter. Wenn der Seiteninhalt gleich bleibt und die Parameter keine eigene Suchintention abbilden, kann die saubere Haupt-URL als Canonical angegeben werden.
Zusätzlich sollten interne Links möglichst direkt auf die bevorzugte URL zeigen. Das Canonical ist kein Ersatz für eine konsistente Verlinkung. Werden beide Varianten dauerhaft in der Website verlinkt, bleibt für Suchmaschinen und Nutzer unnötige URL-Komplexität bestehen.
Sortierung und Darstellung in einem Katalog
Ein Katalog kann dieselben Produkte oder Beiträge nach Preis, Aktualität, Farbe oder anderen Kriterien sortieren. Wenn die Sortieransichten keinen eigenständigen, suchrelevanten Inhalt bieten, kann die Hauptansicht als bevorzugte URL definiert werden.
Ob ein Canonical genügt, hängt davon ab, ob die Varianten weiterhin sinnvoll crawlbar sein sollen und ob sie für Nutzer oder externe Verweise benötigt werden. Bei umfangreichen Filterkombinationen ist eine Gesamtlösung aus URL-Konzept, interner Verlinkung, Crawl-Steuerung und gegebenenfalls Noindex oft sinnvoller als ein pauschales Signal auf jeder Variante.
Druckansicht oder alternative Layout-Version
Eine Druckansicht enthält häufig denselben Text wie die normale Seite, aber eine veränderte Darstellung. Wenn sie öffentlich erreichbar bleiben soll, jedoch nicht als eigenständiges Suchergebnis gewünscht ist, kann eine kanonische Zuordnung zur normalen Inhaltsseite geprüft werden. Bei rein funktionalen Varianten kann je nach Ziel auch Noindex angemessen sein.
Ähnliche Produkt- oder Beitragsseiten
Ein Canonical ist nicht automatisch richtig, nur weil zwei Seiten thematisch ähnlich sind. Wenn zwei Seiten unterschiedliche Fragen beantworten, verschiedene Produkte beschreiben oder jeweils einen eigenständigen Nutzen besitzen, sollten sie nicht ohne sorgfältige Prüfung zusammengelegt werden.
Bei echten Duplikaten oder nahezu identischen Varianten ist ein Canonical plausibler. Bei nur oberflächlicher Ähnlichkeit sollte stattdessen geprüft werden, ob beide Seiten durch bessere Abgrenzung, zusätzliche Informationen oder eine neue Informationsarchitektur eigenständig werden können.
Typische Anwendungsfälle für Noindex
Interne Suchergebnisse
Interne Suchseiten werden häufig automatisch aus Suchbegriffen erzeugt. Sie können für die Website-Navigation hilfreich sein, sind aber nicht grundsätzlich als öffentliche Landingpages gedacht. Wenn diese Seiten keinen kuratierten, stabilen und eigenständigen Inhalt besitzen, ist Noindex oft eine passende Option.
Warenkorb, Kasse und persönliche Bereiche
Warenkorb-, Konto-, Login- und vergleichbare Funktionsseiten richten sich an konkrete Nutzeraktionen. Sie sollen in der Regel nicht als informative Suchergebnisse gefunden werden. Hier ist Noindex meist näher an der eigentlichen Absicht als ein Canonical, weil nicht eine andere Inhaltsversion bevorzugt, sondern die Funktion aus dem Suchindex herausgehalten werden soll.
Vorläufige oder dünne Seiten
Eine noch nicht fertige Vorschauseite, ein interner Entwurf oder eine Seite mit sehr wenig eigenständigem Inhalt kann vorübergehend mit Noindex versehen werden. Vor einer späteren Veröffentlichung sollte die Maßnahme wieder entfernt und die Seite technisch wie redaktionell geprüft werden.
Mehrere Varianten ohne brauchbare Hauptversion
Manchmal existieren viele nahezu gleiche URLs, aber keine davon ist als dauerhaftes Suchergebnis sinnvoll. In diesem Fall kann ein Canonical auf eine nicht passende Seite das Problem nur verschieben. Noindex kann dann geeigneter sein, sofern die URLs weiterhin erreichbar sein müssen. Langfristig ist jedoch eine Bereinigung der URL-Erzeugung meist die robustere Lösung.
Wann Canonical und Noindex nicht einfach kombiniert werden sollten
Ein häufiges Missverständnis ist die Kombination aus Noindex und Canonical auf derselben Seite mit dem Gedanken, beide Signale würden sich gegenseitig verstärken. Das kann widersprüchlich sein: Einerseits wird die Seite als nicht indexierbar markiert, andererseits wird eine bevorzugte URL genannt. Suchmaschinen können das Canonical unter solchen Bedingungen weniger zuverlässig berücksichtigen.
Wenn eine Seite nicht im Index erscheinen soll, sollte zunächst Noindex die klare Hauptabsicht ausdrücken. Wenn mehrere indexierbare Varianten auf eine bevorzugte Version verweisen sollen, sollte das Canonical sauber und konsistent eingesetzt werden. Eine Kombination kann in speziellen technischen Szenarien sinnvoll sein, sollte aber nicht als pauschale Standardlösung verwendet werden.
Ebenso problematisch ist ein Canonical auf eine URL, die selbst noindex trägt. Die Zielseite sollte normalerweise als gültige, indexierbare Hauptversion vorgesehen sein. Widersprüchliche Signale erschweren die Verarbeitung und machen die gewünschte Indexierungslogik weniger eindeutig.
Technische Umsetzung und Qualitätskontrolle
Die korrekte Syntax ist nur der erste Schritt. Nach der Implementierung sollte geprüft werden, ob die Maßnahme tatsächlich zur URL-Strategie passt.
Checkliste für Canonical
- Die Canonical-URL ist vollständig und verwendet das gewünschte Protokoll sowie die gewünschte Host-Version.
- Die Ziel-URL ist erreichbar und liefert nicht dauerhaft auf eine andere Adresse weiter.
- Die Zielseite ist nicht absichtlich mit Noindex versehen.
- Die Zielseite enthält den gleichen oder den klar bevorzugten Inhalt.
- Interne Links, XML-Sitemap und hreflang-Verweise widersprechen der bevorzugten URL nicht.
- Es gibt keine unnötigen Ketten von Canonical-Verweisen.
- Die URL verwendet eine konsistente Schreibweise, etwa bei Großschreibung, abschließendem Schrägstrich und Parametern.
Checkliste für Noindex
- Das Robots-Meta-Tag steht in der ausgelieferten HTML-Seite oder wird zuverlässig über einen passenden HTTP-Header gesetzt.
- Die URL ist für Suchmaschinen erreichbar, damit das Noindex-Signal gelesen werden kann.
- Die Seite soll tatsächlich nicht als Suchergebnis erscheinen.
- Wichtige Inhalte wurden nicht versehentlich mit Noindex versehen.
- Die Seite wird nicht unnötig in XML-Sitemaps als indexierbare Ziel-URL geführt.
- Interne Links verweisen nur dann prominent auf die URL, wenn sie für Nutzer weiterhin eine wichtige Funktion erfüllt.
- Bei einer zeitlich begrenzten Maßnahme ist dokumentiert, wann die Einstellung erneut geprüft wird.
Häufige Fehler bei Canonical und Noindex
Canonical als Ersatz für eine Weiterleitung
Wenn eine alte URL dauerhaft auf eine neue URL umziehen soll und Nutzer ebenfalls automatisch weitergeleitet werden sollen, ist eine serverseitige Weiterleitung meist die passendere Lösung. Ein Canonical lässt die alte URL erreichbar und informiert vor allem Suchmaschinen über die bevorzugte Variante. Beide Maßnahmen verfolgen also nicht dasselbe Ziel.
Noindex für jede ähnliche Seite
Ähnliche Themen sind nicht automatisch doppelte Inhalte. Wer vorschnell viele Seiten auf Noindex setzt, kann wertvolle Suchintentionen und nützliche Einstiegsseiten verlieren. Vor der Entscheidung sollte geklärt werden, ob die Seite eine eigene Frage beantwortet und ob sie für Besucher einen eigenständigen Nutzen hat.
Blockierung in der robots.txt statt Noindex
Ein Crawling-Verbot und ein Noindex-Signal sind nicht gleichbedeutend. Wenn eine URL gar nicht abgerufen werden darf, kann ihr Inhalt nicht zuverlässig auf ein Meta-Tag geprüft werden. Soll eine Seite aus dem Index verschwinden, muss die technische Umsetzung diesen Unterschied berücksichtigen.
Canonical auf die Startseite
Die Startseite ist nicht automatisch die passende Sammelstelle für fehlerhafte, dünne oder doppelte URLs. Ein Canonical sollte auf die inhaltlich passende Hauptversion zeigen. Ist keine solche Version vorhanden, sind eine Überarbeitung, eine Weiterleitung oder Noindex möglicherweise sinnvoller.
Nach der Veröffentlichung nicht kontrollieren
CMS, Plugins, Shopsysteme und Templates können Canonical- oder Noindex-Angaben automatisch erzeugen. Nach Änderungen sollten deshalb nicht nur die Einstellungen im Backend, sondern auch der tatsächlich ausgelieferte Quelltext und die betroffenen URL-Muster geprüft werden.
Eine sinnvolle Vorgehensweise bei großen Websites
Bei vielen URLs sollte die Entscheidung nicht einzeln und zufällig getroffen werden. Besser ist ein wiederholbarer Prozess:
- URL-Muster erfassen: Gruppiere Seiten nach Parametern, Filterkombinationen, Seitentypen, Sprachversionen und Funktionen.
- Suchintention bewerten: Notiere, welche Gruppen für Suchende eigenständige Antworten oder Angebote liefern.
- Hauptversion bestimmen: Lege bei echten Duplikaten eine klare, stabile bevorzugte URL fest.
- Signal auswählen: Nutze Canonical für bevorzugte Varianten und Noindex für Seiten, die nicht in den Suchergebnissen erscheinen sollen.
- Begleitsignale angleichen: Prüfe interne Links, Sitemaps, Weiterleitungen, hreflang und strukturierte Daten.
- Ergebnis beobachten: Kontrolliere nach der Umsetzung, ob die Suchmaschinen die gewünschte URL-Auswahl und Indexierung nachvollziehbar verarbeiten.
Besonders wichtig ist eine Dokumentation: Für jedes URL-Muster sollte festgehalten werden, welche Seiten indexierbar sein sollen, welche Hauptversion gilt und warum eine bestimmte Maßnahme gewählt wurde. Das erleichtert spätere Relaunches, Plugin-Wechsel und Fehleranalysen.
FAQ
Ist Canonical dasselbe wie Noindex?
Nein. Canonical nennt eine bevorzugte URL unter ähnlichen Varianten. Noindex weist darauf hin, dass eine konkrete URL nicht in den Suchergebnissen erscheinen soll. Beide Signale beantworten unterschiedliche Fragen.
Was ist besser bei doppelten Seiten: Canonical oder Noindex?
Wenn eine Version als Hauptseite erhalten bleiben und die Varianten auf sie verweisen sollen, ist Canonical meist passend. Wenn keine der betreffenden URLs als Suchergebnis erscheinen soll, kann Noindex näher an der gewünschten Absicht liegen. Bei dauerhaft identischen URLs kann zusätzlich eine URL-Bereinigung oder Weiterleitung sinnvoll sein.
Kann eine noindex-Seite trotzdem gecrawlt werden?
Ja. Noindex verhindert grundsätzlich nicht, dass die Seite erreichbar oder abrufbar ist. Damit das Signal verarbeitet werden kann, darf der Zugriff für den relevanten Crawler nicht gleichzeitig durch die robots.txt blockiert sein.
Verhindert ein Canonical garantiert die Indexierung der URL?
Nein. Ein Canonical ist ein starkes Signal, aber keine absolute Garantie. Suchmaschinen bewerten zusätzlich Inhalt, interne Verlinkung, technische Erreichbarkeit und weitere Signale. Die bevorzugte URL sollte deshalb eindeutig und konsistent ausgezeichnet werden.
Soll jede Seite ein selbstreferenzierendes Canonical haben?
Ein selbstreferenzierendes Canonical kann bei vielen indexierbaren Seiten eine klare technische Grundlage schaffen, ist aber kein Ersatz für ein durchdachtes URL-Konzept. Entscheidend ist, dass die Angabe korrekt, konsistent und für den jeweiligen Seitentyp sinnvoll ist.
Was sollte ich bei Filterseiten im Onlineshop verwenden?
Das hängt davon ab, ob ein Filter eine eigene, dauerhaft nützliche Suchintention bedient. Für rein technische Kombinationen kann eine kanonische Hauptseite oder eine andere Crawl- und Indexierungsstrategie passen. Wertvolle Filter-Landingpages sollten dagegen nicht pauschal auf Noindex gesetzt werden.
Kann ich eine URL mit Noindex in der XML-Sitemap lassen?
Technisch kann sie dort stehen, sinnvoll ist es normalerweise nicht. Eine XML-Sitemap sollte vor allem URLs enthalten, die als wichtige, indexierbare Seiten vorgesehen sind. Widersprüchliche Signale erschweren die klare Kommunikation der Website-Struktur.
Wie lange dauert es, bis Noindex oder Canonical verarbeitet wird?
Das lässt sich nicht pauschal festlegen. Die Verarbeitung hängt unter anderem davon ab, wann die URL erneut gecrawlt wird und welche weiteren Signale vorliegen. Nach einer Änderung sollte deshalb nicht sofort aus einzelnen Suchergebnissen auf den endgültigen Zustand geschlossen werden.
Fazit: Die Absicht entscheidet
Bei der Frage „Canonical oder Noindex?“ ist nicht die technische Kürze des Signals entscheidend, sondern die gewünschte Funktion der URL. Ein Canonical bündelt ähnliche Varianten unter einer bevorzugten Adresse. Noindex hält eine konkrete Seite aus den Suchergebnissen heraus, während sie für Nutzer weiterhin erreichbar bleiben kann.
Prüfe deshalb zuerst die Suchintention, den eigenständigen Nutzen und die Rolle der URL in der Website. Setze anschließend ein eindeutiges Signal und gleiche interne Links, Sitemaps, Weiterleitungen und weitere technische Angaben daran an. Eine regelmäßige Kontrolle des tatsächlich ausgelieferten Codes verhindert, dass CMS-Einstellungen oder URL-Parameter die geplante SEO-Struktur unbemerkt wieder auflösen.