Die Datei robots.txt wirkt unscheinbar, kann aber maßgeblich beeinflussen, welche Bereiche einer Website Suchmaschinen-Crawler erreichen. Ein einzelner zu weit gefasster Pfad, ein falsch gesetztes Zeichen oder eine veraltete Regel kann dazu führen, dass wichtige Inhalte seltener gecrawlt werden oder gar nicht erst in den Suchindex gelangen. Gleichzeitig wird die robots.txt häufig überschätzt: Sie ist kein sicherer Zugriffsschutz und ersetzt weder Authentifizierung noch technische Sicherheitsmaßnahmen.
Dieser Ratgeber zeigt die häufigsten Fehler in der robots.txt, erklärt ihre Auswirkungen und bietet eine systematische Vorgehensweise zur Prüfung. Dabei geht es nicht nur um einzelne Direktiven, sondern auch um den Zusammenhang mit internen Links, XML-Sitemaps, Meta-Robots-Anweisungen, Weiterleitungen und der tatsächlichen Website-Struktur.
Was die robots.txt tatsächlich steuert
Die robots.txt liegt normalerweise im Hauptverzeichnis einer Domain, zum Beispiel unter https://www.beispiel.de/robots.txt. Crawler rufen diese Datei ab, bevor sie URLs derselben Website crawlen. Darin können Regeln stehen, die bestimmten User-Agents den Zugriff auf bestimmte Pfade erlauben oder untersagen.
Wichtig ist die Unterscheidung zwischen Crawling und Indexierung. Eine Disallow-Regel sagt im Kern: Der betreffende Crawler soll den angegebenen Pfad nicht abrufen. Sie garantiert jedoch nicht, dass eine URL niemals im Index auftaucht. Wenn eine blockierte URL von anderen Seiten verlinkt wird, kann eine Suchmaschine ihre Existenz unter Umständen trotzdem erkennen und die URL ohne ausgelesenen Inhalt anzeigen.
Die robots.txt ist deshalb vor allem ein Werkzeug zur Steuerung des Crawlings. Für den Schutz vertraulicher Inhalte sind beispielsweise Zugriffsbeschränkungen, Serverberechtigungen oder eine geeignete Authentifizierung erforderlich. Für die Steuerung der Indexierung kommen unter anderem Meta-Robots-Anweisungen oder HTTP-Header wie X-Robots-Tag infrage, sofern der Crawler die betreffende Ressource abrufen darf.
Die häufigsten Fehler in der robots.txt
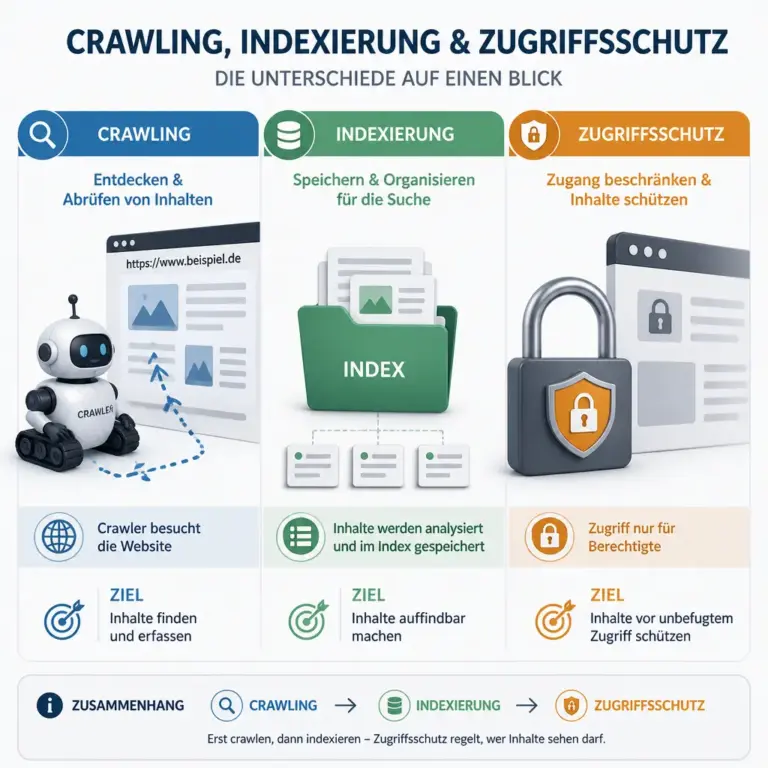
Die Grafik sollte zeigen, dass eine robots.txt den Abruf bestimmter Pfade beeinflusst, aber keine vertraulichen Inhalte schützt. Der getrennte Bereich für Indexierung macht sichtbar, warum Disallow und Noindex nicht dasselbe sind.
Die gesamte Website versehentlich blockieren
Der folgenreichste Fehler ist eine Regel, die nahezu alle URLs blockiert:
User-agent: *
Disallow: /
Diese Kombination kann in einer Entwicklungsumgebung sinnvoll sein, wenn eine nicht öffentliche Website nicht von Suchmaschinen gecrawlt werden soll. Auf einer produktiven Website verhindert sie jedoch das Crawling praktisch aller Pfade. Besonders kritisch ist, wenn die Regel beim Umzug, bei einem Relaunch oder durch die Übernahme einer Staging-Konfiguration aktiv bleibt.
Prüfen Sie daher nach jedem Relaunch, jeder Migration und jedem Wechsel des Hosting-Systems, ob die Datei noch zur Produktionsumgebung passt. Die Website sollte außerdem über eine eindeutige Umgebungskontrolle verfügen: Eine Regel, die auf einer Testdomain sinnvoll ist, darf nicht ungeprüft auf der Live-Domain eingesetzt werden.
Wichtige Verzeichnisse zu weit sperren
Ein Pfad kann harmlos wirken, obwohl darunter wichtige Inhalte liegen. Beispiele sind pauschale Sperren für /wp-content/, /assets/, /media/ oder /static/. Werden dort Bilder, Stylesheets, JavaScript-Dateien oder eingebundene Inhalte gespeichert, kann ein Crawler die Darstellung und den funktionalen Aufbau einer Seite möglicherweise nicht vollständig beurteilen.
Früher wurden technische Ressourcen oft pauschal blockiert, um Crawl-Budget zu sparen. In vielen Fällen ist das jedoch kontraproduktiv. Suchmaschinen müssen eine Seite in ihrer ausgelieferten Form verstehen können. Statt ganze Verzeichnisse zu sperren, sollte geprüft werden, ob tatsächlich problematische URL-Muster existieren und ob diese auf andere Weise bereinigt werden können.
Besonders sorgfältig sollten Sie Regeln behandeln, die ein übergeordnetes Verzeichnis betreffen. Eine Sperre für /shop/ erfasst in der Regel auch /shop/produkte/, /shop/kategorien/ und weitere Unterpfade. Die gewünschte Wirkung sollte deshalb immer anhand konkreter Beispiel-URLs kontrolliert werden.
Fehlerhafte Schreibweise von User-agent und Direktiven
Die Grundstruktur einer Regel besteht aus einem User-Agent-Block und einer oder mehreren Direktiven:
User-agent: *
Disallow: /intern/
Typische Schreibfehler sind fehlende Doppelpunkte, vertauschte Feldnamen, zusätzliche Sonderzeichen oder eine unklare Mischung aus mehreren Blöcken. Die Namen der Direktiven sollten korrekt geschrieben werden, insbesondere User-agent, Disallow und Allow. Unbekannte oder nicht unterstützte Anweisungen werden nicht automatisch so interpretiert, wie der Verfasser es beabsichtigt hat.
Auch Kommentare sollten sauber mit einem # beginnen. Ein Kommentar kann bei der Pflege helfen, darf aber nicht versehentlich einen Teil einer wirksamen Regel ausblenden. Für eine verständliche Datei sind kurze, sachliche Kommentare sinnvoll, etwa zur Kennzeichnung einer temporären Ausnahme oder eines bewusst gesperrten Suchparameters.
Allow und Disallow falsch miteinander kombinieren
Mit Allow können Ausnahmen innerhalb eines gesperrten Bereichs formuliert werden, sofern der jeweilige Crawler diese Direktive unterstützt und die Regeln nach seinen Prioritätsregeln auswertet. Ein Beispiel ist:
User-agent: *
Disallow: /bereich/
Allow: /bereich/oeffentlich/
Solche Ausnahmen sind fehleranfällig, wenn mehrere Regeln ähnliche Pfade betreffen. Entscheidend ist nicht nur die Reihenfolge der Zeilen. Je nach Auswertung spielen unter anderem die konkretere Übereinstimmung und die unterstützte Syntax eine Rolle. Verlassen Sie sich daher nicht auf ein Bauchgefühl, sondern prüfen Sie konkrete URLs mit einem geeigneten Validator oder einer dokumentierten Testmethode.
Oft ist eine einfachere Struktur besser: Wenn nur wenige private Verzeichnisse nicht gecrawlt werden sollen, können diese direkt genannt werden. Eine lange Kette aus verschachtelten Ausnahmen erschwert die spätere Wartung und erhöht die Gefahr widersprüchlicher Regeln.
Wildcards unpräzise oder zu großzügig verwenden
Wildcards können wiederkehrende Muster erfassen, etwa URLs mit bestimmten Parametern. Eine zu breite Regel kann jedoch weit mehr blockieren als beabsichtigt. Ein Muster wie Disallow: /*? zielt beispielsweise auf URLs mit einem Fragezeichen. Je nach Website können darunter aber auch nützliche, indexierbare URLs liegen, die nicht bloß Sortierungen oder Tracking-Parameter enthalten.
Vor jeder Wildcard-Regel sollten Sie eine Liste realer URLs betrachten. Welche Parameter erzeugen Duplikate? Welche verändern den eigentlichen Seiteninhalt? Welche werden intern verlinkt? Eine pauschale Sperre ist nicht automatisch die beste Lösung, denn sie kann auch das Crawling wertvoller Varianten unterbinden. Häufig sind eine saubere interne Verlinkung, kanonische Angaben und eine konsistente URL-Logik langfristig robuster.
Slash, Groß- und Kleinschreibung sowie Pfadgrenzen übersehen
Pfadangaben müssen zur tatsächlichen URL-Struktur passen. /admin und /administrator sind unterschiedliche Pfade. Ebenso kann /shop je nach Regelwerk nicht dieselbe Bedeutung haben wie /shop/. Eine Regel, die einen Pfad ohne abschließenden Schrägstrich erfasst, sollte deshalb auf ihre Wirkung bei ähnlichen Pfaden geprüft werden.
Auch die Schreibweise kann relevant sein. Wenn der Server zwischen Groß- und Kleinschreibung unterscheidet, sind /Download/ und /download/ nicht zwingend identisch. Verwenden Sie exakt die Pfade, die auf der Website ausgeliefert werden, und prüfen Sie Varianten, Weiterleitungen sowie mögliche alternative URL-Schreibweisen.
Die Sitemap falsch oder veraltet angeben
Ein häufiger Fehler ist eine Sitemap-Adresse, die nicht erreichbar ist, auf eine andere Domain zeigt oder nur für eine frühere Website-Version gilt. Eine Sitemap kann am Ende der robots.txt genannt werden:
Sitemap: https://www.beispiel.de/sitemap.xmlDie absolute URL sollte zur tatsächlichen Domain und zum verwendeten Protokoll passen. Bei einer Website mit mehreren Sprachversionen, Subdomains oder getrennten Sitemaps müssen die Einträge bewusst verwaltet werden. Eine robots.txt auf shop.beispiel.de sollte nicht automatisch auf eine Sitemap einer völlig anderen Host-Adresse verweisen, wenn diese nicht die relevanten URLs enthält.
Die Sitemap ersetzt keine gute interne Verlinkung und hebt eine Disallow-Regel nicht auf. Wenn eine URL in der Sitemap steht und gleichzeitig durch die robots.txt blockiert wird, entsteht ein widersprüchliches Signal. Die Sitemap sollte daher nur URLs enthalten, die erreichbar, technisch gültig und für die Indexierung grundsätzlich vorgesehen sind.
Vertrauliche Inhalte nur durch robots.txt schützen
Eine robots.txt ist öffentlich erreichbar. Jeder kann ihre Inhalte abrufen und daraus ableiten, welche Pfade der Betreiber möglicherweise verborgen halten möchte. Außerdem sind Crawler nicht verpflichtet, freiwillige Regeln einzuhalten. Schadsoftware, aggressive Bots oder neugierige Personen können die Datei ignorieren.
Bereiche mit persönlichen Daten, internen Dokumenten, Administrationsfunktionen oder nicht veröffentlichten Projekten gehören deshalb hinter eine Zugriffskontrolle. Entfernen Sie vertrauliche Dateien vom öffentlich erreichbaren Server oder schützen Sie sie mit geeigneten technischen Maßnahmen. Eine Disallow-Regel kann zusätzlich die Crawl-Steuerung verbessern, ist aber keine Sicherheitsbarriere.
Typische Probleme bei WordPress-Websites
Bei WordPress entsteht die robots.txt häufig dynamisch, sofern keine eigene Datei im Webroot angelegt wurde. Zusätzlich können SEO-Plugins oder Hosting-Konfigurationen Regeln beeinflussen. Dadurch ist nicht immer auf den ersten Blick erkennbar, welche Version tatsächlich ausgeliefert wird.
Prüfen Sie zunächst die öffentlich erreichbare Adresse und vergleichen Sie sie mit den Einstellungen in WordPress sowie im verwendeten Plugin. Nach einem Plugin-Wechsel oder einer Änderung der Lesbarkeitseinstellungen kann sich die Ausgabe verändern. Auch Cache-Systeme und Content-Delivery-Netzwerke können eine ältere Version ausliefern. Änderungen sollten daher nach der Veröffentlichung erneut direkt im Browser und möglichst aus verschiedenen Netzwerkperspektiven kontrolliert werden.
Ein weiterer Fehler ist, die robots.txt als Ersatz für die WordPress-Einstellung zur Sichtbarkeit in Suchmaschinen zu betrachten. Diese Einstellung kann zusätzliche technische Signale auslösen, die nicht mit einer einzelnen Zeile in der robots.txt identisch sind. Bei einem Relaunch sollten deshalb die WordPress-Konfiguration, die robots.txt, Meta-Robots-Anweisungen, Canonical-URLs und die XML-Sitemap gemeinsam geprüft werden.
So prüfen Sie eine robots.txt systematisch
1. Die tatsächlich ausgelieferte Datei abrufen
Beginnen Sie mit der URL der produktiven Domain und rufen Sie die Datei direkt auf. Prüfen Sie dabei auch Varianten mit und ohne www, falls beide Hostnamen erreichbar sind. Eine Weiterleitung kann technisch funktionieren, sollte aber bewusst eingerichtet und zur bevorzugten Domain passend sein.
Achten Sie auf Statuscode, Inhalt, Zeichencodierung und ungewöhnliche Fehlermeldungen. Eine HTML-Fehlerseite anstelle einer Textdatei, ein Serverfehler oder eine unerwartete Weiterleitung sind wichtige Hinweise. Die Datei sollte nicht nur im lokalen Editor korrekt aussehen, sondern auch genau so vom Server ausgeliefert werden.
2. Die wichtigsten URL-Gruppen sammeln
Erstellen Sie eine kleine Prüfliste mit repräsentativen URLs: Startseite, wichtige Kategorie- und Produktseiten, redaktionelle Inhalte, Bilder, CSS- und JavaScript-Ressourcen, Suchergebnisse, Filterseiten, Login-Bereiche und bekannte technische Pfade. Nehmen Sie sowohl URLs auf, die erreichbar sein sollen, als auch solche, die bewusst nicht gecrawlt werden sollen.
Diese Auswahl macht sichtbar, ob eine Regel zu breit oder zu schmal greift. Eine robots.txt sollte nicht abstrakt, sondern anhand konkreter URL-Beispiele bewertet werden. Bei großen Websites können Server-Logs, Crawling-Daten und URL-Listen aus dem CMS die Auswahl unterstützen.
3. Regeln mit Suchmaschinen-Tools und Validatoren vergleichen
Nutzen Sie ein aktuelles Prüfwerkzeug, das die robots.txt-Syntax und die Wirkung auf konkrete URLs nachvollziehbar darstellt. Ein Tool ersetzt jedoch nicht die fachliche Prüfung: Nicht jede Suchmaschine unterstützt jede Erweiterung gleich, und ein Tester bildet möglicherweise nur einen bestimmten User-Agent ab.
Vergleichen Sie die Ergebnisse mit den realen Anforderungen der Website. Wenn ein Tool eine URL als erlaubt meldet, bedeutet das nicht automatisch, dass die Seite indexiert wird. Umgekehrt kann eine blockierte URL weiterhin über externe Links bekannt werden. Für eine belastbare Diagnose müssen Crawling, Indexierung und Zugriffsschutz getrennt betrachtet werden.
4. Googlebot, allgemeine Crawler und Sonderfälle auseinanderhalten
Ein Block für User-agent: * richtet sich grundsätzlich an Crawler, die diesen allgemeinen Block berücksichtigen. Ein zusätzlicher spezifischer Block kann für einen bestimmten Crawler gelten. Dadurch entstehen leicht Missverständnisse, wenn eine Regel für einen User-Agent getestet wird, aber ein anderer Crawler sie anders auswertet.
Definieren Sie spezifische Blöcke nur, wenn es dafür einen klaren Grund gibt. Je mehr Ausnahmen und Agenten enthalten sind, desto schwieriger wird die Datei. Dokumentieren Sie die Absicht hinter Sonderregeln und entfernen Sie sie, sobald der ursprüngliche Anwendungsfall nicht mehr besteht.
5. Nach der Änderung erneut kontrollieren
Speichern Sie die Datei in einer kontrollierten Änderung und prüfen Sie anschließend erneut die Live-Version. Kontrollieren Sie nicht nur die geänderte URL, sondern auch wichtige Nachbarpfade. Eine Änderung an /shop/ kann beispielsweise viele Unterbereiche betreffen.
Beobachten Sie danach die Server-Logs und die Berichte der verfügbaren Suchmaschinen-Werkzeuge. Änderungen an Crawling-Signalen wirken nicht immer sofort. Ein kurzfristig unveränderter Bericht beweist daher weder, dass die Änderung wirkungslos ist, noch dass sie vollständig verarbeitet wurde.
Praktische Entscheidungskriterien für Regeln
Vor einer neuen Disallow-Regel sollten Sie fünf Fragen beantworten:
- Welches konkrete Problem soll gelöst werden? Geht es um Serverlast, URL-Parameter, doppelte Inhalte, interne Suchseiten oder einen nicht öffentlichen Bereich?
- Welche exakten URLs sind betroffen? Beschreiben Sie einige erlaubte und gesperrte Beispiele, statt nur ein allgemeines Verzeichnis zu nennen.
- Ist Crawling-Sperrung wirklich das richtige Mittel? Für vertrauliche Inhalte, Indexierungssteuerung oder technische Fehler können andere Maßnahmen passender sein.
- Welche Nebenwirkungen entstehen? Prüfen Sie Ressourcen, Unterverzeichnisse, Sprachversionen, Weiterleitungen und Links aus Sitemaps.
- Wer pflegt die Regel später? Eine verständliche, kurze Datei mit dokumentierter Absicht ist sicherer als ein kaum nachvollziehbares Geflecht aus Ausnahmen.
Ein gutes Ergebnis ist nicht die längste oder technisch ausgefeilteste robots.txt, sondern eine Datei, deren Regeln eine klar erkennbare Aufgabe erfüllen. Wenn keine belastbare Begründung für eine Sperre existiert, sollte sie nicht allein aus Gewohnheit übernommen werden.
FAQ
Kann eine fehlerhafte robots.txt das Ranking direkt verschlechtern?
Eine falsche Sperre kann verhindern, dass wichtige Inhalte oder benötigte Ressourcen gecrawlt werden. Dadurch können Suchmaschinen Seiten schlechter verstehen oder neue Inhalte später entdecken. Die robots.txt verändert jedoch nicht als direkte Bewertungszahl die Qualität einer Seite. Die konkrete Auswirkung hängt davon ab, welche URLs betroffen sind und welche anderen Signale vorliegen.
Ist Disallow dasselbe wie Noindex?
Nein. Disallow steuert das Crawling und verhindert den Abruf eines Pfads für den jeweiligen Crawler. Noindex ist ein Signal zur Indexierung und kann nur zuverlässig verarbeitet werden, wenn die Seite oder Ressource abgerufen werden darf. Wer eine URL aus dem Index entfernen möchte, sollte daher nicht ausschließlich auf eine robots.txt-Sperre setzen.
Warum sollte ich CSS- und JavaScript-Dateien nicht pauschal sperren?
Diese Ressourcen können für die Darstellung und das Verständnis einer Seite relevant sein. Wenn ein Crawler sie nicht laden darf, kann seine Einschätzung der ausgelieferten Seite unvollständig sein. Sperren Sie technische Dateien nur dann, wenn ein konkreter Grund besteht, und prüfen Sie vorher, ob sie für wichtige Seiten benötigt werden.
Kann die robots.txt geheime Verzeichnisse verstecken?
Nein. Die Datei ist öffentlich und freiwillige Regeln können ignoriert werden. Außerdem macht eine Disallow-Regel einen Pfad nicht unsichtbar, wenn er beispielsweise verlinkt wird. Vertrauliche Bereiche benötigen Zugriffsschutz oder dürfen gar nicht öffentlich ausgeliefert werden.
Wie oft sollte die robots.txt geprüft werden?
Eine feste allgemeine Frist ist weniger wichtig als anlassbezogene Kontrollen. Prüfen Sie die Datei bei Relaunches, Domainwechseln, Änderungen an CMS oder SEO-Plugins, neuen Verzeichnisstrukturen und größeren Änderungen an Sitemaps. Zusätzlich kann eine regelmäßige technische Überwachung sinnvoll sein, damit unerwartete Änderungen schnell auffallen.
Ist eine leere robots.txt problematisch?
Eine leere Datei enthält keine Sperrregeln und lässt Crawler grundsätzlich auf die erreichbaren Pfade zugreifen. Das ist nicht automatisch falsch. Ob die Konfiguration sinnvoll ist, hängt von der Website ab. Auch bei einer leeren Datei bleiben andere Themen wie Indexierungsregeln, URL-Parameter, interne Suchseiten und Zugriffsschutz relevant.
Was bedeutet ein Sternchen bei User-agent oder Wildcards?
Bei User-agent: * steht das Sternchen für einen allgemeinen User-Agent-Block. In Pfadangaben kann ein Sternchen als Platzhalter für Zeichenfolgen verwendet werden, sofern der jeweilige Crawler diese Syntax unterstützt. Weil Wildcards schnell zu weit greifen, sollten sie immer mit konkreten URLs und einem passenden Testwerkzeug überprüft werden.
Fazit: Die robots.txt bewusst und nachvollziehbar pflegen
Die häufigsten Fehler in der robots.txt entstehen durch pauschale Sperren, veraltete Konfigurationen, unpräzise Wildcards und die Verwechslung von Crawling, Indexierung und Sicherheit. Eine wirksame Prüfung beginnt deshalb mit der tatsächlich ausgelieferten Datei und führt über konkrete URL-Beispiele bis zur Kontrolle von Sitemap, Ressourcen und Website-Umgebung.
Halten Sie Regeln so kurz wie möglich, dokumentieren Sie ungewöhnliche Ausnahmen und testen Sie Änderungen nach jedem wichtigen technischen Eingriff erneut. So wird die robots.txt zu einem nachvollziehbaren Bestandteil der technischen Suchmaschinenoptimierung, statt selbst zur Ursache schwer erkennbarer Crawling-Probleme zu werden.