Sitemap bei Google einreichen: Anleitung, Fehlerbehebung und SEO-Tipps

Eine Sitemap hilft Suchmaschinen dabei, wichtige URLs einer Website zu entdecken und ihre Zusammenhänge besser zu verstehen. Besonders bei neuen, umfangreichen oder regelmäßig aktualisierten Websites kann es sinnvoll sein, die Sitemap bei Google einzureichen. Der Vorgang ist unkompliziert, ersetzt jedoch weder hochwertige Inhalte noch eine technisch erreichbare Website.

In diesem Ratgeber erfahren Sie, was eine Sitemap leistet, wie Sie sie in der Google Search Console einreichen, welche Dateiformate geeignet sind und wie Sie typische Fehler systematisch beheben. Außerdem geht es darum, wann eine Einreichung sinnvoll ist und welche Erwartungen realistisch sind.

Was ist eine Sitemap?

Eine Sitemap ist eine maschinenlesbare Datei, in der wichtige URLs einer Website aufgeführt werden. Für klassische Websites wird meist eine XML-Sitemap verwendet. Sie kann Suchmaschinen zusätzliche Hinweise zu Seiten, Beiträgen, Bildern oder Videos geben und die Orientierung in einer größeren Website erleichtern.

Eine XML-Sitemap ist keine vollständige Kopie der Website und auch kein Inhaltsverzeichnis für Besucher. Sie sollte vor allem URLs enthalten, die tatsächlich in den Google-Index aufgenommen werden sollen. Nicht relevante, doppelte, gelöschte oder ausdrücklich gesperrte Seiten gehören in der Regel nicht hinein.

Viele Content-Management-Systeme und SEO-Erweiterungen erzeugen eine Sitemap automatisch. Häufig liegt sie beispielsweise unter einer Adresse wie https://www.beispiel.de/sitemap.xml. Bei manchen Systemen gibt es stattdessen eine Sitemap-Indexdatei, die auf mehrere einzelne Sitemaps verweist.

Warum sollte man eine Sitemap bei Google einreichen?
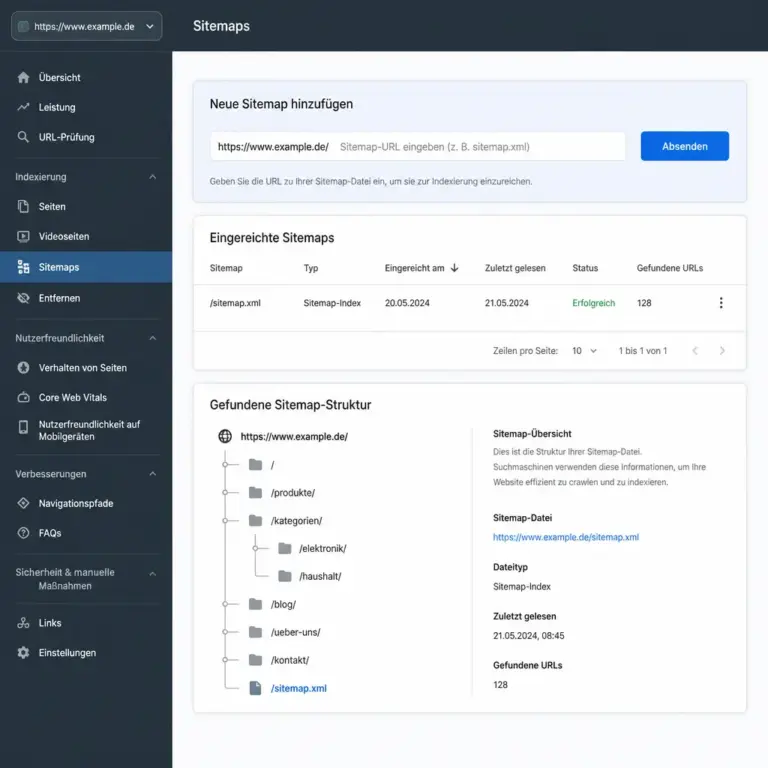
Eingabebereich zum Einreichen einer Sitemap in einer Suchmaschinenverwaltung
Die Sitemap wird über den dafür vorgesehenen Bereich der Search Console übermittelt.

Die Abbildung zeigt, wo der Pfad der Sitemap eingetragen wird und warum die Auswahl der richtigen Website-Property wichtig ist. Leser sollten auf die vollständige URL und den anschließenden Statusbericht achten.

Google kann Sitemaps häufig auch selbst entdecken, etwa über interne Links oder einen Eintrag in der Datei robots.txt. Die manuelle Einreichung über die Google Search Console schafft jedoch einen klaren Kommunikationsweg und liefert zusätzliche Informationen zum Verarbeitungsstatus.

  • Bessere Auffindbarkeit: Neue oder tief verschachtelte URLs können leichter entdeckt werden, sofern sie technisch zugänglich sind.
  • Mehr Übersicht: Die Search Console zeigt, ob Google die angegebene Sitemap abrufen und verarbeiten konnte.
  • Frühere Fehlererkennung: Ungültige URLs, Abrufprobleme oder Formatfehler werden eher sichtbar.
  • Unterstützung bei großen Websites: Viele URLs lassen sich strukturierter an Google übermitteln.
  • Hilfreich bei Änderungen: Nach einem Relaunch oder einer größeren Überarbeitung kann die aktuelle Sitemap die Orientierung unterstützen.

Wichtig ist die richtige Erwartung: Eine eingereichte Sitemap garantiert weder eine Indexierung noch gute Rankings. Google entscheidet für jede URL unabhängig, ob sie gecrawlt, indexiert und in den Suchergebnissen angezeigt wird.

Voraussetzungen vor der Einreichung

Bevor Sie die Sitemap bei Google einreichen, sollten einige Grundlagen stimmen. Dadurch vermeiden Sie, dass die Search Console zwar eine Datei akzeptiert, diese aber viele problematische URLs enthält.

Die richtige Website-Property auswählen

Für die Google Search Console benötigen Sie eine bestätigte Property. Dabei muss die Sitemap zur richtigen Website und zum passenden Protokoll gehören. Eine Sitemap für https://www.beispiel.de sollte nicht versehentlich in einer Property für eine andere Domain oder ausschließlich für http:// eingereicht werden.

Bei Domain-Properties werden mehrere Varianten einer Domain zusammengefasst. Bei URL-Präfix-Properties ist der erfasste Bereich enger. Prüfen Sie deshalb vor dem Absenden, ob Sie sich in der richtigen Property befinden.

Die Sitemap muss erreichbar sein

Rufen Sie die Sitemap zunächst selbst im Browser auf. Sie sollte ohne Login, Blockierung oder Weiterleitungskette erreichbar sein. Eine XML-Datei muss nicht besonders lesefreundlich aussehen; entscheidend ist, dass der Server sie korrekt ausliefert und der Inhalt gültig ist.

Prüfen Sie außerdem, ob die Sitemap nicht versehentlich durch eine Firewall, ein Sicherheits-Plugin oder eine Zugriffsbeschränkung blockiert wird. Bei einer geschützten Entwicklungsumgebung kann Google die Datei nicht zuverlässig abrufen.

Nur kanonische und indexierbare URLs aufnehmen

Die enthaltenen URLs sollten grundsätzlich erreichbar sein und eine sinnvolle Indexierung ermöglichen. Entfernen Sie insbesondere URLs, die auf eine andere Adresse weiterleiten, einen Fehlerstatus liefern oder per noindex von der Indexierung ausgeschlossen sind.

Auch Parameter-URLs, interne Suchergebnisse, Filterkombinationen und nahezu identische Varianten können eine Sitemap unnötig aufblähen. Die Datei sollte die wichtigsten Inhalte priorisieren, nicht jede technisch erzeugbare URL dokumentieren.

Sitemap bei Google einreichen: Schritt für Schritt

Die Einreichung erfolgt in der Google Search Console. Die Bezeichnungen der Oberfläche können sich gelegentlich ändern, das grundlegende Vorgehen bleibt jedoch ähnlich.

1. Google Search Console öffnen

Melden Sie sich mit dem Google-Konto an, das Zugriff auf die betreffende Property besitzt. Wählen Sie anschließend im Auswahlfeld die Website aus, für die Sie die Sitemap einreichen möchten.

2. Zum Bereich für Sitemaps wechseln

Öffnen Sie in der Navigation den Bereich Sitemaps. Dort finden Sie ein Eingabefeld, über das eine neue Sitemap übermittelt werden kann. Bereits bekannte Dateien und deren Status werden meist darunter angezeigt.

3. Sitemap-URL eintragen

Bei vielen Properties tragen Sie nicht die komplette Domain, sondern nur den Pfad der Sitemap ein, zum Beispiel sitemap.xml oder sitemap_index.xml. Achten Sie genau auf Schreibweise, Groß- und Kleinschreibung sowie den verwendeten Dateinamen.

Wenn die Search Console bereits einen Teil der URL vorausfüllt, ergänzen Sie nur den fehlenden Pfad. Prüfen Sie vor dem Absenden, ob die daraus entstehende vollständige Adresse tatsächlich auf die gewünschte Datei zeigt.

4. Übermittlung absenden

Klicken Sie auf die Schaltfläche zum Einreichen. Google versucht anschließend, die Datei abzurufen und zu verarbeiten. Das Ergebnis kann je nach Umfang, Serverreaktion und aktueller Verarbeitung nicht sofort vollständig sichtbar sein.

5. Status kontrollieren

Sehen Sie später erneut im Sitemap-Bericht nach. Ein erfolgreicher Abruf bedeutet, dass Google die Datei erreichen und grundsätzlich verarbeiten konnte. Das ist jedoch nicht dasselbe wie die Indexierung jeder einzelnen enthaltenen URL.

Bei einer Sitemap-Indexdatei kann Google zusätzlich einzelne untergeordnete Sitemaps verarbeiten. Kontrollieren Sie auch diese Einträge, wenn im Bericht Warnungen oder Fehler auftauchen.

Welche Sitemap-Formate unterstützt Google?

Für die meisten Websites ist eine XML-Sitemap die beste Wahl. Sie kann einzelne Seiten-URLs oder Verweise auf weitere Sitemap-Dateien enthalten. Eine Sitemap-Indexdatei ist besonders praktisch, wenn die Website so groß ist, dass mehrere Dateien verwaltet werden müssen.

Je nach Website-Typ können außerdem spezielle Sitemaps für Bilder, Videos oder Nachrichten relevant sein. Sie sind nicht automatisch für jede Website erforderlich. Entscheidend ist, ob der betreffende Inhalt tatsächlich einen zusätzlichen strukturierten Hinweis benötigt und ob das verwendete System ihn korrekt erzeugt.

Eine HTML-Seite mit einer Liste von Links ist keine XML-Sitemap im engeren Sinn. Sie kann für Besucher und interne Verlinkung nützlich sein, wird aber in der Search Console nicht wie eine XML-Sitemap behandelt.

Was gehört in eine gute XML-Sitemap?

Eine gute Sitemap ist aktuell, übersichtlich und auf wertvolle Inhalte konzentriert. Für jede URL sollten mehrere Kriterien erfüllt sein:

  • Die Adresse verwendet das bevorzugte Protokoll, üblicherweise HTTPS.
  • Die URL ist mit dem Statuscode 200 erreichbar oder wird technisch korrekt ausgeliefert.
  • Die Seite ist nicht durch noindex ausgeschlossen.
  • Die URL entspricht der bevorzugten kanonischen Version.
  • Der Inhalt ist für Nutzer relevant und nicht bloß eine technische Variante.
  • Die Datei enthält keine veralteten oder dauerhaft entfernten Adressen.

Das Änderungsdatum einer URL, häufig als lastmod angegeben, sollte nur gepflegt werden, wenn sich der wesentliche Inhalt tatsächlich geändert hat. Ein bei jedem Aufruf automatisch aktualisiertes Datum liefert keinen verlässlichen Hinweis und kann die Aussagekraft der Sitemap schwächen.

Die Prioritätsangaben und Änderungsfrequenzen, die manche Generatoren anbieten, sind kein Ersatz für eine gute Website-Struktur. Verwenden Sie solche Angaben nur, wenn Ihr System sie sinnvoll und konsistent erzeugt.

Typische Fehler beim Einreichen einer Sitemap

Wenn Google eine Sitemap nicht verarbeiten kann, liegt die Ursache häufig nicht bei der Search Console selbst. Prüfen Sie die Datei und die betroffenen URLs in mehreren Schritten.

Die Sitemap wurde nicht gefunden

Eine Meldung wie Sitemap konnte nicht abgerufen werden kann auf eine falsche URL, einen Serverfehler, eine Blockierung oder eine kurzfristige Nichterreichbarkeit hindeuten. Öffnen Sie die Datei im Browser und prüfen Sie zusätzlich die Server- und Sicherheitsprotokolle.

Ungültiges XML oder falsche Kodierung

XML verlangt eine korrekte Struktur. Nicht maskierte Sonderzeichen, beschädigte Zeichenkodierungen, zusätzliche Inhalte vor der XML-Deklaration oder fehlerhafte Tags können die Verarbeitung verhindern. Lassen Sie die Datei gegebenenfalls mit einem geeigneten XML-Prüfwerkzeug validieren.

URLs aus einer anderen Domain

Die Sitemap sollte zum vorgesehenen Website-Bereich passen. Verweise auf eine fremde Domain oder eine nicht passende Subdomain können zu Warnungen führen. Prüfen Sie auch, ob www- und non-www-Varianten sowie HTTP und HTTPS konsistent verwendet werden.

Weiterleitungen und Fehlerseiten

Eine Sitemap mit vielen Weiterleitungen, nicht gefundenen Seiten oder Serverfehlern ist ein deutliches Wartungssignal. Aktualisieren Sie den Generator, entfernen Sie gelöschte URLs und ersetzen Sie alte Adressen durch ihre aktuelle kanonische Version.

Die Sitemap ist blockiert

Die Datei darf nicht durch robots.txt, Zugriffsschutz oder eine Serverregel unerreichbar sein. Die robots.txt kann zusätzlich die vollständige Sitemap-Adresse nennen, etwa mit einer Zeile wie Sitemap: https://www.beispiel.de/sitemap.xml. Das ersetzt die Einreichung in der Search Console nicht zwingend, verbessert aber die Auffindbarkeit.

Sitemap nach einem Relaunch oder einer Migration

Nach einem Domainwechsel, einer Umstellung auf HTTPS oder einer neuen URL-Struktur sollten Sie besonders sorgfältig vorgehen. Richten Sie zunächst die passenden Properties in der Search Console ein und stellen Sie sicher, dass die neue Sitemap ausschließlich die neuen, erreichbaren URLs enthält.

Weiterleitungen von alten auf neue Adressen sollten dauerhaft und inhaltlich passend eingerichtet werden. Eine Sitemap mit alten URLs hilft nach einer Migration nur begrenzt. Sie sollte vielmehr den aktuellen Zielzustand abbilden, während interne Links, kanonische Angaben und Weiterleitungen konsistent auf die neue Struktur verweisen.

Bei einer größeren Umstellung empfiehlt sich eine technische Prüfung nach dem Livegang. Kontrollieren Sie unter anderem wichtige Statuscodes, die robots.txt, Canonical-Tags, interne Verlinkung und die Abdeckung relevanter Seiten. Die Sitemap ist dabei ein Kontrollinstrument, aber keine vollständige Relaunch-Prüfung.

Wie oft sollte man eine Sitemap einreichen?

Eine Sitemap muss normalerweise nicht nach jeder kleinen Änderung erneut eingereicht werden. Wenn die Datei unter derselben URL automatisch aktualisiert wird, kann Google die Änderungen bei späteren Abrufen erkennen.

Eine erneute Übermittlung kann sinnvoll sein, wenn sich der Dateipfad geändert hat, eine neue Sitemap-Indexdatei verwendet wird oder die Website nach einer größeren technischen Änderung aktualisiert wurde. Das wiederholte Einreichen derselben unveränderten Datei beschleunigt die Indexierung nicht automatisch.

Wichtiger als häufiges Absenden sind eine stabile Erreichbarkeit, korrekte URLs und eine nachvollziehbare Website-Struktur. Für einzelne besonders wichtige neue Seiten kann zusätzlich die Funktion zur Prüfung einer einzelnen URL in der Search Console relevant sein. Auch sie garantiert jedoch keine sofortige Aufnahme in den Index.

Sitemap und SEO: Was sie leisten und was nicht

Eine Sitemap verbessert nicht direkt die Qualität eines Textes, die Nutzererfahrung oder die Autorität einer Website. Sie kann Google jedoch helfen, bereits vorhandene Inhalte effizienter zu entdecken. Der größte Nutzen entsteht deshalb, wenn die technischen Grundlagen und die Inhalte gleichzeitig gepflegt werden.

Für eine nachhaltige Suchmaschinenoptimierung sind unter anderem klare interne Links, hilfreiche und eigenständige Inhalte, eine gute mobile Darstellung, kurze Ladezeiten sowie verständliche Seitentitel und Beschreibungen wichtig. Eine Sitemap kann diese Maßnahmen ergänzen, aber nicht ersetzen.

Bei kleinen Websites mit gut verlinkten Seiten ist der zusätzliche Effekt oft begrenzt. Bei großen Onlineshops, Nachrichtenseiten, Portalen, vielen Beiträgen oder neuen Websites mit wenigen externen Verweisen kann eine gepflegte Sitemap dagegen besonders nützlich sein.

Praktische Checkliste für die Einreichung

  • Ist die richtige Property in der Google Search Console ausgewählt?
  • Ist die Sitemap-URL ohne Login und ohne unerwartete Blockierung erreichbar?
  • Enthält die Datei nur aktuelle, kanonische und indexierbare URLs?
  • Verwendet die Sitemap die richtige Domain- und Protokollvariante?
  • Sind Weiterleitungen, Fehlerseiten und gelöschte URLs entfernt?
  • Ist die XML-Struktur gültig?
  • Wird ein realistisches Änderungsdatum verwendet?
  • Wurde der Status nach der Übermittlung kontrolliert?
  • Passt die Sitemap zur aktuellen Website-Struktur und zum letzten Relaunch?

Wenn Sie diese Punkte regelmäßig prüfen, wird die Sitemap zu einem verlässlichen Bestandteil der technischen Website-Pflege. Bei sehr großen Websites kann es zusätzlich sinnvoll sein, Sitemaps nach Inhaltstyp, Verzeichnis oder Aktualität zu strukturieren, solange die Aufteilung nachvollziehbar bleibt.

FAQ

Muss jede Website eine Sitemap haben?

Nein. Kleine, gut intern verlinkte Websites können auch ohne manuell eingereichte Sitemap gefunden werden. Sie ist dennoch eine sinnvolle Ergänzung, wenn viele URLs, häufige Änderungen, neue Inhalte oder eine komplexe Struktur vorliegen.

Garantiert das Einreichen die Indexierung?

Nein. Die Sitemap übermittelt Hinweise zu URLs, garantiert aber weder Crawling noch Indexierung oder Rankings. Google bewertet zusätzlich technische Zugänglichkeit, Qualität, Eigenständigkeit, Relevanz und weitere Signale.

Wo finde ich die Sitemap meiner WordPress-Website?

Viele WordPress-Installationen stellen automatisch eine Sitemap bereit. Je nach Version, Theme oder Erweiterung kann der Pfad unterschiedlich sein. Prüfen Sie die Einstellungen Ihrer Website und rufen Sie die vermutete Adresse direkt auf. Vermeiden Sie es, mehrere konkurrierende Sitemap-Systeme unkontrolliert parallel zu betreiben.

Kann ich mehrere Sitemaps einreichen?

Ja. Das kann bei großen Websites oder verschiedenen Inhaltstypen sinnvoll sein. Häufig wird dafür eine Sitemap-Indexdatei verwendet, die auf einzelne Dateien verweist. Jede Datei sollte korrekt aufgebaut sein und einen klar abgegrenzten URL-Bestand enthalten.

Was bedeutet der Status „Erfolgreich“?

Der Status zeigt in der Regel, dass Google die Sitemap abrufen und verarbeiten konnte. Er bestätigt nicht, dass jede enthaltene URL indexiert wurde. Für einzelne Seiten müssen Sie die Indexierungsinformationen separat betrachten.

Wie lange dauert es, bis Google die Sitemap verarbeitet?

Das lässt sich nicht pauschal vorhersagen. Die Verarbeitung hängt unter anderem von Serververfügbarkeit, Umfang und Aktualität der Website ab. Eine Sitemap ist ein Hinweis, kein Auftrag zur sofortigen Indexierung.

Ist eine Sitemap für Bilder oder Videos immer nötig?

Nein. Spezielle Sitemaps können bei umfangreichen Bild- oder Videobeständen hilfreich sein, sind aber nicht für jede Website erforderlich. Entscheidend ist, ob sie zusätzliche, korrekt gepflegte Informationen liefern und vom verwendeten System zuverlässig erzeugt werden.

Fazit: Sitemap gezielt und sauber einreichen

Eine Sitemap bei Google einzureichen ist schnell erledigt, wenn die Datei korrekt erzeugt wird und die richtige Search-Console-Property ausgewählt ist. Der nachhaltige Nutzen entsteht jedoch erst durch eine laufende Pflege: Die Sitemap sollte aktuelle, erreichbare und tatsächlich relevante URLs enthalten.

Kontrollieren Sie nach der Einreichung den Verarbeitungsstatus, beheben Sie technische Fehler und betrachten Sie die Sitemap als Teil eines größeren SEO-Prozesses. Gute Inhalte, sinnvolle interne Verlinkung und eine stabile technische Grundlage bleiben entscheidend dafür, dass Google Ihre Website nicht nur findet, sondern ihre Seiten auch sinnvoll bewerten kann.
Noindex richtig verwenden: Anleitung für WordPress und SEO

Das Meta-Tag noindex ist ein präzises Werkzeug für die Suchmaschinenoptimierung. Es teilt Suchmaschinen mit, dass eine bestimmte Seite nicht in den Suchergebnissen erscheinen soll. Richtig eingesetzt, hilft es dabei, dünne, doppelte oder intern wenig hilfreiche Inhalte aus dem Suchindex herauszuhalten. Falsch eingesetzt, kann es jedoch wichtige Seiten unsichtbar machen.

In diesem Ratgeber erfahren Sie, wann Noindex richtig verwenden sinnvoll ist, wie sich noindex von robots.txt und einem Canonical-Tag unterscheidet und wie Sie die Einstellung in WordPress kontrolliert umsetzen. Außerdem finden Sie eine praktische Prüfliste, typische Fehler und Antworten auf häufige Fragen.

Was bedeutet „noindex“?

noindex ist eine Anweisung im HTML-Code einer Seite oder im HTTP-Header. Sie richtet sich an Suchmaschinen-Crawler und bedeutet sinngemäß: Diese URL soll nicht in den Suchergebnissen gelistet werden.

Die häufigste Variante steht im <head>-Bereich des Dokuments:

<meta name="robots" content="noindex, follow">

Die Kombination noindex, follow verhindert die Aufnahme der Seite in den Index, erlaubt aber grundsätzlich weiterhin das Verfolgen von Links auf dieser Seite. Alternativ kann eine Seite mit noindex, nofollow versehen werden. Damit wird zusätzlich signalisiert, dass Links auf der Seite nicht verfolgt werden sollen.

Für die meisten redaktionellen Anwendungsfälle ist noindex, follow die differenziertere Einstellung. Sie sollten nofollow nicht pauschal ergänzen, nur weil eine Seite selbst nicht indexiert werden soll.

Wann ist Noindex sinnvoll?

Noindex eignet sich für URLs, die technisch erreichbar oder intern nützlich sind, aber keinen eigenständigen Wert für Suchende haben. Entscheidend ist nicht, ob eine Seite existiert, sondern ob sie als eigenständiges Suchergebnis hilfreich wäre.

Typische Anwendungsfälle

  • Interne Suchergebnisse: Suchseiten mit frei kombinierbaren Suchbegriffen liefern häufig wechselnde oder sehr ähnliche Inhalte.
  • Filter- und Sortier-URLs: Parameter wie Farbe, Größe, Sortierung oder Ansicht können zahlreiche Varianten derselben Seite erzeugen.
  • Doppelte Archivseiten: Datums-, Autoren- oder Schlagwortarchive sind nicht automatisch problematisch, können aber bei geringer eigener Aussagekraft entbehrlich sein.
  • Interne Hilfsseiten: Bestellbestätigungen, Warenkörbe, Login-Seiten oder bestimmte Kontoansichten sind normalerweise keine sinnvollen öffentlichen Suchergebnisse.
  • Test- und Übergangsseiten: Vor der Veröffentlichung kann eine Seite vorübergehend aus dem Suchindex herausgehalten werden.
  • Inhalte mit sehr geringem eigenständigem Nutzen: Dazu können automatisch erzeugte Übersichten oder fast leere Taxonomien gehören.

Die Entscheidung sollte immer URL für URL oder anhand einer klar definierten Regel getroffen werden. Eine pauschale Noindex-Regel für ganze Verzeichnisse oder Inhaltstypen kann leicht wertvolle Seiten erfassen.

Noindex, robots.txt und Canonical im Vergleich

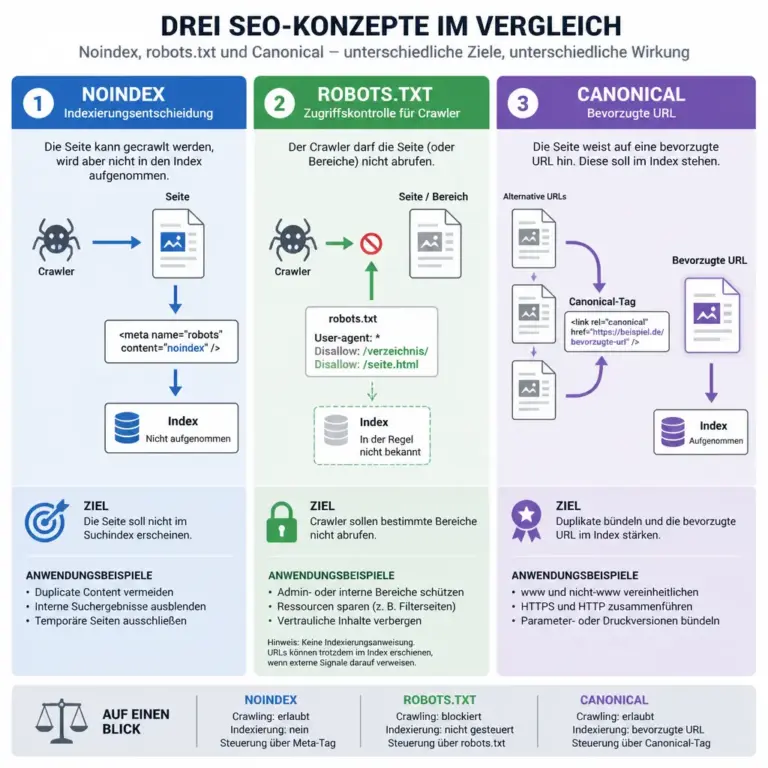
Vergleich von Noindex, robots.txt und Canonical in einer SEO-Infografik
Die drei Signale erfüllen unterschiedliche Aufgaben bei der technischen SEO.

Die Grafik macht sichtbar, dass Noindex, robots.txt und Canonical nicht austauschbar sind. Besonders wichtig ist die Trennung zwischen Zugriff auf eine URL und ihrer Aufnahme in den Suchindex.

Diese drei SEO-Maßnahmen werden häufig verwechselt, verfolgen aber unterschiedliche Ziele. Eine gute technische Strategie beginnt damit, ihre Funktionen sauber zu trennen.

Maßnahme Hauptzweck Wichtiger Hinweis
noindex Eine URL soll nicht in den Suchindex aufgenommen oder dort entfernt werden. Die Suchmaschine muss die Anweisung abrufen können, um sie zuverlässig zu sehen.
robots.txt Crawler sollen bestimmte Bereiche möglichst nicht abrufen. Eine blockierte URL kann dadurch daran gehindert werden, ein Noindex-Signal auszulesen.
Canonical Eine bevorzugte URL unter mehreren ähnlichen oder doppelten Varianten angeben. Ein Canonical ist ein Hinweis, keine Garantie für die Auswahl durch die Suchmaschine.

Wenn eine URL sicher nicht indexiert werden soll, darf sie nicht zugleich in der robots.txt blockiert sein, sofern die Suchmaschine das Noindex-Signal noch auslesen muss. Die beiden Maßnahmen lösen unterschiedliche Probleme: Die Datei robots.txt steuert den Zugriff, während noindex die Indexierung betrifft.

Ein Canonical ist dagegen oft besser geeignet, wenn mehrere URL-Varianten denselben wichtigen Inhalt darstellen und eine Hauptversion in den Suchergebnissen erscheinen soll. Noindex wäre in diesem Fall möglicherweise zu streng, weil damit auch eine eigenständige Suchintention verloren gehen kann.

Noindex richtig verwenden: Entscheidungskriterien

Bevor Sie eine Seite auf Noindex setzen, helfen einige konkrete Fragen. Sie verhindern, dass die Einstellung nur als schnelle Lösung für ein ungeklärtes Strukturproblem dient.

1. Hat die URL eine eigene Suchintention?

Prüfen Sie, ob Nutzer nach genau diesem Inhalt suchen könnten und ob die Seite diese Erwartung erfüllt. Eine eigenständige Kategorie mit verständlicher Beschreibung kann wertvoll sein. Eine automatisch erzeugte Kombination aus drei Filtern ist dagegen oft kein sinnvolles Ziel für die organische Suche.

2. Ist der Inhalt ausreichend vollständig?

Eine kurze Seite ist nicht automatisch schlecht. Problematisch wird es, wenn sie die Frage des Nutzers nicht beantwortet, fast ausschließlich aus Navigation besteht oder nur minimale Unterschiede zu vielen anderen URLs aufweist. In manchen Fällen ist eine Überarbeitung die bessere Lösung als Noindex.

3. Gibt es eine bessere Haupt-URL?

Wenn mehrere Seiten denselben Zweck erfüllen, sollten Sie entscheiden, ob eine URL gestärkt und die anderen zusammengeführt, per Canonical bevorzugt oder aus dem Index ausgeschlossen werden sollen. Noindex ist nicht automatisch die richtige Maßnahme gegen jede Form von Duplicate Content.

4. Brauchen Besucher diese Seite direkt?

Eine nicht indexierte Seite kann weiterhin über interne Links, Lesezeichen oder direkte Verweise erreichbar sein. Das ist bei Konto-, Warenkorb- oder Bestätigungsseiten sinnvoll. Prüfen Sie aber, ob sensible Inhalte wirklich angemessen geschützt sind: Noindex ist kein Zugriffsschutz.

5. Soll die Einstellung dauerhaft gelten?

Bei einer temporären Baustelle ist es wichtig, später eine Wiedervorlage einzuplanen. Bei dauerhaft unnötigen URLs können Sie zusätzlich die interne Verlinkung, URL-Struktur oder Erzeugungslogik verbessern.

Noindex in WordPress umsetzen

In WordPress wird Noindex meist über ein SEO-Plugin, die Einstellungen des jeweiligen Inhaltstyps oder eine individuelle technische Konfiguration gesetzt. Die genaue Bezeichnung kann je nach Plugin und Version abweichen. Suchen Sie nach Optionen wie „Suchmaschinen erlauben, diesen Beitrag in den Suchergebnissen anzuzeigen?“ oder „Indexierung erlauben“.

Einzelne Seite oder einzelnen Beitrag ausschließen

  1. Öffnen Sie den betreffenden Beitrag oder die Seite im WordPress-Editor.
  2. Rufen Sie die SEO-Einstellungen des Dokuments auf.
  3. Deaktivieren Sie die Option, die eine Indexierung erlaubt, beziehungsweise wählen Sie „noindex“.
  4. Speichern oder aktualisieren Sie den Inhalt.
  5. Rufen Sie den Quelltext der veröffentlichten URL auf und suchen Sie nach noindex.

Verlassen Sie sich nicht ausschließlich auf die Anzeige im Editor. Entscheidend ist, was die öffentlich ausgelieferte URL tatsächlich enthält. Caching, mehrere SEO-Erweiterungen oder individuelle Theme-Funktionen können die Ausgabe beeinflussen.

Archiv- und Taxonomieseiten steuern

Für Kategorien, Schlagwörter, Autoren- oder Datumsarchive bieten viele Plugins globale Einstellungen. Hier ist besondere Vorsicht erforderlich. Eine sinnvolle Kategorieübersicht kann Suchenden Orientierung geben und sollte nicht allein deshalb auf Noindex stehen, weil sie ein Archiv ist.

Bewerten Sie zunächst die Qualität und Funktion der jeweiligen Archivart. Wenn Sie eine Taxonomie dauerhaft nicht benötigen, kann das Entfernen oder Zusammenführen leerer Begriffe besser sein. Wenn die Archive intern nützlich, aber für Suchmaschinen nicht relevant sind, ist Noindex eine mögliche kontrollierte Einstellung.

Robots-Meta-Tag und X-Robots-Tag

HTML-Dokumente verwenden häufig das Robots-Meta-Tag im <head>. Bei nicht-HTML-Dateien wie PDF-Dokumenten kann der Server stattdessen einen HTTP-Header ausliefern:

X-Robots-Tag: noindex

Die technische Umsetzung des Headers hängt vom Webserver, dem Hosting und der verwendeten Infrastruktur ab. Änderungen an Serverregeln sollten Sie erst nach einer Sicherung und mit einer nachvollziehbaren Rückfallmöglichkeit durchführen. Bei Unsicherheit ist die Dokumentation des Hosters oder die Unterstützung einer fachkundigen Person sinnvoll.

Kontrolle und Prüfung nach der Änderung

Eine Noindex-Einstellung ist erst dann zuverlässig bewertet, wenn Sie die veröffentlichte Ausgabe und die technischen Rahmenbedingungen kontrollieren. Arbeiten Sie am besten mit einer kleinen, wiederholbaren Prüfroutine.

  • Quelltext prüfen: Suchen Sie nach einem Robots-Meta-Tag und kontrollieren Sie, ob es tatsächlich noindex enthält.
  • HTTP-Antwort prüfen: Bei Dateien und speziellen Konfigurationen kann ein X-Robots-Tag relevant sein.
  • Robots.txt kontrollieren: Stellen Sie sicher, dass die URL nicht blockiert wird, wenn das Noindex-Signal noch abgerufen werden muss.
  • Interne Links prüfen: Entfernen Sie unnötige Links zu ausgeschlossenen Seiten, ohne wichtige Nutzerwege zu zerstören.
  • Sitemap prüfen: Nicht indexierbare URLs sollten normalerweise nicht in der XML-Sitemap stehen. Die genaue Sitemap-Konfiguration hängt vom System ab.
  • Weiterleitungen und Canonicals ansehen: Eine Noindex-Seite sollte nicht versehentlich gleichzeitig auf eine andere URL weiterleiten oder ein widersprüchliches Canonical ausgeben.
  • Nachkontrolle einplanen: Caches, Plugin-Updates und Template-Änderungen können technische Signale verändern.

Eine URL-Prüfung in einem Suchmaschinen-Tool kann zusätzliche Hinweise liefern. Dabei sollten Sie die dort angezeigten Informationen als Diagnosehilfe verstehen und mit dem tatsächlich ausgelieferten Quelltext abgleichen. Die Entfernung einer bereits bekannten URL aus einem Index kann außerdem zeitversetzt erfolgen.

Häufige Fehler beim Einsatz von Noindex

Die komplette Website auf Noindex setzen

Ein falsch gesetztes globales Robots-Signal kann alle wichtigen Inhalte betreffen. Prüfen Sie deshalb nach Änderungen an Theme, SEO-Plugin oder Hosting besonders die Startseite, wichtige Landingpages, Kategorien und Beiträge.

Noindex mit Zugriffsschutz verwechseln

Jede Person, die die URL kennt oder über einen Link erreicht, kann eine nicht indexierte Seite weiterhin aufrufen, sofern keine Authentifizierung oder andere Schutzmaßnahme greift. Für vertrauliche Inhalte benötigen Sie einen echten Zugriffsschutz.

Die URL in robots.txt sperren und Noindex erwarten

Wenn ein Crawler eine URL wegen der robots.txt nicht abrufen darf, sieht er möglicherweise auch das Meta-Tag nicht. Eine Sperre kann deshalb die gewünschte Verarbeitung des Noindex-Signals verhindern.

Wichtige Inhalte wegen geringer Wortzahl ausschließen

Die Länge allein entscheidet nicht über den Nutzen. Eine kompakte Kontakt-, Produkt- oder Hilfeseite kann für Besucher sehr relevant sein. Bewerten Sie Inhalt, Suchintention, Aktualität und Nutzerführung gemeinsam.

Noindex als Ersatz für eine schlechte Informationsarchitektur nutzen

Wenn tausende Filter-URLs entstehen, ist es oft besser, die URL-Erzeugung, interne Verlinkung und Crawling-Steuerung grundsätzlich zu analysieren. Noindex kann eine sinnvolle Maßnahme sein, sollte aber nicht die einzige Antwort auf strukturelle Probleme bleiben.

Praktische Noindex-Checkliste

Die folgende Checkliste eignet sich für einzelne Seiten ebenso wie für größere WordPress-Bereinigungen:

  1. Definieren Sie, warum die konkrete URL nicht in den Suchergebnissen erscheinen soll.
  2. Prüfen Sie, ob Überarbeitung, Zusammenlegung, Weiterleitung oder Canonical die passendere Lösung wäre.
  3. Setzen Sie Noindex gezielt auf der betroffenen URL oder in einer klar begrenzten Regel.
  4. Vermeiden Sie widersprüchliche Einstellungen in SEO-Plugin, Theme, Server und robots.txt.
  5. Entfernen Sie die URL aus der XML-Sitemap, sofern sie dort nicht benötigt wird.
  6. Kontrollieren Sie Meta-Tag oder HTTP-Header in der veröffentlichten Version.
  7. Dokumentieren Sie den Grund und prüfen Sie bei temporären Maßnahmen ein Ablaufdatum.
  8. Beobachten Sie wichtige Seiten nach Plugin-, Theme- oder Serveränderungen erneut.

FAQ

Ist Noindex schlecht für SEO?

Nein. Noindex ist zunächst eine Steuerungsanweisung. Sie kann SEO unterstützen, wenn unwichtige oder nicht eigenständige URLs aus dem Index herausgehalten werden. Problematisch wird sie nur, wenn relevante Seiten versehentlich ausgeschlossen werden.

Kann eine Noindex-Seite weiterhin aufgerufen werden?

Ja. Noindex verhindert grundsätzlich die Aufnahme in Suchergebnisse, sperrt aber nicht den direkten Zugriff. Für private oder geschützte Inhalte brauchen Sie Authentifizierung, Berechtigungen oder eine andere geeignete Zugriffskontrolle.

Soll ich noindex mit nofollow kombinieren?

Nicht automatisch. Wenn die Seite selbst nicht indexiert werden soll, Links darauf aber weiterhin für die interne Navigation relevant sind, kann noindex, follow passender sein. Die Wahl hängt vom Zweck der Seite und Ihrer Linkstrategie ab.

Wie unterscheidet sich Noindex von einem Canonical?

Noindex weist darauf hin, dass eine URL nicht gelistet werden soll. Ein Canonical nennt dagegen eine bevorzugte Version aus mehreren ähnlichen URLs. Wenn eine Variante weiterhin als Suchergebnis infrage kommt, kann ein Canonical die passendere Lösung sein.

Kann ich Noindex in der robots.txt eintragen?

Nein, noindex ist kein regulärer Ersatz für eine Robots.txt-Regel. Das Signal wird typischerweise im HTML-Meta-Tag oder über den X-Robots-Tag im HTTP-Header übertragen. Die robots.txt steuert vor allem, welche URLs ein Crawler abrufen darf.

Wie schnell verschwindet eine URL aus dem Index?

Das lässt sich nicht pauschal festlegen. Die Suchmaschine muss die URL erneut abrufen und das Signal verarbeiten. Eine Änderung im Quelltext führt daher nicht zwingend sofort zu einer sichtbaren Änderung der Suchergebnisse.

Soll eine Noindex-Seite aus der Sitemap entfernt werden?

In der Regel ja, weil eine XML-Sitemap bevorzugt URLs enthalten sollte, die Suchmaschinen indexieren dürfen und sollen. Prüfen Sie jedoch die konkrete Sitemap-Konfiguration und beheben Sie die Ursache, wenn ausgeschlossene URLs automatisch wieder aufgenommen werden.

Fazit: Noindex gezielt statt pauschal einsetzen

Noindex richtig verwenden bedeutet, die Anweisung als präzises Steuerungswerkzeug zu betrachten. Nicht jede kurze, doppelte oder technisch erzeugte URL muss automatisch ausgeschlossen werden. Entscheidend sind Suchintention, eigenständiger Nutzen, Zugriffszweck und die Frage, ob eine andere SEO-Maßnahme besser passt.

Setzen Sie Noindex möglichst gezielt, vermeiden Sie Konflikte mit robots.txt und Canonical, prüfen Sie die tatsächlich ausgelieferte Version und dokumentieren Sie wichtige Änderungen. So bleibt Ihre WordPress-Website für Besucher zugänglich, während der Suchindex auf die Inhalte konzentriert wird, die dort wirklich einen eigenständigen Beitrag leisten.

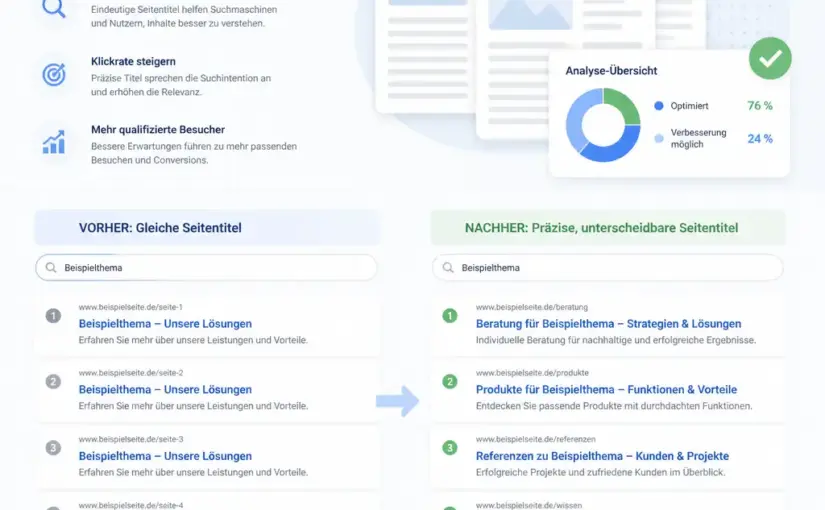
Doppelte Seitentitel vermeiden: Der umfassende Ratgeber für klare SEO-Strukturen

Doppelte Seitentitel wirken auf den ersten Blick wie ein kleines redaktionelles Problem. In größeren Websites können sie jedoch die Orientierung von Besuchern erschweren, die Pflege von Inhalten verkomplizieren und Suchmaschinen wichtige Unterscheidungssignale nehmen. Besonders häufig entstehen identische Titel durch Vorlagen, automatisch erzeugte Archivseiten, Varianten von Produkten oder mehrfach verwendete Seitentitel in einem Content-Management-System.

Dieser Ratgeber zeigt, wie Sie doppelte Seitentitel systematisch erkennen, ihre Ursachen finden und dauerhaft vermeiden. Dabei geht es sowohl um den sichtbaren Titel einer Seite als auch um den SEO-Titel im HTML-Dokument. Beide Elemente sollten verständlich, eindeutig und passend zur jeweiligen Suchintention sein.

Was sind doppelte Seitentitel?

Von doppelten Seitentiteln spricht man, wenn mehrere Seiten einer Website denselben oder nahezu denselben Titel verwenden. Das kann unterschiedliche Elemente betreffen:

  • Den sichtbaren Seitentitel: Er steht meist als Überschrift am Anfang des Inhalts und hilft Besuchern bei der Orientierung.
  • Den SEO-Titel oder Title-Tag: Er wird im HTML-Code hinterlegt und häufig in Suchergebnissen sowie im Browser-Tab angezeigt.
  • Den Titel in Übersichten: Dazu gehören beispielsweise Karten, Listen, Breadcrumbs, Kategorien oder interne Suchergebnisse.

Ein gleicher Titel ist nicht automatisch ein technischer Fehler. Zwei Seiten können beispielsweise denselben kurzen Oberbegriff benötigen, wenn sie unterschiedliche Funktionen haben. Problematisch wird es, wenn Nutzer und Suchmaschinen anhand des Titels nicht erkennen können, worin der Unterschied zwischen den Seiten liegt.

Ein Beispiel: Eine Website besitzt zwei Ratgeber mit den Titeln „Laufschuhe“ und „Laufschuhe“. Einer behandelt die Auswahl für Anfänger, der andere die Pflege von Laufschuhen. Der gemeinsame Titel sagt nicht, welche Frage jeweils beantwortet wird. Präzisere Titel wie „Laufschuhe für Anfänger auswählen“ und „Laufschuhe richtig pflegen“ schaffen sofort mehr Klarheit.

Warum sollten Sie doppelte Seitentitel vermeiden?

Bessere Orientierung für Besucher

Ein aussagekräftiger Titel ist eine wichtige Entscheidungshilfe. Menschen scannen Suchergebnisse, Übersichtsseiten und Browser-Tabs meist sehr schnell. Sind mehrere Einträge gleich benannt, müssen sie zusätzliche Informationen aus dem Umfeld heranziehen. Das kostet Zeit und erhöht die Wahrscheinlichkeit, dass sie die falsche Seite öffnen oder die Website wieder verlassen.

Eindeutige Titel machen dagegen schon vor dem Klick deutlich, welches Thema, welches Produkt, welcher Ort oder welche Zielgruppe gemeint ist. Das verbessert die Verständlichkeit auf Desktop- und Mobilgeräten gleichermaßen.

Mehr Kontrolle über Suchergebnisse

Der Title-Tag gehört zu den Signalen, mit denen Suchmaschinen den Inhalt einer Seite einordnen. Ein Titel allein entscheidet nicht über die Platzierung. Er sollte jedoch den Seiteninhalt präzise zusammenfassen und die Suchintention widerspiegeln. Wenn mehrere URLs denselben Titel besitzen, fehlt ein direkt sichtbares Unterscheidungsmerkmal.

Außerdem können Suchmaschinen einen Titel aus dem Seitentext oder anderen Elementen ableiten oder anpassen, wenn der hinterlegte Titel nicht passend erscheint. Eine klare, individuelle Benennung liefert dafür eine bessere Grundlage.

Weniger Fehler bei der Website-Pflege

Doppelte Titel weisen oft auf ein strukturelles Problem hin: eine kopierte Vorlage, unvollständige Datenfelder oder eine unklare Seitenhierarchie. Wer diese Ursache behebt, verhindert nicht nur aktuelle Duplikate, sondern reduziert auch spätere Pflegefehler. Das ist besonders wichtig bei Websites mit vielen Autoren, Produkten, Standorten oder automatisch generierten Seiten.

Die häufigsten Ursachen für doppelte Seitentitel

Bevor Sie Titel überarbeiten, sollten Sie herausfinden, wie die Duplikate entstehen. Die Ursache bestimmt, welche Lösung nachhaltig ist.

  • Kopierte Inhalte: Eine neue Seite wird aus einer bestehenden Seite dupliziert, der Titel bleibt unverändert.
  • Unvollständige Vorlagen: Eine Vorlage setzt für viele Seiten denselben Standardtitel ein.
  • Produktvarianten: Farbe, Größe oder Ausführung werden in der Titelbildung nicht berücksichtigt.
  • Standortseiten: Mehrere lokale Seiten tragen nur die Bezeichnung des Angebots, nicht aber den jeweiligen Ort.
  • Archiv- und Kategorieseiten: Automatisch erzeugte Übersichten verwenden allgemeine oder mehrfach belegte Begriffe.
  • Paginierte Seiten: Seiten wie „Blog“, „Blog“ oder „Produkte“, „Produkte“ erhalten identische Metadaten.
  • Mehrsprachige Inhalte: Übersetzungen übernehmen den Titel der Ausgangssprache oder unterscheiden sich nicht ausreichend.
  • Technische URLs: Parameter, Filter oder Sortierungen erzeugen mehrere Adressen mit einer identischen Bezeichnung.

Ein häufiger Sonderfall sind Seiten, die zwar verschiedene URLs, aber denselben Inhalt besitzen. Hier reicht eine Titeländerung möglicherweise nicht aus. Dann müssen zusätzlich die Seitenstruktur, kanonische Verweise, Weiterleitungen oder die Indexierbarkeit geprüft werden.

So erkennen Sie doppelte Seitentitel systematisch

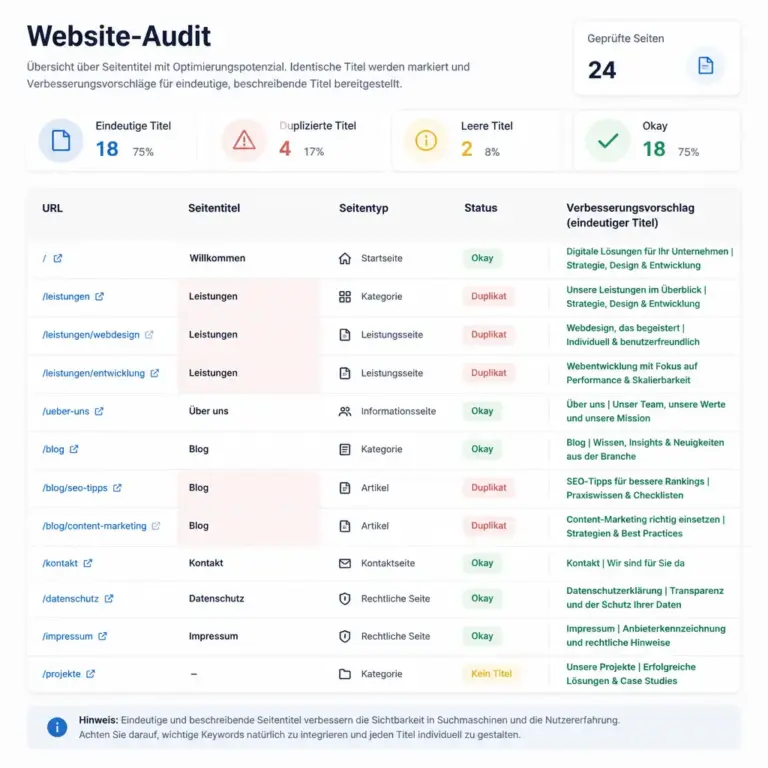
Tabelle zur systematischen Pru00fcfung doppelter Seitentitel
Eine strukturierte Übersicht macht doppelte Seitentitel schnell sichtbar.

Die Darstellung zeigt, welche Felder bei einer Prüfung erfasst werden sollten. Besonders hilfreich ist der direkte Vergleich von URL, sichtbarem Titel und SEO-Titel, weil dadurch redaktionelle und technische Duplikate getrennt betrachtet werden können.

1. Alle relevanten URLs erfassen

Beginnen Sie mit einer vollständigen Übersicht der indexierbaren oder potenziell indexierbaren URLs. Berücksichtigen Sie nicht nur redaktionelle Seiten, sondern auch Produkte, Kategorien, Beiträge, Autorenarchive, Suchseiten und gegebenenfalls Sprachversionen. Eine einfache Tabelle kann bereits genügen.

Erfassen Sie mindestens die URL, den sichtbaren Seitentitel, den SEO-Titel, den Seitentyp, den Status der Seite und die geplante Maßnahme. Wichtig ist, dass Sie zwischen tatsächlich öffentlichen Seiten und rein technischen URLs unterscheiden.

2. Titel gruppieren und vergleichen

Sortieren Sie die Übersicht nach dem sichtbaren Titel und anschließend nach dem SEO-Titel. Identische Werte werden dadurch schnell sichtbar. Prüfen Sie danach auch ähnliche Varianten. Titel wie „Winterreifen kaufen“, „Winterreifen kaufen | Shop“ und „Winterreifen kaufen – Angebote“ sind nicht buchstabengetreu gleich, können aber inhaltlich zu wenig differenzieren.

Achten Sie außerdem auf abgeschnittene Titel. Ein Titel kann im Quelltext individuell sein, in der Darstellung aber immer mit demselben Anfang erscheinen. Der wichtigste Unterschied sollte daher möglichst früh im Titel stehen.

3. Inhalt und Suchintention prüfen

Ein Duplikat ist nicht allein durch den Textvergleich zu bewerten. Vergleichen Sie die eigentlichen Aufgaben der Seiten:

  • Beantworten beide Seiten dieselbe Frage?
  • Richten sie sich an dieselbe Zielgruppe?
  • Geht es um dasselbe Produkt, denselben Ort oder dieselbe Variante?
  • Ist eine Seite eine Übersicht und die andere ein Detailinhalt?
  • Gibt es einen nachvollziehbaren Grund, beide URLs dauerhaft zu behalten?

Diese Prüfung verhindert, dass Sie unterschiedliche Seiten nur deshalb zusammenlegen, weil sie einen ähnlichen Begriff verwenden. Gleichzeitig zeigt sie, wann ein neuer, präziser Titel allein nicht genügt.

Gute Seitentitel formulieren

Ein guter Titel verbindet Klarheit, Genauigkeit und einen natürlichen Bezug zum Inhalt. Er sollte keine bloße Ansammlung von Suchbegriffen sein, sondern eine kurze Inhaltsangabe.

Das wichtigste Unterscheidungsmerkmal zuerst

Beginnen Sie mit dem Begriff, der die Seite von ähnlichen Seiten abgrenzt. Bei lokalen Angeboten ist das häufig der Ort, bei Ratgebern die konkrete Fragestellung und bei Produkten die relevante Ausführung. Beispiele:

Unklarer Titel Präziser Titel
Photovoltaik Photovoltaik für Einfamilienhäuser planen
Steuererklärung Steuererklärung für Selbstständige vorbereiten
Seminare Online-Seminare für Projektmanagement
Restaurant Restaurant in Köln: Abendessen und Reservierung

Die Beispiele zeigen: Der Titel muss nicht möglichst viele Begriffe enthalten. Er sollte vor allem die zentrale Frage oder den konkreten Seitenzweck sichtbar machen.

Sichtbaren Titel und SEO-Titel aufeinander abstimmen

Der sichtbare Seitentitel und der SEO-Titel müssen nicht wortgleich sein. Sie sollten aber dieselbe Aussage unterstützen. Wenn der SEO-Titel ein Versprechen enthält, das der sichtbare Inhalt nicht einlöst, entsteht eine unnötige Erwartungslücke.

Eine mögliche Struktur lautet: Hauptthema – konkreter Nutzen oder Kontext | Markenname. Die Marke kann am Ende stehen, sofern sie zur Website-Strategie passt. Für sehr lange Titel ist eine kürzere Form meist besser als eine künstliche Aneinanderreihung von Begriffen.

Keine austauschbaren Standardzusätze

Formulierungen wie „Startseite“, „Willkommen“, „Informationen“ oder „Produktseite“ unterscheiden Inhalte kaum. Auch ein automatisch angehängter Markenname macht aus identischen Seitentiteln keine wirklich eindeutigen Titel. Der individuelle Teil muss den Seiteninhalt beschreiben.

Praktische Lösungen nach Seitentyp

Ratgeber und Blogbeiträge

Bei redaktionellen Inhalten sollte der Titel die konkrete Frage oder den Nutzen nennen. Verwenden Sie nicht für mehrere Beiträge denselben Oberbegriff. Statt „Dach“ können beispielsweise „Dach dämmen: Materialien und Vorgehen“ und „Dach reinigen: Was Eigentümer beachten sollten“ geeignete Abgrenzungen sein.

Wenn mehrere Beiträge dasselbe Thema behandeln, prüfen Sie zusätzlich die redaktionelle Überschneidung. Manchmal ist ein umfassender Leitfaden sinnvoller als mehrere sehr ähnliche Seiten.

Produkte und Varianten

Bei Produkten sollte aus dem Titel hervorgehen, welche Variante gemeint ist. Abhängig vom Katalog können Farbe, Größe, Material, Modell oder Einsatzbereich relevant sein. Übernehmen Sie jedoch nicht jedes technische Attribut automatisch. Berücksichtigen Sie nur Merkmale, die für die Auswahl und die Suchintention tatsächlich bedeutsam sind.

Wenn Varianten keine eigenständige Such- oder Kaufentscheidung darstellen, kann eine gemeinsame Produktseite mit auswählbaren Optionen die übersichtlichere Lösung sein. Die Entscheidung hängt von Sortiment, Nutzerführung und der technischen Struktur ab.

Kategorien und Übersichten

Kategorieseiten brauchen einen Titel, der den enthaltenen Bereich beschreibt. Prüfen Sie, ob Kategorien sich klar voneinander abgrenzen und ob ihre Namen in Navigation, Breadcrumbs und SEO-Titeln konsistent verwendet werden. Eine Kategorie mit dem Titel „Zubehör“ ist häufig zu allgemein; „Zubehör für Campingkocher“ kann die Einordnung erleichtern.

Lokale und regionale Seiten

Für lokale Seiten sollte der Ortsbezug eindeutig sein. Verwenden Sie nicht einfach denselben Titel für alle Filialen. Eine Struktur wie „Physiotherapie in Münster – Leistungen und Termininfo“ unterscheidet sich klar von „Physiotherapie in Osnabrück – Leistungen und Termininfo“. Dabei sollten die Inhalte der Seiten tatsächlich einen relevanten lokalen Bezug haben.

Was tun, wenn doppelte Titel bereits vorhanden sind?

Gehen Sie nicht sofort in alphabetischer Reihenfolge durch alle Titel. Priorisieren Sie nach Bedeutung und Risiko:

  1. Wichtige Seiten bestimmen: Beginnen Sie mit Seiten, die für Besucher, Geschäftsziele oder die interne Navigation besonders relevant sind.
  2. Inhalte vergleichen: Entscheiden Sie, ob die URLs unterschiedliche Aufgaben erfüllen oder ob eine Zusammenführung sinnvoll ist.
  3. Titel individuell überarbeiten: Ergänzen Sie das zentrale Unterscheidungsmerkmal und stimmen Sie den sichtbaren Titel ab.
  4. Überflüssige Seiten behandeln: Je nach Situation kommen eine Weiterleitung, eine Zusammenlegung, ein kanonischer Verweis oder eine andere technische Lösung infrage.
  5. Interne Links aktualisieren: Verlinken Sie wichtige Seiten mit verständlichen Linktexten und vermeiden Sie widersprüchliche Bezeichnungen.
  6. Änderungen kontrollieren: Prüfen Sie nach der Veröffentlichung Quelltext, Darstellung, interne Suche und relevante Übersichten.

Eine Zusammenlegung sollte den Nutzwert erhöhen. Kopieren Sie nicht einfach beide Inhalte hintereinander, sondern ordnen Sie Informationen, entfernen Sie Wiederholungen und setzen Sie gegebenenfalls eine Weiterleitung von der alten URL auf die bevorzugte Seite.

Typische Fehler beim Vermeiden doppelter Seitentitel

  • Nur den SEO-Titel ändern: Wenn die sichtbare Überschrift unverändert bleibt, bleibt die Orientierung auf der Seite möglicherweise schlecht.
  • Keyword-Ketten verwenden: Viele Begriffe machen einen Titel nicht automatisch präziser.
  • Alle Seiten zwanghaft umbenennen: Ähnliche Titel können sinnvoll sein, wenn die Seiten klar unterschiedliche Unterthemen behandeln.
  • Nur die Startseite prüfen: Duplikate entstehen häufig in Archiven, Filtern, Varianten und automatisch erzeugten Bereichen.
  • URL und Titel verwechseln: Eine neue URL beseitigt keine inhaltliche Überschneidung.
  • Automatisierung ungeprüft übernehmen: Vorlagen sparen Zeit, benötigen aber Regeln für Sonderfälle.
  • Änderungen ohne Dokumentation durchführen: Eine einfache Änderungsübersicht hilft, Entscheidungen später nachzuvollziehen.

Ein dauerhaftes System für eindeutige Seitentitel

Die beste Lösung ist ein Prozess, der bereits bei der Erstellung neuer Inhalte greift. Legen Sie zunächst eine Benennungslogik fest. Sie kann je nach Website beispielsweise Thema, Zielgruppe, Ort, Produktmerkmal oder Suchintention enthalten.

Erstellen Sie anschließend eine kurze redaktionelle Checkliste:

  • Beschreibt der Titel den konkreten Inhalt?
  • Ist er von bestehenden Titeln eindeutig unterscheidbar?
  • Steht das wichtigste Merkmal früh genug?
  • Passt der SEO-Titel zur sichtbaren Überschrift?
  • Entspricht der Titel der tatsächlichen Suchintention?
  • Wurde geprüft, ob die URL bereits eine ähnliche Seite besitzt?

Für Websites mit vielen Einträgen können Vorlagen sinnvoll sein. Sie sollten Felder wie Seitentyp, Thema, Ort und Variante getrennt verwalten, statt einen festen Titel zu erzwingen. So lässt sich aus strukturierten Daten ein individueller Titel erzeugen. Sonderfälle müssen redaktionell überprüfbar bleiben.

Planen Sie außerdem regelmäßige Kontrollen ein. Nach größeren Importen, Migrationen, Übersetzungen oder Änderungen an Templates ist eine erneute Prüfung besonders sinnvoll. Entscheidend ist nicht, dass jeder Titel völlig anders klingt, sondern dass jede relevante Seite verständlich und eindeutig eingeordnet werden kann.

FAQ

Sind doppelte Seitentitel immer ein SEO-Problem?

Nein. Ein identischer Titel führt nicht automatisch zu einer Abstrafung. Er ist jedoch ein Warnsignal für fehlende Differenzierung oder eine unklare Seitenstruktur. Prüfen Sie, ob die Seiten unterschiedliche Inhalte und Suchintentionen besitzen und ob Besucher sie anhand der Titel auseinanderhalten können.

Wie unterscheiden sich Seitentitel und Überschrift?

Der SEO-Titel, meist Title-Tag genannt, steht im HTML-Dokument und kann in Suchergebnissen sowie im Browser-Tab erscheinen. Die Überschrift ist im sichtbaren Seiteninhalt zu sehen. Beide Elemente haben unterschiedliche Aufgaben, sollten aber inhaltlich zusammenpassen und keine widersprüchlichen Erwartungen erzeugen.

Reicht es, jedem Titel den Markennamen anzuhängen?

In der Regel nicht. Der Markenname kann zur Wiedererkennung beitragen, unterscheidet aber zwei Seiten mit demselben Haupttitel kaum. Entscheidend ist ein individueller Bezug zum Thema, zur Variante, zum Ort oder zur konkreten Frage.

Wie lang sollte ein SEO-Titel sein?

Es gibt keine dauerhaft gültige Zeichengrenze, die für jede Darstellung passt. Die sichtbare Länge hängt unter anderem von Gerät, Schrift und Suchoberfläche ab. Formulieren Sie den Titel so kurz wie nötig und so konkret wie möglich. Das wichtigste Unterscheidungsmerkmal sollte nicht erst am Ende stehen.

Kann eine automatische Titelvorlage doppelte Titel verhindern?

Sie kann das Risiko verringern, wenn sie relevante Felder wie Thema, Ort oder Variante einbezieht. Eine Vorlage ersetzt aber keine Qualitätskontrolle. Leere Felder, ungewöhnliche Seitentypen und sehr ähnliche Inhalte können weiterhin zu unklaren oder doppelten Titeln führen.

Was ist bei mehrsprachigen Websites zu beachten?

Jede Sprachversion sollte einen natürlichen Titel in der jeweiligen Sprache besitzen. Eine direkte Übernahme des Ausgangstitels kann unverständlich wirken oder inhaltlich nicht zur lokalen Suchintention passen. Prüfen Sie außerdem, ob Sprachversionen technisch korrekt miteinander verknüpft und nicht versehentlich doppelt veröffentlicht werden.

Sollten ähnliche Seiten zusammengelegt werden?

Das hängt vom Inhalt und vom Zweck der URLs ab. Wenn zwei Seiten dieselbe Frage beantworten und keine klare eigenständige Funktion besitzen, kann eine Zusammenlegung sinnvoll sein. Haben sie unterschiedliche Zielgruppen oder Suchintentionen, sind individuelle Titel und eine klare interne Verlinkung meist die bessere Lösung.

Fazit: Eindeutige Titel sind Teil einer guten Informationsarchitektur

Doppelte Seitentitel zu vermeiden bedeutet mehr, als einzelne Textfelder umzubenennen. Sie brauchen eine Übersicht der URLs, eine Prüfung der Inhalte und eine klare Benennungslogik. Präzise Titel helfen Besuchern bei der Orientierung, geben Suchmaschinen bessere Kontextsignale und machen die redaktionelle Pflege zuverlässiger.

Starten Sie mit den wichtigsten Seiten, unterscheiden Sie sichtbare Überschriften von SEO-Titeln und behandeln Sie technische Duplikate nicht ausschließlich mit redaktionellen Änderungen. Wenn Vorlagen, Prüfungen und Verantwortlichkeiten festgelegt sind, werden eindeutige Seitentitel zu einem dauerhaften Bestandteil Ihrer Website-Qualität.