Eine Sitemap ist kein sichtbares Gütesiegel und auch kein direkter Garant für bessere Rankings. Dennoch gehört sie für die meisten Websites zu den wichtigsten technischen Grundlagen der Suchmaschinenoptimierung. Sie hilft Suchmaschinen dabei, relevante URLs zu entdecken, die Struktur einer Website besser zu verstehen und Änderungen effizienter zu verarbeiten.
In diesem Ratgeber erfahren Sie, warum jede Website eine Sitemap braucht, welche Sitemap-Arten es gibt, wann sie besonders wichtig ist und wie Sie eine Sitemap sinnvoll erstellen, prüfen und dauerhaft pflegen. Dabei geht es nicht nur um Suchmaschinen: Eine gut geplante Sitemap kann auch die interne Organisation und die technische Qualität eines Webauftritts verbessern.
Was ist eine Sitemap?
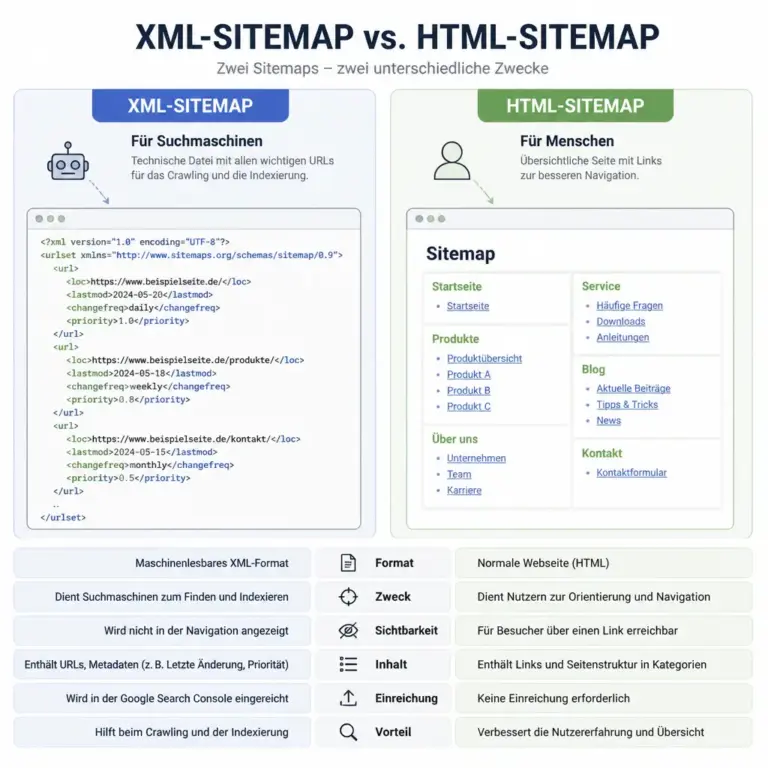
Die Abbildung macht sichtbar, dass beide Sitemap-Arten unterschiedliche Aufgaben erfüllen. Die technische Liste ist nicht als Ersatz für die sichtbare Navigation gedacht.
Eine Sitemap ist eine strukturierte Übersicht wichtiger Seiten, Dateien oder Inhalte einer Website. Im Zusammenhang mit Suchmaschinen ist meist die XML-Sitemap gemeint. Sie wird in einem standardisierten Format bereitgestellt und enthält vor allem URLs, die von Suchmaschinen gefunden und berücksichtigt werden sollen.
Eine XML-Sitemap kann zusätzliche Informationen enthalten, beispielsweise den Zeitpunkt der letzten wesentlichen Änderung. Diese Angaben sind Hinweise, keine Anweisungen. Eine Suchmaschine entscheidet selbst, welche URL sie crawlt, wie häufig sie sie besucht und ob sie in den Suchindex aufgenommen wird.
Daneben gibt es die HTML-Sitemap. Sie richtet sich hauptsächlich an Besucherinnen und Besucher und stellt wichtige Bereiche einer Website als übersichtliche Linkliste dar. Bei kleinen Websites ist eine HTML-Sitemap nicht immer erforderlich, bei umfangreichen oder komplex strukturierten Angeboten kann sie jedoch die Orientierung erleichtern.
Wichtig ist die Unterscheidung zwischen einer Sitemap und der Navigation. Die Navigation dient der täglichen Nutzung durch Menschen. Die XML-Sitemap dient vor allem dazu, Suchmaschinen und anderen technischen Systemen eine zusätzliche, strukturierte Orientierung zu geben. Sie ersetzt weder eine logische Menüführung noch eine gute interne Verlinkung.
Warum jede Website eine Sitemap braucht
Die zentrale Aufgabe einer Sitemap besteht darin, wichtige URLs auffindbar zu machen. Suchmaschinen folgen zwar Links und entdecken dadurch viele Inhalte, doch dieser Prozess ist nicht bei jeder Website gleich zuverlässig. Neue, tief verschachtelte, selten verlinkte oder technisch schwer erreichbare Seiten können leichter übersehen werden.
Neue Inhalte schneller auffindbar machen
Wenn ein Blogartikel, eine Produktseite oder ein wichtiger Ratgeber veröffentlicht wird, muss eine Suchmaschine zunächst von dieser URL erfahren. Eine automatisch aktualisierte Sitemap kann die neue Seite als Teil des vorhandenen Inhaltsbestands sichtbar machen. Das bedeutet nicht, dass die URL sofort gecrawlt oder indexiert wird. Die Entdeckung wird jedoch grundsätzlich erleichtert.
Besonders nützlich ist das bei Websites, auf denen regelmäßig neue Inhalte entstehen. Dazu zählen Nachrichtenportale, Onlineshops, Wissensdatenbanken, Veranstaltungsseiten und große Unternehmenswebsites. Auch eine kleine Website profitiert davon, wenn zentrale neue Seiten nicht lange nur über wenige interne Links erreichbar sind.
Große Websites besser strukturieren
Bei mehreren Hundert oder Tausenden von URLs wird die technische Kontrolle anspruchsvoller. Eine Sitemap kann dabei helfen, den vorgesehenen Inhaltsbestand von zufälligen oder unwichtigen URLs zu trennen. So lässt sich leichter prüfen, ob wichtige Bereiche enthalten sind und ob sich unerwartete URLs eingeschlichen haben.
Eine Sitemap ist deshalb auch ein Kontrollinstrument für Betreiber. Wer regelmäßig überprüft, welche URLs darin stehen, erkennt häufig technische Probleme: versehentlich veröffentlichte Testseiten, veraltete Produktadressen, fehlerhafte Weiterleitungen oder Seiten, die trotz ihrer Bedeutung nicht erfasst werden.
Websites mit schwacher interner Verlinkung unterstützen
Eine Sitemap kann fehlende interne Links nicht reparieren. Sie kann aber als zusätzliche Entdeckungshilfe dienen, wenn bestimmte Seiten nur wenige eingehende Links besitzen. Das betrifft beispielsweise Landingpages aus Kampagnen, Archive, Filterkombinationen oder spezielle Informationsseiten.
Die richtige Schlussfolgerung lautet daher nicht: „Mit einer Sitemap sind interne Links überflüssig.“ Besser ist: „Die Sitemap ergänzt eine starke interne Verlinkung.“ Wichtige Inhalte sollten weiterhin von passenden, gut erreichbaren Seiten aus verlinkt werden.
Technische Änderungen transparenter machen
Bei Migrationen, Relaunches oder umfangreichen Überarbeitungen ist eine Sitemap besonders hilfreich. Sie kann nach dem Umzug die neue URL-Struktur abbilden und als Grundlage für Kontrollen dienen. Gemeinsam mit Weiterleitungen, einer aktuellen internen Verlinkung und einer technischen Prüfung entsteht ein belastbareres Bild der Website.
Auch nach größeren Änderungen sollte geprüft werden, ob nur die gewünschten URLs in der Sitemap stehen. Eine veraltete Sitemap mit alten Adressen kann die technische Auswertung erschweren und unnötige Signale senden.
XML-Sitemap, HTML-Sitemap und Bild-Sitemap im Vergleich
| Sitemap-Art | Hauptzweck | Typische Zielgruppe | Besonderheit |
|---|---|---|---|
| XML-Sitemap | Wichtige URLs strukturiert mitteilen | Suchmaschinen und technische Systeme | Für SEO und Crawling besonders relevant |
| HTML-Sitemap | Inhalte als übersichtliche Linkliste zeigen | Besucherinnen und Besucher | Kann Orientierung und interne Verlinkung verbessern |
| Bild-Sitemap | Relevante Bilder zusätzlich beschreiben | Bildersuchsysteme | Vor allem bei bildorientierten Websites interessant |
| Video-Sitemap | Videoinhalte strukturiert kennzeichnen | Suchmaschinen | Für umfangreiche Videobibliotheken sinnvoll |
Die meisten Websites benötigen zunächst eine gepflegte XML-Sitemap. Bild- oder Video-Sitemaps sind keine Pflicht für jedes Projekt. Sie können sich lohnen, wenn Bilder oder Videos einen wesentlichen Teil des Angebots ausmachen und technisch relevante Zusatzinformationen vorhanden sind.
Welche URLs gehören in eine Sitemap?
In eine XML-Sitemap gehören grundsätzlich die kanonischen, öffentlich erreichbaren URLs, die für Nutzerinnen und Nutzer einen eigenständigen Wert haben. Dazu zählen beispielsweise Startseiten, wichtige Leistungsseiten, Ratgeber, redaktionelle Beiträge, Produktseiten und relevante Kategorieseiten.
Nicht jede technisch erreichbare URL sollte aufgenommen werden. Eine Sitemap ist keine vollständige Liste aller Adressen, die ein Server ausliefern kann. Sie sollte vielmehr den gewünschten, qualitativ relevanten Bestand der Website abbilden.
Geeignete URLs
- Seiten mit einem erfolgreichen Serverstatus, normalerweise einer erreichbaren HTML-Antwort.
- Indexierbare Inhalte, die nicht ausdrücklich von Suchmaschinen ausgeschlossen werden.
- Kanonische URLs, auf die keine andere Adresse als bevorzugte Version verweist.
- Inhalte, die für die Zielgruppe nützlich und dauerhaft relevant sind.
- Neue oder wesentlich aktualisierte Seiten, sofern sie weiterhin veröffentlicht bleiben sollen.
Ungeeignete URLs
- Seiten mit einer Weiterleitung oder einem Fehlerstatus.
- URLs mit einem Ausschluss durch Robots-Meta-Angaben oder andere technische Vorgaben.
- Doppelte Inhalte, alternative Parameter-Varianten und interne Suchergebnisse.
- Warenkorb-, Kassen-, Login- oder persönliche Kontoseiten.
- Temporäre Testseiten, Vorschauen und nicht fertige Entwürfe.
- Seiten, die zwar technisch existieren, aber keinen eigenständigen Nutzen bieten.
Eine wichtige Qualitätsprüfung lautet: Würde diese URL auch dann für Suchmaschinen relevant sein, wenn sie über einen normalen Link entdeckt wird? Wenn die Antwort klar nein lautet, gehört sie meist nicht in die Sitemap.
Wie wird eine Sitemap erstellt?
Der beste Weg hängt vom verwendeten System und vom Umfang der Website ab. Viele Content-Management-Systeme erzeugen automatisch eine Sitemap. Häufig ist sie unter einer Adresse wie /sitemap.xml erreichbar. Bei größeren Websites kann das System mehrere Sitemap-Dateien erstellen und über eine Sitemap-Indexdatei miteinander verbinden.
Bei einer manuellen Erstellung werden die gewünschten URLs in einem gültigen XML-Format hinterlegt. Das ist für kleine, selten veränderte Websites möglich, erfordert aber regelmäßige Pflege. Schon eine einzelne veraltete oder falsch formatierte Adresse kann die Qualität der Datei beeinträchtigen.
Bei dynamischen Websites ist eine automatische Generierung meist sinnvoller. Sie sollte jedoch nicht blind aktiviert werden. Manche Erweiterungen nehmen standardmäßig Archive, Parameterseiten oder andere URL-Typen auf, die nicht zum gewünschten Index gehören. Die Einstellungen sollten deshalb nach der Einrichtung kontrolliert werden.
Worauf sollte das XML-Format achten?
Eine XML-Sitemap muss technisch gültig sein und die vorgesehenen Elemente korrekt verwenden. URLs sollten vollständig angegeben werden und die tatsächliche bevorzugte Version der Adresse darstellen. Einheitlichkeit ist wichtig: Werden beispielsweise sichere und unsichere Protokollvarianten oder verschiedene Hostnamen vermischt, entsteht unnötige Unklarheit.
Das Änderungsdatum sollte nur dann aktualisiert werden, wenn sich der Inhalt tatsächlich wesentlich verändert hat. Ein tägliches Aktualisieren aller URLs ohne inhaltlichen Grund liefert keinen verlässlichen Hinweis. Auch die optionale Angabe einer Priorität sollte nicht als direkte Rankingsteuerung missverstanden werden.
Sitemap bei Suchmaschinen einreichen
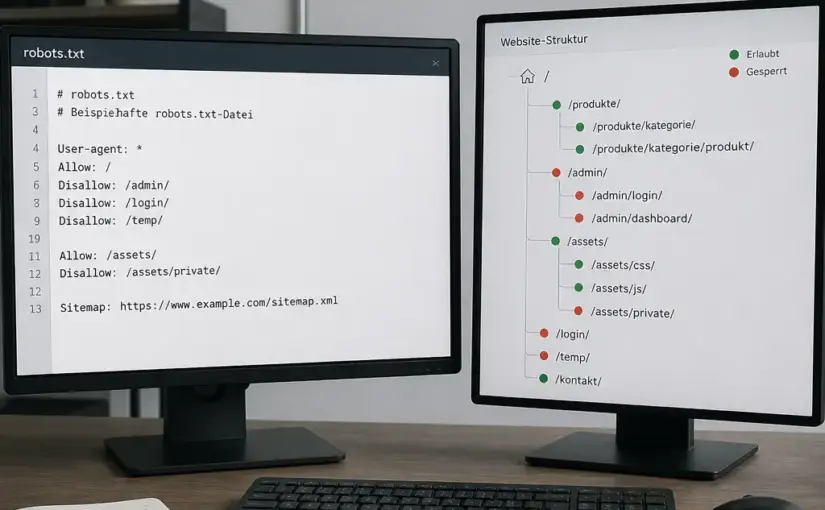
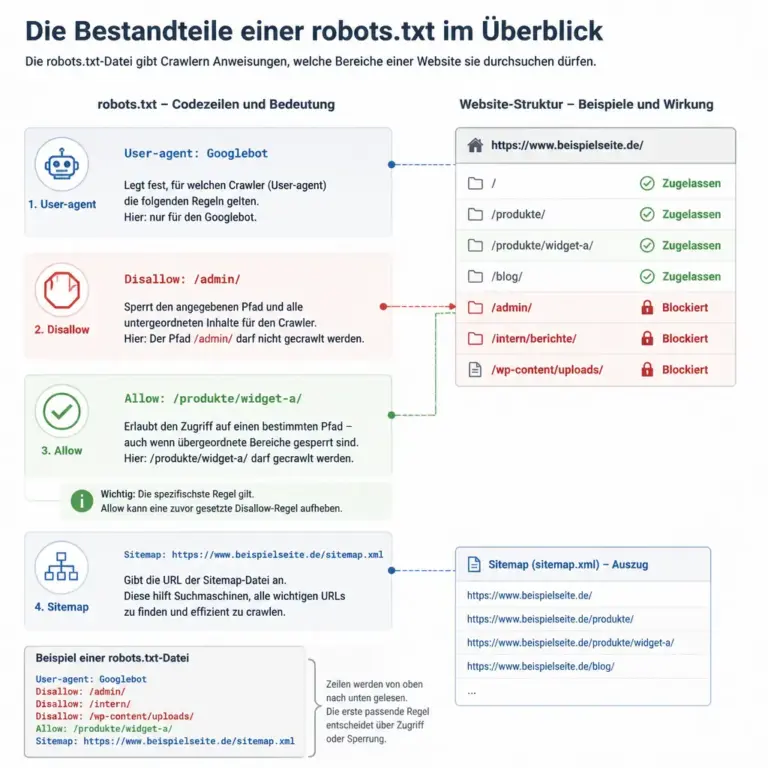
Eine Sitemap kann über die robots.txt referenziert werden. Dort wird die vollständige URL der Datei angegeben. Zusätzlich kann sie in den jeweiligen Bereichen für Website-Verwaltung und Suchanalyse eingereicht werden. Das erleichtert die Zuordnung zur richtigen Website und stellt häufig nützliche Statusinformationen bereit.
Das Einreichen bedeutet nicht, dass jede enthaltene Seite indexiert wird. Es teilt vielmehr mit, welche URLs der Betreiber als relevant betrachtet. Suchmaschinen vergleichen diese Angaben mit ihren eigenen Erkenntnissen, etwa mit gefundenen Links, Statuscodes, Weiterleitungen und Qualitätsmerkmalen.
Nach einer Einreichung sollten Betreiber auf Warnungen und Fehler achten. Ein einzelner Fehler in einer Datei ist nicht automatisch ein schweres Problem. Wiederkehrende Abweichungen zwischen Sitemap und tatsächlichem Websitezustand deuten jedoch auf Pflege- oder Konfigurationsbedarf hin.
Sitemap und Crawling: Was sie leisten kann und was nicht
Eine Sitemap verbessert die Möglichkeit, URLs zu entdecken. Sie garantiert weder Crawling noch Indexierung und schon gar nicht eine bestimmte Position in den Suchergebnissen. Suchmaschinen bewerten unter anderem die Zugänglichkeit, den Inhalt, die interne Verlinkung, technische Signale und die erwartete Bedeutung einer Seite.
Auch die Crawling-Belastung wird durch eine Sitemap nicht automatisch gelöst. Wenn eine Website sehr viele minderwertige oder doppelte URLs enthält, sollte das Problem an der URL-Struktur gelöst werden. Eine Sitemap, die lediglich alle vorhandenen Adressen auflistet, kann die Übersicht sogar verschlechtern.
Für eine gute technische Grundlage sollten deshalb mehrere Elemente zusammenpassen:
- eine klare Informationsarchitektur,
- relevante interne Links,
- korrekte Statuscodes und Weiterleitungen,
- eine konsistente Canonical-Konfiguration,
- eine sinnvolle Steuerung von indexierbaren und nicht indexierbaren Bereichen,
- eine aktuelle, fehlerarme Sitemap.
Die Sitemap ist damit ein wichtiges Puzzleteil, aber kein Ersatz für eine insgesamt saubere Website.
Besondere Fälle: kleine Websites, Onlineshops und Relaunches
Kleine Unternehmenswebsite
Bei einer kleinen Website mit wenigen, gut verlinkten Seiten ist eine Sitemap nicht immer zwingend erforderlich. Trotzdem ist sie meist mit geringem Aufwand verfügbar und schafft eine zusätzliche technische Absicherung. Gerade bei Änderungen oder einem späteren Ausbau kann sie wertvoll sein.
Blog oder redaktionelles Portal
Regelmäßig wachsende Websites profitieren besonders von einer automatisch gepflegten Sitemap. Neue Beiträge, Kategorien und Aktualisierungen sollten nach einer passenden Strategie berücksichtigt werden. Alte Inhalte sollten nicht automatisch entfernt werden, wenn sie weiterhin nützlich und erreichbar sind.
Onlineshop
Shops müssen besonders sorgfältig zwischen wertvollen Produktseiten und wenig hilfreichen URL-Varianten unterscheiden. Filter, Sortierungen, Suchergebnisse und Sitzungsparameter können eine große Zahl ähnlicher Adressen erzeugen. In die Sitemap gehören in der Regel die gewünschten, kanonischen Produkt- und Kategorieseiten, nicht jede Filterkombination.
Website-Relaunch
Vor einem Relaunch sollte bekannt sein, welche URLs künftig bestehen bleiben, geändert oder entfernt werden. Nach dem Start muss die Sitemap die neue Struktur abbilden. Alte Adressen gehören nicht einfach weiter in die neue Datei, sondern sollten passend weitergeleitet oder bewusst mit einem geeigneten Status beendet werden.
Sitemap regelmäßig prüfen und pflegen
Eine Sitemap ist nur dann dauerhaft nützlich, wenn sie dem tatsächlichen Websitezustand entspricht. Für kleine Websites genügt oft eine Prüfung nach größeren Änderungen. Bei Shops, Portalen und stark wachsenden Projekten sollte die Kontrolle in einen festen technischen Prozess integriert werden.
Eine praktische Prüfung kann folgende Fragen enthalten:
- Sind alle enthaltenen URLs erreichbar?
- Gibt es Weiterleitungen oder Fehlerseiten in der Datei?
- Stimmen Protokoll, Domain und bevorzugte URL-Version?
- Sind ausgeschlossene oder nicht öffentliche Bereiche enthalten?
- Fehlen wichtige neue Seiten?
- Entsprechen Änderungsdaten den tatsächlichen inhaltlichen Änderungen?
- Wird die Sitemap nach einem Relaunch automatisch oder manuell aktualisiert?
Zusätzlich lohnt sich ein Vergleich zwischen Sitemap, intern verlinkten Seiten und den Berichten der Suchmaschinenverwaltung. Abweichungen sind nicht immer Fehler, liefern aber Hinweise für eine genauere Untersuchung.
Häufige Fehler bei Sitemaps
Zu den häufigsten Problemen gehört eine Sitemap, die zu viele URLs enthält. Je größer die Datei, desto wichtiger ist die Auswahl. Ebenso problematisch sind URLs, die auf Weiterleitungen zeigen, nicht erreichbar sind oder durch widersprüchliche technische Angaben ausgeschlossen werden.
Ein weiterer Fehler ist die Annahme, dass die Sitemap Rankings erzwingt. Sie kann die Entdeckung unterstützen, aber keinen schwachen Inhalt, eine schlechte Nutzerführung oder technische Barrieren ausgleichen. Auch eine veraltete Sitemap nach einem Domainwechsel oder Relaunch kann zu unnötigen Unklarheiten führen.
Manche Betreiber erstellen außerdem eine Sitemap, reichen sie einmal ein und vergessen sie danach. Sinnvoller ist ein Prozess, bei dem die Datei automatisch gepflegt und in regelmäßigen Abständen stichprobenartig kontrolliert wird.
FAQ
Ist eine Sitemap für jede Website verpflichtend?
Nein. Eine Sitemap ist normalerweise keine allgemeine Pflicht. Für die meisten Websites ist sie dennoch empfehlenswert, weil sie die Entdeckung wichtiger URLs erleichtert und eine zusätzliche Kontrolle über den veröffentlichten Inhaltsbestand ermöglicht.
Verbessert eine Sitemap automatisch das Ranking?
Nein. Eine Sitemap ist kein direkter Rankingfaktor im Sinne einer garantierten Verbesserung. Sie kann Suchmaschinen helfen, relevante Inhalte zu finden. Ob eine Seite indexiert wird und wie sie bewertet wird, hängt von vielen weiteren technischen und inhaltlichen Signalen ab.
Reicht eine Sitemap allein für gute SEO aus?
Nein. Sie ergänzt unter anderem interne Verlinkung, eine klare Seitenstruktur, gute Inhalte, korrekte Statuscodes und eine sinnvolle Indexierungssteuerung. Eine Sitemap kann grundlegende Probleme nicht ersetzen oder verdecken.
Wie oft sollte eine Sitemap aktualisiert werden?
Sie sollte aktualisiert werden, sobald sich der gewünschte Bestand wichtiger URLs ändert. Bei dynamischen Websites geschieht das idealerweise automatisch. Das Änderungsdatum einzelner URLs sollte trotzdem nur bei wesentlichen Änderungen angepasst werden.
Kann eine Sitemap zu viele URLs enthalten?
Ja. Eine Sitemap sollte nicht jede technisch erzeugbare Adresse enthalten. Doppelte, unwichtige, private, weitergeleitete oder ausgeschlossene URLs gehören normalerweise nicht hinein. Eine kleinere, sorgfältig ausgewählte Datei ist hilfreicher als eine vollständige Liste aller Varianten.
Braucht eine kleine Website zusätzlich eine HTML-Sitemap?
Nicht unbedingt. Wenn die Navigation übersichtlich ist und alle wichtigen Seiten gut erreichbar sind, kann eine HTML-Sitemap entbehrlich sein. Bei vielen Unterseiten, älteren Inhalten oder einer komplexen Struktur kann sie Besucherinnen und Besuchern dennoch zusätzliche Orientierung geben.
Was passiert, wenn die Sitemap fehlerhafte URLs enthält?
Einzelne Fehler führen nicht automatisch zu einem großen Problem. Häufen sich jedoch falsche URLs, kann die Datei ihre Funktion als verlässliche Übersicht verlieren. Die fehlerhaften Adressen sollten geprüft und entfernt oder korrigiert werden. Wichtig ist außerdem, die Ursache in der automatischen Generierung zu beheben.
Fazit: Eine Sitemap schafft technische Klarheit
Warum jede Website eine Sitemap braucht, lässt sich vor allem mit drei Punkten beantworten: Sie unterstützt die Entdeckung wichtiger URLs, schafft Transparenz über den gewünschten Inhaltsbestand und erleichtert die Kontrolle bei Wachstum oder technischen Änderungen. Besonders große, regelmäßig aktualisierte oder komplex strukturierte Websites profitieren davon.
Eine gute Sitemap ist nicht möglichst umfangreich, sondern möglichst präzise. Sie enthält indexierbare, kanonische und wertvolle URLs, wird automatisch oder zuverlässig aktualisiert und regelmäßig auf Fehler geprüft. Zusammen mit einer verständlichen Navigation, einer starken internen Verlinkung und technisch sauberen Seiten bildet sie eine solide Grundlage für eine gut auffindbare Website.