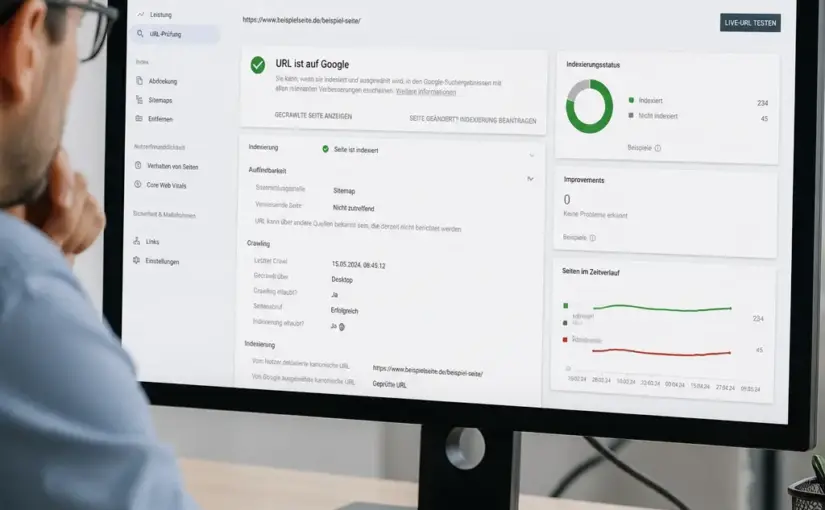
Indexierung einer Website überprüfen: Der umfassende Ratgeber

Wer organischen Traffic gewinnen möchte, muss zuerst sicherstellen, dass Suchmaschinen die wichtigen Seiten einer Website finden, crawlen und in ihren Index aufnehmen können. Eine technisch erreichbare Seite ist nämlich nicht automatisch auch in den Suchergebnissen sichtbar. Mit einer systematischen Prüfung lassen sich fehlende Seiten, versehentliche Sperren und Qualitätsprobleme meist deutlich schneller erkennen.

Dieser Ratgeber zeigt, wie Sie die Indexierung einer Website überprüfen, welche Werkzeuge dafür geeignet sind und wie Sie typische Ursachen für fehlende Sichtbarkeit unterscheiden. Dabei geht es nicht nur um einzelne URLs, sondern um das Zusammenspiel aus Crawling, Indexierung, internen Verlinkungen, Inhaltsqualität und technischen Signalen.

Was bedeutet Indexierung?

Beim Crawling ruft ein Suchmaschinenbot eine URL ab und analysiert deren Inhalt. Bei der Indexierung entscheidet die Suchmaschine anschließend, ob und in welcher Form die Seite in ihren Suchindex aufgenommen wird. Erst danach kann sie für passende Suchanfragen als Ergebnis erscheinen.

Diese Schritte sind voneinander zu unterscheiden:

  • Entdeckung: Die Suchmaschine erhält Kenntnis von einer URL, zum Beispiel über einen Link, eine XML-Sitemap oder bereits bekannte Daten.
  • Crawling: Ein Bot ruft die URL ab und versucht, den Inhalt technisch zu verarbeiten.
  • Indexierung: Die Seite wird bewertet und gegebenenfalls in den Index aufgenommen.
  • Ausspielung: Die indexierte Seite kann bei geeigneten Suchanfragen sichtbar werden.

Eine Seite kann also gecrawlt, aber nicht indexiert sein. Ebenso kann sie indexiert sein, ohne für ein wichtiges Keyword eine gute Position zu erreichen. Deshalb sollte eine Indexierungsprüfung nicht mit einer einfachen Suche nach dem Domainnamen enden.

Warum die Indexierung einer Website regelmäßig überprüft werden sollte
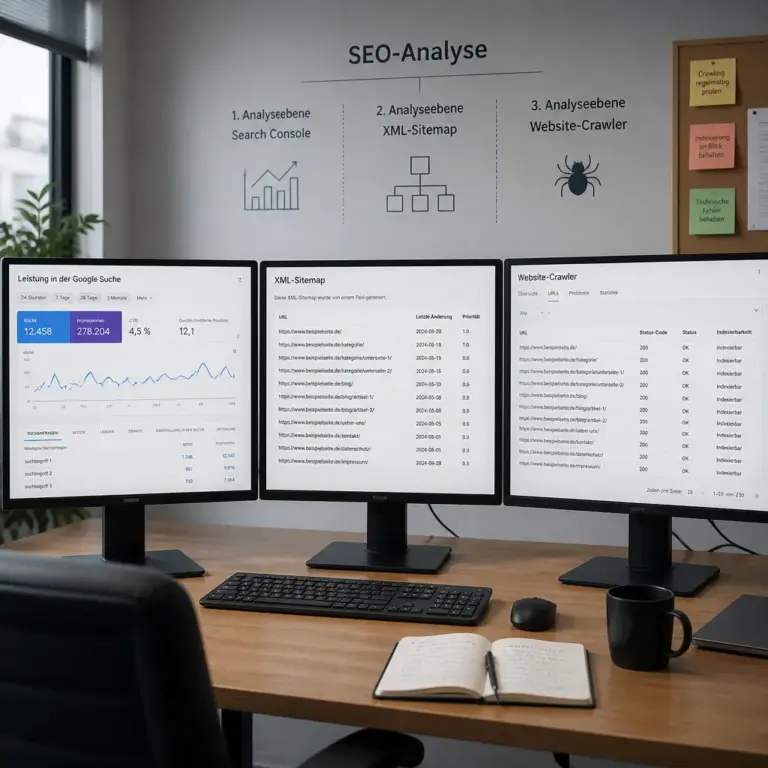
Werkzeuge zur Pru00fcfung der Website-Indexierung
Mehrere Datenquellen ergänzen sich bei der Indexierungsprüfung.

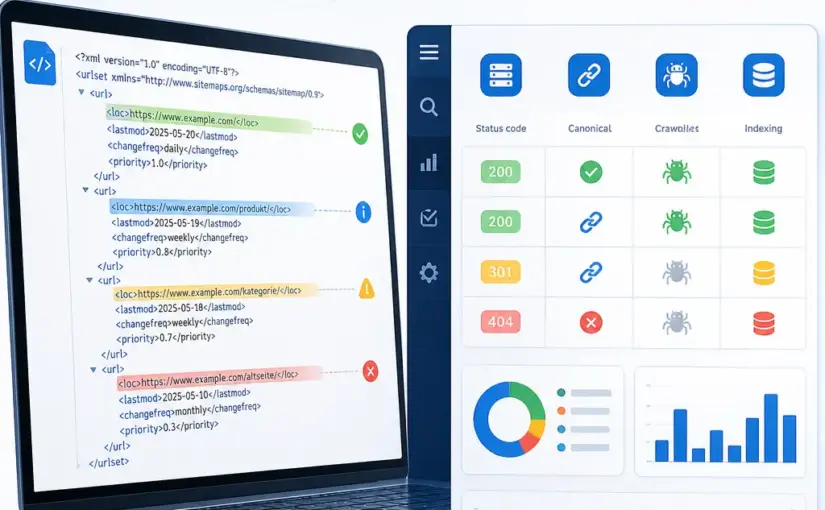
Die Darstellung sollte zeigen, dass eine verlässliche Prüfung nicht auf einem einzigen Werkzeug beruht. Besonders wichtig ist der Abgleich zwischen URL-Status, Sitemap und technischer Website-Analyse.

Neue Websites, Relaunches und größere technische Änderungen bringen häufig unbeabsichtigte Folgen mit sich. Eine Entwicklungsumgebung kann beispielsweise eine globale Noindex-Anweisung enthalten, die beim Livegang übersehen wird. Auch Änderungen an Canonical-Tags, Weiterleitungen, URL-Strukturen oder internen Links können die Auffindbarkeit beeinflussen.

Eine regelmäßige Kontrolle hilft unter anderem dabei, folgende Probleme früh zu erkennen:

  • wichtige Seiten mit einem versehentlichen noindex-Meta-Tag,
  • gesperrte Verzeichnisse in der robots.txt,
  • fehlerhafte oder nicht erreichbare XML-Sitemaps,
  • verwaiste Seiten ohne interne Links,
  • mehrere URLs mit nahezu identischem Inhalt,
  • falsche Canonical-Verweise,
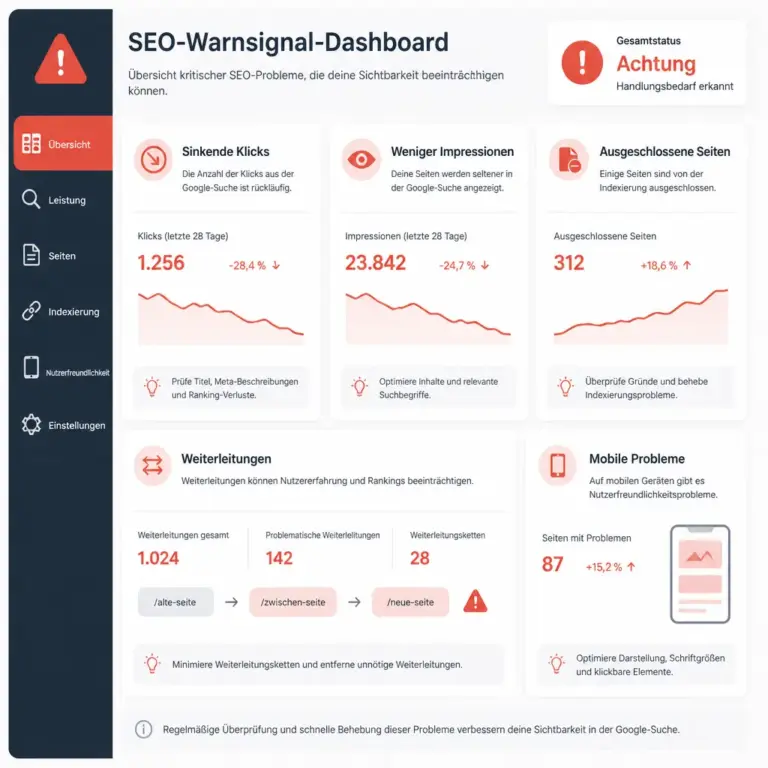
  • Serverfehler, Weiterleitungsketten oder Soft-404-Seiten,
  • Seiten, die zwar indexiert sind, aber keinen ausreichenden eigenständigen Nutzen bieten.

Die Prüfung ist besonders wichtig, wenn sich die Anzahl indexierter URLs stark verändert. Ein Rückgang muss nicht automatisch eine Strafe bedeuten; er kann durch eine technische Bereinigung, entfernte Inhalte oder eine veränderte Erfassung entstehen. Entscheidend ist, ob die betroffenen URLs absichtlich entfernt wurden und ob die wichtigen Seiten weiterhin verfügbar sind.

Die wichtigsten Werkzeuge für eine Indexierungsprüfung

Kein einzelnes Werkzeug zeigt die gesamte Situation perfekt. Aussagekräftiger wird die Analyse, wenn mehrere Datenquellen miteinander verglichen werden.

Google Search Console

Für Websites in der Google-Suche ist die Search Console eine zentrale Anlaufstelle. Im Bericht zur Indexierung lässt sich nachvollziehen, welche URLs als indexiert gelten und welche ausgeschlossen wurden. Die jeweiligen Gründe liefern wichtige Hinweise, etwa „Durch noindex ausgeschlossen“, „Duplikat“ oder „Gecrawlt – derzeit nicht indexiert“.

Mit der URL-Prüfung können Sie einzelne Seiten untersuchen. Sie erhalten unter anderem Informationen zur zuletzt bekannten Version, zur Indexierbarkeit und zum ausgewählten Canonical. Die Live-Prüfung kann zusätzlich zeigen, ob eine Seite aktuell abrufbar ist. Sie ersetzt jedoch keine vollständige Qualitäts- oder Rankinganalyse.

Bing Webmaster Tools

Wenn Sichtbarkeit in mehreren Suchmaschinen relevant ist, sollten auch die Bing Webmaster Tools berücksichtigt werden. Die Berichte können zusätzliche Hinweise zu Crawling, Sitemaps und technischen Auffälligkeiten geben. Unterschiedliche Suchmaschinen können dieselbe Website unterschiedlich verarbeiten; ein Vergleich ist daher sinnvoll.

Suchoperatoren als schneller Plausibilitätscheck

Eine Suche mit site:beispiel.de zeigt eine Auswahl von Seiten, die eine Suchmaschine der Domain zuordnet. Das ist ein schneller Hinweis, aber keine vollständige und exakte Bestandsaufnahme. Die angezeigte Anzahl kann schwanken, und nicht jede indexierte URL wird immer in der sichtbaren Trefferliste dargestellt.

Zusätzliche Suchabfragen können helfen, problematische Muster zu finden, etwa bestimmte Verzeichnisse, Parameter oder alte URL-Strukturen. Solche Abfragen sollten als Ergänzung und nicht als Ersatz für die Search Console verstanden werden.

Crawler und eigene URL-Listen

Ein Website-Crawler kann interne Links, Statuscodes, Canonical-Tags, Meta-Robots-Anweisungen, Weiterleitungen und viele weitere Merkmale erfassen. Für größere Websites ist eine solche technische Bestandsaufnahme besonders hilfreich. Die Ergebnisse sollten anschließend mit einer Liste der tatsächlich gewünschten indexierbaren Seiten verglichen werden.

Eine einfache Tabelle mit URL, Seitentyp, gewünschtem Indexierungsstatus, HTTP-Status, Canonical und Priorität schafft dabei Transparenz. So wird sichtbar, ob beispielsweise Produktseiten, Ratgeberartikel oder Kategorieseiten unterschiedlich behandelt werden müssen.

Indexierung einer Website überprüfen: Schritt-für-Schritt-Anleitung

1. Gewünschte indexierbare Seiten definieren

Bevor Sie Fehler suchen, sollten Sie festlegen, welche Seitentypen überhaupt in den Suchindex gehören. Das können beispielsweise hochwertige Leistungsseiten, Produktseiten, redaktionelle Ratgeber oder lokale Standortseiten sein. Nicht jede URL muss indexiert werden. Interne Suchergebnisse, Warenkorbseiten, persönliche Kontobereiche und viele Filterkombinationen sind häufig keine eigenständigen Suchergebnisse.

Erstellen Sie deshalb eine Zielvorstellung: Welche Seiten sollen gefunden werden, welche dürfen zugänglich bleiben, sollen aber nicht im Index erscheinen, und welche URLs können vollständig entfernt oder weitergeleitet werden? Ohne diese Unterscheidung wirkt eine hohe Zahl ausgeschlossener URLs schnell wie ein Fehler, obwohl sie beabsichtigt sein kann.

2. Die Indexierungsberichte auswerten

Beginnen Sie mit der Search Console und betrachten Sie nicht nur die Gesamtzahl, sondern vor allem die konkreten Ausschlussgründe. Prüfen Sie, ob sich die betroffenen URLs auf wichtige Seitentypen konzentrieren. Ein Ausschluss ist nicht automatisch problematisch; problematisch wird er, wenn eine wertvolle Zielseite betroffen ist.

Priorisieren Sie die Analyse nach geschäftlicher und redaktioneller Bedeutung. Eine einzelne wichtige Angebotsseite kann dringender sein als viele bewusst ausgeschlossene Parameter-URLs. Dokumentieren Sie für jeden relevanten Fall die vermutete Ursache, die gewünschte Lösung und den Zeitpunkt der erneuten Prüfung.

3. Einzelne wichtige URLs mit der URL-Prüfung kontrollieren

Wählen Sie repräsentative URLs aus: die Startseite, wichtige Kategorie- oder Leistungsseiten, neue Inhalte, stark verlinkte Artikel und Seiten mit auffälligen Zugriffsrückgängen. Prüfen Sie, ob die URL indexiert ist und ob die angezeigte Canonical-URL der eigenen Absicht entspricht.

Wenn eine Seite nicht indexiert ist, kontrollieren Sie die Live-Version zusätzlich. Eine Diskrepanz zwischen der zuletzt gespeicherten Version und dem aktuellen Zustand kann darauf hindeuten, dass Änderungen noch nicht verarbeitet wurden oder dass die technische Situation inzwischen anders ist.

4. Technische Indexierungssignale prüfen

Für jede wichtige Seite sollten mehrere Signale zusammenpassen:

  • Der Server liefert einen erfolgreichen Statuscode, normalerweise 200.
  • Die Seite ist ohne Anmeldung erreichbar und wird nicht durch eine fehlerhafte Weiterleitung ersetzt.
  • Es gibt kein unbeabsichtigtes noindex im HTML oder in einem HTTP-Header.
  • Die robots.txt blockiert den benötigten Abruf nicht.
  • Der Canonical verweist auf die bevorzugte, indexierbare URL.
  • Die Seite enthält eigenständigen und nützlichen Inhalt.
  • Sie ist über sinnvolle interne Links erreichbar.

Wichtig ist das Zusammenspiel dieser Signale. Ein Canonical-Tag kann eine Präferenz ausdrücken, ersetzt aber keine sinnvolle URL-Struktur. Eine XML-Sitemap kann eine URL bekannt machen, hebt eine Noindex-Anweisung jedoch nicht automatisch auf.

5. XML-Sitemap und interne Verlinkung abgleichen

Die XML-Sitemap sollte bevorzugt URLs enthalten, die dauerhaft erreichbar, kanonisch und tatsächlich indexierbar sind. Entfernen Sie dort nach Möglichkeit Weiterleitungen, Fehlerseiten, nicht kanonische Varianten und Seiten, die ausdrücklich nicht in den Index sollen.

Vergleichen Sie die Sitemap anschließend mit den internen Links und den Search-Console-Daten. Fehlt eine wichtige Seite in der Sitemap, kann sie trotzdem indexiert werden, sollte aber nicht unnötig schwer auffindbar sein. Umgekehrt ist ein Eintrag in der Sitemap keine Garantie für eine Indexierung.

Besonders kritisch sind verwaiste Seiten. Wenn eine URL nur in der Sitemap steht, aber von keiner relevanten Seite intern verlinkt wird, fehlen Suchmaschinen und Nutzern wichtige Kontextsignale. Ergänzen Sie passende Links in thematisch verwandten Inhalten, Navigationselementen oder Übersichtsseiten.

6. Inhalte auf eigenständigen Nutzen prüfen

Technische Erreichbarkeit allein reicht nicht immer aus. Suchmaschinen können Seiten mit sehr wenig eigenständigem Inhalt, automatisch erzeugten Varianten oder stark ähnlichen Texten nicht prominent berücksichtigen oder gar nicht indexieren. Prüfen Sie deshalb, ob eine Seite eine klar erkennbare Suchintention beantwortet und gegenüber ähnlichen URLs einen eigenen Zweck erfüllt.

Hilfreiche Fragen sind:

  • Welche konkrete Frage oder Aufgabe beantwortet diese URL?
  • Ist der Inhalt verständlich, aktuell und ausreichend präzise?
  • Enthält die Seite Informationen, die nicht nur aus austauschbaren Standardtexten bestehen?
  • Kann ein Nutzer nach dem Lesen eine sinnvolle Entscheidung treffen oder einen nächsten Schritt ausführen?
  • Gibt es eine andere URL auf der Website, die dieselbe Aufgabe besser erfüllt?

Wenn mehrere URLs nahezu denselben Zweck haben, können eine Zusammenführung, eine klare Canonical-Strategie oder eine gezielte Aussonderung sinnvoller sein. Die richtige Lösung hängt vom Inhalt und von der Nutzerführung ab.

Häufige Gründe für fehlende Indexierung

Noindex-Anweisung

Ein Meta-Robots-Tag mit noindex oder ein entsprechender HTTP-Header weist Suchmaschinen an, die Seite nicht in den Index aufzunehmen. Das ist bei nicht öffentlichen oder funktionalen Seiten nützlich, wird aber bei Relaunches oder durch fehlerhafte Vorlagen manchmal versehentlich auf wichtige Inhalte übertragen.

Blockierung durch robots.txt

Die robots.txt steuert, welche Bereiche gecrawlt werden dürfen. Eine Sperre kann den Abruf einer Seite verhindern, ist aber nicht das geeignete Mittel, um eine bereits bekannte URL zuverlässig aus dem Index zu entfernen. Prüfen Sie Regeln immer im Zusammenhang mit dem gewünschten Ziel und vermeiden Sie pauschale Sperren ganzer Verzeichnisse, wenn darin wichtige Inhalte liegen.

Falsches Canonical

Verweist das Canonical einer Seite auf eine andere URL, kann die Suchmaschine diese andere Adresse als bevorzugte Version behandeln. Ein Fehler entsteht beispielsweise, wenn viele unterschiedliche Seiten auf die Startseite oder eine alte URL kanonisiert werden. Das Canonical sollte zur tatsächlichen Inhaltsstruktur passen und auf eine erreichbare, indexierbare Zielseite zeigen.

„Gecrawlt – derzeit nicht indexiert“

Dieser Status bedeutet nicht zwangsläufig einen technischen Defekt. Er kann darauf hindeuten, dass die Seite zwar abgerufen wurde, aber derzeit keinen ausreichenden eigenständigen Wert erkennen lässt, sehr ähnlich zu anderen URLs ist oder noch nicht verarbeitet wurde. Prüfen Sie Inhalt, interne Verlinkung, Seitentyp und technische Signale gemeinsam, statt die URL lediglich mehrfach zur Indexierung einzureichen.

Server- und Weiterleitungsfehler

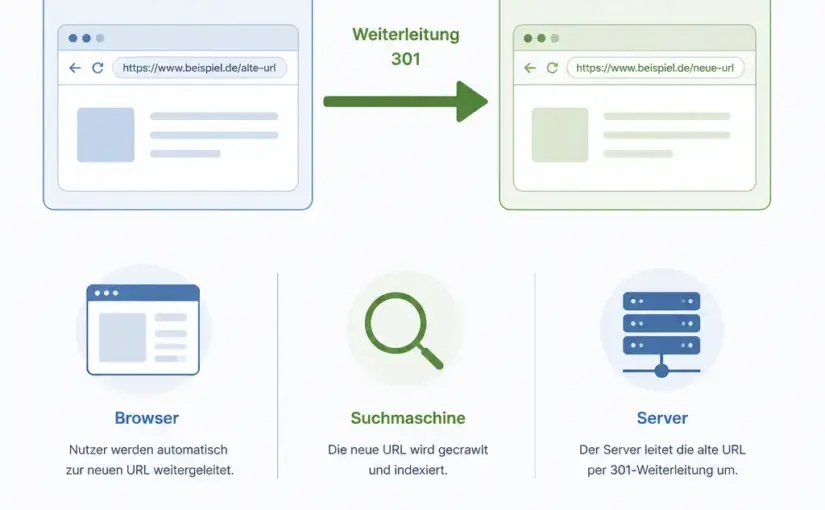
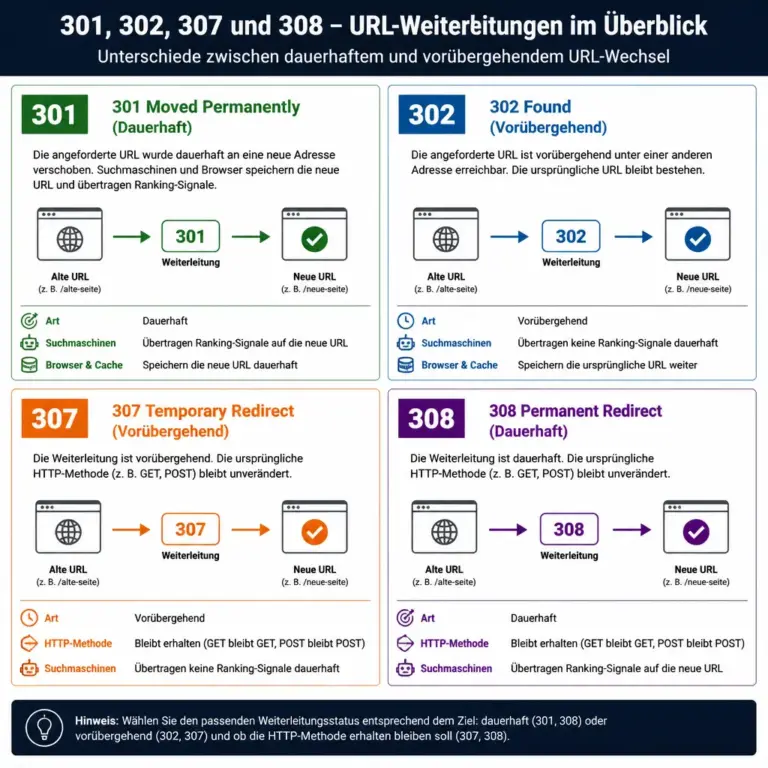
Statuscodes wie 404 oder 410 sind bei absichtlich entfernten Inhalten normal, bei wichtigen Landingpages jedoch problematisch. Auch dauerhafte Weiterleitungen sollten möglichst direkt auf das passende Ziel führen. Ketten, Schleifen und wechselnde Weiterleitungsziele erschweren die Verarbeitung und verschlechtern die Nutzererfahrung.

JavaScript und schwer zugängliche Inhalte

Moderne Websites können Inhalte dynamisch laden. Wenn der wesentliche Text erst durch fehlerhaftes JavaScript erscheint oder wichtige Links nicht als normale, verarbeitbare Verknüpfungen vorliegen, kann die Verarbeitung erschwert werden. Prüfen Sie daher, ob der Hauptinhalt auch in einer technisch robusten Auslieferung vorhanden ist und ob zentrale Navigationswege funktionieren.

Wie Sie Indexierungsprobleme sinnvoll beheben

Beginnen Sie mit der Ursache und nicht mit dem erneuten Einreichen jeder betroffenen URL. Entfernen Sie eine unbeabsichtigte Noindex-Anweisung, korrigieren Sie den Canonical, beheben Sie den Serverfehler oder verbessern Sie die interne Verlinkung. Bei Qualitätsproblemen sollte zuerst der Inhalt überarbeitet werden.

Danach können Sie die betroffene URL in der Search Console erneut prüfen lassen oder eine Validierung des entsprechenden Problems anstoßen. Die Verarbeitung benötigt Zeit und ist keine Garantie für eine Aufnahme. Kontrollieren Sie nach angemessener Wartezeit, ob sich der Status und die Sichtbarkeit tatsächlich verändert haben.

Bei vielen URLs empfiehlt sich ein kontrolliertes Vorgehen:

  1. Problem und betroffene URL-Gruppe dokumentieren.
  2. Ursache anhand von Quellcode, Serverantwort, robots.txt, Sitemap und internen Links bestätigen.
  3. Änderung zunächst an repräsentativen URLs testen.
  4. Die technische Umsetzung auf weitere URLs ausrollen.
  5. Nachverfolgen, ob die wichtigen Seiten erreichbar, indexierbar und in den Berichten korrekt eingeordnet sind.

Messbare Kriterien für eine verlässliche Kontrolle

Eine gute Prüfung beschränkt sich nicht auf „indexiert“ oder „nicht indexiert“. Sinnvolle Kontrollgrößen sind unter anderem:

Kriterium Worauf Sie achten sollten
Indexierbare Zielseiten Wichtige URLs sind technisch erreichbar, nicht versehentlich gesperrt und eindeutig zugeordnet.
Ausschlussgründe Bewusste Ausschlüsse sind nachvollziehbar; wichtige Inhalte tauchen nicht unerwartet darin auf.
XML-Sitemap Sie enthält aktuelle, kanonische und indexierbare URLs ohne unnötige Varianten.
Interne Verlinkung Relevante Seiten sind über thematisch passende Links erreichbar.
Statuscodes Wichtige Inhalte liefern eine passende erfolgreiche Antwort und keine Fehler- oder Umleitungskette.
Organische Sichtbarkeit Indexierung und Suchleistung werden getrennt bewertet; eine indexierte Seite muss nicht automatisch gut ranken.

Für kleine Websites reicht oft eine monatliche oder anlassbezogene Kontrolle, etwa nach einem Relaunch. Größere Websites mit häufigen Veröffentlichungen sollten technische Warnungen, Sitemap-Änderungen und wichtige URL-Gruppen enger überwachen. Der passende Rhythmus richtet sich nach Änderungsfrequenz und Risiko.

FAQ

Wie kann ich schnell prüfen, ob eine einzelne Seite indexiert ist?

Geben Sie die vollständige URL in die URL-Prüfung der Google Search Console ein. Als ergänzenden Plausibilitätscheck können Sie nach der exakten URL oder mit dem Operator site: suchen. Die Search Console liefert für die eigene bestätigte Website in der Regel die aussagekräftigere technische Einordnung.

Ist eine Website mit einer Suche nach „site:Domain“ vollständig geprüft?

Nein. Der Suchoperator zeigt keine garantiert vollständige Liste und kann eine ungenaue oder schwankende Anzahl anzeigen. Er eignet sich für einen schnellen Überblick, sollte aber mit Search-Console-Berichten, einer Sitemap und einer technischen URL-Analyse kombiniert werden.

Warum wird eine Seite trotz XML-Sitemap nicht indexiert?

Eine Sitemap macht eine URL bekannt, erzwingt aber keine Indexierung. Gründe können unter anderem eine Noindex-Anweisung, ein falsches Canonical, sehr ähnlicher Inhalt, fehlende interne Verlinkung, technische Fehler oder ein noch nicht abgeschlossener Verarbeitungsprozess sein.

Wie lange dauert es, bis eine Änderung berücksichtigt wird?

Das lässt sich nicht pauschal vorhersagen. Es hängt unter anderem von der Website, der URL, der Änderungsfrequenz und der technischen Situation ab. Nach einer Korrektur sollten Sie die Seite erneut prüfen, aber nicht aus einer kurzen Verzögerung sofort auf einen dauerhaften Fehler schließen.

Sollten alle Seiten einer Website indexiert werden?

Nein. Funktionale Seiten, interne Suchergebnisse, bestimmte Filtervarianten oder private Bereiche haben oft keinen eigenständigen Nutzen für Suchende. Entscheidend ist, dass die für Nutzer und Suchmaschinen relevanten Seiten gezielt indexierbar sind und unnötige Varianten nicht die Website-Struktur verwässern.

Was ist der Unterschied zwischen Crawling und Indexierung?

Crawling bezeichnet den Abruf und die Verarbeitung einer URL durch einen Suchmaschinenbot. Indexierung ist die anschließende Entscheidung, ob und wie diese Seite im Suchindex gespeichert wird. Eine gecrawlte Seite kann deshalb trotzdem nicht indexiert sein.

Kann eine indexierte Seite trotzdem unsichtbar wirken?

Ja. Indexierung bedeutet nur, dass eine Seite grundsätzlich im Index vorhanden sein kann. Sie kann für ein bestimmtes Keyword eine sehr niedrige Position haben, eine andere Suchintention bedienen oder in einer personalisierten beziehungsweise lokal unterschiedlichen Suche nicht prominent erscheinen. Für die Bewertung müssen Indexierung, Suchintention und Ranking getrennt betrachtet werden.

Fazit: Indexierung systematisch statt zufällig prüfen

Wer die Indexierung einer Website überprüfen möchte, sollte mehrere Ebenen verbinden: gewünschte Zielseiten, Search-Console-Daten, technische Signale, XML-Sitemap, interne Verlinkung und die Qualität der Inhalte. Eine einzelne Suchabfrage oder ein einzelner Status reicht selten für eine verlässliche Diagnose.

Am effizientesten ist ein priorisiertes Vorgehen. Definieren Sie zunächst, welche URLs sichtbar sein sollen, prüfen Sie danach deren technische Erreichbarkeit und untersuchen Sie erst anschließend größere URL-Mengen. So unterscheiden Sie bewusste Ausschlüsse von echten Fehlern und investieren Ihre Zeit dort, wo die Website und ihre Nutzer am meisten profitieren.
Suchmaschinen-Crawling verbessern: Ein praxisnaher Leitfaden für Websites

Wenn Suchmaschinen eine Website regelmäßig und vollständig crawlen können, werden neue und überarbeitete Inhalte schneller entdeckt und in den Suchindex aufgenommen. Crawling allein garantiert zwar keine guten Rankings, ist aber eine wichtige technische Grundlage für organische Sichtbarkeit. Dieser Ratgeber zeigt, wie Sie das Suchmaschinen-Crawling verbessern, typische Hindernisse erkennen und technische Maßnahmen sinnvoll priorisieren.

Im Mittelpunkt stehen keine kurzfristigen Tricks, sondern eine saubere Website-Struktur, eindeutig erreichbare Inhalte und verlässliche technische Signale. Die Empfehlungen eignen sich für kleinere Websites ebenso wie für umfangreichere Projekte mit vielen Unterseiten.

Was bedeutet Suchmaschinen-Crawling?

Beim Crawling rufen Suchmaschinen automatisiert Webseiten auf. Dafür folgen ihre Crawler, häufig auch Bots oder Suchroboter genannt, Links, lesen technische Hinweise und prüfen Inhalte. Die gefundenen Seiten können anschließend verarbeitet und – sofern sie die jeweiligen Voraussetzungen erfüllen – in den Suchindex aufgenommen werden.

Crawling und Indexierung sind nicht dasselbe. Eine Suchmaschine kann eine URL kennen und aufrufen, ohne sie in den Index aufzunehmen. Umgekehrt kann eine wichtige Seite schwer auffindbar sein, wenn sie intern schlecht verlinkt ist oder technische Barrieren bestehen. Wer das Suchmaschinen-Crawling verbessern möchte, sollte deshalb die gesamte Kette betrachten:

  • Entdeckung: Kann der Crawler die URL über Links oder eine XML-Sitemap finden?
  • Zugriff: Darf der Crawler die URL abrufen und erhält er eine verwertbare Antwort?
  • Verarbeitung: Sind Inhalt, Canonical-Signal und technische Auszeichnung eindeutig?
  • Priorisierung: Ist erkennbar, welche Seiten wichtig und aktuell sind?

Ein Crawling-Problem zeigt sich daher nicht immer als vollständiger Ausschluss. Auch unnötig häufige Aufrufe von unwichtigen URLs können Aufmerksamkeit und Ressourcen von relevanten Seiten abziehen.

Die wichtigsten Grundlagen für besseres Crawling

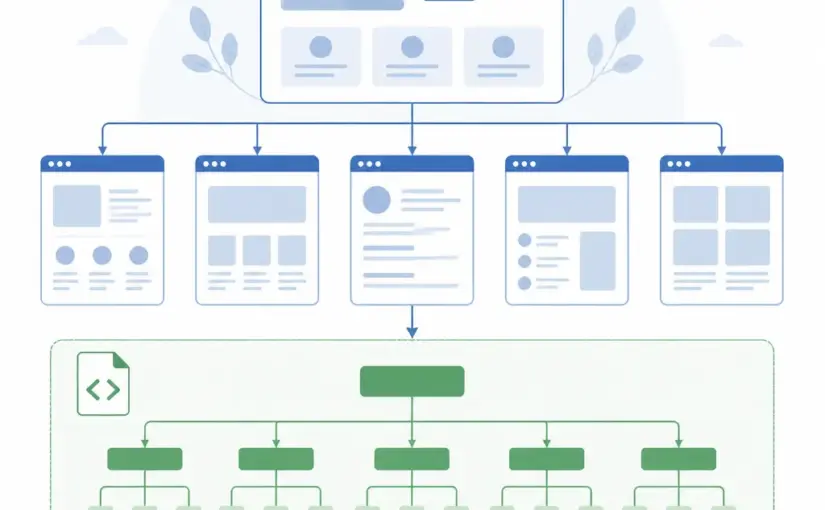
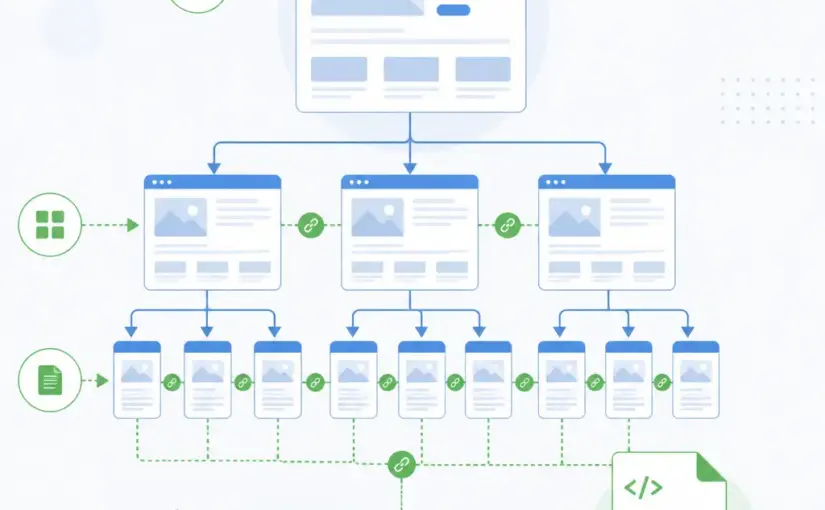
u00dcbersichtliche Website-Struktur mit Kategorien, Inhaltsseiten und internen Verbindungen
Eine klare Website-Struktur erleichtert die Auffindbarkeit wichtiger Inhalte.

Die Grafik zeigt, wie Startseite, Übersichtsseiten und Inhalte sinnvoll miteinander verbunden werden können. Achten Sie besonders darauf, dass wichtige Seiten nicht als isolierte Endpunkte erscheinen.

Eine logisch aufgebaute Website-Struktur schaffen

Eine klare Informationsarchitektur erleichtert Menschen und Suchmaschinen die Orientierung. Ordnen Sie Inhalte nach nachvollziehbaren Themen und sorgen Sie dafür, dass wichtige Seiten mit wenigen sinnvollen Klicks erreichbar sind. Die genaue Klicktiefe ist kein alleiniger Qualitätsmaßstab, aber sehr verschachtelte Strukturen erschweren die Pflege und die Entdeckung von Inhalten.

Jede zentrale Seite sollte mindestens einen thematisch passenden internen Link von einer anderen erreichbaren Seite erhalten. Vermeiden Sie Strukturen, in denen wichtige Inhalte ausschließlich über eine interne Suche, Filter oder JavaScript-Interaktionen erreichbar sind. Ein sichtbarer HTML-Link mit einer verständlichen Zieladresse ist in der Regel die robusteste Grundlage.

Interne Links gezielt einsetzen

Interne Verlinkung verbindet Inhalte und hilft dabei, ihre Bedeutung innerhalb der Website einzuordnen. Verlinken Sie beispielsweise einen ausführlichen Leitfaden aus passenden Ratgeberartikeln, Kategorien und relevanten Übersichtsseiten. Der Linktext sollte kurz beschreiben, was auf der Zielseite zu erwarten ist.

Prüfen Sie regelmäßig, ob Links auf Fehlerseiten, Weiterleitungsketten oder veraltete URLs führen. Ein Linknetz mit vielen defekten Verbindungen erschwert die Navigation und kann dazu führen, dass wichtige Inhalte weniger zuverlässig entdeckt werden.

XML-Sitemap aktuell halten

Eine XML-Sitemap kann Suchmaschinen eine zusätzliche Übersicht über wichtige URLs geben. Sie ersetzt keine interne Verlinkung, ist aber besonders bei größeren Websites, häufigen Änderungen oder neuen Projekten hilfreich.

In die Sitemap gehören grundsätzlich nur URLs, die tatsächlich indexierbar sein sollen. Entfernen Sie nach Möglichkeit Seiten mit einem dauerhaften Ausschluss, nicht kanonische Varianten, Weiterleitungen und offensichtliche Fehler-URLs. Achten Sie außerdem auf gültige absolute URLs, einen erreichbaren Sitemap-Pfad und eine Aktualisierung nach relevanten Änderungen.

Die Sitemap sollte nicht als vollständiges Archiv jeder jemals erzeugten URL verstanden werden. Ihre Aufgabe ist es, Suchmaschinen eine kuratierte Liste wichtiger, gültiger und zugänglicher Seiten zu liefern.

Robots.txt, Meta-Robots und Zugriffssignale richtig verwenden

Die Datei robots.txt kann Crawlern mitteilen, welche Bereiche sie nicht abrufen sollen. Sie ist jedoch kein zuverlässiger Schutz für vertrauliche Inhalte. Nicht öffentlich bestimmte Informationen gehören hinter eine geeignete Zugriffskontrolle und sollten nicht allein durch robots.txt verborgen werden.

Ein zu großzügiger Ausschluss kann das Crawling erheblich behindern. Prüfen Sie deshalb jede Disallow-Regel darauf, ob sie wirklich notwendig ist. Besonders riskant sind pauschale Regeln für Verzeichnisse, in denen sich neben unwichtigen Parametervarianten auch redaktionell relevante Inhalte befinden.

Ein wichtiger Unterschied: Ein Crawling-Ausschluss in robots.txt verhindert in erster Linie den Abruf. Ein noindex-Signal wird dagegen erst ausgewertet, wenn die betreffende Seite abgerufen werden kann. Wer eine Seite gezielt aus dem Index entfernen möchte, sollte die passende Methode im jeweiligen technischen Umfeld sorgfältig prüfen und nicht mehrere widersprüchliche Signale ohne Plan kombinieren.

Typische Fehler bei robots.txt

  • Die gesamte Website wird versehentlich mit einer allgemeinen Regel blockiert.
  • CSS- oder JavaScript-Ressourcen werden gesperrt, obwohl sie für die Darstellung oder Verarbeitung relevant sind.
  • Eine alte Testregel bleibt nach dem Relaunch bestehen.
  • Parameter werden pauschal blockiert, obwohl dadurch wichtige Zielseiten nicht mehr erreichbar sind.
  • Die Sitemap wird mit einer falschen oder nicht erreichbaren Adresse angegeben.

Nach Änderungen sollten Sie die Datei aus Sicht verschiedener URL-Typen prüfen: Startseite, wichtige Inhaltsseite, Kategorie, Medien- oder Produktseite sowie eine bewusst auszuschließende URL.

URL-Struktur, Statuscodes und Weiterleitungen prüfen

Eine verständliche URL-Struktur hilft bei der Verwaltung und reduziert unnötige Varianten. Vermeiden Sie, wenn möglich, mehrere URLs für denselben Inhalt, unkontrolliert erzeugte Parameter und dauerhaft wechselnde Pfade. URLs sollten stabil bleiben und den Inhalt nicht durch übermäßig viele technische Kennungen verschleiern.

Der HTTP-Statuscode liefert dem Crawler einen wichtigen Hinweis:

  • 200: Die Ressource wurde erfolgreich ausgeliefert.
  • 3xx: Die Anfrage wird weitergeleitet oder benötigt eine weitere Verarbeitung.
  • 4xx: Die angeforderte Ressource ist aus Sicht des Servers nicht verfügbar.
  • 5xx: Der Server konnte die Anfrage nicht erfolgreich verarbeiten.

Einzelne Fehler sind auf jeder größeren Website möglich. Problematisch wird es, wenn interne Links regelmäßig auf nicht vorhandene URLs zeigen, Weiterleitungen in Ketten auftreten oder viele relevante Seiten vorübergehend mit Serverfehlern antworten. Korrigieren Sie interne Links möglichst direkt und leiten Sie dauerhaft verschobene Inhalte auf die passendste neue URL weiter.

Beachten Sie auch, dass eine Weiterleitung kein Ersatz für eine konsequente interne Verlinkung ist. Wenn eine Seite dauerhaft umgezogen ist, sollten die wichtigsten Links auf die endgültige Adresse zeigen.

Duplicate Content und URL-Varianten reduzieren

Technische Systeme erzeugen häufig mehrere URLs mit gleichem oder sehr ähnlichem Inhalt. Beispiele sind Filter, Sortierungen, Tracking-Parameter, Druckansichten, Session-Kennungen oder unterschiedliche Schreibweisen. Dadurch kann eine Website unnötig viele crawlbare Adressen erzeugen.

Der erste Schritt ist eine Bestandsaufnahme: Welche URL-Varianten existieren, welche davon werden intern verlinkt und welche sollen überhaupt in den Suchindex gelangen? Danach lassen sich passende Maßnahmen auswählen:

  • Parameter nur dann verwenden, wenn sie einen echten Zweck erfüllen.
  • Für gleichartige Inhalte eine bevorzugte kanonische URL festlegen.
  • Unnötige Varianten vermeiden oder technisch kontrolliert behandeln.
  • Interne Links konsequent auf die gewünschte Hauptversion richten.
  • Bei dauerhaft zusammengeführten Inhalten geeignete Weiterleitungen einsetzen.

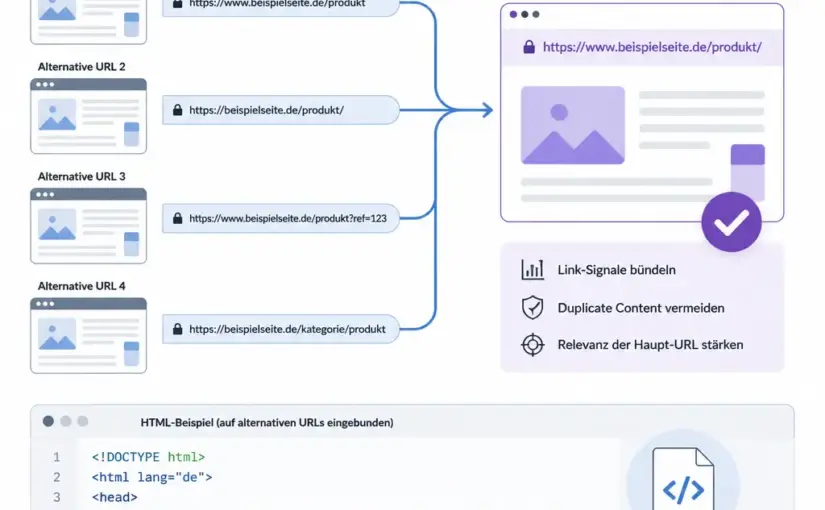
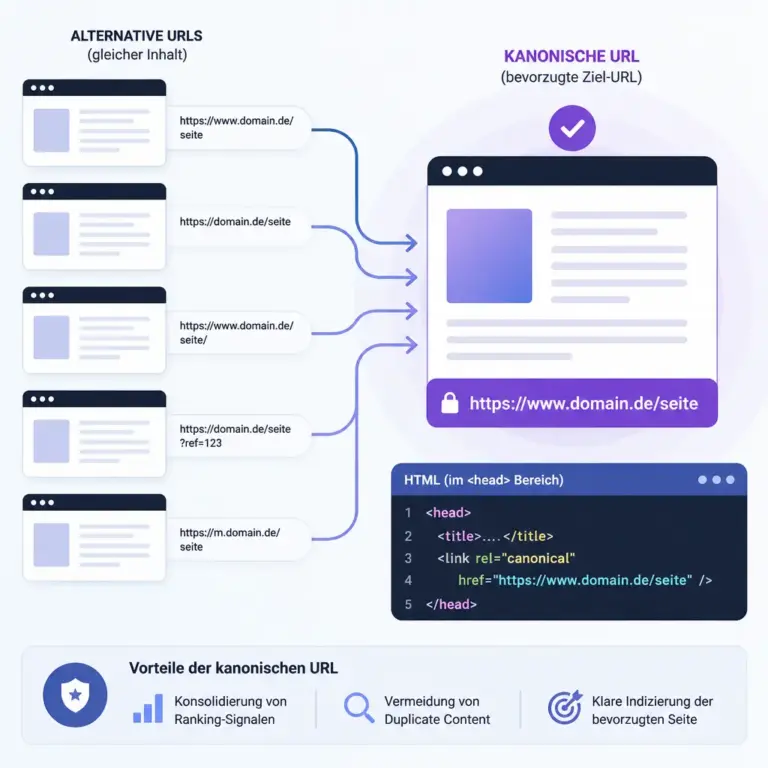
Das rel="canonical"-Element ist ein Hinweis auf die bevorzugte Version, aber keine pauschale Garantie für die Auswahl durch eine Suchmaschine. Es sollte nur auf eine inhaltlich passende, erreichbare und indexierbare Ziel-URL verweisen. Ein Canonical auf eine thematisch unpassende Seite kann die technische Klarheit verschlechtern.

JavaScript, Rendering und wichtige Inhalte

Moderne Websites laden Inhalte teilweise nachträglich über JavaScript. Das kann funktionieren, macht die Verarbeitung aber komplexer als eine direkt ausgelieferte HTML-Struktur. Besonders wichtige Informationen sollten deshalb nicht ausschließlich nach einer Interaktion, einem Scrollvorgang oder einem clientseitigen Datenabruf erscheinen.

Prüfen Sie, ob der zentrale Text, interne Links, Überschriften und relevante Metadaten im ausgelieferten Dokument oder nach der vorgesehenen Verarbeitung zuverlässig vorhanden sind. Achten Sie außerdem darauf, dass Links echte, erreichbare Zieladressen besitzen und nicht nur durch Klick-Handler simuliert werden.

Eine gute Praxis ist die schrittweise Prüfung: Zuerst sollte die Seite ohne unnötige Abhängigkeiten eine verständliche Grundstruktur liefern. Danach können dynamische Funktionen die Darstellung und Bedienung erweitern. Bei einem Relaunch empfiehlt sich ein Vergleich wichtiger Seiten vor und nach der technischen Umstellung.

Serverleistung und Crawling-Budget verstehen

Suchmaschinen verfügen nicht über unbegrenzte Kapazitäten für jede Website. Die verfügbare Aufmerksamkeit hängt unter anderem von der Größe, Aktualität, Qualität, Erreichbarkeit und technischen Stabilität eines Projekts ab. Für kleine Websites ist das sogenannte Crawling-Budget oft kein akutes Problem. Bei großen oder stark parameterisierten Websites kann es jedoch wichtig werden.

Die sinnvollste Maßnahme ist nicht, Crawler um jeden Preis zu einer höheren Abruffrequenz zu bewegen. Stattdessen sollte die Website möglichst wenige unnötige URLs erzeugen und wichtige Inhalte zuverlässig ausliefern. Dazu gehören:

  • stabile Serverantworten und möglichst geringe Ausfallzeiten,
  • eine Begrenzung nutzloser Filter- und Parameterkombinationen,
  • eine nachvollziehbare interne Verlinkung,
  • aktuelle Sitemaps ohne Fehler- und Weiterleitungs-URLs,
  • regelmäßige Kontrolle von Serverprotokollen und technischen Reports.

Langsame Ladezeiten sind nicht ausschließlich ein Crawling-Thema. Sie beeinflussen auch die Nutzung und die technische Verarbeitung. Priorisieren Sie daher die Ursachen: überlastete Server, unnötig große Ressourcen, fehlerhafte Caches oder ineffiziente Datenbankabfragen sollten getrennt untersucht werden.

Nach einem Relaunch das Crawling absichern

Ein Relaunch verändert häufig URLs, Navigation, Templates, interne Links und technische Regeln gleichzeitig. Deshalb sollte die Crawling-Prüfung bereits vor der Veröffentlichung beginnen. Erstellen Sie eine Liste der wichtigsten alten URLs und ordnen Sie ihnen – falls erforderlich – passende neue Zieladressen zu.

Direkt nach dem Start sollten Sie mindestens diese Punkte kontrollieren:

  • Ist die Website öffentlich erreichbar und nicht versehentlich blockiert?
  • Funktionieren wichtige alte und neue URLs mit dem vorgesehenen Statuscode?
  • Gibt es Weiterleitungsketten oder massenhaft nicht gefundene Seiten?
  • Enthält die neue Sitemap nur gültige Zieladressen?
  • Sind Canonical- und Meta-Robots-Signale korrekt gesetzt?
  • Führen interne Links nicht mehr auf alte oder falsche Pfade?
  • Sind zentrale Inhalte auch ohne problematische Interaktionen auffindbar?

Die Nachkontrolle sollte nicht auf einen einzigen Tag beschränkt bleiben. Beobachten Sie technische Fehler und auffällige URL-Muster über einen angemessenen Zeitraum, da manche Probleme erst durch das erneute Crawling sichtbar werden.

Werkzeuge für die technische Kontrolle

Für die Analyse stehen verschiedene Werkzeugarten zur Verfügung. Nutzen Sie keine einzelne Quelle als vollständige Wahrheit, sondern vergleichen Sie die Perspektiven:

  • Suchmaschinen-Tools: Sie zeigen häufig erkannte Indexierungs-, Abruf- oder Sitemap-Probleme für die jeweilige Property.
  • Serverprotokolle: Sie dokumentieren, welche URLs tatsächlich von welchen Crawlern angefragt wurden und welche Antworten der Server zurückgab.
  • Crawler für technische Audits: Sie können interne Links, Statuscodes, Canonicals, Weiterleitungen und viele URL-Varianten systematisch erfassen.
  • Browser- und Entwicklerwerkzeuge: Sie helfen bei der Prüfung von Netzwerkaufrufen, gerendertem Inhalt und blockierten Ressourcen.

Bewerten Sie Ergebnisse immer im Kontext. Eine einzelne nicht gecrawlte URL ist weniger aussagekräftig als ein wiederkehrendes Muster aus vielen fehlerhaften Seiten, widersprüchlichen Signalen oder ständig neuen Parameteradressen. Dokumentieren Sie Befunde mit URL, Ursache, Priorität und geplanter Lösung.

Eine sinnvolle Priorisierung der Maßnahmen

Nicht jede technische Auffälligkeit verdient dieselbe Aufmerksamkeit. Beginnen Sie mit Problemen, die viele wichtige URLs betreffen oder den Zugriff grundsätzlich verhindern. Eine praktikable Reihenfolge lautet:

  1. Zugriff sichern: Blockierungen, Serverfehler und falsche Weiterleitungen beheben.
  2. Wichtige URLs eindeutig machen: Canonicals, interne Links und Zieladressen vereinheitlichen.
  3. Unnötige URL-Mengen reduzieren: Parameter, Filter und doppelte Varianten kontrollieren.
  4. Sitemap und Architektur bereinigen: wichtige Inhalte klar auffindbar und korrekt gelistet halten.
  5. Rendering und Leistung verbessern: zentrale Inhalte zuverlässig ausliefern und technische Engpässe reduzieren.
  6. Kontinuierlich überwachen: Änderungen dokumentieren und wiederkehrende Fehler erkennen.

Die Priorität sollte sich nach Auswirkungen, Umfang und Aufwand richten. Eine kleine Korrektur an einer robots.txt kann wichtiger sein als zahlreiche Detailverbesserungen an einzelnen Seiten. Umgekehrt lohnt sich eine aufwendige Bereinigung großer URL-Mengen erst dann, wenn die grundlegenden Zugriffsprobleme gelöst sind.

FAQ

Wie kann ich das Suchmaschinen-Crawling verbessern?

Beginnen Sie mit einer klaren internen Verlinkung, einer aktuellen XML-Sitemap und einer korrekten robots.txt. Prüfen Sie zusätzlich Statuscodes, Weiterleitungen, Canonical-Signale, URL-Varianten und die Erreichbarkeit wichtiger Inhalte. Entscheidend ist eine Kombination dieser Maßnahmen, nicht ein einzelner technischer Schalter.

Wie schnell werden Änderungen gecrawlt?

Das lässt sich nicht allgemein garantieren. Die Geschwindigkeit hängt unter anderem von Websitegröße, Aktualität, technischer Stabilität und der Bedeutung der jeweiligen URL ab. Nach wichtigen Änderungen sollten Sie die technische Erreichbarkeit sofort kontrollieren und die weitere Entwicklung anhand geeigneter Berichte beobachten.

Ist eine XML-Sitemap für jede Website notwendig?

Eine kleine, gut intern verlinkte Website kann auch ohne Sitemap auffindbar sein. Eine XML-Sitemap ist dennoch oft eine hilfreiche zusätzliche Orientierung, insbesondere bei vielen URLs, neuen Websites, häufigen Änderungen oder schwer überschaubaren Strukturen. Sie sollte gepflegt sein und keine beliebigen URL-Varianten enthalten.

Blockiert robots.txt eine Seite dauerhaft aus dem Index?

Robots.txt steuert in erster Linie, ob ein Crawler eine Ressource abrufen darf. Das ist nicht dasselbe wie ein garantiertes Entfernen aus dem Index. Für Ausschlüsse sollten Sie die gewünschte Wirkung, die Erreichbarkeit der Seite und vorhandene Meta- oder HTTP-Signale gemeinsam prüfen.

Was ist wichtiger: Sitemap oder interne Links?

Beides erfüllt unterschiedliche Aufgaben. Interne Links verbinden Inhalte innerhalb der Website und unterstützen ihre Auffindbarkeit und Einordnung. Die Sitemap bietet eine zusätzliche URL-Übersicht. Eine Sitemap sollte daher keine schwache interne Struktur kaschieren.

Kann JavaScript das Crawling verschlechtern?

JavaScript ist nicht automatisch ein Problem. Schwierigkeiten entstehen, wenn wichtige Inhalte, Links oder technische Signale nur unzuverlässig nachgeladen werden. Prüfen Sie deshalb, ob die zentrale Seitenstruktur auch bei der vorgesehenen Verarbeitung vollständig und verständlich verfügbar ist.

Wie erkenne ich unnötige Crawl-Varianten?

Achten Sie in Serverprotokollen, technischen Crawls und Suchmaschinenberichten auf wiederkehrende Parameter, Filterkombinationen, Session-IDs, Druckversionen oder verschiedene Schreibweisen derselben Inhalte. Vergleichen Sie diese Adressen mit Ihren internen Links und entscheiden Sie für jede Gruppe, ob sie indexierbar sein soll.

Fazit: Suchmaschinen-Crawling nachhaltig verbessern

Wer das Suchmaschinen-Crawling verbessern möchte, sollte zuerst die technische Grundlage ordnen: wichtige Inhalte müssen erreichbar, sinnvoll verlinkt, eindeutig adressiert und zuverlässig ausgeliefert werden. Eine aktuelle Sitemap, sorgfältig eingesetzte Zugriffssignale und kontrollierte URL-Varianten unterstützen diesen Prozess.

Besonders nachhaltig ist ein regelmäßiger Prüfablauf. Kontrollieren Sie nach Relaunches und größeren Änderungen die wichtigsten URLs, beobachten Sie Server- und Suchmaschinenberichte und dokumentieren Sie wiederkehrende Fehler. So wird Crawling nicht zu einer einmaligen Reparatur, sondern zu einem festen Bestandteil der Website-Qualität.

Häufige Fehler in der robots.txt: Anleitung zur Prüfung und Behebung

Die Datei robots.txt wirkt unscheinbar, kann aber maßgeblich beeinflussen, welche Bereiche einer Website Suchmaschinen-Crawler erreichen. Ein einzelner zu weit gefasster Pfad, ein falsch gesetztes Zeichen oder eine veraltete Regel kann dazu führen, dass wichtige Inhalte seltener gecrawlt werden oder gar nicht erst in den Suchindex gelangen. Gleichzeitig wird die robots.txt häufig überschätzt: Sie ist kein sicherer Zugriffsschutz und ersetzt weder Authentifizierung noch technische Sicherheitsmaßnahmen.

Dieser Ratgeber zeigt die häufigsten Fehler in der robots.txt, erklärt ihre Auswirkungen und bietet eine systematische Vorgehensweise zur Prüfung. Dabei geht es nicht nur um einzelne Direktiven, sondern auch um den Zusammenhang mit internen Links, XML-Sitemaps, Meta-Robots-Anweisungen, Weiterleitungen und der tatsächlichen Website-Struktur.

Was die robots.txt tatsächlich steuert

Die robots.txt liegt normalerweise im Hauptverzeichnis einer Domain, zum Beispiel unter https://www.beispiel.de/robots.txt. Crawler rufen diese Datei ab, bevor sie URLs derselben Website crawlen. Darin können Regeln stehen, die bestimmten User-Agents den Zugriff auf bestimmte Pfade erlauben oder untersagen.

Wichtig ist die Unterscheidung zwischen Crawling und Indexierung. Eine Disallow-Regel sagt im Kern: Der betreffende Crawler soll den angegebenen Pfad nicht abrufen. Sie garantiert jedoch nicht, dass eine URL niemals im Index auftaucht. Wenn eine blockierte URL von anderen Seiten verlinkt wird, kann eine Suchmaschine ihre Existenz unter Umständen trotzdem erkennen und die URL ohne ausgelesenen Inhalt anzeigen.

Die robots.txt ist deshalb vor allem ein Werkzeug zur Steuerung des Crawlings. Für den Schutz vertraulicher Inhalte sind beispielsweise Zugriffsbeschränkungen, Serverberechtigungen oder eine geeignete Authentifizierung erforderlich. Für die Steuerung der Indexierung kommen unter anderem Meta-Robots-Anweisungen oder HTTP-Header wie X-Robots-Tag infrage, sofern der Crawler die betreffende Ressource abrufen darf.

Die häufigsten Fehler in der robots.txt

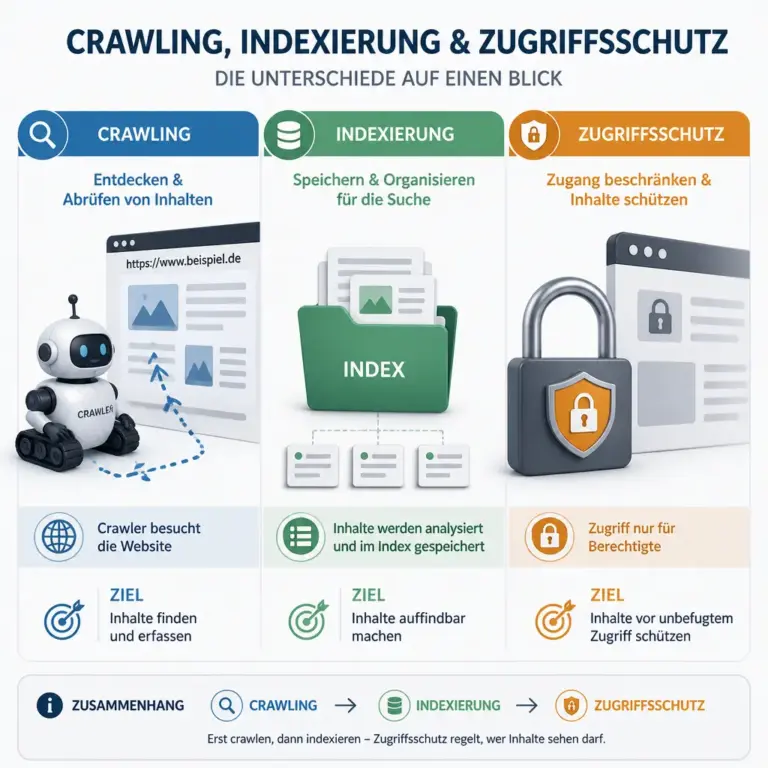
Infografik zum Unterschied zwischen Crawling, Indexierung und Zugriffsschutz
Die robots.txt steuert vor allem das Crawling und ersetzt keinen Zugriffsschutz.

Die Grafik sollte zeigen, dass eine robots.txt den Abruf bestimmter Pfade beeinflusst, aber keine vertraulichen Inhalte schützt. Der getrennte Bereich für Indexierung macht sichtbar, warum Disallow und Noindex nicht dasselbe sind.

Die gesamte Website versehentlich blockieren

Der folgenreichste Fehler ist eine Regel, die nahezu alle URLs blockiert:

User-agent: *
Disallow: /

Diese Kombination kann in einer Entwicklungsumgebung sinnvoll sein, wenn eine nicht öffentliche Website nicht von Suchmaschinen gecrawlt werden soll. Auf einer produktiven Website verhindert sie jedoch das Crawling praktisch aller Pfade. Besonders kritisch ist, wenn die Regel beim Umzug, bei einem Relaunch oder durch die Übernahme einer Staging-Konfiguration aktiv bleibt.

Prüfen Sie daher nach jedem Relaunch, jeder Migration und jedem Wechsel des Hosting-Systems, ob die Datei noch zur Produktionsumgebung passt. Die Website sollte außerdem über eine eindeutige Umgebungskontrolle verfügen: Eine Regel, die auf einer Testdomain sinnvoll ist, darf nicht ungeprüft auf der Live-Domain eingesetzt werden.

Wichtige Verzeichnisse zu weit sperren

Ein Pfad kann harmlos wirken, obwohl darunter wichtige Inhalte liegen. Beispiele sind pauschale Sperren für /wp-content/, /assets/, /media/ oder /static/. Werden dort Bilder, Stylesheets, JavaScript-Dateien oder eingebundene Inhalte gespeichert, kann ein Crawler die Darstellung und den funktionalen Aufbau einer Seite möglicherweise nicht vollständig beurteilen.

Früher wurden technische Ressourcen oft pauschal blockiert, um Crawl-Budget zu sparen. In vielen Fällen ist das jedoch kontraproduktiv. Suchmaschinen müssen eine Seite in ihrer ausgelieferten Form verstehen können. Statt ganze Verzeichnisse zu sperren, sollte geprüft werden, ob tatsächlich problematische URL-Muster existieren und ob diese auf andere Weise bereinigt werden können.

Besonders sorgfältig sollten Sie Regeln behandeln, die ein übergeordnetes Verzeichnis betreffen. Eine Sperre für /shop/ erfasst in der Regel auch /shop/produkte/, /shop/kategorien/ und weitere Unterpfade. Die gewünschte Wirkung sollte deshalb immer anhand konkreter Beispiel-URLs kontrolliert werden.

Fehlerhafte Schreibweise von User-agent und Direktiven

Die Grundstruktur einer Regel besteht aus einem User-Agent-Block und einer oder mehreren Direktiven:

User-agent: *
Disallow: /intern/

Typische Schreibfehler sind fehlende Doppelpunkte, vertauschte Feldnamen, zusätzliche Sonderzeichen oder eine unklare Mischung aus mehreren Blöcken. Die Namen der Direktiven sollten korrekt geschrieben werden, insbesondere User-agent, Disallow und Allow. Unbekannte oder nicht unterstützte Anweisungen werden nicht automatisch so interpretiert, wie der Verfasser es beabsichtigt hat.

Auch Kommentare sollten sauber mit einem # beginnen. Ein Kommentar kann bei der Pflege helfen, darf aber nicht versehentlich einen Teil einer wirksamen Regel ausblenden. Für eine verständliche Datei sind kurze, sachliche Kommentare sinnvoll, etwa zur Kennzeichnung einer temporären Ausnahme oder eines bewusst gesperrten Suchparameters.

Allow und Disallow falsch miteinander kombinieren

Mit Allow können Ausnahmen innerhalb eines gesperrten Bereichs formuliert werden, sofern der jeweilige Crawler diese Direktive unterstützt und die Regeln nach seinen Prioritätsregeln auswertet. Ein Beispiel ist:

User-agent: *
Disallow: /bereich/
Allow: /bereich/oeffentlich/

Solche Ausnahmen sind fehleranfällig, wenn mehrere Regeln ähnliche Pfade betreffen. Entscheidend ist nicht nur die Reihenfolge der Zeilen. Je nach Auswertung spielen unter anderem die konkretere Übereinstimmung und die unterstützte Syntax eine Rolle. Verlassen Sie sich daher nicht auf ein Bauchgefühl, sondern prüfen Sie konkrete URLs mit einem geeigneten Validator oder einer dokumentierten Testmethode.

Oft ist eine einfachere Struktur besser: Wenn nur wenige private Verzeichnisse nicht gecrawlt werden sollen, können diese direkt genannt werden. Eine lange Kette aus verschachtelten Ausnahmen erschwert die spätere Wartung und erhöht die Gefahr widersprüchlicher Regeln.

Wildcards unpräzise oder zu großzügig verwenden

Wildcards können wiederkehrende Muster erfassen, etwa URLs mit bestimmten Parametern. Eine zu breite Regel kann jedoch weit mehr blockieren als beabsichtigt. Ein Muster wie Disallow: /*? zielt beispielsweise auf URLs mit einem Fragezeichen. Je nach Website können darunter aber auch nützliche, indexierbare URLs liegen, die nicht bloß Sortierungen oder Tracking-Parameter enthalten.

Vor jeder Wildcard-Regel sollten Sie eine Liste realer URLs betrachten. Welche Parameter erzeugen Duplikate? Welche verändern den eigentlichen Seiteninhalt? Welche werden intern verlinkt? Eine pauschale Sperre ist nicht automatisch die beste Lösung, denn sie kann auch das Crawling wertvoller Varianten unterbinden. Häufig sind eine saubere interne Verlinkung, kanonische Angaben und eine konsistente URL-Logik langfristig robuster.

Slash, Groß- und Kleinschreibung sowie Pfadgrenzen übersehen

Pfadangaben müssen zur tatsächlichen URL-Struktur passen. /admin und /administrator sind unterschiedliche Pfade. Ebenso kann /shop je nach Regelwerk nicht dieselbe Bedeutung haben wie /shop/. Eine Regel, die einen Pfad ohne abschließenden Schrägstrich erfasst, sollte deshalb auf ihre Wirkung bei ähnlichen Pfaden geprüft werden.

Auch die Schreibweise kann relevant sein. Wenn der Server zwischen Groß- und Kleinschreibung unterscheidet, sind /Download/ und /download/ nicht zwingend identisch. Verwenden Sie exakt die Pfade, die auf der Website ausgeliefert werden, und prüfen Sie Varianten, Weiterleitungen sowie mögliche alternative URL-Schreibweisen.

Die Sitemap falsch oder veraltet angeben

Ein häufiger Fehler ist eine Sitemap-Adresse, die nicht erreichbar ist, auf eine andere Domain zeigt oder nur für eine frühere Website-Version gilt. Eine Sitemap kann am Ende der robots.txt genannt werden:

Sitemap: https://www.beispiel.de/sitemap.xml

Die absolute URL sollte zur tatsächlichen Domain und zum verwendeten Protokoll passen. Bei einer Website mit mehreren Sprachversionen, Subdomains oder getrennten Sitemaps müssen die Einträge bewusst verwaltet werden. Eine robots.txt auf shop.beispiel.de sollte nicht automatisch auf eine Sitemap einer völlig anderen Host-Adresse verweisen, wenn diese nicht die relevanten URLs enthält.

Die Sitemap ersetzt keine gute interne Verlinkung und hebt eine Disallow-Regel nicht auf. Wenn eine URL in der Sitemap steht und gleichzeitig durch die robots.txt blockiert wird, entsteht ein widersprüchliches Signal. Die Sitemap sollte daher nur URLs enthalten, die erreichbar, technisch gültig und für die Indexierung grundsätzlich vorgesehen sind.

Vertrauliche Inhalte nur durch robots.txt schützen

Eine robots.txt ist öffentlich erreichbar. Jeder kann ihre Inhalte abrufen und daraus ableiten, welche Pfade der Betreiber möglicherweise verborgen halten möchte. Außerdem sind Crawler nicht verpflichtet, freiwillige Regeln einzuhalten. Schadsoftware, aggressive Bots oder neugierige Personen können die Datei ignorieren.

Bereiche mit persönlichen Daten, internen Dokumenten, Administrationsfunktionen oder nicht veröffentlichten Projekten gehören deshalb hinter eine Zugriffskontrolle. Entfernen Sie vertrauliche Dateien vom öffentlich erreichbaren Server oder schützen Sie sie mit geeigneten technischen Maßnahmen. Eine Disallow-Regel kann zusätzlich die Crawl-Steuerung verbessern, ist aber keine Sicherheitsbarriere.

Typische Probleme bei WordPress-Websites

Bei WordPress entsteht die robots.txt häufig dynamisch, sofern keine eigene Datei im Webroot angelegt wurde. Zusätzlich können SEO-Plugins oder Hosting-Konfigurationen Regeln beeinflussen. Dadurch ist nicht immer auf den ersten Blick erkennbar, welche Version tatsächlich ausgeliefert wird.

Prüfen Sie zunächst die öffentlich erreichbare Adresse und vergleichen Sie sie mit den Einstellungen in WordPress sowie im verwendeten Plugin. Nach einem Plugin-Wechsel oder einer Änderung der Lesbarkeitseinstellungen kann sich die Ausgabe verändern. Auch Cache-Systeme und Content-Delivery-Netzwerke können eine ältere Version ausliefern. Änderungen sollten daher nach der Veröffentlichung erneut direkt im Browser und möglichst aus verschiedenen Netzwerkperspektiven kontrolliert werden.

Ein weiterer Fehler ist, die robots.txt als Ersatz für die WordPress-Einstellung zur Sichtbarkeit in Suchmaschinen zu betrachten. Diese Einstellung kann zusätzliche technische Signale auslösen, die nicht mit einer einzelnen Zeile in der robots.txt identisch sind. Bei einem Relaunch sollten deshalb die WordPress-Konfiguration, die robots.txt, Meta-Robots-Anweisungen, Canonical-URLs und die XML-Sitemap gemeinsam geprüft werden.

So prüfen Sie eine robots.txt systematisch

1. Die tatsächlich ausgelieferte Datei abrufen

Beginnen Sie mit der URL der produktiven Domain und rufen Sie die Datei direkt auf. Prüfen Sie dabei auch Varianten mit und ohne www, falls beide Hostnamen erreichbar sind. Eine Weiterleitung kann technisch funktionieren, sollte aber bewusst eingerichtet und zur bevorzugten Domain passend sein.

Achten Sie auf Statuscode, Inhalt, Zeichencodierung und ungewöhnliche Fehlermeldungen. Eine HTML-Fehlerseite anstelle einer Textdatei, ein Serverfehler oder eine unerwartete Weiterleitung sind wichtige Hinweise. Die Datei sollte nicht nur im lokalen Editor korrekt aussehen, sondern auch genau so vom Server ausgeliefert werden.

2. Die wichtigsten URL-Gruppen sammeln

Erstellen Sie eine kleine Prüfliste mit repräsentativen URLs: Startseite, wichtige Kategorie- und Produktseiten, redaktionelle Inhalte, Bilder, CSS- und JavaScript-Ressourcen, Suchergebnisse, Filterseiten, Login-Bereiche und bekannte technische Pfade. Nehmen Sie sowohl URLs auf, die erreichbar sein sollen, als auch solche, die bewusst nicht gecrawlt werden sollen.

Diese Auswahl macht sichtbar, ob eine Regel zu breit oder zu schmal greift. Eine robots.txt sollte nicht abstrakt, sondern anhand konkreter URL-Beispiele bewertet werden. Bei großen Websites können Server-Logs, Crawling-Daten und URL-Listen aus dem CMS die Auswahl unterstützen.

3. Regeln mit Suchmaschinen-Tools und Validatoren vergleichen

Nutzen Sie ein aktuelles Prüfwerkzeug, das die robots.txt-Syntax und die Wirkung auf konkrete URLs nachvollziehbar darstellt. Ein Tool ersetzt jedoch nicht die fachliche Prüfung: Nicht jede Suchmaschine unterstützt jede Erweiterung gleich, und ein Tester bildet möglicherweise nur einen bestimmten User-Agent ab.

Vergleichen Sie die Ergebnisse mit den realen Anforderungen der Website. Wenn ein Tool eine URL als erlaubt meldet, bedeutet das nicht automatisch, dass die Seite indexiert wird. Umgekehrt kann eine blockierte URL weiterhin über externe Links bekannt werden. Für eine belastbare Diagnose müssen Crawling, Indexierung und Zugriffsschutz getrennt betrachtet werden.

4. Googlebot, allgemeine Crawler und Sonderfälle auseinanderhalten

Ein Block für User-agent: * richtet sich grundsätzlich an Crawler, die diesen allgemeinen Block berücksichtigen. Ein zusätzlicher spezifischer Block kann für einen bestimmten Crawler gelten. Dadurch entstehen leicht Missverständnisse, wenn eine Regel für einen User-Agent getestet wird, aber ein anderer Crawler sie anders auswertet.

Definieren Sie spezifische Blöcke nur, wenn es dafür einen klaren Grund gibt. Je mehr Ausnahmen und Agenten enthalten sind, desto schwieriger wird die Datei. Dokumentieren Sie die Absicht hinter Sonderregeln und entfernen Sie sie, sobald der ursprüngliche Anwendungsfall nicht mehr besteht.

5. Nach der Änderung erneut kontrollieren

Speichern Sie die Datei in einer kontrollierten Änderung und prüfen Sie anschließend erneut die Live-Version. Kontrollieren Sie nicht nur die geänderte URL, sondern auch wichtige Nachbarpfade. Eine Änderung an /shop/ kann beispielsweise viele Unterbereiche betreffen.

Beobachten Sie danach die Server-Logs und die Berichte der verfügbaren Suchmaschinen-Werkzeuge. Änderungen an Crawling-Signalen wirken nicht immer sofort. Ein kurzfristig unveränderter Bericht beweist daher weder, dass die Änderung wirkungslos ist, noch dass sie vollständig verarbeitet wurde.

Praktische Entscheidungskriterien für Regeln

Vor einer neuen Disallow-Regel sollten Sie fünf Fragen beantworten:

  • Welches konkrete Problem soll gelöst werden? Geht es um Serverlast, URL-Parameter, doppelte Inhalte, interne Suchseiten oder einen nicht öffentlichen Bereich?
  • Welche exakten URLs sind betroffen? Beschreiben Sie einige erlaubte und gesperrte Beispiele, statt nur ein allgemeines Verzeichnis zu nennen.
  • Ist Crawling-Sperrung wirklich das richtige Mittel? Für vertrauliche Inhalte, Indexierungssteuerung oder technische Fehler können andere Maßnahmen passender sein.
  • Welche Nebenwirkungen entstehen? Prüfen Sie Ressourcen, Unterverzeichnisse, Sprachversionen, Weiterleitungen und Links aus Sitemaps.
  • Wer pflegt die Regel später? Eine verständliche, kurze Datei mit dokumentierter Absicht ist sicherer als ein kaum nachvollziehbares Geflecht aus Ausnahmen.

Ein gutes Ergebnis ist nicht die längste oder technisch ausgefeilteste robots.txt, sondern eine Datei, deren Regeln eine klar erkennbare Aufgabe erfüllen. Wenn keine belastbare Begründung für eine Sperre existiert, sollte sie nicht allein aus Gewohnheit übernommen werden.

FAQ

Kann eine fehlerhafte robots.txt das Ranking direkt verschlechtern?

Eine falsche Sperre kann verhindern, dass wichtige Inhalte oder benötigte Ressourcen gecrawlt werden. Dadurch können Suchmaschinen Seiten schlechter verstehen oder neue Inhalte später entdecken. Die robots.txt verändert jedoch nicht als direkte Bewertungszahl die Qualität einer Seite. Die konkrete Auswirkung hängt davon ab, welche URLs betroffen sind und welche anderen Signale vorliegen.

Ist Disallow dasselbe wie Noindex?

Nein. Disallow steuert das Crawling und verhindert den Abruf eines Pfads für den jeweiligen Crawler. Noindex ist ein Signal zur Indexierung und kann nur zuverlässig verarbeitet werden, wenn die Seite oder Ressource abgerufen werden darf. Wer eine URL aus dem Index entfernen möchte, sollte daher nicht ausschließlich auf eine robots.txt-Sperre setzen.

Warum sollte ich CSS- und JavaScript-Dateien nicht pauschal sperren?

Diese Ressourcen können für die Darstellung und das Verständnis einer Seite relevant sein. Wenn ein Crawler sie nicht laden darf, kann seine Einschätzung der ausgelieferten Seite unvollständig sein. Sperren Sie technische Dateien nur dann, wenn ein konkreter Grund besteht, und prüfen Sie vorher, ob sie für wichtige Seiten benötigt werden.

Kann die robots.txt geheime Verzeichnisse verstecken?

Nein. Die Datei ist öffentlich und freiwillige Regeln können ignoriert werden. Außerdem macht eine Disallow-Regel einen Pfad nicht unsichtbar, wenn er beispielsweise verlinkt wird. Vertrauliche Bereiche benötigen Zugriffsschutz oder dürfen gar nicht öffentlich ausgeliefert werden.

Wie oft sollte die robots.txt geprüft werden?

Eine feste allgemeine Frist ist weniger wichtig als anlassbezogene Kontrollen. Prüfen Sie die Datei bei Relaunches, Domainwechseln, Änderungen an CMS oder SEO-Plugins, neuen Verzeichnisstrukturen und größeren Änderungen an Sitemaps. Zusätzlich kann eine regelmäßige technische Überwachung sinnvoll sein, damit unerwartete Änderungen schnell auffallen.

Ist eine leere robots.txt problematisch?

Eine leere Datei enthält keine Sperrregeln und lässt Crawler grundsätzlich auf die erreichbaren Pfade zugreifen. Das ist nicht automatisch falsch. Ob die Konfiguration sinnvoll ist, hängt von der Website ab. Auch bei einer leeren Datei bleiben andere Themen wie Indexierungsregeln, URL-Parameter, interne Suchseiten und Zugriffsschutz relevant.

Was bedeutet ein Sternchen bei User-agent oder Wildcards?

Bei User-agent: * steht das Sternchen für einen allgemeinen User-Agent-Block. In Pfadangaben kann ein Sternchen als Platzhalter für Zeichenfolgen verwendet werden, sofern der jeweilige Crawler diese Syntax unterstützt. Weil Wildcards schnell zu weit greifen, sollten sie immer mit konkreten URLs und einem passenden Testwerkzeug überprüft werden.

Fazit: Die robots.txt bewusst und nachvollziehbar pflegen

Die häufigsten Fehler in der robots.txt entstehen durch pauschale Sperren, veraltete Konfigurationen, unpräzise Wildcards und die Verwechslung von Crawling, Indexierung und Sicherheit. Eine wirksame Prüfung beginnt deshalb mit der tatsächlich ausgelieferten Datei und führt über konkrete URL-Beispiele bis zur Kontrolle von Sitemap, Ressourcen und Website-Umgebung.

Halten Sie Regeln so kurz wie möglich, dokumentieren Sie ungewöhnliche Ausnahmen und testen Sie Änderungen nach jedem wichtigen technischen Eingriff erneut. So wird die robots.txt zu einem nachvollziehbaren Bestandteil der technischen Suchmaschinenoptimierung, statt selbst zur Ursache schwer erkennbarer Crawling-Probleme zu werden.

Warum jede Website eine Sitemap braucht: Der umfassende Ratgeber

Eine Sitemap ist kein sichtbares Gütesiegel und auch kein direkter Garant für bessere Rankings. Dennoch gehört sie für die meisten Websites zu den wichtigsten technischen Grundlagen der Suchmaschinenoptimierung. Sie hilft Suchmaschinen dabei, relevante URLs zu entdecken, die Struktur einer Website besser zu verstehen und Änderungen effizienter zu verarbeiten.

In diesem Ratgeber erfahren Sie, warum jede Website eine Sitemap braucht, welche Sitemap-Arten es gibt, wann sie besonders wichtig ist und wie Sie eine Sitemap sinnvoll erstellen, prüfen und dauerhaft pflegen. Dabei geht es nicht nur um Suchmaschinen: Eine gut geplante Sitemap kann auch die interne Organisation und die technische Qualität eines Webauftritts verbessern.

Was ist eine Sitemap?

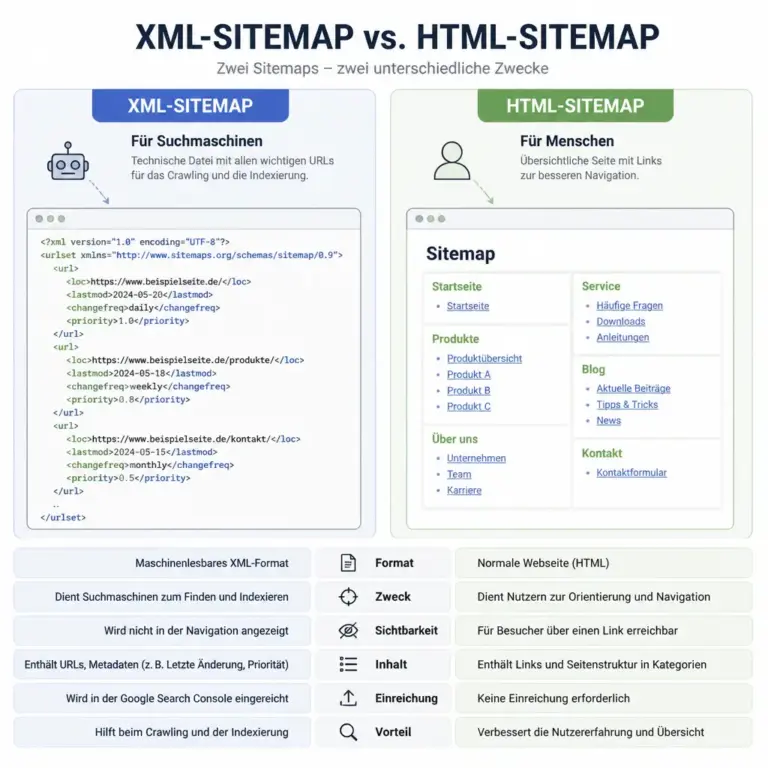
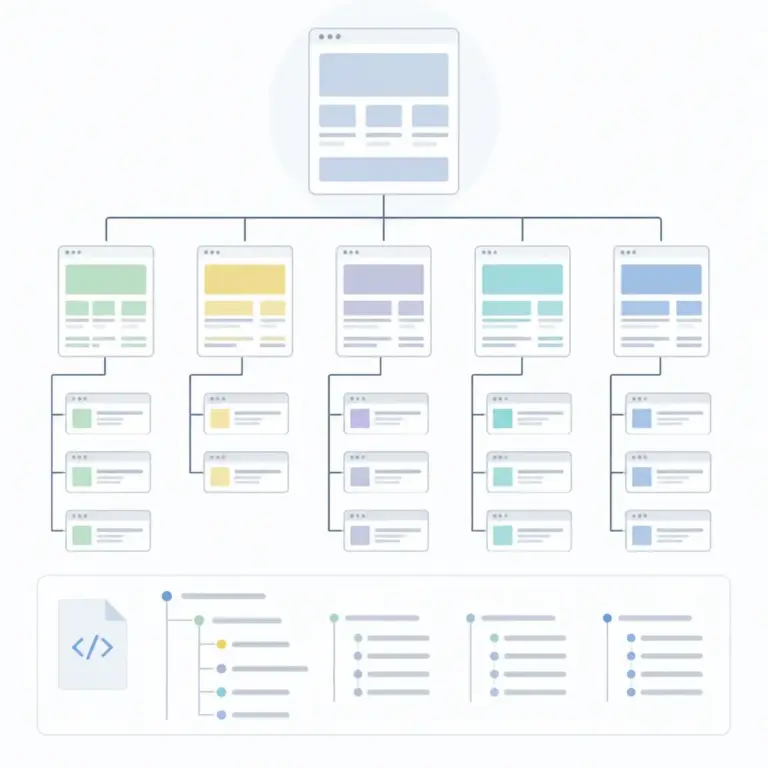
Vergleich zwischen XML-Sitemap fu00fcr Suchmaschinen und HTML-Sitemap fu00fcr Besucher
Eine XML-Sitemap unterstützt Suchmaschinen, während eine HTML-Sitemap Menschen Orientierung bietet.

Die Abbildung macht sichtbar, dass beide Sitemap-Arten unterschiedliche Aufgaben erfüllen. Die technische Liste ist nicht als Ersatz für die sichtbare Navigation gedacht.

Eine Sitemap ist eine strukturierte Übersicht wichtiger Seiten, Dateien oder Inhalte einer Website. Im Zusammenhang mit Suchmaschinen ist meist die XML-Sitemap gemeint. Sie wird in einem standardisierten Format bereitgestellt und enthält vor allem URLs, die von Suchmaschinen gefunden und berücksichtigt werden sollen.

Eine XML-Sitemap kann zusätzliche Informationen enthalten, beispielsweise den Zeitpunkt der letzten wesentlichen Änderung. Diese Angaben sind Hinweise, keine Anweisungen. Eine Suchmaschine entscheidet selbst, welche URL sie crawlt, wie häufig sie sie besucht und ob sie in den Suchindex aufgenommen wird.

Daneben gibt es die HTML-Sitemap. Sie richtet sich hauptsächlich an Besucherinnen und Besucher und stellt wichtige Bereiche einer Website als übersichtliche Linkliste dar. Bei kleinen Websites ist eine HTML-Sitemap nicht immer erforderlich, bei umfangreichen oder komplex strukturierten Angeboten kann sie jedoch die Orientierung erleichtern.

Wichtig ist die Unterscheidung zwischen einer Sitemap und der Navigation. Die Navigation dient der täglichen Nutzung durch Menschen. Die XML-Sitemap dient vor allem dazu, Suchmaschinen und anderen technischen Systemen eine zusätzliche, strukturierte Orientierung zu geben. Sie ersetzt weder eine logische Menüführung noch eine gute interne Verlinkung.

Warum jede Website eine Sitemap braucht

Die zentrale Aufgabe einer Sitemap besteht darin, wichtige URLs auffindbar zu machen. Suchmaschinen folgen zwar Links und entdecken dadurch viele Inhalte, doch dieser Prozess ist nicht bei jeder Website gleich zuverlässig. Neue, tief verschachtelte, selten verlinkte oder technisch schwer erreichbare Seiten können leichter übersehen werden.

Neue Inhalte schneller auffindbar machen

Wenn ein Blogartikel, eine Produktseite oder ein wichtiger Ratgeber veröffentlicht wird, muss eine Suchmaschine zunächst von dieser URL erfahren. Eine automatisch aktualisierte Sitemap kann die neue Seite als Teil des vorhandenen Inhaltsbestands sichtbar machen. Das bedeutet nicht, dass die URL sofort gecrawlt oder indexiert wird. Die Entdeckung wird jedoch grundsätzlich erleichtert.

Besonders nützlich ist das bei Websites, auf denen regelmäßig neue Inhalte entstehen. Dazu zählen Nachrichtenportale, Onlineshops, Wissensdatenbanken, Veranstaltungsseiten und große Unternehmenswebsites. Auch eine kleine Website profitiert davon, wenn zentrale neue Seiten nicht lange nur über wenige interne Links erreichbar sind.

Große Websites besser strukturieren

Bei mehreren Hundert oder Tausenden von URLs wird die technische Kontrolle anspruchsvoller. Eine Sitemap kann dabei helfen, den vorgesehenen Inhaltsbestand von zufälligen oder unwichtigen URLs zu trennen. So lässt sich leichter prüfen, ob wichtige Bereiche enthalten sind und ob sich unerwartete URLs eingeschlichen haben.

Eine Sitemap ist deshalb auch ein Kontrollinstrument für Betreiber. Wer regelmäßig überprüft, welche URLs darin stehen, erkennt häufig technische Probleme: versehentlich veröffentlichte Testseiten, veraltete Produktadressen, fehlerhafte Weiterleitungen oder Seiten, die trotz ihrer Bedeutung nicht erfasst werden.

Websites mit schwacher interner Verlinkung unterstützen

Eine Sitemap kann fehlende interne Links nicht reparieren. Sie kann aber als zusätzliche Entdeckungshilfe dienen, wenn bestimmte Seiten nur wenige eingehende Links besitzen. Das betrifft beispielsweise Landingpages aus Kampagnen, Archive, Filterkombinationen oder spezielle Informationsseiten.

Die richtige Schlussfolgerung lautet daher nicht: „Mit einer Sitemap sind interne Links überflüssig.“ Besser ist: „Die Sitemap ergänzt eine starke interne Verlinkung.“ Wichtige Inhalte sollten weiterhin von passenden, gut erreichbaren Seiten aus verlinkt werden.

Technische Änderungen transparenter machen

Bei Migrationen, Relaunches oder umfangreichen Überarbeitungen ist eine Sitemap besonders hilfreich. Sie kann nach dem Umzug die neue URL-Struktur abbilden und als Grundlage für Kontrollen dienen. Gemeinsam mit Weiterleitungen, einer aktuellen internen Verlinkung und einer technischen Prüfung entsteht ein belastbareres Bild der Website.

Auch nach größeren Änderungen sollte geprüft werden, ob nur die gewünschten URLs in der Sitemap stehen. Eine veraltete Sitemap mit alten Adressen kann die technische Auswertung erschweren und unnötige Signale senden.

XML-Sitemap, HTML-Sitemap und Bild-Sitemap im Vergleich

Sitemap-Art Hauptzweck Typische Zielgruppe Besonderheit
XML-Sitemap Wichtige URLs strukturiert mitteilen Suchmaschinen und technische Systeme Für SEO und Crawling besonders relevant
HTML-Sitemap Inhalte als übersichtliche Linkliste zeigen Besucherinnen und Besucher Kann Orientierung und interne Verlinkung verbessern
Bild-Sitemap Relevante Bilder zusätzlich beschreiben Bildersuchsysteme Vor allem bei bildorientierten Websites interessant
Video-Sitemap Videoinhalte strukturiert kennzeichnen Suchmaschinen Für umfangreiche Videobibliotheken sinnvoll

Die meisten Websites benötigen zunächst eine gepflegte XML-Sitemap. Bild- oder Video-Sitemaps sind keine Pflicht für jedes Projekt. Sie können sich lohnen, wenn Bilder oder Videos einen wesentlichen Teil des Angebots ausmachen und technisch relevante Zusatzinformationen vorhanden sind.

Welche URLs gehören in eine Sitemap?

In eine XML-Sitemap gehören grundsätzlich die kanonischen, öffentlich erreichbaren URLs, die für Nutzerinnen und Nutzer einen eigenständigen Wert haben. Dazu zählen beispielsweise Startseiten, wichtige Leistungsseiten, Ratgeber, redaktionelle Beiträge, Produktseiten und relevante Kategorieseiten.

Nicht jede technisch erreichbare URL sollte aufgenommen werden. Eine Sitemap ist keine vollständige Liste aller Adressen, die ein Server ausliefern kann. Sie sollte vielmehr den gewünschten, qualitativ relevanten Bestand der Website abbilden.

Geeignete URLs

  • Seiten mit einem erfolgreichen Serverstatus, normalerweise einer erreichbaren HTML-Antwort.
  • Indexierbare Inhalte, die nicht ausdrücklich von Suchmaschinen ausgeschlossen werden.
  • Kanonische URLs, auf die keine andere Adresse als bevorzugte Version verweist.
  • Inhalte, die für die Zielgruppe nützlich und dauerhaft relevant sind.
  • Neue oder wesentlich aktualisierte Seiten, sofern sie weiterhin veröffentlicht bleiben sollen.

Ungeeignete URLs

  • Seiten mit einer Weiterleitung oder einem Fehlerstatus.
  • URLs mit einem Ausschluss durch Robots-Meta-Angaben oder andere technische Vorgaben.
  • Doppelte Inhalte, alternative Parameter-Varianten und interne Suchergebnisse.
  • Warenkorb-, Kassen-, Login- oder persönliche Kontoseiten.
  • Temporäre Testseiten, Vorschauen und nicht fertige Entwürfe.
  • Seiten, die zwar technisch existieren, aber keinen eigenständigen Nutzen bieten.

Eine wichtige Qualitätsprüfung lautet: Würde diese URL auch dann für Suchmaschinen relevant sein, wenn sie über einen normalen Link entdeckt wird? Wenn die Antwort klar nein lautet, gehört sie meist nicht in die Sitemap.

Wie wird eine Sitemap erstellt?

Der beste Weg hängt vom verwendeten System und vom Umfang der Website ab. Viele Content-Management-Systeme erzeugen automatisch eine Sitemap. Häufig ist sie unter einer Adresse wie /sitemap.xml erreichbar. Bei größeren Websites kann das System mehrere Sitemap-Dateien erstellen und über eine Sitemap-Indexdatei miteinander verbinden.

Bei einer manuellen Erstellung werden die gewünschten URLs in einem gültigen XML-Format hinterlegt. Das ist für kleine, selten veränderte Websites möglich, erfordert aber regelmäßige Pflege. Schon eine einzelne veraltete oder falsch formatierte Adresse kann die Qualität der Datei beeinträchtigen.

Bei dynamischen Websites ist eine automatische Generierung meist sinnvoller. Sie sollte jedoch nicht blind aktiviert werden. Manche Erweiterungen nehmen standardmäßig Archive, Parameterseiten oder andere URL-Typen auf, die nicht zum gewünschten Index gehören. Die Einstellungen sollten deshalb nach der Einrichtung kontrolliert werden.

Worauf sollte das XML-Format achten?

Eine XML-Sitemap muss technisch gültig sein und die vorgesehenen Elemente korrekt verwenden. URLs sollten vollständig angegeben werden und die tatsächliche bevorzugte Version der Adresse darstellen. Einheitlichkeit ist wichtig: Werden beispielsweise sichere und unsichere Protokollvarianten oder verschiedene Hostnamen vermischt, entsteht unnötige Unklarheit.

Das Änderungsdatum sollte nur dann aktualisiert werden, wenn sich der Inhalt tatsächlich wesentlich verändert hat. Ein tägliches Aktualisieren aller URLs ohne inhaltlichen Grund liefert keinen verlässlichen Hinweis. Auch die optionale Angabe einer Priorität sollte nicht als direkte Rankingsteuerung missverstanden werden.

Sitemap bei Suchmaschinen einreichen

Eine Sitemap kann über die robots.txt referenziert werden. Dort wird die vollständige URL der Datei angegeben. Zusätzlich kann sie in den jeweiligen Bereichen für Website-Verwaltung und Suchanalyse eingereicht werden. Das erleichtert die Zuordnung zur richtigen Website und stellt häufig nützliche Statusinformationen bereit.

Das Einreichen bedeutet nicht, dass jede enthaltene Seite indexiert wird. Es teilt vielmehr mit, welche URLs der Betreiber als relevant betrachtet. Suchmaschinen vergleichen diese Angaben mit ihren eigenen Erkenntnissen, etwa mit gefundenen Links, Statuscodes, Weiterleitungen und Qualitätsmerkmalen.

Nach einer Einreichung sollten Betreiber auf Warnungen und Fehler achten. Ein einzelner Fehler in einer Datei ist nicht automatisch ein schweres Problem. Wiederkehrende Abweichungen zwischen Sitemap und tatsächlichem Websitezustand deuten jedoch auf Pflege- oder Konfigurationsbedarf hin.

Sitemap und Crawling: Was sie leisten kann und was nicht

Eine Sitemap verbessert die Möglichkeit, URLs zu entdecken. Sie garantiert weder Crawling noch Indexierung und schon gar nicht eine bestimmte Position in den Suchergebnissen. Suchmaschinen bewerten unter anderem die Zugänglichkeit, den Inhalt, die interne Verlinkung, technische Signale und die erwartete Bedeutung einer Seite.

Auch die Crawling-Belastung wird durch eine Sitemap nicht automatisch gelöst. Wenn eine Website sehr viele minderwertige oder doppelte URLs enthält, sollte das Problem an der URL-Struktur gelöst werden. Eine Sitemap, die lediglich alle vorhandenen Adressen auflistet, kann die Übersicht sogar verschlechtern.

Für eine gute technische Grundlage sollten deshalb mehrere Elemente zusammenpassen:

  • eine klare Informationsarchitektur,
  • relevante interne Links,
  • korrekte Statuscodes und Weiterleitungen,
  • eine konsistente Canonical-Konfiguration,
  • eine sinnvolle Steuerung von indexierbaren und nicht indexierbaren Bereichen,
  • eine aktuelle, fehlerarme Sitemap.

Die Sitemap ist damit ein wichtiges Puzzleteil, aber kein Ersatz für eine insgesamt saubere Website.

Besondere Fälle: kleine Websites, Onlineshops und Relaunches

Kleine Unternehmenswebsite

Bei einer kleinen Website mit wenigen, gut verlinkten Seiten ist eine Sitemap nicht immer zwingend erforderlich. Trotzdem ist sie meist mit geringem Aufwand verfügbar und schafft eine zusätzliche technische Absicherung. Gerade bei Änderungen oder einem späteren Ausbau kann sie wertvoll sein.

Blog oder redaktionelles Portal

Regelmäßig wachsende Websites profitieren besonders von einer automatisch gepflegten Sitemap. Neue Beiträge, Kategorien und Aktualisierungen sollten nach einer passenden Strategie berücksichtigt werden. Alte Inhalte sollten nicht automatisch entfernt werden, wenn sie weiterhin nützlich und erreichbar sind.

Onlineshop

Shops müssen besonders sorgfältig zwischen wertvollen Produktseiten und wenig hilfreichen URL-Varianten unterscheiden. Filter, Sortierungen, Suchergebnisse und Sitzungsparameter können eine große Zahl ähnlicher Adressen erzeugen. In die Sitemap gehören in der Regel die gewünschten, kanonischen Produkt- und Kategorieseiten, nicht jede Filterkombination.

Website-Relaunch

Vor einem Relaunch sollte bekannt sein, welche URLs künftig bestehen bleiben, geändert oder entfernt werden. Nach dem Start muss die Sitemap die neue Struktur abbilden. Alte Adressen gehören nicht einfach weiter in die neue Datei, sondern sollten passend weitergeleitet oder bewusst mit einem geeigneten Status beendet werden.

Sitemap regelmäßig prüfen und pflegen

Eine Sitemap ist nur dann dauerhaft nützlich, wenn sie dem tatsächlichen Websitezustand entspricht. Für kleine Websites genügt oft eine Prüfung nach größeren Änderungen. Bei Shops, Portalen und stark wachsenden Projekten sollte die Kontrolle in einen festen technischen Prozess integriert werden.

Eine praktische Prüfung kann folgende Fragen enthalten:

  • Sind alle enthaltenen URLs erreichbar?
  • Gibt es Weiterleitungen oder Fehlerseiten in der Datei?
  • Stimmen Protokoll, Domain und bevorzugte URL-Version?
  • Sind ausgeschlossene oder nicht öffentliche Bereiche enthalten?
  • Fehlen wichtige neue Seiten?
  • Entsprechen Änderungsdaten den tatsächlichen inhaltlichen Änderungen?
  • Wird die Sitemap nach einem Relaunch automatisch oder manuell aktualisiert?

Zusätzlich lohnt sich ein Vergleich zwischen Sitemap, intern verlinkten Seiten und den Berichten der Suchmaschinenverwaltung. Abweichungen sind nicht immer Fehler, liefern aber Hinweise für eine genauere Untersuchung.

Häufige Fehler bei Sitemaps

Zu den häufigsten Problemen gehört eine Sitemap, die zu viele URLs enthält. Je größer die Datei, desto wichtiger ist die Auswahl. Ebenso problematisch sind URLs, die auf Weiterleitungen zeigen, nicht erreichbar sind oder durch widersprüchliche technische Angaben ausgeschlossen werden.

Ein weiterer Fehler ist die Annahme, dass die Sitemap Rankings erzwingt. Sie kann die Entdeckung unterstützen, aber keinen schwachen Inhalt, eine schlechte Nutzerführung oder technische Barrieren ausgleichen. Auch eine veraltete Sitemap nach einem Domainwechsel oder Relaunch kann zu unnötigen Unklarheiten führen.

Manche Betreiber erstellen außerdem eine Sitemap, reichen sie einmal ein und vergessen sie danach. Sinnvoller ist ein Prozess, bei dem die Datei automatisch gepflegt und in regelmäßigen Abständen stichprobenartig kontrolliert wird.

FAQ

Ist eine Sitemap für jede Website verpflichtend?

Nein. Eine Sitemap ist normalerweise keine allgemeine Pflicht. Für die meisten Websites ist sie dennoch empfehlenswert, weil sie die Entdeckung wichtiger URLs erleichtert und eine zusätzliche Kontrolle über den veröffentlichten Inhaltsbestand ermöglicht.

Verbessert eine Sitemap automatisch das Ranking?

Nein. Eine Sitemap ist kein direkter Rankingfaktor im Sinne einer garantierten Verbesserung. Sie kann Suchmaschinen helfen, relevante Inhalte zu finden. Ob eine Seite indexiert wird und wie sie bewertet wird, hängt von vielen weiteren technischen und inhaltlichen Signalen ab.

Reicht eine Sitemap allein für gute SEO aus?

Nein. Sie ergänzt unter anderem interne Verlinkung, eine klare Seitenstruktur, gute Inhalte, korrekte Statuscodes und eine sinnvolle Indexierungssteuerung. Eine Sitemap kann grundlegende Probleme nicht ersetzen oder verdecken.

Wie oft sollte eine Sitemap aktualisiert werden?

Sie sollte aktualisiert werden, sobald sich der gewünschte Bestand wichtiger URLs ändert. Bei dynamischen Websites geschieht das idealerweise automatisch. Das Änderungsdatum einzelner URLs sollte trotzdem nur bei wesentlichen Änderungen angepasst werden.

Kann eine Sitemap zu viele URLs enthalten?

Ja. Eine Sitemap sollte nicht jede technisch erzeugbare Adresse enthalten. Doppelte, unwichtige, private, weitergeleitete oder ausgeschlossene URLs gehören normalerweise nicht hinein. Eine kleinere, sorgfältig ausgewählte Datei ist hilfreicher als eine vollständige Liste aller Varianten.

Braucht eine kleine Website zusätzlich eine HTML-Sitemap?

Nicht unbedingt. Wenn die Navigation übersichtlich ist und alle wichtigen Seiten gut erreichbar sind, kann eine HTML-Sitemap entbehrlich sein. Bei vielen Unterseiten, älteren Inhalten oder einer komplexen Struktur kann sie Besucherinnen und Besuchern dennoch zusätzliche Orientierung geben.

Was passiert, wenn die Sitemap fehlerhafte URLs enthält?

Einzelne Fehler führen nicht automatisch zu einem großen Problem. Häufen sich jedoch falsche URLs, kann die Datei ihre Funktion als verlässliche Übersicht verlieren. Die fehlerhaften Adressen sollten geprüft und entfernt oder korrigiert werden. Wichtig ist außerdem, die Ursache in der automatischen Generierung zu beheben.

Fazit: Eine Sitemap schafft technische Klarheit

Warum jede Website eine Sitemap braucht, lässt sich vor allem mit drei Punkten beantworten: Sie unterstützt die Entdeckung wichtiger URLs, schafft Transparenz über den gewünschten Inhaltsbestand und erleichtert die Kontrolle bei Wachstum oder technischen Änderungen. Besonders große, regelmäßig aktualisierte oder komplex strukturierte Websites profitieren davon.

Eine gute Sitemap ist nicht möglichst umfangreich, sondern möglichst präzise. Sie enthält indexierbare, kanonische und wertvolle URLs, wird automatisch oder zuverlässig aktualisiert und regelmäßig auf Fehler geprüft. Zusammen mit einer verständlichen Navigation, einer starken internen Verlinkung und technisch sauberen Seiten bildet sie eine solide Grundlage für eine gut auffindbare Website.

Sitemap.xml prüfen und optimieren: Der umfassende Ratgeber für bessere Crawlbarkeit

Eine gut gepflegte sitemap.xml hilft Suchmaschinen dabei, wichtige URLs einer Website effizient zu entdecken und regelmäßig zu crawlen. Sie ersetzt weder eine klare interne Verlinkung noch hochwertige Inhalte, kann aber besonders bei großen, neuen oder häufig veränderten Websites wertvolle Orientierung geben. In diesem Ratgeber erfahren Sie, wie Sie Ihre Sitemap.xml prüfen, typische Fehler erkennen und die Datei dauerhaft sinnvoll optimieren.

Was ist eine Sitemap.xml und welche Aufgabe hat sie?

Eine XML-Sitemap ist eine maschinenlesbare Datei, in der die indexierbaren URLs einer Website aufgelistet werden. Sie liegt häufig unter einer Adresse wie https://www.beispiel.de/sitemap.xml oder verweist als Sitemap-Index auf mehrere einzelne Sitemaps. Suchmaschinen können diese URLs abrufen und mit den Informationen aus der Sitemap abgleichen.

Wichtig ist die richtige Einordnung: Eine Sitemap ist keine Liste von Seiten, die automatisch indexiert werden. Sie ist vielmehr ein Hinweis an Suchmaschinen, welche URLs Sie für relevant halten. Ob eine Seite tatsächlich gecrawlt und in den Suchindex aufgenommen wird, hängt zusätzlich von Faktoren wie Inhalt, interner Verlinkung, Zugriffsmöglichkeit, Canonical-Angabe und technischen Signalen ab.

Für kleine Websites mit wenigen, gut verlinkten Seiten ist eine Sitemap nicht immer entscheidend. Dennoch gehört sie heute meist zur technischen Grundausstattung. Besonders nützlich ist sie in folgenden Situationen:

  • Die Website enthält viele Seiten oder wird regelmäßig erweitert.
  • Neue Inhalte sind nur über wenige interne Links erreichbar.
  • Es gibt Archive, Filterseiten oder andere große URL-Strukturen, die sorgfältig gesteuert werden müssen.
  • Die Website enthält Bilder, Videos oder Nachrichteninhalte mit speziellen Anforderungen.
  • Die interne Verlinkung ist noch nicht vollständig ausgebaut.
  • Nach einem Relaunch sollen wichtige URLs schneller erkannt werden.

Sitemap.xml prüfen: Die wichtigsten Kontrollen im Überblick

Infografik mit den wichtigsten Pru00fcfschritten fu00fcr eine Sitemap.xml
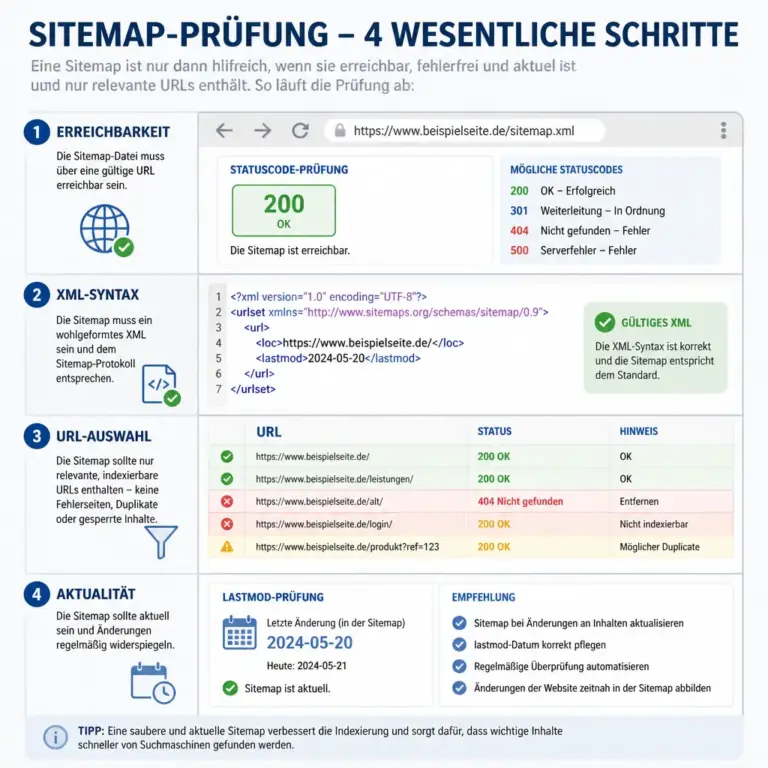
Diese Übersicht zeigt die zentralen Prüfschritte einer Sitemap-Kontrolle.

Achten Sie in der Grafik auf die Verbindung zwischen technischer Erreichbarkeit und der Qualität der enthaltenen URLs. Eine Sitemap ist erst dann hilfreich, wenn sie sowohl gültig ausgeliefert wird als auch relevante, indexierbare Seiten enthält.

Beim Prüfen der Sitemap geht es nicht nur darum, ob die Datei technisch erreichbar ist. Entscheidend ist, ob sie konsistente und tatsächlich wertvolle URLs enthält. Eine kurze, saubere Sitemap ist in der Regel nützlicher als eine sehr große Datei mit zahlreichen Weiterleitungen, Fehlerseiten oder irrelevanten Parametervarianten.

Prüfbereich Worauf Sie achten sollten Typische Maßnahme
Erreichbarkeit Die Datei liefert eine erfolgreiche HTTP-Antwort und ist öffentlich abrufbar. Server, URL und Zugriffsregeln kontrollieren.
Format Die XML-Struktur ist gültig und sauber codiert. XML-Validator oder Suchmaschinen-Tool verwenden.
URL-Auswahl Nur kanonische, indexierbare und relevante URLs sind enthalten. Weiterleitungen, Fehlerseiten und Ausschlussseiten entfernen.
Aktualität Neue, geänderte oder entfernte Inhalte werden korrekt berücksichtigt. Generierung und Aktualisierungslogik prüfen.
Abdeckung Wichtige Seitentypen werden vollständig erfasst. Stichproben mit Website-Struktur und Indexbericht vergleichen.
Technische Grenzen Datei- und URL-Grenzen werden eingehalten. Sitemap-Index für größere Websites einsetzen.

Erreichbarkeit und Statuscode kontrollieren

Rufen Sie die Sitemap direkt im Browser oder über ein technisches Prüfwerkzeug auf. Sie sollte ohne Anmeldung, Cookie-Abfrage oder JavaScript-Ausführung erreichbar sein. Prüfen Sie außerdem, ob die Datei den erwarteten Inhalt ausliefert und nicht versehentlich auf eine HTML-Fehlerseite, eine Startseite oder eine veraltete Domain weiterleitet.

Ein erfolgreicher Statuscode allein reicht nicht immer aus. Manche Server liefern bei nicht vorhandenen Dateien eine eigene Fehlerseite mit einem technisch erfolgreichen Statuscode aus. Deshalb sollte auch der Inhalt überprüft werden: Beginnt die Datei mit einer gültigen XML-Struktur und enthält sie die erwarteten Sitemap-Elemente?

XML-Syntax und Zeichencodierung prüfen

Eine Sitemap muss syntaktisch korrekt sein. Achten Sie unter anderem auf korrekt geschlossene Elemente, gültige URLs und eine passende Zeichencodierung. Sonderzeichen in URLs müssen korrekt behandelt werden. Auch unzulässige Steuerzeichen oder fehlerhafte Einträge können dazu führen, dass Teile der Datei nicht verarbeitet werden.

Die grundlegende Struktur einer URL-Sitemap sieht beispielsweise so aus:

<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://www.beispiel.de/wichtige-seite/</loc>
  </url>
</urlset>

Die Beispielstruktur ist bewusst einfach gehalten. Zusätzliche Elemente wie lastmod können sinnvoll sein, wenn der angegebene Änderungszeitpunkt zuverlässig gepflegt wird.

Welche URLs gehören in eine Sitemap?

Die zentrale Entscheidungsfrage lautet: Würde die Website diese URL einem Suchmaschinen-Crawler und einem potenziellen Besucher als eigenständige, wertvolle Seite empfehlen? Wenn die Antwort eindeutig Nein lautet, gehört die URL meist nicht in die Sitemap.

In der Regel sollten enthalten sein:

  • kanonische URLs mit dem bevorzugten Protokoll und Hostnamen,
  • öffentlich erreichbare Seiten mit relevantem, eigenständigem Inhalt,
  • indexierbare Kategorien, Produkte, Dienstleistungen oder Ratgeberseiten,
  • wichtige Seiten, die dauerhaft Bestandteil der Website bleiben,
  • aktualisierte URLs, wenn deren Inhalt tatsächlich überarbeitet wurde.

Eine URL sollte möglichst gleichzeitig mehrere Bedingungen erfüllen: Sie ist mit dem HTTP-Statuscode 200 erreichbar, nicht durch noindex ausgeschlossen, nicht per robots.txt blockiert und verweist über das Canonical-Element auf sich selbst oder wird von der Website als kanonische Variante behandelt.

Welche URLs sollten ausgeschlossen werden?

Häufige Kandidaten für den Ausschluss sind:

  • Weiterleitungsziele, wenn die alte URL selbst noch in der Sitemap steht,
  • 404- und 410-Seiten,
  • URLs mit noindex,
  • interne Suchergebnisse, Warenkörbe und Konto-Seiten,
  • Session-IDs und unnötige Tracking-Parameter,
  • technische Varianten mit falschem Protokoll oder falschem Hostnamen,
  • doppelte Inhalte ohne eigenständigen Suchwert,
  • unvollständige oder vorläufige Seiten.

Ein häufiger Fehler ist die automatische Aufnahme jeder URL, die ein Content-Management-System erzeugt. Dazu können beispielsweise Autorenarchive, Schlagwortseiten, Druckversionen, facettierte Filter oder paginierte Varianten gehören. Diese URL-Typen müssen nicht grundsätzlich ausgeschlossen werden. Entscheidend ist, ob sie einen eigenständigen Nutzen haben und bewusst indexiert werden sollen.

Die Sitemap.xml sinnvoll optimieren

Die Optimierung beginnt mit einer klaren Trennung zwischen wichtigen Inhalts-URLs und technischen Nebenprodukten. Ziel ist kein möglichst umfangreiches Verzeichnis, sondern ein verlässliches Signal über die Seiten, die Suchmaschinen tatsächlich berücksichtigen sollen.

Nur kanonische URLs verwenden

Wenn eine Seite unter mehreren Varianten erreichbar ist, sollte nur die bevorzugte Version in der Sitemap stehen. Typische Varianten entstehen durch HTTP und HTTPS, verschiedene Hostnamen, Groß- und Kleinschreibung, abschließende Schrägstriche oder Parameter. Legen Sie eine konsistente URL-Struktur fest und verwenden Sie sie überall: in der Sitemap, in Canonical-Tags, in internen Links und möglichst auch in Weiterleitungen.

Die Sitemap darf nicht als Ort dienen, an dem Suchmaschinen zwischen mehreren konkurrierenden URL-Varianten wählen müssen. Je klarer das Signal, desto leichter lässt sich die technische Struktur prüfen.

Das Änderungsdatum vorsichtig einsetzen

Das Element lastmod beschreibt, wann sich der Inhalt einer URL zuletzt wesentlich geändert hat. Es sollte nicht bei jedem automatischen Seitenaufruf oder jeder kleinen Systemänderung aktualisiert werden. Ein ständig wechselndes Datum ohne relevante Inhaltsänderung verliert an Aussagekraft.

Verwenden Sie lastmod vor allem dann, wenn die Daten zuverlässig aus dem Redaktionssystem stammen. Eine echte Überarbeitung eines Ratgebers, eine Änderung zentraler Produktinformationen oder eine wichtige Aktualisierung eines Leistungsangebots sind plausible Anlässe. Das Datum sollte sich auf den Inhalt beziehen, nicht lediglich auf das technische Erstellungsdatum einer neuen Sitemap-Datei.

Priorität und Änderungsfrequenz nicht überschätzen

Ältere Sitemap-Felder wie eine allgemeine Priorität oder eine Änderungsfrequenz werden von modernen Suchmaschinen nicht als verbindliche Steuerung verstanden. Sie ersetzen keine gute Informationsarchitektur und garantieren keinen häufigeren Crawl. Konzentrieren Sie sich daher auf korrekte URLs, verlässliche Änderungsdaten und eine sinnvolle Auswahl.

Sitemap-Index für umfangreiche Websites einsetzen

Große Websites können mehrere thematische oder technische Sitemaps verwenden, etwa getrennt nach Produkten, Ratgebern, Kategorien oder Sprachen. Ein Sitemap-Index bündelt diese Dateien. Das erleichtert die Wartung und ermöglicht eine gezielte Fehleranalyse.

Achten Sie auf eine verständliche Benennung. Eine Aufteilung nach Seitentypen kann sinnvoller sein als eine rein zufällige Aufteilung nach Dateigröße. Wenn bei einem Relaunch nur die Produkt-Sitemap fehlerhaft ist, lässt sich das Problem schneller eingrenzen, wenn die Struktur klar erkennbar ist.

Sitemap.xml und robots.txt richtig verbinden

Die robots.txt-Datei und die Sitemap erfüllen unterschiedliche Aufgaben. Die robots.txt kann das Crawling bestimmter Bereiche einschränken. Die Sitemap listet URLs auf, die als relevant und zugänglich betrachtet werden. Sie sollten deshalb keine URL in der Sitemap angeben, deren Abruf Sie gleichzeitig über robots.txt verhindern.

Ein Verweis in der robots.txt kann die Auffindbarkeit der Sitemap verbessern. Er kann beispielsweise auf die vollständige absolute URL der Sitemap oder des Sitemap-Index zeigen. Prüfen Sie dabei, dass der Hostname und das Protokoll genau zur Website passen.

Beachten Sie außerdem: Eine robots.txt-Sperre ist kein verlässlicher Ersatz für noindex, wenn eine URL aus dem Suchindex entfernt werden soll. Ist eine Seite bereits bekannt, kann eine reine Crawling-Sperre verhindern, dass Suchmaschinen das gewünschte Ausschlusssignal abrufen. Technische Maßnahmen sollten daher nach dem konkreten Ziel ausgewählt werden.

Sitemap in Suchmaschinen-Tools einreichen und überwachen

Reichen Sie die Sitemap beziehungsweise den Sitemap-Index in den passenden Verwaltungsoberflächen der Suchmaschinen ein. Das ist meist nur ein Hinweis und keine Garantie für Crawling oder Indexierung. Der Vorteil liegt vor allem in der Überwachung: Sie können erkennen, ob die Datei abgerufen wurde, ob Fehler gemeldet werden und wie sich bekannte URLs im Verhältnis zu den tatsächlich indexierten Seiten entwickeln.

Vergleichen Sie die Sitemap nicht unkritisch mit jeder URL, die in einem Indexbericht auftaucht. Suchmaschinen können URLs entdecken, die nicht in Ihrer Sitemap stehen, beispielsweise über interne oder externe Links. Umgekehrt kann eine URL in der Sitemap stehen, ohne indexiert zu werden. Diese Abweichung ist ein Anlass zur Analyse, aber nicht automatisch ein technischer Fehler.

Für eine belastbare Prüfung kombinieren Sie mehrere Perspektiven:

  • Sitemap-Inhalt und Sitemap-Fehlermeldungen,
  • Crawling- und Indexierungsberichte,
  • Server-Logs oder Crawling-Daten, sofern verfügbar,
  • interne Verlinkung und Website-Struktur,
  • Stichproben bei wichtigen Seitentypen,
  • Weiterleitungen, Canonical-Tags und Statuscodes.

Typische Fehler beim Prüfen und Optimieren

Die Sitemap enthält jede automatisch erzeugte URL

Eine automatische Generierung ist bequem, aber nicht automatisch sinnvoll. Prüfen Sie die Regeln des eingesetzten Systems. Manche Erweiterungen nehmen standardmäßig Archive, Filter oder Medienseiten auf, obwohl diese für die organische Suche keine eigenständige Rolle spielen sollen.

Die Datei ist aktuell, aber inhaltlich unzuverlässig

Eine täglich neu geschriebene Sitemap ist nicht automatisch besser. Wenn entfernte Seiten, alte Weiterleitungen oder falsche Änderungsdaten enthalten bleiben, entsteht ein dauerhaftes Qualitätsproblem. Entscheidend ist die Logik hinter der Generierung: Wird vor der Ausgabe geprüft, ob eine URL indexierbar, erreichbar und kanonisch ist?

Wichtige Seiten fehlen trotz vorhandener Sitemap

Manchmal wird nur die Startseite oder nur eine bestimmte Kategorie erfasst. Prüfen Sie deshalb nicht nur die Datei selbst, sondern auch die Seitentypen, die das System einbezieht. Ein Vergleich mit der XML-Struktur, der Navigation und einer repräsentativen URL-Liste zeigt häufig, ob Produkte, Beiträge, Landingpages oder regionale Seiten fehlen.

Sitemap und interne Links werden verwechselt

Eine URL in der Sitemap ist kein Ersatz für eine gute interne Verlinkung. Wichtige Seiten sollten über nachvollziehbare Menüs, Kategorien, kontextbezogene Links oder thematische Übersichten erreichbar sein. Die Sitemap kann die Entdeckung unterstützen, vermittelt aber nicht automatisch die inhaltliche Bedeutung einer Seite.

Nach dem Relaunch bleiben alte URLs enthalten

Bei Domainwechseln, Strukturänderungen und Migrationen sollte die Sitemap Bestandteil der Abnahmekontrolle sein. Entfernen Sie alte URLs, die dauerhaft weiterleiten oder nicht mehr existieren, und stellen Sie sicher, dass die neue Sitemap nur die aktuelle Zielstruktur enthält. Prüfen Sie außerdem, ob Verweise in der robots.txt und in Suchmaschinen-Tools aktualisiert wurden.

Praktische Checkliste für die regelmäßige Kontrolle

Eine wiederkehrende Prüfung muss nicht kompliziert sein. Die folgende Checkliste eignet sich als monatlicher oder anlassbezogener Ablauf:

  1. Öffnen Sie die Sitemap oder den Sitemap-Index direkt und kontrollieren Sie die Erreichbarkeit.
  2. Prüfen Sie die XML-Syntax und achten Sie auf Fehlermeldungen.
  3. Überprüfen Sie stichprobenartig wichtige URLs auf Statuscode, Canonical und Indexierbarkeit.
  4. Suchen Sie nach Weiterleitungen, Fehlerseiten, gesperrten URLs und noindex-Seiten.
  5. Vergleichen Sie die Sitemap mit den wichtigsten Seitentypen der Website.
  6. Kontrollieren Sie, ob neue Inhalte erscheinen und entfernte Inhalte verschwinden.
  7. Bewerten Sie die Aussagekraft der Änderungsdaten.
  8. Prüfen Sie Sitemap-Index, robots.txt und Einreichungen in den Suchmaschinen-Tools.
  9. Dokumentieren Sie größere Änderungen, etwa nach einem Relaunch oder einer CMS-Umstellung.

Für Websites mit vielen Veröffentlichungen, häufigen Produktänderungen oder mehreren Sprachversionen kann eine automatisierte Überwachung sinnvoll sein. Lassen Sie dabei nicht nur die Verfügbarkeit, sondern auch Stichproben der URL-Qualität und auffällige Mengenänderungen prüfen.

FAQ

Wie oft sollte man eine Sitemap.xml prüfen?

Für eine stabile kleine Website genügt meist eine regelmäßige Kontrolle in größeren Abständen sowie eine Prüfung nach wichtigen technischen Änderungen. Bei häufig aktualisierten oder großen Websites ist eine laufende beziehungsweise monatliche Überwachung sinnvoll. Nach einem Relaunch, einer Migration oder einer Änderung des CMS sollte die Sitemap sofort kontrolliert werden.

Garantiert eine Sitemap die Indexierung aller enthaltenen URLs?

Nein. Eine Sitemap ist ein Hinweis auf bevorzugte URLs, aber keine Indexierungsgarantie. Suchmaschinen bewerten zusätzlich Qualität, Einzigartigkeit, interne Verlinkung, technische Erreichbarkeit und weitere Signale. Wenn viele URLs aus der Sitemap nicht indexiert werden, sollten Sie die Auswahl und den Nutzen dieser Seiten prüfen.

Sollten Seiten mit „noindex“ in der Sitemap stehen?

In der Regel nicht. Die Sitemap sollte möglichst konsistent mit Ihrem Indexierungsziel sein. Wenn eine URL bewusst mit noindex versehen wurde, gehört sie normalerweise nicht in die Liste der URLs, die Sie als indexierbar empfehlen.

Kann eine Sitemap zu groß sein?

Ja. XML-Sitemaps unterliegen technischen Grenzen für Dateigröße und URL-Anzahl. Große Websites sollten deshalb einen Sitemap-Index und mehrere einzelne Dateien verwenden. Unabhängig von der Dateigröße ist eine überfüllte Sitemap mit irrelevanten URLs auch inhaltlich problematisch.

Ist eine HTML-Sitemap besser als eine XML-Sitemap?

Beide Formate haben unterschiedliche Aufgaben. Eine HTML-Sitemap kann Besuchern und Suchmaschinen bei der Navigation helfen und die interne Verlinkung verbessern. Eine XML-Sitemap ist dagegen speziell für maschinenlesbare URL-Hinweise gedacht. Je nach Website können beide Varianten sinnvoll sein.

Was bedeutet es, wenn eine Sitemap nicht alle indexierten URLs enthält?

Das ist nicht automatisch ein Fehler. Suchmaschinen können URLs über Links oder andere Signale entdecken. Die Sitemap sollte sich auf Ihre bevorzugten und relevanten URLs konzentrieren. Wenn wichtige Seiten fehlen, sollten Sie jedoch die Generierungsregeln und die technische Abdeckung überprüfen.

Wie erkennt man falsche lastmod-Daten?

Vergleichen Sie die angegebenen Änderungsdaten mit dem tatsächlichen Redaktionsverlauf oder dem Inhalt der Seiten. Wenn viele URLs dasselbe aktuelle Datum erhalten, obwohl sich ihre Inhalte nicht geändert haben, ist die Datenquelle wahrscheinlich zu pauschal. In diesem Fall sollte die Generierung auf echte Inhaltsänderungen abgestimmt werden.

Fazit: Sitemap.xml prüfen und optimieren

Eine gute Sitemap.xml ist übersichtlich, technisch gültig und auf die wirklich wichtigen URLs konzentriert. Prüfen Sie nicht nur, ob die Datei erreichbar ist, sondern auch, ob ihre Einträge mit Canonical-Tags, Statuscodes, Indexierungsregeln und der tatsächlichen Website-Struktur übereinstimmen. Entfernen Sie Weiterleitungen, Fehlerseiten und irrelevante technische Varianten. Nutzen Sie einen Sitemap-Index, wenn die Website umfangreich ist, und behandeln Sie Änderungsdaten mit der nötigen Sorgfalt.

Die beste Wirkung entsteht im Zusammenspiel mit einer klaren Informationsarchitektur, sinnvoller interner Verlinkung und hochwertigen Inhalten. Wer die Sitemap nach größeren Änderungen und in regelmäßigen Abständen kontrolliert, schafft ein verlässliches technisches Signal und erkennt Probleme meist, bevor sie die Auffindbarkeit wichtiger Seiten beeinträchtigen.

Canonical-Tag richtig einsetzen: Der umfassende SEO-Ratgeber

Ein Canonical-Tag hilft Suchmaschinen dabei, die bevorzugte URL für identische oder sehr ähnliche Inhalte zu erkennen. Das ist besonders wichtig, wenn eine Website mehrere URLs für dieselbe Seite erzeugt, etwa durch Filter, Tracking-Parameter, Druckansichten oder alternative Pfade. Richtig eingesetzt, kann das Canonical-Signal die Indexierung übersichtlicher machen und Signale auf eine zentrale URL bündeln. Falsch eingesetzt, kann es dagegen wichtige Seiten aus dem Index drängen.

Dieser Ratgeber erklärt, wie du den Canonical-Tag richtig einsetzen kannst, wann er sinnvoll ist, welche Fehler häufig auftreten und wie du die Implementierung systematisch prüfst.

Was ist ein Canonical-Tag?

Der Canonical-Tag ist ein HTML-Link-Element im <head> einer Webseite. Es weist auf die bevorzugte, sogenannte kanonische URL eines Inhalts hin. Ein typisches Beispiel sieht so aus:

<link rel="canonical" href="https://www.beispiel.de/ratgeber/canonical-tag/">

Die URL im Attribut href ist die Adresse, die Suchmaschinen bevorzugt berücksichtigen sollen. Andere URLs können weiterhin erreichbar sein, werden aber als alternative Varianten desselben oder eines sehr ähnlichen Inhalts signalisiert.

Wichtig ist die Einordnung: Ein Canonical-Tag ist kein harter Weiterleitungsbefehl. Besucherinnen und Besucher bleiben auf der aufgerufenen URL, sofern keine andere technische Maßnahme greift. Außerdem ist das Canonical-Signal für Suchmaschinen eine Empfehlung, keine Garantie. Ob es übernommen wird, hängt unter anderem von der technischen Konsistenz und der inhaltlichen Ähnlichkeit der beteiligten Seiten ab.

Warum ist der Canonical-Tag für SEO wichtig?

Illustration zum Canonical-Tag mit mehreren URL-Varianten und einer bevorzugten kanonischen URL 1

Websites erzeugen häufig mehrere URLs, obwohl dahinter derselbe Inhalt steht. Das kann durch URL-Parameter, Sortierungen, interne Suchfunktionen, verschiedene URL-Schreibweisen oder Content-Management-Systeme passieren. Ohne klare Signale müssen Suchmaschinen selbst einschätzen, welche Variante relevant ist.

Ein sauber gesetztes Canonical kann dabei helfen, drei praktische Ziele zu erreichen:

  • Duplikate einordnen: Sehr ähnliche URLs werden als Varianten eines bevorzugten Dokuments gekennzeichnet.
  • Signale bündeln: Verweise und andere Signale können stärker mit der bevorzugten URL verbunden werden, sofern die Suchmaschine das Canonical akzeptiert.
  • Indexierung steuern: Die gewünschte URL erhält eine klarere Priorität gegenüber technisch erzeugten Varianten.

Der Canonical-Tag löst jedoch nicht jedes Duplicate-Content-Problem. Bei vollständig unterschiedlichen Seiten ist er ungeeignet. Auch eine fehlerhafte interne Verlinkung, falsche Weiterleitungen oder unzugängliche Zielseiten werden durch ein Canonical nicht automatisch behoben.

Canonical-Tag richtig einsetzen: Die wichtigsten Regeln

Eine bevorzugte URL eindeutig festlegen

Bevor du ein Canonical setzt, solltest du entscheiden, welche URL dauerhaft die maßgebliche Version des Inhalts sein soll. Berücksichtige dabei die gewünschte Domain, das Protokoll, die Schreibweise des Pfades und die URL-Struktur.

Diese Varianten können technisch unterschiedliche Adressen sein:

  • http://www.beispiel.de/seite/
  • https://www.beispiel.de/seite/
  • https://beispiel.de/seite/
  • https://www.beispiel.de/seite

Welche Variante kanonisch sein soll, ist eine strategische Entscheidung. Entscheidend ist, dass sie auf der Website konsequent verwendet wird. HTTPS ist für die meisten modernen Websites die naheliegende Wahl. Ob die Domain mit oder ohne „www“ verwendet wird und ob ein abschließender Schrägstrich dazugehört, sollte zur bestehenden URL-Architektur passen.

Selbstreferenzierende Canonicals verwenden

Auch die bevorzugte Originalseite kann ein Canonical auf sich selbst enthalten. Dieses sogenannte selbstreferenzierende Canonical sieht beispielsweise so aus:

<link rel="canonical" href="https://www.beispiel.de/ratgeber/canonical-tag/">

Damit wird die bevorzugte URL auch auf ihrer eigenen Seite eindeutig benannt. Das kann besonders hilfreich sein, wenn URLs durch Parameter oder andere technische Varianten erreichbar sind. Die selbstreferenzierende Variante ist kein Ersatz für eine saubere URL-Struktur, aber ein klares zusätzliches Signal.

Absolute URLs nutzen

Verwende im Canonical-Tag möglichst vollständige absolute URLs mit Protokoll und Domain. Eine vollständige Angabe ist leichter zu prüfen und verringert das Risiko, dass relative Pfade in unterschiedlichen Umgebungen falsch interpretiert werden.

Bevorzugt:

<link rel="canonical" href="https://www.beispiel.de/produkte/kaffeemuehle/">

Weniger eindeutig:

<link rel="canonical" href="/produkte/kaffeemuehle/">

Die absolute Schreibweise sollte exakt der tatsächlich erreichbaren Ziel-URL entsprechen. Achte auf Groß- und Kleinschreibung, URL-Codierung, den abschließenden Schrägstrich und mögliche Weiterleitungsketten.

Das Canonical auf eine indexierbare Zielseite setzen

Die kanonische Zielseite sollte normalerweise erreichbar sein, einen erfolgreichen HTTP-Status liefern und nicht durch noindex von der Indexierung ausgeschlossen werden. Verweist ein Canonical auf eine blockierte, nicht erreichbare oder dauerhaft weitergeleitete URL, entsteht ein widersprüchliches Signal.

Prüfe deshalb vor dem Einsatz:

  • Die Ziel-URL ist öffentlich erreichbar.
  • Sie antwortet nicht mit einem Fehlerstatus.
  • Sie wird nicht unnötig über mehrere Stationen weitergeleitet.
  • Sie enthält den maßgeblichen Inhalt.
  • Sie ist nicht durch widersprüchliche Robots-Anweisungen ausgeschlossen.

Eine Zielseite muss nicht in jedem Szenario identisch mit der Ausgangsseite sein. Je größer der inhaltliche Unterschied jedoch ist, desto schwächer und riskanter wird das Signal. Das Canonical sollte nicht als pauschales Mittel verwendet werden, um beliebige Seiten auf eine zentrale Übersichtsseite zu verweisen.

Typische Einsatzgebiete für Canonical-Tags

URL-Parameter für Tracking

Marketing- oder Analyseparameter wie ?utm_source=newsletter verändern häufig nicht den eigentlichen Seiteninhalt. Die URL mit Parameter kann separat aufgerufen werden, soll aber meist nicht als eigene Inhaltsversion gelten. In diesem Fall kann die parameterfreie URL als Canonical dienen.

Beispiel:

Aufgerufene URL: https://www.beispiel.de/angebot/?utm_source=newsletter
Canonical:       https://www.beispiel.de/angebot/

Wichtig ist, dass der Parameter tatsächlich keinen relevanten Seiteninhalt verändert. Wenn ein Parameter eine echte Produktvariante, Sprache oder redaktionell wichtige Auswahl erzeugt, darf er nicht automatisch entfernt werden.

Sortier- und Filtervarianten in Shops

Onlineshops erzeugen oft URL-Varianten für Sortierungen, Farben, Größen oder Preisfilter. Nicht jede dieser URLs sollte dieselbe kanonische Zielseite erhalten. Entscheidend ist, ob die Variante eine eigenständige Suchintention bedient und dauerhaft als eigene Landingpage gepflegt wird.

Eine rein technische Sortierung wie „Preis aufsteigend“ ist häufig keine eigenständige Inhaltsseite. Eine sorgfältig erstellte Kategorie für ein klar definiertes Sortiment kann dagegen eine eigene kanonische URL verdienen. Die Entscheidung sollte mit der Informationsarchitektur, der internen Verlinkung und der redaktionellen Pflege zusammenpassen.

Druckansichten und alternative Darstellungen

Wenn eine Druckansicht denselben Inhalt in einem anderen Layout ausgibt, kann sie auf die normale Inhaltsseite verweisen. Dasselbe gilt für bestimmte mobile oder vereinfachte Darstellungen, sofern diese nicht als eigenständige Inhalte gedacht sind.

Bei responsiven Websites ist eine separate mobile URL häufig gar nicht erforderlich. Falls dennoch alternative Adressen existieren, müssen Canonicals, hreflang-Angaben und Weiterleitungen als zusammenhängendes System geprüft werden.

Produktvarianten

Bei Produkten ist die Situation differenziert. Varianten wie Farbe oder Speichergröße können denselben Grundinhalt teilen, aber unterschiedliche Suchabsichten erfüllen. Eine gemeinsame kanonische Produktseite kann sinnvoll sein, wenn die Varianten inhaltlich kaum voneinander abweichen. Eigene Seiten sind eher gerechtfertigt, wenn sich Name, technische Daten, Verfügbarkeit, Bilder und Beschreibung wesentlich unterscheiden.

Verwende den Canonical-Tag hier nicht automatisch für alle Varianten. Prüfe stattdessen, ob Nutzerinnen und Nutzer eine Variante als eigenständiges Angebot finden und verstehen sollten.

Ähnliche redaktionelle Inhalte

Bei redaktionellen Seiten ist ein Canonical nur dann passend, wenn eine Seite im Wesentlichen eine alternative URL für denselben Inhalt darstellt. Ähnliche Ratgeber mit unterschiedlichen Schwerpunkten sollten nicht einfach aufeinander kanonisiert werden. Besser sind eine klare thematische Abgrenzung, interne Verlinkung und gegebenenfalls eine Überarbeitung überschneidender Inhalte.

Canonical-Tag, Weiterleitung und noindex im Vergleich

Diese drei Maßnahmen werden häufig verwechselt, erfüllen aber unterschiedliche Aufgaben.

Maßnahme Wirkung Geeignet für
Canonical-Tag Empfiehlt eine bevorzugte URL, die aufgerufene Seite bleibt erreichbar. Ähnliche oder technisch erzeugte URL-Varianten.
301-Weiterleitung Leitet Besucherinnen und Besucher dauerhaft auf eine andere URL weiter. Zusammengelegte, umgezogene oder dauerhaft ersetzte Inhalte.
noindex Signalisiert, dass eine Seite nicht in den Suchindex aufgenommen werden soll. Seiten, die erreichbar bleiben, aber nicht als Suchergebnis erscheinen sollen.

Wenn eine alte URL nicht mehr benötigt wird, ist eine Weiterleitung meist klarer als ein Canonical. Wenn eine Seite für Nutzer weiterhin zugänglich sein muss, aber keine eigenständige Suchversion darstellen soll, kann ein Canonical oder noindex infrage kommen. Die passende Lösung hängt vom Zweck der URL ab.

Canonical-Tags in verschiedenen technischen Umgebungen

HTML im Head

Die häufigste Implementierung erfolgt im <head> des HTML-Dokuments. Pro Seite sollte die Implementierung eindeutig sein. Mehrere unterschiedliche Canonical-Tags auf derselben Seite schaffen kein klares Signal.

<head>
  <title>Canonical-Tag richtig einsetzen</title>
  <link rel="canonical" href="https://www.beispiel.de/ratgeber/canonical-tag/">
</head>

Content-Management-Systeme

Viele Content-Management-Systeme oder SEO-Erweiterungen erzeugen Canonicals automatisch. Das ist bequem, kann aber bei individuellen URL-Strukturen zu Fehlern führen. Prüfe deshalb nicht nur die Einstellungen im Backend, sondern auch den tatsächlich ausgelieferten Quelltext.

Besondere Aufmerksamkeit verdienen:

  • Archivseiten und paginierte Übersichten
  • Parameter-URLs aus Such- und Filterfunktionen
  • Mehrsprachige Inhalte
  • Staging- oder Testumgebungen
  • Seiten mit Weiterleitungen oder wechselnden Permalinks

Canonical über HTTP-Header

Für bestimmte nicht-HTML-Dokumente, etwa PDF-Dateien, kann ein Canonical-Signal über einen HTTP-Header übermittelt werden. Das ist eine technische Sonderlösung und sollte sauber mit der Serverkonfiguration abgestimmt werden. Bei normalen HTML-Seiten ist das Link-Element im Dokument meist leichter zu verwalten und zu kontrollieren.

Häufige Fehler beim Canonical-Tag

Canonical auf eine nicht passende Seite

Ein Canonical von einer Produktseite auf die Startseite oder von einem ausführlichen Ratgeber auf eine allgemeine Kategorie ist in der Regel zu weit gefasst. Die Zielseite sollte den gleichen oder nahezu gleichen Kerninhalt repräsentieren.

Mehrere Canonical-Tags

Wenn ein System im Template, ein Plugin und eine weitere Erweiterung jeweils ein Canonical ausgeben, können widersprüchliche Angaben entstehen. Suche im gerenderten HTML nach rel="canonical" und stelle sicher, dass pro Dokument nur eine eindeutige Angabe vorhanden ist.

Canonical auf eine 404- oder 5xx-Seite

Gelöschte oder technisch fehlerhafte Zielseiten sind als kanonische Ziele ungeeignet. Nach Migrationen und URL-Änderungen sollte deshalb geprüft werden, ob alle Canonical-Ziele weiterhin existieren.

Canonical und interne Links widersprechen sich

Wenn die meisten internen Links auf eine Varianten-URL zeigen, das Canonical aber auf eine andere Adresse verweist, entstehen unnötige Signalkonflikte. Verlinke intern möglichst direkt auf die bevorzugte URL. Das verbessert die Orientierung für Menschen und erleichtert die technische Verarbeitung.

Lokale URLs oder Testdomains ausliefern

Bei Umzügen, Staging-Systemen und Domainwechseln kann versehentlich eine Testdomain im Canonical stehen. Prüfe deshalb vor jeder Veröffentlichung das Protokoll, die Domain und den vollständigen Pfad. Ein Canonical auf eine nicht öffentliche Umgebung kann die Auffindbarkeit der Produktionsseite beeinträchtigen.

Eine praktische Checkliste zur Prüfung

Mit der folgenden Reihenfolge kannst du Canonicals systematisch kontrollieren:

  1. URL auswählen: Bestimme für jede relevante Seite die gewünschte kanonische Adresse.
  2. Quelltext prüfen: Suche im ausgelieferten HTML nach dem Canonical-Link.
  3. Eindeutigkeit kontrollieren: Stelle sicher, dass nur ein Canonical vorhanden ist.
  4. Ziel aufrufen: Prüfe, ob die URL erreichbar ist und den erwarteten Inhalt liefert.
  5. Weiterleitungen untersuchen: Vermeide Canonicals auf URLs, die erst über mehrere Schritte weiterleiten.
  6. Indexierungsanweisungen abgleichen: Vergleiche Canonical, Robots-Metaangabe, HTTP-Header und robots.txt.
  7. Interne Links prüfen: Verweise möglichst direkt auf die kanonische URL.
  8. Sitemap abgleichen: Führe in XML-Sitemaps vorzugsweise die URLs auf, die du als kanonisch etablieren möchtest.
  9. Nach Änderungen erneut prüfen: Kontrolliere Canonicals nach Relaunches, Plugin-Updates und URL-Migrationen.

Für die Analyse können der Browser-Quelltext, Serverprotokolle und die Funktionen der jeweils eingesetzten Webmaster- beziehungsweise Suchmaschinenplattformen genutzt werden. Ein einzelnes Tool ersetzt dabei nicht die fachliche Prüfung des Inhalts und der URL-Logik.

Canonical-Tags bei internationalen Websites

Mehrsprachige Websites benötigen eine besonders sorgfältige Abstimmung. Sprachversionen sind normalerweise keine Duplikate, wenn sie unterschiedliche Nutzergruppen und Inhalte bedienen. Daher sollte eine deutsche Seite nicht pauschal auf die englische Seite kanonisiert werden. Stattdessen benötigen die Sprachversionen ihre jeweils passende kanonische URL und eine konsistente hreflang-Struktur.

Auch regionale Versionen können sich bei Währung, Lieferbedingungen, Rechtstexten oder Verfügbarkeit unterscheiden. In solchen Fällen sollte die URL-Architektur diese Unterschiede abbilden, anstatt alle Länder auf eine einzige Version zu verweisen.

Wann ist kein Canonical die bessere Lösung?

Ein Canonical ist nicht automatisch nötig, nur weil zwei URLs ähnlich aussehen. Wenn jede URL einen eigenständigen, nützlichen Inhalt bietet, sollte sie nicht ohne Prüfung auf eine andere Seite verweisen. Ebenso ist eine Weiterleitung oft geeigneter, wenn der alte Inhalt dauerhaft ersetzt wurde.

Bei nahezu identischen Seiten kann außerdem eine inhaltliche Zusammenführung sinnvoller sein als ein technisches Signal. Entferne überflüssige Varianten, verbessere die URL-Struktur und reduziere automatisch erzeugte Parameter, wenn sie für die Nutzerführung nicht gebraucht werden. Gute technische SEO beginnt häufig mit einer verständlichen Informationsarchitektur.

FAQ

Ist ein Canonical-Tag eine Weiterleitung?

Nein. Ein Canonical-Tag lässt die aufgerufene URL grundsätzlich erreichbar und empfiehlt Suchmaschinen eine bevorzugte Version. Eine Weiterleitung führt Nutzer und Crawler dagegen direkt zu einer anderen URL.

Muss jede Seite ein selbstreferenzierendes Canonical haben?

Es ist häufig sinnvoll, die bevorzugte URL selbst als Canonical auszuzeichnen. Es handelt sich aber nicht um eine pauschale Reparatur für jede URL-Situation. Entscheidend sind eine konsistente URL-Struktur und eine technisch passende Implementierung.

Kann ich mit einem Canonical Duplicate Content vollständig verhindern?

Nein. Das Canonical liefert ein wichtiges Signal, ersetzt aber keine saubere Seitenstruktur. Bei stark unterschiedlichen Inhalten, fehlerhaften Zielseiten oder widersprüchlichen technischen Angaben kann das Signal anders bewertet oder ignoriert werden.

Soll die Canonical-URL in der XML-Sitemap stehen?

Idealerweise enthält die XML-Sitemap die URLs, die du als bevorzugte Versionen etablieren möchtest. Das ist ein zusätzliches Konsistenzsignal, ersetzt aber nicht die korrekte Implementierung im HTML und die Prüfung der Zielseiten.

Wie gehe ich mit URL-Parametern um?

Wenn ein Parameter nur Tracking oder eine technische Sortierung darstellt und den Inhalt nicht wesentlich verändert, kann die parameterfreie URL als Canonical dienen. Erzeugt der Parameter dagegen eine eigenständige, relevante Seite, sollte er nicht automatisch entfernt werden.

Kann eine Seite auf eine andere Domain kanonisiert werden?

Technisch sind domainübergreifende Canonicals möglich, sie sollten aber nur bei einer klaren inhaltlichen Beziehung und einem nachvollziehbaren Eigentums- oder Veröffentlichungsmodell eingesetzt werden. Ein versehentliches Cross-Domain-Canonical kann die eigene Seite aus dem Suchindex verdrängen.

Was mache ich bei widersprüchlichen Canonicals?

Ermittle zunächst, welche Anwendung das Signal ausgibt: Template, Plugin, Server oder Plattform. Entscheide anschließend eine einzige Ziel-URL, entferne doppelte Angaben und passe interne Links, Sitemaps sowie Weiterleitungen an. Danach sollte die Seite erneut technisch geprüft werden.

Fazit: Canonical-Tag richtig einsetzen

Wer den Canonical-Tag richtig einsetzen möchte, sollte ihn als Bestandteil einer konsistenten URL-Strategie betrachten. Wähle eine eindeutige bevorzugte URL, verweise nur bei inhaltlicher Nähe auf sie und halte Canonical, interne Links, Sitemaps und Weiterleitungen möglichst widerspruchsfrei. Prüfe außerdem regelmäßig, ob die Zielseite erreichbar und weiterhin die passende Version ist.

Der größte Nutzen entsteht nicht durch möglichst viele Canonicals, sondern durch klare Entscheidungen: Welche URLs sind eigenständig wertvoll, welche sind nur technische Varianten und welche sollten dauerhaft weiterleiten? Wenn diese Fragen sauber beantwortet sind, wird der Canonical-Tag zu einem verständlichen und kontrollierbaren SEO-Signal.

Fehlende Meta-Daten erkennen: Ein praxisnaher Ratgeber für bessere SEO

Fehlende Meta-Daten können dazu führen, dass wichtige Seiten in Suchergebnissen unklar, unvollständig oder weniger überzeugend erscheinen. Das Problem ist dabei nicht immer sofort sichtbar: Eine Seite kann technisch erreichbar sein und trotzdem keinen sinnvollen Seitentitel, keine passende Meta-Beschreibung oder wichtige strukturierte Angaben enthalten.

Dieser Ratgeber zeigt, wie Sie fehlende Meta-Daten systematisch erkennen, welche Angaben besonders wichtig sind und wie Sie Fehler nach Priorität beheben. Der Schwerpunkt liegt auf einer nachvollziehbaren Prüfung, nicht auf blindem Optimieren einzelner Zeichenlängen.

Was sind Meta-Daten und warum fehlen sie häufig?

Meta-Daten sind Informationen über eine Webseite, die teilweise im HTML-Dokument stehen, aber nicht unbedingt direkt im sichtbaren Seiteninhalt erscheinen. Sie helfen Suchmaschinen, Browsern, sozialen Netzwerken und anderen technischen Systemen dabei, eine Seite einzuordnen und darzustellen.

Zu den bekanntesten Meta-Daten gehören der Title-Tag und die Meta-Description. Je nach Website kommen außerdem Angaben wie Canonical-URL, Robots-Direktiven, Open-Graph-Daten, Sprachkennzeichnungen oder strukturierte Daten hinzu. Nicht jede Angabe ist für jede Seite gleich wichtig. Eine Produktdetailseite benötigt beispielsweise andere Informationen als ein redaktioneller Ratgeber oder eine Kontaktseite.

Fehlende Meta-Daten entstehen häufig durch Vorlagenfehler, unvollständige CMS-Einstellungen, nachträgliche Migrationen oder automatisch erzeugte Seiten. Auch Filterseiten, Archivseiten und Varianten von URLs können unbemerkt ohne passende Angaben veröffentlicht werden.

Die wichtigsten Meta-Daten im Überblick

Systematische Pru00fcfung von Meta-Daten in einer URL-u00dcbersicht
Eine strukturierte URL-Liste macht fehlende Angaben und wiederkehrende Muster sichtbar.

Die Übersicht zeigt, wie sich wichtige URLs und ihre Meta-Daten gemeinsam erfassen lassen. Besonders hilfreich sind getrennte Spalten für leere, doppelte und technisch widersprüchliche Werte.

Bevor Sie eine Prüfung starten, sollten Sie wissen, welche Elemente Sie suchen. So vermeiden Sie, jede technische Angabe gleich zu behandeln.

Title-Tag

Der Title-Tag beschreibt den thematischen Schwerpunkt einer Seite. Er wird meist als anklickbare Überschrift in den Suchergebnissen verwendet und erscheint außerdem im Browser-Tab. Ein guter Title ist eindeutig, verständlich und auf die Suchabsicht der jeweiligen Seite abgestimmt.

Fehlt der Title vollständig, muss die Suchmaschine eine andere Textstelle als Überschrift auswählen. Auch ein sehr allgemeiner, mehrfach verwendeter oder automatisch abgeschnittener Titel kann die Orientierung erschweren. Prüfen Sie deshalb nicht nur, ob ein Title vorhanden ist, sondern auch, ob er die konkrete Seite wirklich beschreibt.

Meta-Description

Die Meta-Description ist eine kurze Zusammenfassung des Seiteninhalts. Sie ist kein verlässlicher direkter Rankingfaktor, kann aber die Entscheidung für oder gegen einen Klick beeinflussen, wenn sie in der Suchdarstellung verwendet wird.

Eine fehlende Beschreibung ist nicht automatisch ein schwerer Fehler, weil Suchmaschinen je nach Suchanfrage auch einen passenden Textauszug aus der Seite bilden können. Trotzdem ist eine individuell formulierte Description besonders für wichtige Einstiegsseiten sinnvoll. Sie sollte den erwartbaren Nutzen erklären und keine Versprechen enthalten, die der Inhalt nicht einlösen kann.

Canonical-URL

Mit einer Canonical-Angabe kann eine Website signalisieren, welche URL als bevorzugte Version eines ähnlichen oder mehrfach erreichbaren Inhalts gelten soll. Das ist vor allem bei Parametern, Sortierungen, Druckansichten und technisch bedingten URL-Varianten relevant.

Eine fehlende Canonical-Angabe ist nicht auf jeder Seite problematisch. Entscheidend ist der Kontext: Bei einer eindeutigen, nur einmal erreichbaren Seite kann eine selbstreferenzierende Canonical-Angabe zwar nützlich sein, aber nicht jede Website benötigt dieselbe Umsetzung. Fehlerhafte Canonicals, die auf eine unpassende oder nicht erreichbare URL zeigen, sind meist kritischer als ein bloßes Fehlen.

Robots-Meta-Tag

Das Robots-Meta-Tag steuert, ob Suchmaschinen eine Seite indexieren oder den Links auf ihr folgen sollen. Eine Anweisung wie noindex kann beabsichtigt sein, etwa bei internen Suchergebnissen oder bestimmten Filterkombinationen. Auf einer wichtigen Zielseite wäre sie jedoch ein gravierendes Problem.

Prüfen Sie deshalb nicht nur, ob der Robots-Tag vorhanden ist. Lesen Sie den Inhalt und vergleichen Sie ihn mit der gewünschten Funktion der Seite. Eine fehlende Anweisung bedeutet in der Regel nicht automatisch, dass eine Seite ausgeschlossen wird. Unbeabsichtigte Ausschlussregeln sollten dennoch schnell erkannt werden.

Open-Graph- und weitere Vorschau-Daten

Open-Graph-Daten beeinflussen, wie eine Seite beim Teilen in bestimmten sozialen Netzwerken oder Messengern dargestellt wird. Häufige Felder sind ein Vorschautitel, eine Beschreibung und ein Bild. Fehlende Angaben führen nicht zwingend zu einem SEO-Problem, können aber eine unklare oder unattraktive Vorschau erzeugen.

Für Websites, deren Inhalte regelmäßig geteilt werden, lohnt sich eine Prüfung der wichtigsten Vorlagen. Achten Sie auch darauf, dass Titel, Bild und Beschreibung tatsächlich zur jeweiligen Seite gehören und nicht von einer globalen Standardvorlage übernommen werden.

Fehlende Meta-Daten erkennen: Die systematische Prüfung

Eine verlässliche Prüfung beginnt mit einer klaren Abgrenzung. Legen Sie fest, welche Seitentypen untersucht werden sollen: beispielsweise Startseite, Leistungsseiten, Blogartikel, Produktseiten, Kategorien und wichtige Landingpages. Danach erfassen Sie je URL den Status der relevanten Meta-Daten.

1. Wichtige URLs zusammenstellen

Starten Sie nicht ausschließlich mit den Seiten, die Ihnen spontan einfallen. Nutzen Sie Ihre XML-Sitemap, die interne Verlinkung, die Navigation und vorhandene Übersichten im CMS. Ergänzen Sie Seiten, die über externe Verweise, Kampagnen oder Suchfunktionen erreichbar sind.

Eine einfache Tabelle kann folgende Spalten enthalten:

  • URL und Seitentyp
  • Hauptthema oder primäre Suchabsicht
  • Title vorhanden, passend und eindeutig
  • Meta-Description vorhanden und relevant
  • Canonical vorhanden und korrekt
  • Robots-Anweisung und gewünschter Indexierungsstatus
  • Open-Graph-Angaben, sofern sie benötigt werden
  • festgestelltes Problem, Priorität und Bearbeitungsstatus

Diese Übersicht hilft, einzelne Fehler von systematischen Vorlagenproblemen zu unterscheiden. Wenn beispielsweise alle neuen Ratgeber denselben Title erhalten, liegt die Ursache wahrscheinlich nicht bei einem einzelnen Beitrag.

2. Den HTML-Quelltext einer Seite ansehen

Im Quelltext finden Sie den Title im <title>-Element innerhalb des Dokuments. Meta-Descriptions stehen meist in einem Element mit name="description". Canonical-Links werden typischerweise über rel="canonical" angegeben.

Bei der manuellen Prüfung sollten Sie nach folgenden Punkten suchen:

  • Existiert genau ein sinnvoller Title?
  • Ist die Description vorhanden und bezieht sie sich auf diese URL?
  • Zeigt die Canonical-URL auf die gewünschte Hauptversion?
  • Enthält der Robots-Tag unbeabsichtigte Ausschlussregeln?
  • Sind Vorschau-Titel, Beschreibung und Bild korrekt ausgesteuert?

Der Quelltext zeigt, was ausgeliefert wird. Die Eingabefelder im CMS allein sind kein ausreichender Beleg, weil Plugins, Themes, Caching oder serverseitige Prozesse die Ausgabe verändern können.

3. Einzelne Seiten und große Mengen kombinieren

Eine Einzelprüfung ist hilfreich, um die tatsächliche Darstellung einer Seite zu verstehen. Für größere Websites benötigen Sie zusätzlich einen automatisierten Crawl oder einen vergleichbaren Export. Solche Prüfungen können URLs mit fehlenden Titles, leeren Descriptions, doppelten Angaben oder ungewöhnlichen Längen gruppieren.

Automatisierte Listen sind jedoch keine fertige Prioritätenliste. Ein kurzer Title kann für eine kleine interne Seite akzeptabel sein, während ein formal vollständiger Title auf einer wichtigen Landingpage inhaltlich unpassend sein kann. Verwenden Sie technische Prüfungen daher als Filter und kontrollieren Sie kritische URLs anschließend manuell.

Woran Sie problematische Meta-Daten erkennen

Beim Erkennen fehlender Meta-Daten reicht es nicht, auf leere Felder zu achten. Auch vorhandene Angaben können ihre Funktion nur unzureichend erfüllen.

Leere und automatisch erzeugte Angaben

Ein Feld gilt als problematisch, wenn es leer ist, nur aus einem Standardwort besteht oder lediglich den Website-Namen wiederholt. Ebenso ungünstig sind Platzhalter, technische Variablen oder Texte, die sichtbar nie ersetzt wurden.

Bei automatisch erzeugten Descriptions sollte geprüft werden, ob der Anfang des Seiteninhalts tatsächlich eine verständliche Zusammenfassung ergibt. Ein Cookie-Hinweis, eine Navigation oder ein unvollständiger Satz ist kein guter Ersatz für eine gezielte Beschreibung.

Doppelte Angaben

Doppelte Titles und Descriptions erschweren die Unterscheidung ähnlicher Seiten. Das ist besonders relevant, wenn mehrere Seiten unterschiedliche Angebote, Orte, Zielgruppen oder Suchabsichten bedienen. Eine gewisse Ähnlichkeit bei eng verwandten Seiten ist normal, aber der unterscheidende Teil sollte erkennbar sein.

Beheben Sie doppelte Angaben nicht durch wahlloses Einfügen weiterer Begriffe. Fragen Sie stattdessen, ob die Seiten inhaltlich klar genug getrennt sind und welchen konkreten Nutzen jede URL bietet.

Inhaltlich unpassende Angaben

Ein Title kann vorhanden sein und trotzdem auf das falsche Thema verweisen. Das passiert etwa nach dem Kopieren einer Vorlage, bei umbenannten Leistungen oder bei dynamischen Produktseiten. Prüfen Sie immer den Zusammenhang zwischen Meta-Daten, sichtbarer Hauptüberschrift und tatsächlichem Seiteninhalt.

Auch die Sprache muss stimmen. Eine deutschsprachige Seite mit englischer Standardbeschreibung wirkt unfertig und kann falsche Erwartungen erzeugen. Bei mehrsprachigen Websites sollten Angaben pro Sprachversion gepflegt werden.

Technisch widersprüchliche Signale

Besonders aufmerksam sollten Sie bei widersprüchlichen Signalen sein. Beispiele sind eine indexierbare Seite mit einer Canonical-Angabe auf eine andere Inhaltsversion, eine in der Sitemap enthaltene URL mit noindex oder eine Vorschau, die auf ein nicht vorhandenes Bild verweist.

Solche Fälle lassen sich nicht allein durch ein fehlendes Feld bewerten. Prüfen Sie die beabsichtigte Rolle der URL und betrachten Sie Sitemap, interne Links, Canonical, Robots-Anweisungen und sichtbaren Inhalt gemeinsam.

Meta-Daten nach Priorität bewerten

Nicht jede Lücke benötigt sofort dieselbe Aufmerksamkeit. Eine praktische Priorisierung verhindert, dass sich ein Team in nebensächlichen Details verliert.

Hohe Priorität

  • Wichtige Seiten besitzen keinen eindeutigen Title.
  • Eine relevante Seite enthält unbeabsichtigt eine noindex-Anweisung.
  • Die Canonical-Angabe verweist auf eine falsche, nicht erreichbare oder thematisch unpassende URL.
  • Eine zentrale Vorlage erzeugt bei vielen Seiten dieselben fehlerhaften Angaben.
  • Meta-Daten versprechen Inhalte, die auf der Seite nicht vorhanden sind.

Mittlere Priorität

  • Descriptions fehlen auf wichtigen Einstiegsseiten.
  • Titles sind zu allgemein, doppelt oder nicht auf die Suchabsicht abgestimmt.
  • Open-Graph-Daten führen bei häufig geteilten Inhalten zu falschen Vorschauen.
  • Mehrsprachige Seiten verwenden die falsche Sprachversion in ihren Standardangaben.

Niedrigere Priorität

  • Eine selten besuchte Neben-URL hat keine individuelle Description.
  • Eine Description könnte stilistisch verbessert werden, ist aber sachlich korrekt.
  • Ein Vorschau-Bild ist nicht optimal zugeschnitten, obwohl die Seite korrekt beschrieben wird.

Die Priorität sollte sich an Geschäftsrelevanz, organischer Sichtbarkeit, interner Verlinkung und dem Risiko falscher Indexierung orientieren. Ein kleiner Fehler auf der Startseite kann wichtiger sein als viele ähnliche Lücken in wenig bedeutenden Archivseiten.

Meta-Daten im CMS korrekt pflegen

Die konkrete Umsetzung hängt vom verwendeten CMS und den installierten Erweiterungen ab. Das grundlegende Vorgehen bleibt jedoch ähnlich: Definieren Sie für jeden Seitentyp sinnvolle Standardwerte und ermöglichen Sie zugleich individuelle Anpassungen für wichtige Seiten.

Ein Standard-Title kann beispielsweise aus dem Seitentitel und dem Website-Namen zusammengesetzt werden. Bei Produkt- oder Leistungsseiten sollte die Vorlage jedoch nur Informationen verwenden, die zuverlässig vorhanden sind. Leere Variablen können zu unverständlichen Titeln führen.

Für Descriptions sind flexible Vorlagen hilfreich, wenn der Seiteninhalt zuverlässig strukturiert ist. Bei wichtigen Seiten ist eine manuelle Beschreibung meist vorzuziehen. Legen Sie redaktionelle Regeln fest: Die Beschreibung sollte den Inhalt ehrlich zusammenfassen, einen konkreten Nutzen nennen und keine übertriebenen Versprechen machen.

Nach Änderungen sollten Sie nicht nur die Eingabemaske speichern, sondern die veröffentlichte Seite im Quelltext prüfen. Leeren Sie bei Bedarf den relevanten Cache und kontrollieren Sie verschiedene Seitentypen. Eine scheinbar kleine Template-Änderung kann viele URLs gleichzeitig beeinflussen.

Häufige Fehler bei der Prüfung

Ein verbreiteter Fehler ist die ausschließliche Orientierung an pauschalen Längenangaben. Die Darstellung in Suchergebnissen hängt unter anderem von Zeichen, Wörtern, Geräten und der konkreten Suchanfrage ab. Verständlichkeit und Relevanz sind wichtiger als das Ausfüllen eines starren Zählers.

Ebenso problematisch ist es, jede URL mit identischen Meta-Daten zu versehen. Das spart kurzfristig Arbeit, macht aber Unterschiede zwischen den Seiten unsichtbar. Besser ist ein kontrolliertes System aus sinnvollen Vorlagen und manuellen Ausnahmen.

Vermeiden Sie außerdem Keyword-Stuffing. Das Hauptkeyword darf natürlich vorkommen, muss aber nicht in jedem Feld wiederholt werden. Ein Title, der wie eine Aneinanderreihung von Suchbegriffen wirkt, hilft Leserinnen und Lesern nicht weiter.

Auch das ungeprüfte Kopieren aus Wettbewerberseiten ist keine gute Methode. Ihre Meta-Daten sollten die eigene Seite korrekt beschreiben und zu Ihrem Angebot passen. Prüfen Sie lieber, welche Frage die Seite beantwortet und welcher Grund für einen Besuch überzeugend, aber sachlich vertretbar ist.

Ein praktischer Prüfplan für laufende Qualität

Eine einmalige Bereinigung ist sinnvoll, reicht bei größeren Websites aber nicht immer aus. Neue Inhalte, Relaunches, Plugin-Updates und Änderungen an Vorlagen können Meta-Daten erneut beeinflussen.

  1. Bestand erfassen: Legen Sie regelmäßig eine aktuelle URL-Liste der wichtigen Seitentypen an.
  2. Technisch prüfen: Suchen Sie nach fehlenden, doppelten und widersprüchlichen Angaben.
  3. Manuell bewerten: Lesen Sie die wichtigsten Titles und Descriptions zusammen mit dem Seiteninhalt.
  4. Ursache beheben: Korrigieren Sie zuerst Vorlagen- oder Prozessfehler, bevor Sie viele Einzelfälle bearbeiten.
  5. Änderungen kontrollieren: Prüfen Sie die gerenderte Ausgabe nach der Veröffentlichung erneut.
  6. Dokumentieren: Halten Sie fest, welche Regeln für Seitentypen und Ausnahmen gelten.

Eine gute Dokumentation sollte auch festhalten, welche Seiten absichtlich nicht indexiert werden und warum. Dadurch lassen sich beabsichtigte Einstellungen bei späteren Audits von echten Fehlern unterscheiden.

FAQ

Was bedeutet „fehlende Meta-Daten erkennen“ konkret?

Gemeint ist die systematische Suche nach nicht vorhandenen, leeren, doppelten oder unpassenden Angaben im HTML einer Website. Dazu gehören je nach Ziel der Prüfung vor allem Title, Meta-Description, Canonical, Robots-Direktiven und Vorschau-Daten.

Ist eine fehlende Meta-Description ein schwerer SEO-Fehler?

Nicht automatisch. Suchmaschinen können selbst einen Textauszug auswählen. Für wichtige Seiten ist eine gute Description dennoch sinnvoll, weil sie den Inhalt verständlich zusammenfasst und die Erwartung vor dem Klick beeinflussen kann.

Wie erkenne ich, ob ein Title wirklich fehlt?

Prüfen Sie den ausgelieferten HTML-Quelltext und suchen Sie nach einem <title>-Element. Zusätzlich sollten Sie kontrollieren, ob der Title leer, doppelt, technisch fehlerhaft oder inhaltlich unpassend ist. Ein CMS-Feld allein beweist nicht, dass der Wert korrekt im Quelltext ankommt.

Welche Rolle spielt die Canonical-URL?

Sie kann bei ähnlichen oder mehrfach erreichbaren URL-Versionen die bevorzugte Adresse kennzeichnen. Wichtig ist vor allem, dass sie auf eine passende, erreichbare und indexierbare Zielseite verweist. Nicht jede fehlende Canonical-Angabe ist gleich kritisch.

Soll jede Seite eine individuelle Meta-Description haben?

Für wichtige Seiten ist eine individuelle Description empfehlenswert. Bei sehr vielen Neben- oder Archivseiten kann eine zuverlässige Vorlage ausreichen. Entscheidend ist, dass die erzeugten Texte nicht leer, irreführend oder massenhaft identisch sind.

Kann ein SEO-Plugin alle fehlenden Meta-Daten automatisch beheben?

Ein Plugin kann Felder bereitstellen, Vorlagen erzeugen und manche Lücken sichtbar machen. Es kann jedoch nicht zuverlässig beurteilen, welche Aussage für jede Seite sachlich richtig ist. Die automatische Technik sollte deshalb durch redaktionelle Kontrolle und Tests der veröffentlichten Ausgabe ergänzt werden.

Wie oft sollte eine Website auf fehlende Meta-Daten geprüft werden?

Das hängt von Größe, Änderungsfrequenz und technischer Komplexität ab. Nach Relaunches, Template-Änderungen oder Plugin-Wechseln ist eine Prüfung besonders wichtig. Für aktive Websites empfiehlt sich zusätzlich eine wiederkehrende Kontrolle der wichtigsten Seitentypen.

Fazit

Fehlende Meta-Daten erkennen Sie am zuverlässigsten durch eine Kombination aus URL-Bestand, HTML-Prüfung, automatisierter Auswertung und manueller Inhaltskontrolle. Beginnen Sie mit wichtigen Seiten und systematischen Vorlagenfehlern. Prüfen Sie anschließend, ob Title, Description, Canonical und Robots-Einstellungen zur tatsächlichen Aufgabe der jeweiligen URL passen.

Das Ziel ist nicht, jedes Feld um jeden Preis zu füllen. Entscheidend sind klare Signale, ehrliche Vorschauen und eine technische Struktur, die Suchmaschinen und Menschen nicht in die Irre führt. Wenn Sie die Prüfung dokumentieren und nach größeren Änderungen wiederholen, wird aus einer einmaligen Reparatur ein dauerhaft verlässlicher Qualitätsprozess.

Meta-Daten einer Website prüfen: Der umfassende Praxisleitfaden

Meta-Daten gehören zu den unsichtbaren, aber wichtigen Grundlagen einer Website. Sie helfen Suchmaschinen dabei, einzelne Seiten einzuordnen, und beeinflussen zugleich, wie Inhalte in den Suchergebnissen dargestellt werden. Wer die Meta-Daten einer Website prüfen möchte, sollte deshalb nicht nur auf den Seitentitel achten. Auch Meta-Description, robots-Anweisungen, Canonical-URLs, Sprachangaben und technische Auszeichnungen können für die Auffindbarkeit und die Nutzerführung relevant sein.

Dieser Ratgeber zeigt, welche Meta-Daten Sie kontrollieren sollten, wo Sie sie finden und wie Sie typische Fehler sinnvoll priorisieren. Dabei geht es nicht darum, möglichst viele Felder auszufüllen, sondern um klare, konsistente und zur jeweiligen Seite passende Informationen.

Was sind Meta-Daten und warum sollte man sie prüfen?

Meta-Daten sind Informationen über eine Webseite, die meist im <head>-Bereich des HTML-Dokuments stehen. Viele davon werden nicht direkt im sichtbaren Seiteninhalt angezeigt. Sie können jedoch Suchmaschinen, Browsern, sozialen Netzwerken und anderen technischen Systemen Hinweise zum Inhalt geben.

Besonders bekannt sind der Title-Tag und die Meta-Description. Der Title-Tag wird häufig als Überschrift eines Suchtreffers verwendet. Die Meta-Description kann als Beschreibung erscheinen, wird aber nicht immer unverändert von der Suchmaschine übernommen. Weitere Angaben steuern beispielsweise, ob eine Seite indexiert werden darf, welche URL als bevorzugte Version gilt oder welches Vorschaubild beim Teilen in sozialen Netzwerken verwendet wird.

Eine Prüfung ist aus mehreren Gründen sinnvoll:

  • Wichtige Seiten erhalten einen eindeutigen und verständlichen Seitentitel.
  • Suchmaschinen finden keine versehentlich blockierten oder doppelt ausgezeichneten Inhalte.
  • Die Darstellung in Suchergebnissen und beim Teilen wirkt konsistent.
  • Technische Signale widersprechen sich nicht.
  • Die wichtigsten Seiten unterstützen die Erwartungen der Besucher bereits vor dem Klick.

Meta-Daten allein garantieren keine guten Rankings. Sie sind aber Teil eines größeren Qualitätsbildes, zu dem hilfreicher Inhalt, eine verständliche Seitenstruktur, gute Ladezeiten, interne Verlinkung und eine verlässliche Nutzererfahrung gehören.

Welche Meta-Daten sind besonders wichtig?

u00dcbersicht der wichtigsten Meta-Daten im HTML-Head einer Website
Die wichtigsten Meta-Daten erfüllen unterschiedliche technische und redaktionelle Aufgaben.

Die Darstellung macht sichtbar, dass Meta-Daten nicht nur aus Title und Description bestehen. Leserinnen und Leser können erkennen, welche Angaben die Suchdarstellung, Indexierung und Weitergabe an soziale Netzwerke beeinflussen.

Nicht jedes Meta-Element hat dieselbe Bedeutung. Bei einer Prüfung sollten Sie zunächst die Angaben kontrollieren, die für Suchdarstellung, Indexierung und technische Eindeutigkeit besonders relevant sind.

Title-Tag

Der Title-Tag beschreibt das zentrale Thema einer einzelnen Seite. Er sollte eindeutig, verständlich und auf den tatsächlichen Inhalt abgestimmt sein. Ein guter Titel nennt das Hauptthema möglichst früh und ergänzt bei Bedarf den Unternehmens- oder Markennamen.

Vermeiden Sie allgemeine Titel wie „Startseite“, „Willkommen“ oder „Produktseite 1“. Auch lange Aufzählungen von Suchbegriffen wirken unnatürlich und helfen Besuchern wenig. Jede indexierbare Seite sollte einen eigenen Titel besitzen. Besonders problematisch sind fehlende, identische oder automatisch erzeugte Titel, die auf vielen Seiten gleich erscheinen.

Prüfen Sie außerdem, ob der Title-Tag das Versprechen des sichtbaren Inhalts einhält. Ein Titel darf Interesse wecken, sollte aber nicht mehr versprechen, als die Seite tatsächlich liefert.

Meta-Description

Die Meta-Description fasst den erwartbaren Nutzen einer Seite knapp zusammen. Sie ist kein sicherer Rankingfaktor, kann aber die Entscheidung für oder gegen einen Klick beeinflussen, wenn sie in der Suchdarstellung verwendet wird.

Eine gute Beschreibung beantwortet möglichst schnell drei Fragen: Worum geht es? Für wen ist die Seite relevant? Was kann die Person dort erfahren oder erledigen? Schreiben Sie für Menschen und nicht als Liste einzelner Suchbegriffe. Jede wichtige Seite sollte eine individuelle Beschreibung haben. Für unwichtige technische Seiten ist ein hoher redaktioneller Aufwand dagegen meist nicht nötig.

Die Darstellung kann je nach Gerät und Suchanfrage unterschiedlich lang ausfallen. Deshalb ist es sinnvoll, die Kernaussage an den Anfang zu setzen und nicht von einer exakt sichtbaren Zeichenlänge auszugehen.

Robots-Meta-Tag

Mit Robots-Anweisungen lässt sich unter anderem festlegen, ob Suchmaschinen eine Seite indexieren oder ihren Links folgen sollen. Ein versehentlich gesetztes noindex kann dazu führen, dass eine wichtige Seite nicht in den Suchindex gelangt.

Prüfen Sie daher vor allem:

  • Besitzen öffentlich wichtige Seiten ungewollt noindex-Anweisungen?
  • Werden interne Links durch widersprüchliche Vorgaben problematisch behandelt?
  • Ist die Anweisung im HTML und gegebenenfalls im HTTP-Header konsistent?
  • Werden Test-, Filter- oder interne Suchseiten bewusst von der Indexierung ausgeschlossen?

Eine Sperre in der robots.txt und ein noindex-Hinweis sind nicht dasselbe. Die robots.txt steuert vor allem den Zugriff von Crawlern auf bestimmte Pfade. Ein noindex kann ein Crawler-Signal zur Indexierung sein, setzt aber voraus, dass die betreffende URL grundsätzlich abgerufen werden kann. Die gewünschte technische Lösung hängt vom konkreten Zweck ab.

Canonical-URL

Das Canonical-Link-Element weist auf die bevorzugte URL für eine Seite oder eine Gruppe sehr ähnlicher URLs hin. Es kann beispielsweise bei URL-Parametern, Druckversionen oder technisch bedingten Varianten hilfreich sein.

Die Angabe muss sorgfältig geprüft werden. Eine falsche Canonical-URL kann Suchmaschinen signalisieren, dass eine wichtige Seite einer anderen URL untergeordnet werden soll. Kontrollieren Sie deshalb, ob die Zieladresse erreichbar ist, zur inhaltlichen Seite passt und nicht auf eine völlig andere Unterseite zeigt. Bei eigenständigen Seiten ist eine selbstreferenzierende Canonical-Angabe häufig sinnvoll, sofern sie korrekt umgesetzt ist.

Open-Graph- und Social-Media-Daten

Open-Graph-Elemente bestimmen unter anderem Titel, Beschreibung und Bild, wenn eine URL in vielen sozialen Netzwerken geteilt wird. Häufig verwendete Angaben sind og:title, og:description, og:url, og:image und og:type.

Diese Daten verbessern nicht automatisch die Suchposition. Sie beeinflussen jedoch den ersten Eindruck beim Teilen. Prüfen Sie, ob das Bild zum Inhalt passt, die angegebene URL korrekt ist und der Text nicht abgeschnitten oder irreführend wirkt. Für wichtige Inhalte können zusätzlich plattformspezifische Angaben sinnvoll sein.

Strukturierte Daten

Strukturierte Daten beschreiben Inhalte in einem maschinenlesbaren Format. Je nach Seitentyp können beispielsweise Informationen zu Artikeln, Produkten, Veranstaltungen, Organisationen oder lokalen Unternehmen ausgezeichnet werden.

Entscheidend ist die inhaltliche Richtigkeit. Strukturierte Daten dürfen keine Angaben enthalten, die Besucher auf der Seite nicht nachvollziehen können. Nutzen Sie nur Auszeichnungstypen, die zum tatsächlichen Inhalt passen. Fehlerhafte oder widersprüchliche strukturierte Daten sollten korrigiert oder entfernt werden, statt möglichst viele Felder zu ergänzen.

Meta-Daten einer Website prüfen: Schritt für Schritt

Eine systematische Prüfung verhindert, dass einzelne Fehler isoliert betrachtet werden. Beginnen Sie mit den wichtigsten Seiten und arbeiten Sie sich anschließend durch Vorlagen, Seitentypen und technische Sonderfälle.

1. Prüfungsumfang festlegen

Definieren Sie zuerst, welche URLs untersucht werden sollen. Dazu gehören meist Startseite, zentrale Leistungs- oder Kategorieseiten, wichtige Ratgeberartikel, Produktseiten, Kontaktseiten und gegebenenfalls Landingpages.

Erstellen Sie eine einfache Tabelle mit URL, Seitentyp, Title-Tag, Meta-Description, Indexierungsstatus, Canonical-URL und festgestellten Problemen. Ergänzende Spalten für Priorität, Verantwortlichkeit und Bearbeitungsstatus erleichtern die Umsetzung.

Bei größeren Websites ist eine Stichprobe allein oft nicht ausreichend. Prüfen Sie zusätzlich, welche Vorlage für einen Seitentyp verwendet wird. Ein Fehler in einer Vorlage kann viele URLs gleichzeitig betreffen.

2. Quelltext und gerenderte Seite ansehen

Die Meta-Daten finden Sie im HTML-Quelltext im <head>-Bereich. Im Browser lässt sich der Quelltext meist über das Kontextmenü oder eine entsprechende Tastenkombination öffnen. Die Entwicklertools zeigen zusätzlich das nach JavaScript gerenderte Dokument.

Diese Unterscheidung ist wichtig: Manche Systeme setzen Meta-Daten erst beim Rendern ein. Dann kann der ursprüngliche Quelltext unvollständig wirken, während die gerenderte Seite andere Angaben enthält. Prüfen Sie bei dynamischen Websites beide Ebenen, insbesondere wenn Inhalte über ein JavaScript-Framework ausgeliefert werden.

Achten Sie auf die tatsächlichen HTML-Elemente und nicht nur auf die Darstellung in einem Redaktionssystem. Ein Feld kann im CMS ausgefüllt sein, aber durch eine Vorlage, ein Plugin oder eine spätere Überschreibung falsch im HTML landen.

3. Titel und Beschreibungen bewerten

Lesen Sie Title-Tags und Meta-Descriptions wie ein Besucher, der mehrere Suchtreffer vergleicht. Ist das Thema sofort erkennbar? Passt der Text zur Suchabsicht? Wird ein konkreter Nutzen genannt, ohne übertriebene Versprechen?

Markieren Sie fehlende, doppelte, sehr allgemeine oder offensichtlich automatisch generierte Angaben. Prüfen Sie auch Sonderzeichen, Trennzeichen, überflüssige Wiederholungen und ungewollte Standardtexte des Themes. Ein Titel muss nicht überall gleich aufgebaut sein: Eine Produktseite benötigt andere Schwerpunkte als ein ausführlicher Ratgeber.

4. Indexierungs- und Crawling-Signale kontrollieren

Vergleichen Sie Robots-Meta-Tag, Canonical-URL, robots.txt und gegebenenfalls XML-Sitemap. Diese Elemente sollten gemeinsam eine nachvollziehbare Strategie ergeben. Eine URL, die in der Sitemap als wichtig markiert wird, sollte nicht gleichzeitig per noindex ausgeschlossen sein, sofern dies nicht bewusst beabsichtigt ist.

Prüfen Sie außerdem Weiterleitungen, Statuscodes und die Erreichbarkeit der Canonical-Ziele. Eine Meta-Daten-Prüfung ist unvollständig, wenn eine vermeintlich korrekte URL anschließend auf einen Fehler, eine Weiterleitungskette oder eine nicht passende Seite führt.

5. Vorschau für soziale Netzwerke prüfen

Teilen Sie wichtige URLs zunächst nicht blind, sondern prüfen Sie die vorgesehene Vorschau mit einem geeigneten Vorschauwerkzeug oder anhand des Quelltexts. Kontrollieren Sie Titel, Beschreibung, Bild, URL und Inhaltstyp.

Wenn nach einer Änderung weiterhin eine alte Vorschau erscheint, kann ein zwischengespeicherter Abruf die Ursache sein. Das bedeutet nicht automatisch, dass die Meta-Daten falsch sind. Dokumentieren Sie Änderungen und prüfen Sie die Vorschau nach einer angemessenen Aktualisierungszeit erneut.

6. Strukturierte Daten validieren

Verwenden Sie für die Prüfung strukturierter Daten ein geeignetes Validierungswerkzeug. Entscheidend sind sowohl Syntaxfehler als auch inhaltliche Warnungen. Fragen Sie bei jedem Feld, ob der Wert auf der Seite sichtbar, aktuell und für den Seitentyp angemessen ist.

Beachten Sie, dass ein technisch gültiges Markup keine Garantie für eine besondere Darstellung in Suchergebnissen ist. Suchmaschinen entscheiden selbst, ob sie eine erweiterte Darstellung anzeigen.

Typische Fehler bei Meta-Daten

Viele Probleme wiederholen sich unabhängig vom verwendeten CMS. Eine klare Fehlerklassifizierung hilft, Aufwand und Nutzen richtig einzuschätzen.

Doppelte Titles und Beschreibungen

Doppelte Angaben sind nicht immer automatisch kritisch. Bei vielen Seiten erschweren sie jedoch die Unterscheidung zwischen ähnlichen Inhalten. Überarbeiten Sie zuerst die wichtigsten URLs und Seitentypen. Kategorien, Produkte oder Artikel sollten den jeweiligen konkreten Inhalt erkennbar machen.

Fehlende Meta-Descriptions

Eine fehlende Beschreibung kann dazu führen, dass Suchmaschinen einen beliebigen Textausschnitt der Seite verwenden. Dieser Ausschnitt kann durchaus passend sein, muss es aber nicht. Für wichtige Seiten lohnt sich deshalb eine bewusst formulierte Beschreibung. Bei einer großen Website kann eine gute Vorlage für weniger wichtige Seitentypen eine pragmatische Zwischenlösung sein.

Keyword-Stuffing und irreführende Versprechen

Die wiederholte Aneinanderreihung eines Keywords macht Titel und Beschreibung schwer lesbar. Verwenden Sie das Hauptthema dort, wo es natürlich passt, und ergänzen Sie den konkreten Nutzen. Ein klarer, präziser Text ist meist hilfreicher als eine scheinbar optimierte Wortfolge.

Falsche Canonical- oder Hreflang-Angaben

Bei mehrsprachigen Websites kommen Sprach- und Regionalvarianten hinzu. Hreflang-Angaben müssen auf tatsächlich vorhandene, passende Sprachversionen verweisen. Falsche Sprachcodes, nicht erreichbare URLs oder fehlende Gegenseitigkeit können die Signale unklar machen. Prüfen Sie diesen Bereich gemeinsam mit den URL- und Übersetzungsregeln der Website.

Unpassende Social-Media-Bilder

Ein Bild kann technisch vorhanden sein und trotzdem schlecht funktionieren, etwa durch ein ungünstiges Seitenverhältnis, unleserlichen Text oder einen unklaren Bildausschnitt. Wählen Sie Motive, die den Inhalt unterstützen und auch in einer kleinen Vorschau verständlich bleiben.

Welche Werkzeuge helfen beim Prüfen?

Für eine belastbare Prüfung ist nicht ein einzelnes Tool entscheidend, sondern die Kombination aus automatisierter Übersicht und manueller Bewertung. Crawler können große Mengen an URLs auf fehlende oder doppelte Titles, Beschreibungen, Canonical-Elemente und Robots-Anweisungen untersuchen. Sie zeigen häufig auch Statuscodes, Weiterleitungen und blockierte Ressourcen.

Browser-Entwicklertools eignen sich für die Kontrolle einzelner Seiten. Sie helfen dabei, den tatsächlichen HTML-Code, gerenderte Inhalte und mögliche Überschreibungen durch JavaScript zu sehen. Systeme zur Suchleistungsanalyse können zusätzliche Hinweise liefern, beispielsweise zu indexierten URLs, möglichen Ausschlüssen oder Suchdarstellungen.

Für strukturierte Daten und Social-Media-Vorschauen sind spezialisierte Validatoren nützlich. Behandeln Sie deren Meldungen jedoch als Prüfhinweise. Entscheidend bleibt, ob die Auszeichnung fachlich stimmt und mit dem sichtbaren Seiteninhalt übereinstimmt.

Dokumentieren Sie bei jedem Werkzeug, welchen Zustand es tatsächlich prüft: eine gespeicherte URL, einen abgerufenen Quelltext, eine gerenderte Seite oder einen zwischengespeicherten Stand. Unterschiedliche Ergebnisse sind nicht zwangsläufig ein Widerspruch, sondern können aus verschiedenen Abrufzeitpunkten oder Verarbeitungsschritten entstehen.

Fehler sinnvoll priorisieren und beheben

Nicht jeder Befund verdient sofort dieselbe Aufmerksamkeit. Eine sinnvolle Priorisierung orientiert sich an Sichtbarkeit, geschäftlicher Bedeutung und technischem Risiko.

  1. Hohe Priorität: wichtige Seiten mit noindex, falscher Canonical-URL, fehlerhaftem Statuscode oder fehlendem relevanten Inhalt.
  2. Mittlere Priorität: doppelte Titles, unpassende Beschreibungen, fehlerhafte Social-Media-Daten oder problematische Vorlagen.
  3. Niedrigere Priorität: kleinere redaktionelle Verbesserungen auf wenig besuchten oder nicht strategischen Seiten.

Beheben Sie zunächst Fehler auf Vorlagenebene. Wenn beispielsweise alle Produktseiten denselben Title erhalten, ist eine Änderung im Template effizienter als die manuelle Bearbeitung jeder einzelnen URL. Testen Sie jede Anpassung zuerst an repräsentativen Seiten und prüfen Sie danach, ob sie auf andere Seitentypen unbeabsichtigte Auswirkungen hat.

Führen Sie nach der Korrektur eine erneute Kontrolle durch. Prüfen Sie nicht nur das CMS-Feld, sondern das ausgelieferte HTML, die Canonical-Ziele, die Sitemap und bei Bedarf die Vorschau in sozialen Netzwerken. Halten Sie fest, wann eine Änderung umgesetzt wurde und ob eine weitere Beobachtung nötig ist.

Meta-Daten langfristig pflegen

Meta-Daten sollten kein einmaliges Projekt bleiben. Neue Seiten, Relaunches, Plugin-Updates und Änderungen an URL-Strukturen können bestehende Angaben verändern. Legen Sie deshalb klare Zuständigkeiten und einen einfachen Prüfprozess fest.

Eine regelmäßige Kontrolle kann beispielsweise folgende Punkte umfassen:

  • neue oder geänderte Seiten auf eindeutige Titles und passende Beschreibungen prüfen,
  • wichtige Vorlagen nach technischen Änderungen erneut testen,
  • Indexierungs- und Canonical-Probleme aus Suchleistungsdaten nachvollziehen,
  • strukturierte Daten nach Änderungen an Inhalten oder Seitentypen validieren,
  • Social-Media-Vorschauen bei zentralen Landingpages kontrollieren.

Definieren Sie außerdem redaktionelle Regeln: Wie wird der Seitentitel aufgebaut? Wann wird der Markenname ergänzt? Welche Seiten erhalten eine individuelle Beschreibung? Welche Inhalte sollen bewusst nicht indexiert werden? Solche Regeln schaffen Konsistenz, ohne jede Entscheidung vollständig zu automatisieren.

FAQ

Wie oft sollte man die Meta-Daten einer Website prüfen?

Die Häufigkeit hängt von Größe und Änderungsintensität der Website ab. Nach einem Relaunch, einer neuen SEO-Vorlage oder einer Änderung der URL-Struktur ist eine umfassende Prüfung sinnvoll. Im laufenden Betrieb sollten wichtige Seiten und wiederkehrende Seitentypen regelmäßig kontrolliert werden. Entscheidend ist weniger ein starrer Kalender als ein verlässlicher Prozess nach relevanten Änderungen.

Welche Meta-Daten sind für SEO am wichtigsten?

Besonders wichtig sind ein passender Title-Tag, eine korrekte Indexierungssteuerung und eine sinnvolle Canonical-URL. Die Meta-Description unterstützt vor allem die Verständlichkeit und mögliche Klickentscheidung in der Suchdarstellung. Strukturierte Daten und Social-Media-Angaben ergänzen die technische Kommunikation, ersetzen aber keinen hilfreichen Seiteninhalt.

Ist die Meta-Description ein direkter Rankingfaktor?

Die Meta-Description wird in der Regel nicht als direkter Rankingfaktor behandelt. Sie kann dennoch wichtig sein, weil sie den Suchtreffer verständlicher macht und die Erwartung vor dem Klick beeinflusst. Außerdem kann die Suchmaschine statt der hinterlegten Beschreibung einen passenden Textausschnitt aus der Seite auswählen.

Was tun, wenn eine wichtige Seite nicht indexiert wird?

Prüfen Sie zunächst, ob ein noindex-Signal, eine robots.txt-Sperre, ein falscher Canonical-Verweis oder ein problematischer Statuscode vorliegt. Kontrollieren Sie außerdem, ob die Seite erreichbar ist, ausreichend eingebunden wurde und einen eigenständigen, hilfreichen Inhalt besitzt. Bei komplexen Fällen sollten technische und redaktionelle Ursachen gemeinsam betrachtet werden.

Sind doppelte Title-Tags immer ein schwerer Fehler?

Nein. Ähnliche Seiten können in bestimmten Fällen ähnliche Bestandteile besitzen. Wenn viele unterschiedliche Seiten jedoch exakt denselben Title verwenden, wird ihre Unterscheidung erschwert. Priorisieren Sie wichtige Seiten und prüfen Sie, ob die Duplikate durch eine fehlerhafte Vorlage oder durch bewusst ähnliche Inhalte entstehen.

Kann ein SEO-Plugin die Prüfung vollständig übernehmen?

Ein Plugin kann Felder bereitstellen, Vorlagen erzeugen und auf manche Fehler hinweisen. Es ersetzt jedoch nicht die Kontrolle des ausgelieferten HTML und keine fachliche Bewertung. Falsche Einstellungen, Überschreibungen durch Themes oder Konflikte zwischen Erweiterungen können auch bei gut konfigurierten Plugins auftreten.

Wie lang sollten Title-Tag und Meta-Description sein?

Es gibt keine dauerhaft verlässliche sichtbare Zeichenlänge, da Suchdarstellungen je nach Gerät, Schriftbreite und Suchanfrage variieren. Formulieren Sie die wichtigste Aussage früh, vermeiden Sie unnötige Wiederholungen und prüfen Sie die Darstellung anschließend in einer Vorschau. Inhaltliche Klarheit ist wichtiger als das Ausreizen einer festen Zahl.

Warum erscheinen Änderungen an Meta-Daten nicht sofort?

Zwischenspeicher, verzögerte Abrufe und eine erneute Verarbeitung durch Suchmaschinen oder soziale Netzwerke können dazu führen, dass ältere Angaben vorübergehend sichtbar bleiben. Prüfen Sie zunächst, ob die neue Information tatsächlich im ausgelieferten HTML steht. Dokumentieren Sie den Änderungszeitpunkt und kontrollieren Sie die betroffene Darstellung später erneut.

Fazit

Wer die Meta-Daten einer Website prüfen möchte, sollte strukturiert vorgehen: Umfang festlegen, wichtige URLs priorisieren, HTML und gerenderte Inhalte kontrollieren, technische Signale abgleichen und die Ergebnisse nachvollziehbar dokumentieren. Title-Tag, Meta-Description, Robots-Anweisungen, Canonical-URLs, strukturierte Daten und Social-Media-Angaben erfüllen unterschiedliche Aufgaben und müssen deshalb jeweils passend bewertet werden.

Die beste Prüfung verbindet automatisierte Übersichten mit menschlicher Beurteilung. Entscheidend ist nicht die größtmögliche Anzahl an Meta-Elementen, sondern eine konsistente technische Grundlage, die den tatsächlichen Inhalt korrekt beschreibt und Besuchern eine klare Erwartung vermittelt.

Weiterleitungen richtig einrichten: Der praktische SEO- und Technik-Ratgeber

Weiterleitungen gehören zu den wichtigsten technischen Grundlagen einer gut gepflegten Website. Sie sorgen dafür, dass Besucher und Suchmaschinen von einer alten URL zuverlässig zu einer neuen Adresse gelangen. Richtig eingesetzt, bewahren sie bestehende Sichtbarkeit, vermeiden unnötige Fehlermeldungen und verbessern die Orientierung auf der Website. Falsch konfigurierte Weiterleitungen können dagegen zu Ketten, Schleifen, unnötigen Ladezeiten oder verlorenen Rankings führen.

Dieser Ratgeber zeigt, wie Sie Weiterleitungen richtig einrichten, welche Weiterleitungsarten sich für typische Fälle eignen und wie Sie Fehler systematisch prüfen. Die Beispiele sind allgemein gehalten und lassen sich je nach Server, Content-Management-System und Hostingumgebung anpassen.

Was ist eine Weiterleitung?

Eine Weiterleitung, auch Redirect genannt, weist einen Browser oder einen Suchroboter an, eine andere URL aufzurufen. Ruft jemand beispielsweise https://www.beispiel.de/alte-seite auf, kann der Server mitteilen, dass der gewünschte Inhalt künftig unter https://www.beispiel.de/neue-seite erreichbar ist.

Technisch besteht eine Weiterleitung aus einer HTTP-Statusmeldung und meist einer Zieladresse. Der Server antwortet also nicht einfach mit dem Seiteninhalt, sondern mit einer Information darüber, wie der Abruf fortgesetzt werden soll. Die wichtigsten Statuscodes für Weiterleitungen sind 301, 302, 307 und 308.

Eine Weiterleitung ist nicht dasselbe wie ein interner Link. Ein Link verweist im HTML-Dokument auf ein Ziel. Ein Redirect wird dagegen bereits beim Aufruf der URL verarbeitet. Diese Unterscheidung ist wichtig, weil Weiterleitungen auch alte externe Links, Lesezeichen und Suchmaschineneinträge auffangen können.

Warum Weiterleitungen für SEO und Nutzer wichtig sind

URLs ändern sich aus vielen Gründen: Ein Produkt wird umbenannt, eine Website erhält eine neue Struktur, Inhalte werden zusammengelegt oder eine Domain wird technisch vereinheitlicht. Ohne passende Weiterleitung landet der Besucher häufig auf einer 404-Fehlerseite. Das wirkt unprofessionell und kann dazu führen, dass wertvolle Verweise nicht mehr auf den passenden Inhalt führen.

Eine sauber geplante Weiterleitung hilft in mehreren Bereichen:

  • Nutzerführung: Besucher erreichen auch über alte Links den aktuellen Inhalt.
  • Technische Erreichbarkeit: Entfernte oder verschobene Seiten führen nicht unnötig zu Fehlerseiten.
  • Suchmaschinenverständnis: Ein permanenter Redirect signalisiert, dass eine Adresse dauerhaft durch eine andere ersetzt wurde.
  • Linkpflege: Externe Verweise können weiterhin auf einen thematisch passenden Zielinhalt führen.
  • Website-Struktur: Eine konsistente Domain-, Protokoll- und URL-Version verhindert doppelte Erreichbarkeit.

Ein Redirect ersetzt jedoch keine sorgfältige Informationsarchitektur. Wenn viele alte URLs ohne Prüfung pauschal auf die Startseite zeigen, entstehen oft unpassende Zielseiten. Gute Weiterleitungen sind deshalb möglichst präzise und führen zu einem inhaltlich nahen Ziel.

Die wichtigsten Weiterleitungstypen

u00dcbersicht der wichtigsten HTTP-Weiterleitungstypen 301, 302, 307 und 308
Die Statuscodes unterscheiden dauerhafte und vorübergehende Weiterleitungen.

Die Grafik unterstützt den Vergleich der wichtigsten Statuscodes. Achten Sie besonders darauf, ob ein URL-Wechsel dauerhaft oder nur vorübergehend gemeint ist.

Für die richtige Einrichtung ist entscheidend, ob eine Änderung dauerhaft oder nur vorübergehend gilt. Der Statuscode sollte zur tatsächlichen Situation passen.

301: dauerhaft verschoben

Der Statuscode 301 Moved Permanently eignet sich, wenn eine URL dauerhaft durch eine andere ersetzt wird. Typische Fälle sind die Umstellung von HTTP auf HTTPS, ein Domainwechsel, die Änderung eines URL-Pfads oder die Zusammenlegung zweier Inhalte.

Ein 301-Redirect ist die übliche Wahl, wenn Suchmaschinen langfristig die neue URL berücksichtigen sollen. Die alte Adresse sollte dabei nicht bloß auf irgendeine allgemeine Seite verweisen. Besser ist ein inhaltlich möglichst gleichwertiges Ziel.

302: vorübergehend verschoben

Ein 302 Found beziehungsweise eine temporäre Weiterleitung ist für zeitlich begrenzte Situationen gedacht. Dazu zählen etwa eine kurzfristige Kampagnenseite, ein vorübergehend nicht verfügbarer Bereich oder ein zeitlich begrenzter Test.

Wird eine URL dauerhaft geändert, ist ein 302 meist nicht die passende Wahl. Eine falsche Kennzeichnung kann die Verarbeitung durch Browser, Caches und Suchmaschinen erschweren. Prüfen Sie deshalb regelmäßig, ob eine zunächst temporäre Weiterleitung noch benötigt wird.

307 und 308: moderne Varianten

Die Statuscodes 307 Temporary Redirect und 308 Permanent Redirect unterscheiden sich unter anderem darin, dass die ursprüngliche HTTP-Methode erhalten bleiben soll. Das kann bei Formularen, Schnittstellen oder anderen nicht ausschließlich lesenden Anfragen relevant sein.

Für gewöhnliche Seitenaufrufe im redaktionellen WordPress-Bereich sind 301 und 302 meist leichter verständlich und ausreichend. Bei technischen Anwendungen sollten Sie die Auswirkungen auf Methoden wie GET, POST, PUT oder DELETE prüfen, bevor Sie einen Statuscode festlegen.

Entscheidungshilfe: Welcher Redirect passt?

Situation Geeignete Lösung Worauf achten?
Eine Seite erhält dauerhaft eine neue URL 301 Auf thematisch passenden Zielinhalt weiterleiten
Eine Adresse ist nur vorübergehend an einem anderen Ort 302 oder 307 Nach Ende der Aktion zurückbauen oder dauerhaft umstellen
Die gesamte Website wechselt von HTTP zu HTTPS 301 Interne Links und Canonicals ebenfalls aktualisieren
Eine Domain wird dauerhaft ersetzt 301 Alte wichtige URLs einzeln zuordnen, nicht nur die Startseite umleiten
Eine Seite wurde ersatzlos entfernt Keine automatische Weiterleitung oder passende Ersatzseite Kein beliebiges Ziel verwenden; eine nachvollziehbare 404 oder 410 kann sinnvoll sein

Weiterleitungen richtig planen

Die eigentliche technische Regel ist nur ein Teil der Arbeit. Vor der Umsetzung sollten Sie erfassen, welche URLs betroffen sind und welche Zielseiten fachlich sinnvoll sind.

1. Alte und neue URLs erfassen

Erstellen Sie eine Redirect-Liste mit mindestens drei Spalten: alte URL, neue URL und Begründung. Ergänzend können Sie Status, Umsetzungsdatum und eine Prüfnotiz aufnehmen. Berücksichtigen Sie dabei nicht nur die aktuell sichtbaren Menüpunkte, sondern auch:

  • URLs aus der XML-Sitemap,
  • wichtige Seiten aus der Webanalyse,
  • häufig verlinkte Inhalte,
  • alte Kampagnen- oder Landingpage-Adressen,
  • Varianten mit und ohne abschließenden Schrägstrich,
  • alte Dateiendungen oder veränderte Pfade.

Bei einem Domainwechsel ist eine vollständige URL-Inventur besonders wichtig. Eine reine Weiterleitung der Startseite reicht normalerweise nicht aus, weil Besucher und externe Links oft direkt auf Unterseiten zugreifen.

2. Ein fachlich passendes Ziel bestimmen

Ordnen Sie jede alte URL der besten verfügbaren neuen Seite zu. Eine alte Produktseite sollte möglichst auf das Nachfolgeprodukt oder eine passende Kategorie führen. Ein veralteter Ratgeber kann auf eine aktualisierte Fassung verweisen. Existiert kein sinnvoller Ersatz, ist eine verständliche Fehlerseite häufig besser als eine irreführende Weiterleitung.

Vermeiden Sie sogenannte Soft-404-Situationen: Die URL wird technisch weitergeleitet oder liefert den Status 200, obwohl der erwartete Inhalt nicht vorhanden ist. Eine leere, allgemeine oder offensichtlich unpassende Zielseite löst das eigentliche Problem nicht.

3. Eine einzige Zielkette anstreben

Ideal ist der direkte Weg von der alten zur aktuellen URL:

alte-url → endgültige-url

Ungünstig ist dagegen eine Kette wie:

alte-url → zwischen-url → weitere-url → endgültige-url

Weiterleitungsketten erhöhen die Zahl der HTTP-Anfragen und erschweren die Fehlersuche. Wenn eine alte Adresse bereits weiterleitet und sich das endgültige Ziel erneut ändert, aktualisieren Sie die ursprüngliche Regel nach Möglichkeit direkt auf die aktuelle URL.

Weiterleitungen auf dem Server einrichten

Die konkrete Umsetzung hängt vom Webserver ab. Ändern Sie Konfigurationsdateien nur, wenn Sie Zugriff auf Sicherungen und eine Möglichkeit zur Wiederherstellung haben. Ein Syntaxfehler kann dazu führen, dass die Website oder einzelne Bereiche nicht mehr erreichbar sind.

Apache mit .htaccess

Auf Apache-Servern werden einfache Regeln häufig in der Datei .htaccess im jeweiligen Webverzeichnis hinterlegt. Ein typisches Beispiel für eine einzelne dauerhafte Umleitung lautet:

Redirect 301 /alter-pfad https://www.beispiel.de/neuer-pfad

Für komplexere Regeln wird häufig das Rewrite-Modul verwendet. Dabei muss die konkrete Serverumgebung berücksichtigt werden, insbesondere der Gültigkeitsbereich der Datei und die Reihenfolge mehrerer Regeln. Testen Sie eine Regel zunächst mit einer einzelnen URL, bevor Sie ein Muster auf viele Adressen anwenden.

Nginx

Bei Nginx werden Weiterleitungen in der Serverkonfiguration definiert. Ein einfaches Beispiel kann so aussehen:

location = /alter-pfad {
    return 301 https://www.beispiel.de/neuer-pfad;
}

Nach Änderungen muss die Konfiguration in der Regel geprüft und neu geladen werden. Der genaue Befehl hängt vom System und vom Hosting ab. Lassen Sie produktive Konfigurationen bei Unsicherheit von einer fachkundigen Person prüfen.

Weiterleitungen in WordPress

In WordPress können Redirects je nach Hosting, Server und eingesetzter Verwaltungssoftware auf mehreren Wegen eingerichtet werden. Manche Hoster bieten dafür eine eigene Oberfläche. Alternativ kann ein etabliertes Redirect-Plugin die Verwaltung erleichtern, besonders wenn Redakteure Regeln ohne direkten Serverzugriff pflegen sollen.

Unabhängig vom Werkzeug bleiben die Grundregeln gleich: Verwenden Sie den passenden Statuscode, dokumentieren Sie jede Regel, vermeiden Sie Zielketten und sichern Sie die Konfiguration. Prüfen Sie außerdem, ob ein Plugin Regeln vor oder nach anderen WordPress-Prozessen ausführt, da sich daraus unterschiedliche Ergebnisse ergeben können.

Häufige Redirect-Fehler vermeiden

Weiterleitungsschleifen

Eine Schleife entsteht, wenn URL A auf URL B und URL B wieder auf URL A verweist. Häufige Ursachen sind widersprüchliche HTTP- und HTTPS-Regeln, konkurrierende www- und non-www-Einstellungen oder automatische Regeln im CMS und im Hosting. Der Browser meldet dann, dass zu viele Weiterleitungen aufgetreten sind.

Prüfen Sie in solchen Fällen alle Ebenen: DNS und CDN, Hosting, Webserver, CMS, Plugins und eventuell vorgeschaltete Sicherheitsdienste. Entfernen Sie doppelte Regeln und legen Sie eine eindeutige bevorzugte URL-Version fest.

HTTP, HTTPS, www und non-www vermischen

Eine Website kann technisch unter mehreren Varianten erreichbar sein. Entscheiden Sie sich für eine kanonische Version, zum Beispiel HTTPS mit oder ohne www, und leiten Sie die übrigen Varianten mit einer klaren Regel dorthin. Interne Links, Canonical-Tags, Sitemaps und strukturierte Verweise sollten ebenfalls auf die bevorzugte Version zeigen.

Relative und absolute Ziele unübersichtlich mischen

Relative Zielpfade sind in einfachen Serverregeln praktisch, absolute URLs machen das Ziel jedoch oft eindeutiger. Besonders bei Domainumzügen, Protokolländerungen und komplexen Konfigurationen sollten Sie genau prüfen, ob das gewünschte Schema und die gewünschte Domain verwendet werden.

Alles auf die Startseite umleiten

Eine pauschale Startseitenweiterleitung wirkt zunächst bequem, ist aber für Besucher meist wenig hilfreich. Sie sollten sie nur dort einsetzen, wo die Startseite tatsächlich das passende Ziel ist. Andernfalls ordnen Sie alte Inhalte besser einzeln zu oder lassen nicht mehr vorhandene Adressen kontrolliert mit einem passenden Fehlerstatus reagieren.

Parameter und Großschreibung übersehen

Je nach System können URL-Parameter, Groß- und Kleinschreibung oder abschließende Schrägstriche unterschiedliche Adressen erzeugen. Prüfen Sie, ob Regeln unbeabsichtigt Suchparameter entfernen, Tracking-Informationen verändern oder mehrere Varianten auf widersprüchliche Ziele führen. Nicht jeder Parameter braucht einen eigenen Redirect; oft ist eine klare technische und redaktionelle URL-Strategie sinnvoller.

Weiterleitungen testen und überwachen

Nach der Einrichtung sollte jede wichtige Regel praktisch überprüft werden. Öffnen Sie zunächst die alte URL in einem privaten Browserfenster und kontrollieren Sie, ob das erwartete Ziel erreicht wird. Für eine technische Prüfung benötigen Sie zusätzlich den HTTP-Status und den vollständigen Weiterleitungsverlauf.

Achten Sie bei der Kontrolle auf folgende Punkte:

  • Die alte Adresse liefert den vorgesehenen Statuscode.
  • Das Ziel verwendet das richtige Protokoll und die richtige Domain.
  • Es gibt nur den notwendigen Redirect-Schritt.
  • Die Zielseite antwortet mit einem erfolgreichen Status.
  • Der Inhalt passt fachlich zur alten URL.
  • Keine wichtigen Parameter oder Pfade gehen unbeabsichtigt verloren.
  • Mobile und Desktop-Aufrufe verhalten sich wie vorgesehen.

Nach größeren Änderungen sollten Sie außerdem Serverprotokolle, Crawling-Berichte und die eigene Fehlerüberwachung beobachten. Wenn weiterhin viele alte URLs auf Fehlerseiten führen, ergänzen Sie die Redirect-Liste. Wenn dagegen ungewöhnlich viele Weiterleitungen auf eine einzige allgemeine Seite zeigen, prüfen Sie die Zielzuordnung.

Redirects bei typischen Website-Projekten

Relaunch mit neuer URL-Struktur

Bei einem Relaunch sollten Sie die alte Struktur vor dem Livegang erfassen und jeder wichtigen URL ein neues Ziel zuordnen. Legen Sie die Redirects rechtzeitig an, testen Sie sie in einer sicheren Umgebung und prüfen Sie am Veröffentlichungstag besonders die meistbesuchten Seiten. Aktualisieren Sie parallel interne Links, Navigation, Canonicals und die XML-Sitemap.

Domainwechsel

Bei einem Domainwechsel ist eine URL-zu-URL-Zuordnung sinnvoll. Die alte Domain sollte die passenden Unterseiten auf die entsprechenden neuen Unterseiten weiterleiten. Kontrollieren Sie zusätzlich E-Mail-Links, externe Integrationen, Bildpfade, hreflang-Verweise und alle Stellen, an denen die alte Domain fest hinterlegt sein könnte.

Zusammenlegung ähnlicher Inhalte

Wenn mehrere Artikel zu einem umfassenden Beitrag zusammengeführt werden, können die bisherigen Einzel-URLs auf die neue Hauptseite zeigen. Überarbeiten Sie dabei den neuen Inhalt so, dass er die wichtigsten Erwartungen der alten Seiten abdeckt. Dokumentieren Sie die Zusammenlegung und beobachten Sie, ob Nutzer weiterhin passende Informationen finden.

Vorübergehende Kampagnen

Bei einer zeitlich begrenzten Aktion sollte die ursprüngliche URL nicht dauerhaft umgeleitet werden, wenn sie danach wieder benötigt wird. Definieren Sie einen klaren Start- und Endzeitpunkt und planen Sie die Rückkehr zur regulären Zielseite. Temporäre Regeln sollten nicht dauerhaft im System verbleiben, weil sie später für Verwirrung sorgen können.

Checkliste: Weiterleitungen richtig einrichten

  1. Betroffene alte URLs vollständig sammeln.
  2. Für jede URL ein fachlich passendes Ziel festlegen.
  3. Zwischen dauerhafter und vorübergehender Änderung unterscheiden.
  4. Den passenden HTTP-Statuscode auswählen.
  5. Direkte Weiterleitungen ohne unnötige Ketten erstellen.
  6. Regeln in einer dokumentierten Liste festhalten.
  7. Widersprüchliche Regeln in CMS, Server, CDN und Hosting vermeiden.
  8. Alte und neue URL mit Statusprüfung testen.
  9. Interne Links, Canonicals und Sitemaps aktualisieren.
  10. Fehlerberichte und Weiterleitungsketten nach dem Start beobachten.

FAQ

Wann sollte ich eine 301-Weiterleitung verwenden?

Eine 301-Weiterleitung ist passend, wenn eine URL dauerhaft durch eine andere ersetzt wird. Das gilt beispielsweise für einen neuen URL-Pfad, eine dauerhafte Domainänderung oder die Umstellung von HTTP auf HTTPS. Das Ziel sollte inhaltlich möglichst gut zur ursprünglichen Adresse passen.

Ist eine Weiterleitung auf die Startseite immer sinnvoll?

Nein. Die Startseite ist nur dann ein gutes Ziel, wenn sie die Erwartung des Besuchers erfüllt. Für einen entfernten Artikel, ein nicht mehr verfügbares Produkt oder eine alte Kategorie ist eine thematisch passende Ersatzseite meist hilfreicher. Gibt es keinen sinnvollen Ersatz, kann eine kontrollierte Fehlerseite die bessere Lösung sein.

Wie viele Weiterleitungen hintereinander sind akzeptabel?

Am besten ist genau eine Weiterleitung bis zur endgültigen Zielseite. Mehrere Schritte können zwar funktionieren, erhöhen aber die Ladezeit und die Fehleranfälligkeit. Wenn Sie eine Kette entdecken, ändern Sie die alte Regel möglichst direkt auf das finale Ziel.

Brauche ich für jede gelöschte Seite einen Redirect?

Nicht zwingend. Entscheidend ist, ob ein passender Ersatzinhalt existiert und ob die alte URL für Besucher oder externe Verweise relevant ist. Gibt es keinen sinnvollen Ersatz, sollte die Adresse nicht künstlich auf eine unpassende Seite zeigen. Eine korrekt konfigurierte Fehlerantwort kann in diesem Fall nachvollziehbarer sein.

Kann ich Weiterleitungen mit einem WordPress-Plugin einrichten?

Ja, viele WordPress-Installationen nutzen dafür ein Redirect-Plugin oder eine Funktion des Hosters. Das ist besonders praktisch, wenn Regeln regelmäßig redaktionell gepflegt werden müssen. Prüfen Sie jedoch die Kompatibilität mit Serverregeln, Caching und anderen Plugins und sichern Sie die Konfiguration vor größeren Änderungen.

Wie erkenne ich eine Weiterleitungsschleife?

Ein Browser meldet häufig zu viele Weiterleitungen oder lädt die Seite nicht. Technische Prüfungen zeigen dann, dass mehrere URLs wechselseitig aufeinander verweisen. Kontrollieren Sie insbesondere HTTP-zu-HTTPS-Regeln, www-Varianten, CMS-Einstellungen und vorgeschaltete Dienste.

Wie lange sollte eine alte Weiterleitung bestehen bleiben?

Das hängt von der Bedeutung der alten URL, ihrer Verlinkung und den Zugriffsversuchen ab. Bei wichtigen, dauerhaft geänderten Adressen sollte der Redirect nicht vorschnell entfernt werden. Prüfen Sie regelmäßig Protokolle und Fehlerberichte, bevor Sie alte Regeln bereinigen.

Fazit

Wer Weiterleitungen richtig einrichten möchte, sollte nicht nur einen einzelnen Statuscode auswählen. Entscheidend sind eine vollständige URL-Erfassung, eine passende Zielzuordnung, direkte Weiterleitungswege und eine sorgfältige Prüfung nach der Umsetzung. Dauerhafte Änderungen werden in der Regel mit 301 abgebildet, während vorübergehende Situationen einen temporären Status benötigen.

Dokumentieren Sie Ihre Regeln, vermeiden Sie pauschale Startseitenziele und berücksichtigen Sie neben dem Server auch WordPress, Caching, Sitemaps und interne Links. So bleiben alte Verweise nützlich, Besucher gelangen zuverlässig zum richtigen Inhalt und die technische Struktur Ihrer Website bleibt langfristig nachvollziehbar.

SEO-Probleme frühzeitig erkennen: Der praxisnahe Ratgeber für stabile Sichtbarkeit

SEO-Probleme entstehen selten erst in dem Moment, in dem eine Website vollständig aus den Suchergebnissen verschwindet. Häufig kündigen sich technische Fehler, Qualitätsprobleme oder Veränderungen bei der Suchintention bereits vorher an: wichtige Seiten verlieren Impressionen, neue Inhalte werden nicht indexiert oder Besucher verlassen bestimmte Bereiche ungewöhnlich schnell. Wer solche Signale regelmäßig beobachtet, kann Ursachen meist früher eingrenzen und gezielter reagieren.

Dieser Ratgeber zeigt, wie du SEO-Probleme frühzeitig erkennst, welche Prüfungen sich im Alltag bewährt haben und wie du Warnsignale nach Dringlichkeit bewertest. Im Mittelpunkt stehen nachvollziehbare Kontrollen statt kurzfristiger Tricks oder vorschneller Änderungen.

Warum eine frühe SEO-Diagnose wichtig ist

Organische Sichtbarkeit entwickelt sich durch das Zusammenspiel vieler Faktoren. Dazu gehören die technische Zugänglichkeit einer Website, die Qualität und Ausrichtung ihrer Inhalte, interne Verlinkungen, externe Signale und die Passung zur Suchanfrage. Ein einzelnes schwaches Signal muss nicht automatisch ein ernstes Problem bedeuten. Mehrere Veränderungen in dieselbe Richtung sind jedoch ein guter Anlass für eine Untersuchung.

Eine frühe Diagnose hat drei Vorteile:

  • Der Schaden bleibt begrenzt: Eine falsche Weiterleitung oder eine versehentlich gesetzte Sperre lässt sich leichter beheben, wenn sie schnell entdeckt wird.
  • Ursachen bleiben nachvollziehbar: Wenn Prüfungen und Änderungen dokumentiert werden, lässt sich besser erkennen, welche Maßnahme eine Entwicklung beeinflusst hat.
  • Ressourcen werden gezielter eingesetzt: Ein klarer Befund verhindert, dass Zeit in eine umfassende Überarbeitung investiert wird, obwohl nur ein technisches Detail fehlerhaft ist.

Wichtig ist eine saubere Trennung zwischen Beobachtung und Schlussfolgerung. Sinkende Klicks sind zunächst ein Signal. Erst der Vergleich mit Impressionen, Positionen, Suchanfragen, betroffenen URLs und technischen Daten zeigt, welche Erklärung plausibel ist.

Die wichtigsten Warnsignale im Überblick

u00dcbersicht typischer Warnsignale bei SEO-Problemen
Typische Warnsignale helfen, SEO-Probleme systematisch einzuordnen.

Die Abbildung zeigt, dass ein einzelnes Signal selten die gesamte Diagnose erklärt. Erst das Zusammenspiel von Leistungsdaten, technischen Hinweisen und betroffenen URLs macht die nächste Prüfung sinnvoll.

SEO-Probleme können auf URL-Ebene, in einzelnen Verzeichnissen oder auf der gesamten Website auftreten. Die folgende Übersicht hilft bei einer ersten Einordnung:

Warnsignal Mögliche Ursache Erste Prüfung
Deutlich weniger Klicks Veränderte Rankings, geringere Nachfrage, schlechtere Darstellung oder technische Einschränkung Leistung nach Suchanfragen, Seiten und Gerät vergleichen
Weniger Impressionen Verlust von Rankings, Suchinteresse oder Indexierbarkeit Betroffene URLs und Zeiträume gegenüberstellen
Viele neue ausgeschlossene Seiten Fehlerhafte Canonicals, noindex-Anweisungen, Weiterleitungen oder Crawling-Probleme Indexierungsbericht und konkrete URLs prüfen
Ungewöhnlich viele Weiterleitungen Umzüge, Ketten, fehlerhafte interne Links oder wechselnde URL-Strukturen Weiterleitungsziele und Statuscodes kontrollieren
Sinkende Sichtbarkeit einzelner Inhalte Veraltete Inhalte, falsche Suchintention oder stärkere Konkurrenz Inhalt, Suchergebnisse und interne Verlinkung vergleichen
Schlechte mobile Nutzung Zu kleine Bedienelemente, überlappende Elemente oder lange Ladezeiten Mobile Darstellung auf realen Geräten und mit Berichten prüfen

Diese Signale sollten nicht isoliert bewertet werden. Ein saisonaler Rückgang kann beispielsweise völlig normal sein, während ein gleichzeitiger Verlust von Impressionen und eine fehlerhafte robots.txt-Datei eher auf ein technisches Problem hindeuten.

SEO-Daten richtig beobachten

Suchleistung nach Zeiträumen vergleichen

Ein einzelner Tageswert ist für eine SEO-Diagnose meist wenig aussagekräftig. Vergleiche längere Zeiträume und stelle ihnen einen passenden Vergleichszeitraum gegenüber. Bei saisonalen Themen kann ein Vergleich mit dem Vorjahr sinnvoller sein als der direkte Vergleich mit der Vorwoche.

Betrachte mindestens Klicks, Impressionen, durchschnittliche Position und Klickrate. Segmentiere die Daten zusätzlich nach Suchanfrage, Zielseite, Land, Gerät und Suchtyp, sofern diese Informationen verfügbar sind. Dadurch wird sichtbar, ob ein Problem die gesamte Website betrifft oder nur bestimmte Inhalte.

Veränderungen nicht vorschnell als Rankingverlust bewerten

Weniger Klicks können verschiedene Gründe haben. Fallen Impressionen und Positionen gemeinsam, ist ein Sichtbarkeitsverlust wahrscheinlich. Bleiben Impressionen stabil, sinkt aber die Klickrate, können Seitentitel, Snippets, SERP-Elemente oder die Konkurrenzdarstellung eine Rolle spielen. Steigt die durchschnittliche Position, ohne dass Klicks zunehmen, kann sich die Nachfrage verändert haben oder die Suchergebnisse können mehr direkte Antworten enthalten.

Notiere für auffällige Entwicklungen immer den Startzeitpunkt. Prüfe danach, ob an diesem Tag eine Website-Änderung, ein Relaunch, eine neue Weiterleitungsregel, eine Anpassung von Metadaten oder eine Veränderung des Angebots stattgefunden hat. So entsteht eine belastbare zeitliche Spur.

Technische SEO-Probleme frühzeitig erkennen

Indexierung und Crawling prüfen

Eine Seite kann nur organisch sichtbar werden, wenn Suchmaschinen sie finden, abrufen und für die Suche berücksichtigen können. Prüfe deshalb regelmäßig, ob wichtige URLs indexierbar sind. Dabei sollten insbesondere folgende Punkte kontrolliert werden:

  • Ist die URL mit einem erfolgreichen HTTP-Status erreichbar?
  • Verhindert eine robots.txt-Regel den Zugriff?
  • Enthält die Seite versehentlich ein noindex-Signal?
  • Zeigt das Canonical-Element auf die gewünschte URL?
  • Ist die URL in der XML-Sitemap enthalten, wenn sie indexiert werden soll?
  • Existieren interne Links, über die Suchmaschinen und Nutzer die Seite erreichen?

Ein einzelner Indexierungsbericht liefert nicht immer die vollständige Erklärung. Nutze die URL-Prüfung für repräsentative Beispiele und vergleiche wichtige Seiten mit ähnlichen, bereits sichtbaren URLs. Besonders kritisch sind Veränderungen, die viele Seiten derselben Vorlage betreffen.

Statuscodes, Weiterleitungen und Fehlerseiten

Ein 404-Fehler ist nicht grundsätzlich problematisch. Er kann korrekt sein, wenn eine Seite dauerhaft entfernt wurde und keine gleichwertige Alternative existiert. Kritisch wird es, wenn wichtige Inhalte unerwartet einen Fehler liefern, interne Links auf nicht vorhandene URLs zeigen oder mehrere Weiterleitungen hintereinander auftreten.

Prüfe bei einem URL-Wechsel, ob die alte Adresse direkt auf die fachlich passende neue Adresse weiterleitet. Vermeide Weiterleitungsketten und leite nicht pauschal jede alte URL auf die Startseite. Das erschwert Nutzern die Orientierung und kann die thematische Zuordnung verwässern.

Seitenerfahrung und Geschwindigkeit als Diagnose, nicht als Selbstzweck

Ladezeit und mobile Bedienbarkeit beeinflussen, ob Menschen eine Seite problemlos nutzen können. Sie sind deshalb wichtige Qualitäts- und Diagnoseaspekte. Prüfe nicht nur einen technischen Einzelwert, sondern die reale Nutzung verschiedener Seitentypen: Startseite, Kategorie, Ratgeber, Produktseite und Kontaktbereich können sich deutlich unterscheiden.

Achte auf große Bilder, unnötige Skripte, Layoutverschiebungen, blockierende Ressourcen und schlecht erreichbare Bedienelemente. Eine Optimierung sollte immer mit einem konkreten Nutzerproblem beginnen. Ein guter Messwert allein ersetzt keine Prüfung der tatsächlichen Darstellung.

Inhaltliche und strukturelle SEO-Probleme aufdecken

Suchintention und Inhalt abgleichen

Ein Inhalt kann fachlich korrekt sein und trotzdem für eine Suchanfrage nicht gut funktionieren. Prüfe, welches Ziel hinter der Anfrage steht: Sucht die Person eine Erklärung, einen Vergleich, eine Anleitung, eine konkrete Lösung oder eine Bezugsquelle? Der Inhalt sollte dieses Ziel früh erkennbar bedienen.

Vergleiche die eigene Seite mit den aktuellen Suchergebnissen, ohne andere Texte einfach nachzuahmen. Frage dich:

  • Beantwortet die Seite die zentrale Frage direkt?
  • Ist die erwartete Detailtiefe vorhanden?
  • Wird erklärt, für wen die Empfehlung oder Anleitung gilt?
  • Sind Grenzen, Voraussetzungen und mögliche Ausnahmen nachvollziehbar?
  • Führen interne Links zu weiterführenden Informationen?

Wenn sich die Suchintention verändert hat, reicht es häufig nicht, einzelne Schlüsselbegriffe zu ergänzen. Dann muss die Struktur des Inhalts angepasst werden.

Veraltete, dünne und doppelte Inhalte

Überarbeite zuerst Seiten, die für wichtige Themen Sichtbarkeit verloren haben und noch einen klaren Nutzen besitzen. Prüfe Aussagen, Beispiele, Screenshots, interne Links und Handlungsanweisungen. Entferne überholte Details, statt nur neue Absätze anzuhängen.

Dünne Inhalte sind nicht allein wegen ihrer Wortzahl problematisch. Entscheidend ist, ob sie die Frage ausreichend beantworten und einen eigenständigen Zweck erfüllen. Mehrere nahezu identische Seiten können Nutzer verwirren und die interne Struktur schwächen. Überlege, ob Inhalte zusammengeführt, klar voneinander abgegrenzt oder auf eine passende Hauptseite verwiesen werden sollten.

Titel, Überschriften und Snippets

Ein verständlicher Seitentitel beschreibt präzise, was die Seite bietet. Die wichtigste Information sollte nicht durch allgemeine Formulierungen verdeckt werden. Überschriften helfen Nutzern, den Inhalt zu scannen; sie sollten eine logische Hierarchie bilden und keine bloße Sammlung von Suchbegriffen sein.

Eine niedrige Klickrate ist ein Anlass, Titel und Beschreibung zu prüfen, aber kein Beweis, dass ausschließlich diese Elemente die Ursache sind. Berücksichtige auch Position, Suchintention, Markensignale und die Darstellung konkurrierender Ergebnisse.

Interne Verlinkung und Website-Struktur kontrollieren

Interne Links verbinden Inhalte, unterstützen die Navigation und helfen Suchmaschinen, thematische Zusammenhänge zu erkennen. Ein Warnsignal sind wichtige Seiten, die nur über die XML-Sitemap oder über eine Suche erreichbar sind, aber kaum redaktionelle Links erhalten.

Erstelle eine Liste der zentralen Themen und ordne ihnen passende Unterseiten zu. Prüfe anschließend:

  • Verlinken relevante ältere Beiträge auf neue, passende Inhalte?
  • Führen Links zu Seiten, die noch existieren und den erwarteten Inhalt liefern?
  • Sind Ankertexte verständlich und nicht übermäßig wiederholt?
  • Erreichen Nutzer wichtige Inhalte mit wenigen sinnvollen Schritten?
  • Gibt es verwaiste Seiten ohne redaktionelle interne Links?

Eine gute Struktur ist nicht möglichst tief oder möglichst flach. Sie sollte die Denkweise der Nutzer abbilden und wichtige Inhalte eindeutig priorisieren. Änderungen an Navigation, Kategorien oder URL-Struktur sollten deshalb geplant und dokumentiert werden.

Ein praktikabler Prüfprozess in fünf Schritten

1. Auffälligkeit beschreiben

Formuliere das Problem konkret: „Die Impressionen wichtiger Ratgeberseiten sinken seit einem bestimmten Zeitraum“ ist hilfreicher als „Die SEO ist schlechter geworden“. Ergänze betroffene URLs, Geräte, Länder und Suchanfragen.

2. Umfang feststellen

Prüfe, ob nur eine URL, ein Seitentyp, ein Verzeichnis oder die gesamte Website betroffen ist. Ein Problem in einer Vorlage kann viele URLs gleichzeitig beeinflussen. Ein einzelner Inhalt erfordert dagegen meist eine andere Analyse.

3. Technische Ursachen ausschließen

Kontrolliere Erreichbarkeit, Statuscode, Indexierungsanweisungen, Canonical, interne Verlinkung und Sitemap. Führe diese Prüfung vor größeren redaktionellen Änderungen durch. Andernfalls kann ein technischer Fehler durch neue Inhalte verdeckt werden.

4. Inhalt und Suchergebnisse bewerten

Untersuche Suchintention, Aktualität, Verständlichkeit, Vollständigkeit und Nutzbarkeit. Schaue dir die Suchergebnisse zu wichtigen Suchanfragen an und notiere, welche Erwartungen dort sichtbar werden.

5. Eine Änderung nach der anderen dokumentieren

Lege fest, was geändert wird, warum die Änderung notwendig ist und woran der Erfolg gemessen werden soll. Vermeide es, gleichzeitig URL-Struktur, Seitentitel, Inhalt und interne Verlinkung umzubauen, wenn du die Ursache einer Entwicklung verstehen möchtest. Nach der Umsetzung braucht es eine angemessene Beobachtungsphase.

Welche SEO-Probleme haben Priorität?

Nicht jede Warnung verlangt sofort eine umfassende Maßnahme. Eine einfache Priorisierung berücksichtigt vier Fragen:

  1. Wie groß ist die betroffene Reichweite? Ein Fehler auf vielen wichtigen Seiten ist dringlicher als ein Detail auf einer kaum besuchten URL.
  2. Wie wichtig ist die betroffene Seite für das Geschäfts- oder Informationsziel? Eine zentrale Leistungsseite verdient besondere Aufmerksamkeit.
  3. Wie sicher ist die Diagnose? Ein belegter noindex-Fehler ist anders zu behandeln als eine Vermutung über veränderte Suchintention.
  4. Wie hoch ist das Risiko der Gegenmaßnahme? Große Umzüge oder Löschungen sollten sorgfältiger vorbereitet werden als eine Korrektur eines falschen Links.

Akute technische Blockaden, falsche Weiterleitungen und versehentlich ausgeschlossene Kernseiten gehören meist an den Anfang. Danach folgen strukturelle Probleme wie verwaiste Inhalte oder doppelte URL-Varianten. Inhaltliche Verbesserungen können parallel geplant, aber nach ihrer erwarteten Wirkung priorisiert werden.

Häufige Fehler bei der SEO-Diagnose

  • Nur Rankings betrachten: Rankings schwanken. Ergänze sie durch Klicks, Impressionen, Suchanfragen und technische Daten.
  • Zu schnell alles ändern: Viele gleichzeitige Änderungen machen die Ursachenanalyse schwierig.
  • Jeden Rückgang als Strafe interpretieren: Nachfrage, Wettbewerb, Saison und Suchergebnisdarstellung können sich ebenfalls verändern.
  • Nur die Startseite prüfen: Probleme liegen oft in Templates, Kategorien, mobilen Ansichten oder einzelnen Verzeichnissen.
  • Inhalte mit Suchbegriffen überladen: Verständlichkeit und tatsächlicher Nutzen sind wichtiger als künstliche Wiederholungen.
  • Warnungen ungeprüft automatisieren: Ein Tool kann auf eine mögliche Ursache hinweisen, aber nicht jede Empfehlung passt zur Website.

Eine gute SEO-Diagnose verbindet automatisierte Hinweise mit manueller Prüfung. Entscheidend ist nicht die Zahl der gefundenen Warnungen, sondern ob daraus eine nachvollziehbare, risikoarme Handlung entsteht.

FAQ

Wie oft sollte ich eine Website auf SEO-Probleme prüfen?

Die Häufigkeit hängt von Größe, Änderungsrate und Bedeutung der Website ab. Leistungsdaten können regelmäßig beobachtet werden; eine ausführliche technische Prüfung ist besonders nach Relaunches, größeren Template-Änderungen oder URL-Umzügen sinnvoll. Kleine Websites profitieren ebenfalls von einem festen Prüfintervall, damit Auffälligkeiten nicht über Monate unbemerkt bleiben.

Was ist der erste Schritt bei plötzlich sinkender Sichtbarkeit?

Bestätige zunächst den Zeitraum und den Umfang des Rückgangs. Vergleiche Klicks, Impressionen und Positionen nach Seiten und Suchanfragen. Prüfe anschließend, ob wichtige URLs erreichbar, indexierbar und korrekt verlinkt sind. Erst danach solltest du umfassende inhaltliche Änderungen planen.

Ist ein 404-Fehler immer ein SEO-Problem?

Nein. Eine nicht mehr vorhandene URL kann korrekt einen 404-Status liefern. Problematisch ist der Fehler, wenn die Seite weiterhin benötigt wird, viele interne Links auf sie zeigen oder eine fachlich passende neue Adresse existiert. Dann sollte die Ursache behoben oder eine sinnvolle Weiterleitung geprüft werden.

Wie erkenne ich, ob ein Inhalt veraltet ist?

Prüfe, ob Fakten, Beispiele, Empfehlungen, Screenshots und Links noch stimmen. Vergleiche außerdem die aktuelle Suchintention mit dem Inhalt. Ein Beitrag kann auch ohne sichtbare Datumsangabe veraltet sein, wenn sich Verfahren, Produkte oder Erwartungen der Nutzer verändert haben.

Welche Rolle spielt die Klickrate?

Die Klickrate zeigt, wie häufig ein Ergebnis im Verhältnis zu seinen Impressionen angeklickt wird. Sie sollte immer zusammen mit Position, Suchanfrage und Suchergebnisdarstellung betrachtet werden. Eine niedrige Klickrate kann auf einen unklaren Titel hindeuten, aber auch durch eine stark umkämpfte Suchanfrage oder zusätzliche Suchfunktionen entstehen.

Soll ich bei SEO-Problemen zuerst technische oder inhaltliche Änderungen vornehmen?

Schließe zunächst grundlegende technische Blockaden aus. Wenn eine Seite nicht erreichbar oder nicht indexierbar ist, bringt eine inhaltliche Überarbeitung wenig. Sind diese Punkte unauffällig, kannst du Suchintention, Qualität, Aktualität und interne Verlinkung untersuchen.

Wann ist professionelle Unterstützung sinnvoll?

Unterstützung kann sinnvoll sein, wenn ein Relaunch ansteht, viele URLs betroffen sind, die Ursachen unklar bleiben oder Änderungen ein hohes Risiko für wichtige Inhalte haben. Gute Unterstützung sollte Befunde verständlich erklären, Prioritäten begründen und zwischen gesicherten Fakten und Hypothesen unterscheiden.

Fazit: SEO-Probleme mit System frühzeitig erkennen

SEO-Probleme frühzeitig zu erkennen bedeutet nicht, jede kleine Schwankung zu bekämpfen. Es geht darum, relevante Veränderungen systematisch zu beobachten, ihren Umfang zu bestimmen und technische, inhaltliche sowie strukturelle Ursachen voneinander zu trennen. Ein fester Prüfprozess, dokumentierte Änderungen und eine klare Priorisierung schaffen dafür die Grundlage.

Beginne mit den wichtigsten Seiten und realen Nutzungssituationen. Prüfe zuerst, ob Suchmaschinen und Menschen die Inhalte zuverlässig erreichen. Bewerte danach Suchintention, Aktualität und interne Verbindungen. So entstehen Maßnahmen, die nicht nur kurzfristig Kennzahlen verbessern sollen, sondern die Website dauerhaft verständlicher, zugänglicher und hilfreicher machen.