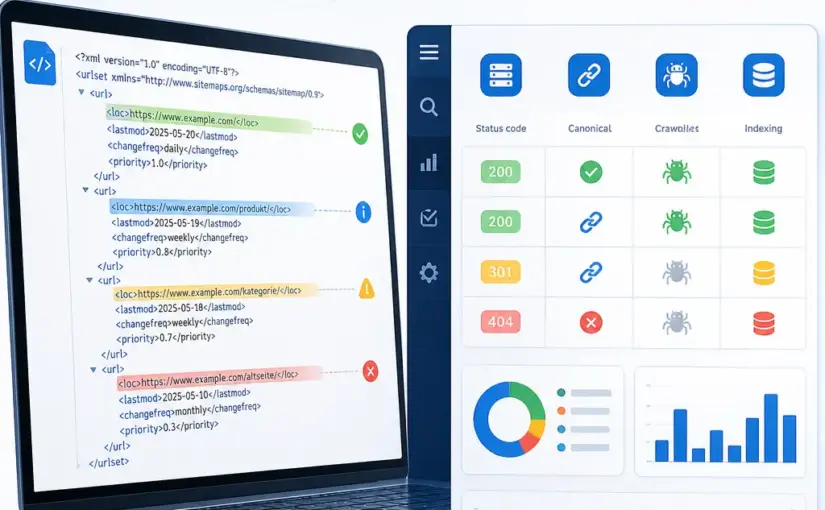
Sitemap.xml prüfen und optimieren: Der umfassende Ratgeber für bessere Crawlbarkeit

Eine gut gepflegte sitemap.xml hilft Suchmaschinen dabei, wichtige URLs einer Website effizient zu entdecken und regelmäßig zu crawlen. Sie ersetzt weder eine klare interne Verlinkung noch hochwertige Inhalte, kann aber besonders bei großen, neuen oder häufig veränderten Websites wertvolle Orientierung geben. In diesem Ratgeber erfahren Sie, wie Sie Ihre Sitemap.xml prüfen, typische Fehler erkennen und die Datei dauerhaft sinnvoll optimieren.

Was ist eine Sitemap.xml und welche Aufgabe hat sie?

Eine XML-Sitemap ist eine maschinenlesbare Datei, in der die indexierbaren URLs einer Website aufgelistet werden. Sie liegt häufig unter einer Adresse wie https://www.beispiel.de/sitemap.xml oder verweist als Sitemap-Index auf mehrere einzelne Sitemaps. Suchmaschinen können diese URLs abrufen und mit den Informationen aus der Sitemap abgleichen.

Wichtig ist die richtige Einordnung: Eine Sitemap ist keine Liste von Seiten, die automatisch indexiert werden. Sie ist vielmehr ein Hinweis an Suchmaschinen, welche URLs Sie für relevant halten. Ob eine Seite tatsächlich gecrawlt und in den Suchindex aufgenommen wird, hängt zusätzlich von Faktoren wie Inhalt, interner Verlinkung, Zugriffsmöglichkeit, Canonical-Angabe und technischen Signalen ab.

Für kleine Websites mit wenigen, gut verlinkten Seiten ist eine Sitemap nicht immer entscheidend. Dennoch gehört sie heute meist zur technischen Grundausstattung. Besonders nützlich ist sie in folgenden Situationen:

  • Die Website enthält viele Seiten oder wird regelmäßig erweitert.
  • Neue Inhalte sind nur über wenige interne Links erreichbar.
  • Es gibt Archive, Filterseiten oder andere große URL-Strukturen, die sorgfältig gesteuert werden müssen.
  • Die Website enthält Bilder, Videos oder Nachrichteninhalte mit speziellen Anforderungen.
  • Die interne Verlinkung ist noch nicht vollständig ausgebaut.
  • Nach einem Relaunch sollen wichtige URLs schneller erkannt werden.

Sitemap.xml prüfen: Die wichtigsten Kontrollen im Überblick
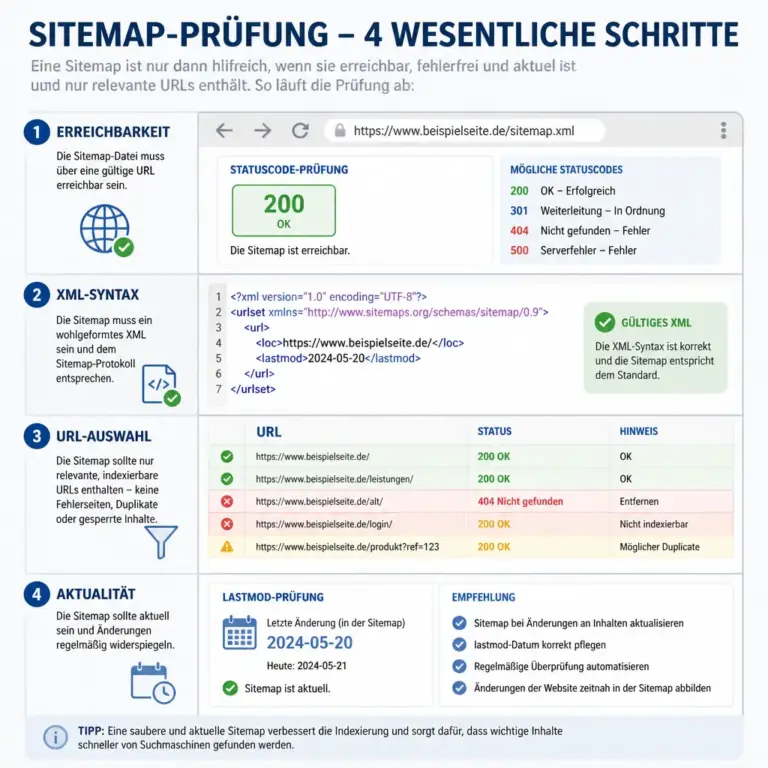
Infografik mit den wichtigsten Pru00fcfschritten fu00fcr eine Sitemap.xml
Diese Übersicht zeigt die zentralen Prüfschritte einer Sitemap-Kontrolle.

Achten Sie in der Grafik auf die Verbindung zwischen technischer Erreichbarkeit und der Qualität der enthaltenen URLs. Eine Sitemap ist erst dann hilfreich, wenn sie sowohl gültig ausgeliefert wird als auch relevante, indexierbare Seiten enthält.

Beim Prüfen der Sitemap geht es nicht nur darum, ob die Datei technisch erreichbar ist. Entscheidend ist, ob sie konsistente und tatsächlich wertvolle URLs enthält. Eine kurze, saubere Sitemap ist in der Regel nützlicher als eine sehr große Datei mit zahlreichen Weiterleitungen, Fehlerseiten oder irrelevanten Parametervarianten.

Prüfbereich Worauf Sie achten sollten Typische Maßnahme
Erreichbarkeit Die Datei liefert eine erfolgreiche HTTP-Antwort und ist öffentlich abrufbar. Server, URL und Zugriffsregeln kontrollieren.
Format Die XML-Struktur ist gültig und sauber codiert. XML-Validator oder Suchmaschinen-Tool verwenden.
URL-Auswahl Nur kanonische, indexierbare und relevante URLs sind enthalten. Weiterleitungen, Fehlerseiten und Ausschlussseiten entfernen.
Aktualität Neue, geänderte oder entfernte Inhalte werden korrekt berücksichtigt. Generierung und Aktualisierungslogik prüfen.
Abdeckung Wichtige Seitentypen werden vollständig erfasst. Stichproben mit Website-Struktur und Indexbericht vergleichen.
Technische Grenzen Datei- und URL-Grenzen werden eingehalten. Sitemap-Index für größere Websites einsetzen.

Erreichbarkeit und Statuscode kontrollieren

Rufen Sie die Sitemap direkt im Browser oder über ein technisches Prüfwerkzeug auf. Sie sollte ohne Anmeldung, Cookie-Abfrage oder JavaScript-Ausführung erreichbar sein. Prüfen Sie außerdem, ob die Datei den erwarteten Inhalt ausliefert und nicht versehentlich auf eine HTML-Fehlerseite, eine Startseite oder eine veraltete Domain weiterleitet.

Ein erfolgreicher Statuscode allein reicht nicht immer aus. Manche Server liefern bei nicht vorhandenen Dateien eine eigene Fehlerseite mit einem technisch erfolgreichen Statuscode aus. Deshalb sollte auch der Inhalt überprüft werden: Beginnt die Datei mit einer gültigen XML-Struktur und enthält sie die erwarteten Sitemap-Elemente?

XML-Syntax und Zeichencodierung prüfen

Eine Sitemap muss syntaktisch korrekt sein. Achten Sie unter anderem auf korrekt geschlossene Elemente, gültige URLs und eine passende Zeichencodierung. Sonderzeichen in URLs müssen korrekt behandelt werden. Auch unzulässige Steuerzeichen oder fehlerhafte Einträge können dazu führen, dass Teile der Datei nicht verarbeitet werden.

Die grundlegende Struktur einer URL-Sitemap sieht beispielsweise so aus:

<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://www.beispiel.de/wichtige-seite/</loc>
  </url>
</urlset>

Die Beispielstruktur ist bewusst einfach gehalten. Zusätzliche Elemente wie lastmod können sinnvoll sein, wenn der angegebene Änderungszeitpunkt zuverlässig gepflegt wird.

Welche URLs gehören in eine Sitemap?

Die zentrale Entscheidungsfrage lautet: Würde die Website diese URL einem Suchmaschinen-Crawler und einem potenziellen Besucher als eigenständige, wertvolle Seite empfehlen? Wenn die Antwort eindeutig Nein lautet, gehört die URL meist nicht in die Sitemap.

In der Regel sollten enthalten sein:

  • kanonische URLs mit dem bevorzugten Protokoll und Hostnamen,
  • öffentlich erreichbare Seiten mit relevantem, eigenständigem Inhalt,
  • indexierbare Kategorien, Produkte, Dienstleistungen oder Ratgeberseiten,
  • wichtige Seiten, die dauerhaft Bestandteil der Website bleiben,
  • aktualisierte URLs, wenn deren Inhalt tatsächlich überarbeitet wurde.

Eine URL sollte möglichst gleichzeitig mehrere Bedingungen erfüllen: Sie ist mit dem HTTP-Statuscode 200 erreichbar, nicht durch noindex ausgeschlossen, nicht per robots.txt blockiert und verweist über das Canonical-Element auf sich selbst oder wird von der Website als kanonische Variante behandelt.

Welche URLs sollten ausgeschlossen werden?

Häufige Kandidaten für den Ausschluss sind:

  • Weiterleitungsziele, wenn die alte URL selbst noch in der Sitemap steht,
  • 404- und 410-Seiten,
  • URLs mit noindex,
  • interne Suchergebnisse, Warenkörbe und Konto-Seiten,
  • Session-IDs und unnötige Tracking-Parameter,
  • technische Varianten mit falschem Protokoll oder falschem Hostnamen,
  • doppelte Inhalte ohne eigenständigen Suchwert,
  • unvollständige oder vorläufige Seiten.

Ein häufiger Fehler ist die automatische Aufnahme jeder URL, die ein Content-Management-System erzeugt. Dazu können beispielsweise Autorenarchive, Schlagwortseiten, Druckversionen, facettierte Filter oder paginierte Varianten gehören. Diese URL-Typen müssen nicht grundsätzlich ausgeschlossen werden. Entscheidend ist, ob sie einen eigenständigen Nutzen haben und bewusst indexiert werden sollen.

Die Sitemap.xml sinnvoll optimieren

Die Optimierung beginnt mit einer klaren Trennung zwischen wichtigen Inhalts-URLs und technischen Nebenprodukten. Ziel ist kein möglichst umfangreiches Verzeichnis, sondern ein verlässliches Signal über die Seiten, die Suchmaschinen tatsächlich berücksichtigen sollen.

Nur kanonische URLs verwenden

Wenn eine Seite unter mehreren Varianten erreichbar ist, sollte nur die bevorzugte Version in der Sitemap stehen. Typische Varianten entstehen durch HTTP und HTTPS, verschiedene Hostnamen, Groß- und Kleinschreibung, abschließende Schrägstriche oder Parameter. Legen Sie eine konsistente URL-Struktur fest und verwenden Sie sie überall: in der Sitemap, in Canonical-Tags, in internen Links und möglichst auch in Weiterleitungen.

Die Sitemap darf nicht als Ort dienen, an dem Suchmaschinen zwischen mehreren konkurrierenden URL-Varianten wählen müssen. Je klarer das Signal, desto leichter lässt sich die technische Struktur prüfen.

Das Änderungsdatum vorsichtig einsetzen

Das Element lastmod beschreibt, wann sich der Inhalt einer URL zuletzt wesentlich geändert hat. Es sollte nicht bei jedem automatischen Seitenaufruf oder jeder kleinen Systemänderung aktualisiert werden. Ein ständig wechselndes Datum ohne relevante Inhaltsänderung verliert an Aussagekraft.

Verwenden Sie lastmod vor allem dann, wenn die Daten zuverlässig aus dem Redaktionssystem stammen. Eine echte Überarbeitung eines Ratgebers, eine Änderung zentraler Produktinformationen oder eine wichtige Aktualisierung eines Leistungsangebots sind plausible Anlässe. Das Datum sollte sich auf den Inhalt beziehen, nicht lediglich auf das technische Erstellungsdatum einer neuen Sitemap-Datei.

Priorität und Änderungsfrequenz nicht überschätzen

Ältere Sitemap-Felder wie eine allgemeine Priorität oder eine Änderungsfrequenz werden von modernen Suchmaschinen nicht als verbindliche Steuerung verstanden. Sie ersetzen keine gute Informationsarchitektur und garantieren keinen häufigeren Crawl. Konzentrieren Sie sich daher auf korrekte URLs, verlässliche Änderungsdaten und eine sinnvolle Auswahl.

Sitemap-Index für umfangreiche Websites einsetzen

Große Websites können mehrere thematische oder technische Sitemaps verwenden, etwa getrennt nach Produkten, Ratgebern, Kategorien oder Sprachen. Ein Sitemap-Index bündelt diese Dateien. Das erleichtert die Wartung und ermöglicht eine gezielte Fehleranalyse.

Achten Sie auf eine verständliche Benennung. Eine Aufteilung nach Seitentypen kann sinnvoller sein als eine rein zufällige Aufteilung nach Dateigröße. Wenn bei einem Relaunch nur die Produkt-Sitemap fehlerhaft ist, lässt sich das Problem schneller eingrenzen, wenn die Struktur klar erkennbar ist.

Sitemap.xml und robots.txt richtig verbinden

Die robots.txt-Datei und die Sitemap erfüllen unterschiedliche Aufgaben. Die robots.txt kann das Crawling bestimmter Bereiche einschränken. Die Sitemap listet URLs auf, die als relevant und zugänglich betrachtet werden. Sie sollten deshalb keine URL in der Sitemap angeben, deren Abruf Sie gleichzeitig über robots.txt verhindern.

Ein Verweis in der robots.txt kann die Auffindbarkeit der Sitemap verbessern. Er kann beispielsweise auf die vollständige absolute URL der Sitemap oder des Sitemap-Index zeigen. Prüfen Sie dabei, dass der Hostname und das Protokoll genau zur Website passen.

Beachten Sie außerdem: Eine robots.txt-Sperre ist kein verlässlicher Ersatz für noindex, wenn eine URL aus dem Suchindex entfernt werden soll. Ist eine Seite bereits bekannt, kann eine reine Crawling-Sperre verhindern, dass Suchmaschinen das gewünschte Ausschlusssignal abrufen. Technische Maßnahmen sollten daher nach dem konkreten Ziel ausgewählt werden.

Sitemap in Suchmaschinen-Tools einreichen und überwachen

Reichen Sie die Sitemap beziehungsweise den Sitemap-Index in den passenden Verwaltungsoberflächen der Suchmaschinen ein. Das ist meist nur ein Hinweis und keine Garantie für Crawling oder Indexierung. Der Vorteil liegt vor allem in der Überwachung: Sie können erkennen, ob die Datei abgerufen wurde, ob Fehler gemeldet werden und wie sich bekannte URLs im Verhältnis zu den tatsächlich indexierten Seiten entwickeln.

Vergleichen Sie die Sitemap nicht unkritisch mit jeder URL, die in einem Indexbericht auftaucht. Suchmaschinen können URLs entdecken, die nicht in Ihrer Sitemap stehen, beispielsweise über interne oder externe Links. Umgekehrt kann eine URL in der Sitemap stehen, ohne indexiert zu werden. Diese Abweichung ist ein Anlass zur Analyse, aber nicht automatisch ein technischer Fehler.

Für eine belastbare Prüfung kombinieren Sie mehrere Perspektiven:

  • Sitemap-Inhalt und Sitemap-Fehlermeldungen,
  • Crawling- und Indexierungsberichte,
  • Server-Logs oder Crawling-Daten, sofern verfügbar,
  • interne Verlinkung und Website-Struktur,
  • Stichproben bei wichtigen Seitentypen,
  • Weiterleitungen, Canonical-Tags und Statuscodes.

Typische Fehler beim Prüfen und Optimieren

Die Sitemap enthält jede automatisch erzeugte URL

Eine automatische Generierung ist bequem, aber nicht automatisch sinnvoll. Prüfen Sie die Regeln des eingesetzten Systems. Manche Erweiterungen nehmen standardmäßig Archive, Filter oder Medienseiten auf, obwohl diese für die organische Suche keine eigenständige Rolle spielen sollen.

Die Datei ist aktuell, aber inhaltlich unzuverlässig

Eine täglich neu geschriebene Sitemap ist nicht automatisch besser. Wenn entfernte Seiten, alte Weiterleitungen oder falsche Änderungsdaten enthalten bleiben, entsteht ein dauerhaftes Qualitätsproblem. Entscheidend ist die Logik hinter der Generierung: Wird vor der Ausgabe geprüft, ob eine URL indexierbar, erreichbar und kanonisch ist?

Wichtige Seiten fehlen trotz vorhandener Sitemap

Manchmal wird nur die Startseite oder nur eine bestimmte Kategorie erfasst. Prüfen Sie deshalb nicht nur die Datei selbst, sondern auch die Seitentypen, die das System einbezieht. Ein Vergleich mit der XML-Struktur, der Navigation und einer repräsentativen URL-Liste zeigt häufig, ob Produkte, Beiträge, Landingpages oder regionale Seiten fehlen.

Sitemap und interne Links werden verwechselt

Eine URL in der Sitemap ist kein Ersatz für eine gute interne Verlinkung. Wichtige Seiten sollten über nachvollziehbare Menüs, Kategorien, kontextbezogene Links oder thematische Übersichten erreichbar sein. Die Sitemap kann die Entdeckung unterstützen, vermittelt aber nicht automatisch die inhaltliche Bedeutung einer Seite.

Nach dem Relaunch bleiben alte URLs enthalten

Bei Domainwechseln, Strukturänderungen und Migrationen sollte die Sitemap Bestandteil der Abnahmekontrolle sein. Entfernen Sie alte URLs, die dauerhaft weiterleiten oder nicht mehr existieren, und stellen Sie sicher, dass die neue Sitemap nur die aktuelle Zielstruktur enthält. Prüfen Sie außerdem, ob Verweise in der robots.txt und in Suchmaschinen-Tools aktualisiert wurden.

Praktische Checkliste für die regelmäßige Kontrolle

Eine wiederkehrende Prüfung muss nicht kompliziert sein. Die folgende Checkliste eignet sich als monatlicher oder anlassbezogener Ablauf:

  1. Öffnen Sie die Sitemap oder den Sitemap-Index direkt und kontrollieren Sie die Erreichbarkeit.
  2. Prüfen Sie die XML-Syntax und achten Sie auf Fehlermeldungen.
  3. Überprüfen Sie stichprobenartig wichtige URLs auf Statuscode, Canonical und Indexierbarkeit.
  4. Suchen Sie nach Weiterleitungen, Fehlerseiten, gesperrten URLs und noindex-Seiten.
  5. Vergleichen Sie die Sitemap mit den wichtigsten Seitentypen der Website.
  6. Kontrollieren Sie, ob neue Inhalte erscheinen und entfernte Inhalte verschwinden.
  7. Bewerten Sie die Aussagekraft der Änderungsdaten.
  8. Prüfen Sie Sitemap-Index, robots.txt und Einreichungen in den Suchmaschinen-Tools.
  9. Dokumentieren Sie größere Änderungen, etwa nach einem Relaunch oder einer CMS-Umstellung.

Für Websites mit vielen Veröffentlichungen, häufigen Produktänderungen oder mehreren Sprachversionen kann eine automatisierte Überwachung sinnvoll sein. Lassen Sie dabei nicht nur die Verfügbarkeit, sondern auch Stichproben der URL-Qualität und auffällige Mengenänderungen prüfen.

FAQ

Wie oft sollte man eine Sitemap.xml prüfen?

Für eine stabile kleine Website genügt meist eine regelmäßige Kontrolle in größeren Abständen sowie eine Prüfung nach wichtigen technischen Änderungen. Bei häufig aktualisierten oder großen Websites ist eine laufende beziehungsweise monatliche Überwachung sinnvoll. Nach einem Relaunch, einer Migration oder einer Änderung des CMS sollte die Sitemap sofort kontrolliert werden.

Garantiert eine Sitemap die Indexierung aller enthaltenen URLs?

Nein. Eine Sitemap ist ein Hinweis auf bevorzugte URLs, aber keine Indexierungsgarantie. Suchmaschinen bewerten zusätzlich Qualität, Einzigartigkeit, interne Verlinkung, technische Erreichbarkeit und weitere Signale. Wenn viele URLs aus der Sitemap nicht indexiert werden, sollten Sie die Auswahl und den Nutzen dieser Seiten prüfen.

Sollten Seiten mit „noindex“ in der Sitemap stehen?

In der Regel nicht. Die Sitemap sollte möglichst konsistent mit Ihrem Indexierungsziel sein. Wenn eine URL bewusst mit noindex versehen wurde, gehört sie normalerweise nicht in die Liste der URLs, die Sie als indexierbar empfehlen.

Kann eine Sitemap zu groß sein?

Ja. XML-Sitemaps unterliegen technischen Grenzen für Dateigröße und URL-Anzahl. Große Websites sollten deshalb einen Sitemap-Index und mehrere einzelne Dateien verwenden. Unabhängig von der Dateigröße ist eine überfüllte Sitemap mit irrelevanten URLs auch inhaltlich problematisch.

Ist eine HTML-Sitemap besser als eine XML-Sitemap?

Beide Formate haben unterschiedliche Aufgaben. Eine HTML-Sitemap kann Besuchern und Suchmaschinen bei der Navigation helfen und die interne Verlinkung verbessern. Eine XML-Sitemap ist dagegen speziell für maschinenlesbare URL-Hinweise gedacht. Je nach Website können beide Varianten sinnvoll sein.

Was bedeutet es, wenn eine Sitemap nicht alle indexierten URLs enthält?

Das ist nicht automatisch ein Fehler. Suchmaschinen können URLs über Links oder andere Signale entdecken. Die Sitemap sollte sich auf Ihre bevorzugten und relevanten URLs konzentrieren. Wenn wichtige Seiten fehlen, sollten Sie jedoch die Generierungsregeln und die technische Abdeckung überprüfen.

Wie erkennt man falsche lastmod-Daten?

Vergleichen Sie die angegebenen Änderungsdaten mit dem tatsächlichen Redaktionsverlauf oder dem Inhalt der Seiten. Wenn viele URLs dasselbe aktuelle Datum erhalten, obwohl sich ihre Inhalte nicht geändert haben, ist die Datenquelle wahrscheinlich zu pauschal. In diesem Fall sollte die Generierung auf echte Inhaltsänderungen abgestimmt werden.

Fazit: Sitemap.xml prüfen und optimieren

Eine gute Sitemap.xml ist übersichtlich, technisch gültig und auf die wirklich wichtigen URLs konzentriert. Prüfen Sie nicht nur, ob die Datei erreichbar ist, sondern auch, ob ihre Einträge mit Canonical-Tags, Statuscodes, Indexierungsregeln und der tatsächlichen Website-Struktur übereinstimmen. Entfernen Sie Weiterleitungen, Fehlerseiten und irrelevante technische Varianten. Nutzen Sie einen Sitemap-Index, wenn die Website umfangreich ist, und behandeln Sie Änderungsdaten mit der nötigen Sorgfalt.

Die beste Wirkung entsteht im Zusammenspiel mit einer klaren Informationsarchitektur, sinnvoller interner Verlinkung und hochwertigen Inhalten. Wer die Sitemap nach größeren Änderungen und in regelmäßigen Abständen kontrolliert, schafft ein verlässliches technisches Signal und erkennt Probleme meist, bevor sie die Auffindbarkeit wichtiger Seiten beeinträchtigen.
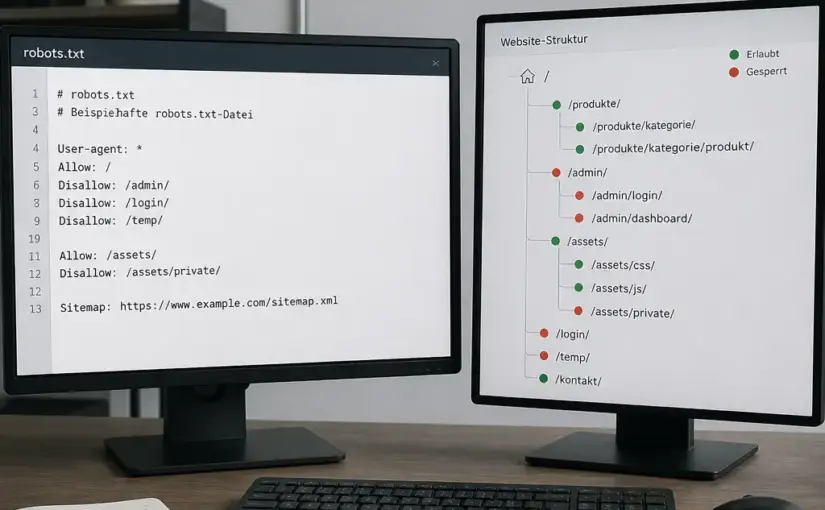
robots.txt prüfen und verstehen: Der umfassende Ratgeber für Website-Betreiber

Die Datei robots.txt gehört zu den kleinsten, aber häufig missverstandenen Bestandteilen einer Website. Sie kann Suchmaschinen-Crawlern Hinweise geben, welche Bereiche sie abrufen dürfen und welche nicht. Gleichzeitig ist sie weder ein sicherer Zugriffsschutz noch eine Garantie dafür, dass Seiten aus dem Suchindex verschwinden. Wer die Datei richtig einordnet, kann Crawling-Ressourcen gezielter steuern, typische SEO-Fehler vermeiden und technische Probleme schneller erkennen.

Dieser Ratgeber zeigt, wie Sie robots.txt prüfen und verstehen, welche Direktiven relevant sind, wie Sie die Datei testen und welche Grenzen sie hat. Die Beispiele sind bewusst allgemein gehalten, damit Sie die Regeln auf unterschiedliche Content-Management-Systeme und Hosting-Umgebungen übertragen können.

Was ist eine robots.txt?

Die Datei robots.txt ist eine einfache Textdatei im Hauptverzeichnis einer Website. Sie ist normalerweise unter dieser Adresse erreichbar:

https://www.beispiel.de/robots.txt

Ein Crawler ruft diese Datei ab, bevor er weitere URLs derselben Website crawlt. Darin können Regeln stehen, die sich an bestimmte Crawler oder an alle Crawler richten. Die Regeln beziehen sich vor allem darauf, welche Pfade ein Crawler abrufen soll oder nicht abrufen soll.

Wichtig ist die Unterscheidung zwischen Crawling und Indexierung. Crawling bedeutet, dass ein Bot eine URL abruft und ihren Inhalt verarbeitet. Indexierung bedeutet, dass eine Suchmaschine eine URL in ihren Suchindex aufnimmt und sie möglicherweise in den Suchergebnissen anzeigt. Eine Sperre in der robots.txt verhindert in erster Linie den Abruf. Sie ist keine zuverlässige Anweisung, eine bereits bekannte URL aus dem Index zu entfernen.

Die Datei ist öffentlich. Jeder kann sie aufrufen und ihren Inhalt lesen. Deshalb sollten Sie dort keine vertraulichen Verzeichnisse, internen Projektnamen oder Hinweise auf sensible Systembereiche aufführen, wenn diese Informationen nicht öffentlich sichtbar sein sollen.

Warum sollte man robots.txt prüfen und verstehen?

Eine fehlerhafte robots.txt kann dazu führen, dass wichtige Inhalte, Produktseiten, Kategorien oder JavaScript- und CSS-Dateien nicht wie erwartet gecrawlt werden. Ein versehentlich gesetztes Disallow: / würde beispielsweise den gesamten Abruf einer Website für den betroffenen Crawler blockieren. Umgekehrt kann eine sehr großzügige Konfiguration unnötige URL-Varianten, Suchergebnisse oder Filterkombinationen crawlen lassen.

Die Prüfung ist besonders sinnvoll, wenn eine Website neu veröffentlicht, migriert oder technisch umgebaut wurde. Auch nach Änderungen am Shopsystem, an einem SEO-Plugin, an der Domainstruktur oder an wichtigen Verzeichnissen lohnt sich ein Blick auf die Datei. Sie sollten außerdem kontrollieren, ob die Datei tatsächlich unter der richtigen Domain und mit dem erwarteten Statuscode erreichbar ist.

Typische Ziele einer Prüfung

  • prüfen, ob wichtige Inhalte versehentlich gesperrt werden;
  • unnötige Crawling-Pfade wie interne Suchseiten oder bestimmte Parameter begrenzen;
  • unbeabsichtigte Unterschiede zwischen www-, nicht-www-, HTTP- und HTTPS-Versionen erkennen;
  • eine Sitemap-URL korrekt bekannt machen;
  • Syntaxfehler und widersprüchliche Regeln identifizieren;
  • feststellen, ob eine robots.txt fälschlich als Zugriffsschutz verwendet wird.

Die wichtigsten Bestandteile einer robots.txt

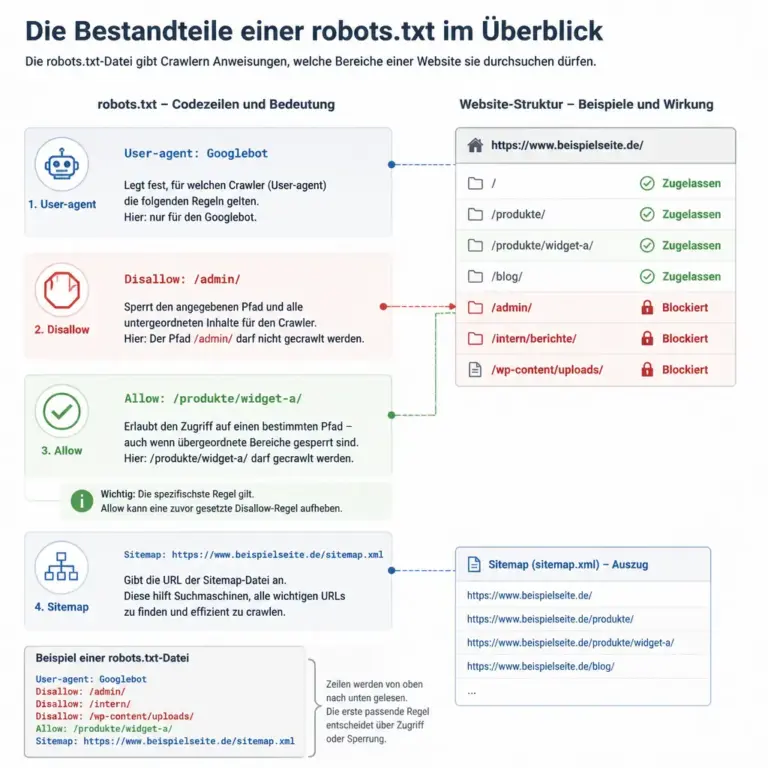
Die wichtigsten Direktiven einer robots.txt im u00dcberblick
Diese Übersicht zeigt, wie zentrale robots.txt-Direktiven zusammenspielen.

Achten Sie auf die Zuordnung zwischen einer Direktive und dem jeweiligen Pfad. Die Darstellung macht sichtbar, dass eine Regel nicht isoliert, sondern immer im Zusammenhang mit dem angesprochenen Crawler gelesen werden sollte.

Eine robots.txt besteht aus einzelnen Anweisungen. Die wichtigsten Elemente sind User-agent, Disallow, Allow und Sitemap. Leerzeilen werden häufig verwendet, um Regelgruppen übersichtlich voneinander zu trennen. Kommentare beginnen mit einem Doppelkreuz und werden von unterstützenden Crawlern ignoriert.

User-agent

Mit User-agent legen Sie fest, für welchen Crawler eine nachfolgende Regelgruppe gilt. Mit dem Sternchen sprechen Sie alle Crawler an:

User-agent: *

Daneben können einzelne Crawler gezielt angesprochen werden. Das ist jedoch nur sinnvoll, wenn Sie einen konkreten technischen Grund haben und genau wissen, wie der jeweilige Crawler seine Regeln verarbeitet. Unterschiedliche Suchmaschinen oder Spezial-Crawler können eigene Bezeichnungen und eigene Interpretationen verwenden.

Disallow

Disallow kennzeichnet einen Pfad, den der betreffende Crawler nicht abrufen soll. Ein leerer Wert bedeutet normalerweise, dass kein Pfad gesperrt wird:

User-agent: *
Disallow:

Ein Pfad mit einem abschließenden Schrägstrich bezieht sich typischerweise auf diesen Verzeichnisbereich und seine Unterpfade:

User-agent: *
Disallow: /admin/

Das ist nicht dasselbe wie ein sicherer Schutz des Verzeichnisses. Der Server kann die angeforderte Ressource weiterhin ausliefern, wenn jemand die URL direkt aufruft.

Allow

Allow kann verwendet werden, um innerhalb eines gesperrten Bereichs einen bestimmten Pfad wieder freizugeben. Die genaue Auswertung kann von der Crawler-Implementierung und von konkurrierenden Regeln abhängen. Deshalb sollten Ausnahmen möglichst klar und sparsam formuliert werden.

User-agent: *
Disallow: /intern/
Allow: /intern/oeffentliches-dokument.pdf

Wenn Regeln kompliziert werden, ist es oft besser, die URL-Struktur oder die technische Auslieferung zu vereinfachen. Eine kurze, verständliche Datei ist leichter zu warten als eine Sammlung vieler Ausnahmen.

Sitemap

Mit Sitemap können Sie Suchmaschinen auf eine XML-Sitemap hinweisen. Die vollständige absolute URL ist empfehlenswert:

Sitemap: https://www.beispiel.de/sitemap.xml

Eine Sitemap ist keine Erlaubnis zum Crawlen und ersetzt auch keine interne Verlinkung. Sie liefert lediglich eine zusätzliche Quelle für URLs, die eine Suchmaschine prüfen kann. In einer robots.txt können auch mehrere Sitemap-URLs angegeben werden, etwa wenn eine Website getrennte Sitemaps für Beiträge, Produkte und Kategorien verwendet.

So prüfen Sie Ihre robots.txt Schritt für Schritt

1. Die richtige Datei aufrufen

Rufen Sie die Datei direkt auf der betreffenden Host- und Protokollvariante auf. Eine robots.txt für https://www.beispiel.de gilt nicht automatisch für eine separate Subdomain wie https://shop.beispiel.de. Ebenso sollten Sie Weiterleitungen, unterschiedliche Domains und mögliche Staging-Umgebungen kontrollieren.

Prüfen Sie, ob die Antwort tatsächlich eine Textdatei mit den erwarteten Regeln ist. Eine HTML-Fehlerseite, ein Login, ein Serverfehler oder eine unerwartete Weiterleitung kann die Funktion beeinträchtigen. Eine temporäre Nichterreichbarkeit ist anders zu bewerten als eine bewusst leere Datei.

2. Inhalt und Format kontrollieren

Die Datei sollte gut lesbar sein und pro Zeile eine Anweisung enthalten. Achten Sie auf Tippfehler bei den Direktiven, überflüssige Leerzeichen, nicht beabsichtigte Sonderzeichen und Pfade, die nicht zur aktuellen Website-Struktur passen. Kommentare können erklären, warum eine Regel existiert und wer sie bei Änderungen überprüfen sollte.

Ein einfacher Anfang kann so aussehen:

User-agent: *
Disallow: /interne-suche/
Disallow: /konto/
Disallow: /warenkorb/
Sitemap: https://www.beispiel.de/sitemap.xml

Ob diese Regeln sinnvoll sind, hängt von Ihrer Website ab. Bei einer redaktionellen Website gibt es andere technische Bereiche als in einem Onlineshop. Übernehmen Sie Beispiele deshalb nicht blind.

3. Jede Regel auf wichtige URLs anwenden

Erstellen Sie eine kleine Liste wichtiger URL-Typen: Startseite, redaktioneller Beitrag, Produktseite, Kategorie, Bild- oder Dokumentseite sowie gegebenenfalls eine paginierte Übersichtsseite. Prüfen Sie anschließend, ob ein Disallow-Muster diese Pfade berührt. Besonders gefährlich sind sehr allgemeine Muster wie ein gesperrter Ordnername, der auch wichtige Inhalte enthält.

Denken Sie außerdem an Verzeichnisse für Ressourcen. Eine Suchmaschine muss nicht jede technische Datei indexieren, benötigt aber gegebenenfalls Zugriff auf Ressourcen, um eine Seite zu rendern und ihre Inhalte richtig zu verstehen. Sperren Sie CSS-, JavaScript- oder Bildpfade daher nicht pauschal, ohne die Auswirkungen zu prüfen.

4. Mit einem geeigneten Testwerkzeug nachprüfen

Für eine zusätzliche Kontrolle können Sie die Prüf- und Berichtsfunktionen der jeweiligen Suchmaschinen-Tools verwenden, sofern sie für Ihre Property verfügbar sind. Solche Werkzeuge helfen dabei, einzelne URLs gegen eine veröffentlichte robots.txt zu beurteilen. Sie ersetzen jedoch nicht die manuelle Prüfung der Datei und der tatsächlichen Serverantwort.

Testen Sie nicht nur eine Muster-URL. Ein erfolgreicher Test für eine Produktseite sagt wenig aus, wenn beispielsweise alle Kategorieseiten oder die Sitemap blockiert sind. Prüfen Sie repräsentative URL-Typen und wiederholen Sie die Kontrolle nach jeder Änderung.

Häufige Fehler und ihre Folgen

Die gesamte Website versehentlich sperren

Diese Regel ist besonders weitreichend:

User-agent: *
Disallow: /

Sie kann in einer Entwicklungsumgebung sinnvoll sein, ist für eine öffentlich auffindbare Produktionswebsite aber meist problematisch. Ein häufiger Fehler besteht darin, diese Einstellung beim Wechsel von Staging zu Live zu übernehmen. Kontrollieren Sie deshalb nach einem Launch sofort die robots.txt und wichtige URLs.

Wichtige Verzeichnisse blockieren

Ein Pfad wie /blog/, /content/ oder /produkte/ kann je nach Website zentrale Inhalte enthalten. Auch scheinbar technische Ordner können Bilder, Skripte oder andere Ressourcen bereitstellen. Prüfen Sie zuerst, welche Dateien und URL-Typen tatsächlich darunter liegen.

robots.txt mit noindex verwechseln

Die robots.txt ist kein zuverlässiger Ersatz für eine noindex-Anweisung. Wenn eine Suchmaschine eine URL nicht abrufen darf, kann sie deren Inhalt und ein dort gesetztes noindex unter Umständen nicht lesen. Für die Indexierungssteuerung müssen Sie die passende Methode verwenden, beispielsweise ein Robots-Meta-Element oder einen entsprechenden HTTP-Header, sofern der Crawler die Seite abrufen darf.

Wenn eine bereits indexierte URL dauerhaft aus den Suchergebnissen verschwinden soll, sind je nach Fall andere Maßnahmen erforderlich. Dazu gehören die korrekte Indexierungsanweisung, die Entfernung oder Weiterleitung des Inhalts und gegebenenfalls die Nutzung von Funktionen zur vorübergehenden Entfernung in den Webmaster-Werkzeugen.

Interne Suchseiten und Parameter unüberlegt blockieren

Interne Suchseiten, Sortierungen und Filter können eine große Zahl ähnlicher URLs erzeugen. Das kann ein berechtigter Anlass sein, bestimmte Pfade zu begrenzen. Eine pauschale Sperre nach einem allgemeinen Parameterzeichen kann jedoch auch wertvolle URLs treffen. Prüfen Sie zuerst, welche Parameter tatsächlich vorkommen und ob sie für Nutzer oder Suchmaschinen relevante Inhalte erzeugen.

Die Sitemap falsch eintragen

Eine Sitemap-Angabe mit Tippfehler, falscher Domain oder nicht erreichbarer Datei hilft nicht weiter. Die Sitemap sollte auf eine gültige, öffentlich abrufbare XML-Datei zeigen. Achten Sie bei mehreren Sprach- oder Domainvarianten darauf, dass die URL zur jeweiligen Website gehört und die enthaltenen URLs zur richtigen Property passen.

robots.txt als Zugriffsschutz: Was sie nicht kann

Die Datei richtet sich an kooperative Crawler. Sie verhindert nicht, dass Menschen eine URL aufrufen, und sie hält keinen böswilligen Bot zuverlässig auf. Auch sensible Daten, Backups, Zugangsdaten, interne Dokumente oder Verwaltungsoberflächen gehören nicht lediglich durch eine robots.txt geschützt ins Internet.

Für vertrauliche Bereiche benötigen Sie eine serverseitige Zugriffskontrolle, beispielsweise Authentifizierung, geeignete Berechtigungen oder eine Beschränkung auf ein internes Netzwerk. Zusätzlich sollten sensible Dateien gar nicht erst öffentlich gespeichert werden. Eine robots.txt darf höchstens ergänzend eingesetzt werden, nicht als Sicherheitsmaßnahme.

Beachten Sie auch, dass gesperrte URLs unter Umständen trotzdem bekannt werden können, etwa durch externe Verweise. Suchmaschinen können dann möglicherweise die URL, aber nicht den Inhalt anzeigen. Daraus folgt: Eine Sperre kann Sichtbarkeit nicht in jedem Fall verhindern.

Praktische Entscheidungsregeln für die eigene Website

Bevor Sie eine neue Regel hinzufügen, beantworten Sie einige konkrete Fragen:

  1. Welches Problem soll gelöst werden? Benennen Sie den konkreten URL-Bereich oder das Crawling-Problem.
  2. Welche URLs sind betroffen? Prüfen Sie echte Beispieladressen und nicht nur die Ordnerbezeichnung.
  3. Soll der Inhalt nicht gecrawlt oder nicht indexiert werden? Wählen Sie die Maßnahme nach dem Ziel aus.
  4. Ist die Sperre für alle Crawler notwendig? Eine allgemeine Regel ist weitreichender als eine gezielte Regel.
  5. Wie wird die Änderung kontrolliert? Legen Sie fest, welche URLs nach der Veröffentlichung getestet werden.
  6. Wer pflegt die Datei? Dokumentieren Sie Verantwortlichkeit und Anlass der Regel, damit sie nicht dauerhaft aus Gewohnheit bestehen bleibt.

In vielen Fällen ist eine saubere interne Verlinkung, eine konsistente URL-Struktur und eine korrekte Indexierungssteuerung nachhaltiger als eine lange Liste von Sperren. Die robots.txt sollte ein gezieltes technisches Werkzeug bleiben.

robots.txt nach einem Relaunch oder Domainwechsel prüfen

Bei einem Relaunch ändern sich häufig Verzeichnisse, Parameter, Weiterleitungen und Sitemap-Adressen gleichzeitig. Führen Sie die Prüfung deshalb als festen Bestandteil der technischen Abnahme durch. Kontrollieren Sie die Datei auf der produktiven Domain, testen Sie die wichtigsten URL-Typen und stellen Sie sicher, dass die Sitemap aktualisiert wurde.

Vergleichen Sie die neue Version mit der alten Datei, aber übernehmen Sie nicht automatisch jede historische Regel. Eine frühere Sperre kann für die neue Struktur falsch sein. Prüfen Sie außerdem, ob ein temporärer Schutz aus der Entwicklungsphase entfernt wurde und ob die Domain nicht versehentlich auf eine fremde oder nicht öffentliche Sitemap verweist.

Nach dem Launch sollten Sie die Berichte der Suchmaschinen beobachten. Ein einzelner Hinweis ist nicht immer ein Beweis für einen Fehler, aber wiederkehrende Crawling- oder Indexierungsprobleme verdienen eine genaue Untersuchung der betroffenen URLs, Serverantworten, Canonicals und robots.txt-Regeln.

FAQ

Wo muss die robots.txt liegen?

Sie gehört in das Hauptverzeichnis der jeweiligen Host- und Protokollvariante und sollte unter /robots.txt erreichbar sein. Eine Datei in einem Unterordner gilt nicht automatisch für die gesamte Domain. Für Subdomains muss die Konfiguration separat betrachtet werden.

Kann robots.txt eine Seite aus Google entfernen?

Eine Sperre verhindert in erster Linie den Abruf und ist keine zuverlässige Entfernung aus dem Index. Für eine kontrollierte Indexierung benötigen Sie eine passende Maßnahme, die der Crawler lesen kann, oder eine andere geeignete Entfernung beziehungsweise Deindexierung im jeweiligen Fall.

Ist eine leere robots.txt problematisch?

Eine leere Datei bedeutet üblicherweise, dass keine Pfade ausdrücklich gesperrt werden. Das kann für eine kleine Website völlig in Ordnung sein. Entscheidend ist, ob die Website besondere Crawling-Probleme hat und ob andere technische Maßnahmen die gewünschten Signale liefern.

Sollte ich CSS und JavaScript sperren?

Eine pauschale Sperre ist meist keine gute Idee. Suchmaschinen können Ressourcen benötigen, um Layout und Inhalte einer Seite zu verstehen. Prüfen Sie einzelne Pfade und sperren Sie nur Bereiche, deren Abruf tatsächlich unnötig ist und keine wichtige Darstellung oder Funktionsweise beeinflusst.

Wie oft sollte man robots.txt prüfen?

Eine feste monatliche Pflicht gibt es nicht. Sinnvoll ist eine Prüfung bei Relaunches, Migrationen, Änderungen am Shopsystem, Wechseln von SEO-Erweiterungen und auffälligen Crawling- oder Indexierungsdaten. Zusätzlich kann eine regelmäßige technische Checkliste helfen, unbemerkte Änderungen zu erkennen.

Kann ich mit robots.txt schädliche Bots blockieren?

Nur kooperative Bots können die Datei freiwillig beachten. Für unerwünschten oder missbräuchlichen Traffic benötigen Sie serverseitige oder vorgeschaltete Schutzmechanismen. Die robots.txt sollte nicht als Sicherheits- oder Lastschutz betrachtet werden.

Was bedeutet ein Pfad mit Schrägstrich am Ende?

Ein abschließender Schrägstrich beschreibt üblicherweise einen Verzeichnisbereich und seine Unterpfade. Ob ein konkretes Muster eine URL erfasst, hängt jedoch von der Schreibweise und der Auswertung des Crawlers ab. Testen Sie daher reale Beispiel-URLs, insbesondere bei ähnlichen Pfaden.

Fazit: robots.txt systematisch prüfen

Wer robots.txt prüfen und verstehen möchte, sollte nicht nur nach einer einzelnen fehlerhaften Zeile suchen. Entscheidend ist das Zusammenspiel aus URL-Struktur, Crawling, Indexierung, Ressourcen, Sitemaps und Zugriffsschutz. Rufen Sie die Datei auf der richtigen Domain auf, lesen Sie jede Regel im Kontext, testen Sie wichtige URL-Typen und dokumentieren Sie bewusst gesetzte Ausnahmen.

Eine gute robots.txt ist nicht möglichst lang, sondern nachvollziehbar und zielgerichtet. Verwenden Sie sie für begrenzte Crawling-Steuerung, aber nicht für vertrauliche Daten oder als Ersatz für noindex. Nach technischen Änderungen sollte die Prüfung Teil der Abnahme sein. So erkennen Sie verhinderte Crawling-Zugriffe früh und schaffen eine verlässlichere Grundlage für die technische Suchmaschinenoptimierung.

SEO-Probleme frühzeitig erkennen: Der praxisnahe Ratgeber für stabile Sichtbarkeit

SEO-Probleme entstehen selten erst in dem Moment, in dem eine Website vollständig aus den Suchergebnissen verschwindet. Häufig kündigen sich technische Fehler, Qualitätsprobleme oder Veränderungen bei der Suchintention bereits vorher an: wichtige Seiten verlieren Impressionen, neue Inhalte werden nicht indexiert oder Besucher verlassen bestimmte Bereiche ungewöhnlich schnell. Wer solche Signale regelmäßig beobachtet, kann Ursachen meist früher eingrenzen und gezielter reagieren.

Dieser Ratgeber zeigt, wie du SEO-Probleme frühzeitig erkennst, welche Prüfungen sich im Alltag bewährt haben und wie du Warnsignale nach Dringlichkeit bewertest. Im Mittelpunkt stehen nachvollziehbare Kontrollen statt kurzfristiger Tricks oder vorschneller Änderungen.

Warum eine frühe SEO-Diagnose wichtig ist

Organische Sichtbarkeit entwickelt sich durch das Zusammenspiel vieler Faktoren. Dazu gehören die technische Zugänglichkeit einer Website, die Qualität und Ausrichtung ihrer Inhalte, interne Verlinkungen, externe Signale und die Passung zur Suchanfrage. Ein einzelnes schwaches Signal muss nicht automatisch ein ernstes Problem bedeuten. Mehrere Veränderungen in dieselbe Richtung sind jedoch ein guter Anlass für eine Untersuchung.

Eine frühe Diagnose hat drei Vorteile:

  • Der Schaden bleibt begrenzt: Eine falsche Weiterleitung oder eine versehentlich gesetzte Sperre lässt sich leichter beheben, wenn sie schnell entdeckt wird.
  • Ursachen bleiben nachvollziehbar: Wenn Prüfungen und Änderungen dokumentiert werden, lässt sich besser erkennen, welche Maßnahme eine Entwicklung beeinflusst hat.
  • Ressourcen werden gezielter eingesetzt: Ein klarer Befund verhindert, dass Zeit in eine umfassende Überarbeitung investiert wird, obwohl nur ein technisches Detail fehlerhaft ist.

Wichtig ist eine saubere Trennung zwischen Beobachtung und Schlussfolgerung. Sinkende Klicks sind zunächst ein Signal. Erst der Vergleich mit Impressionen, Positionen, Suchanfragen, betroffenen URLs und technischen Daten zeigt, welche Erklärung plausibel ist.

Die wichtigsten Warnsignale im Überblick

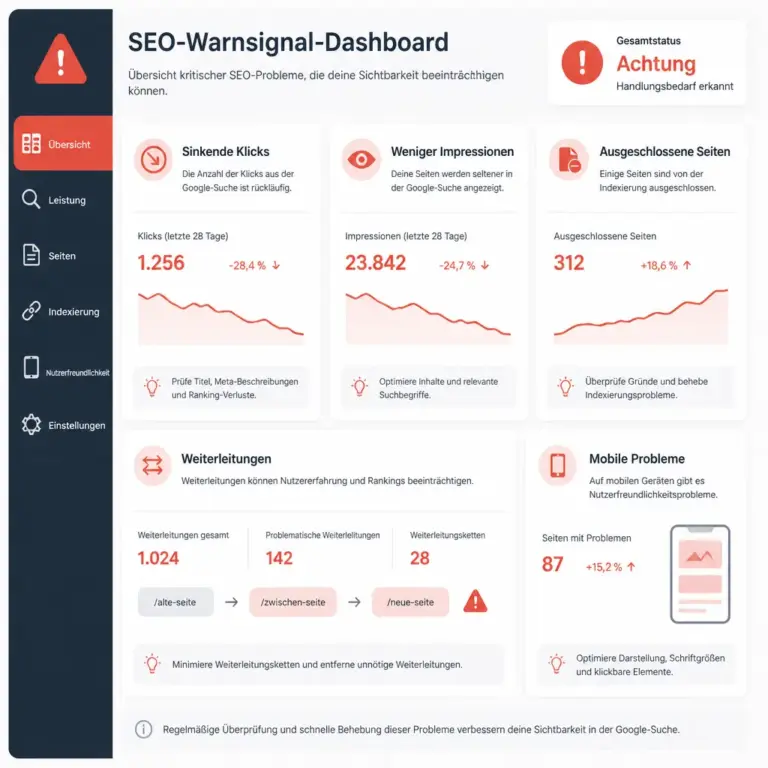
u00dcbersicht typischer Warnsignale bei SEO-Problemen
Typische Warnsignale helfen, SEO-Probleme systematisch einzuordnen.

Die Abbildung zeigt, dass ein einzelnes Signal selten die gesamte Diagnose erklärt. Erst das Zusammenspiel von Leistungsdaten, technischen Hinweisen und betroffenen URLs macht die nächste Prüfung sinnvoll.

SEO-Probleme können auf URL-Ebene, in einzelnen Verzeichnissen oder auf der gesamten Website auftreten. Die folgende Übersicht hilft bei einer ersten Einordnung:

Warnsignal Mögliche Ursache Erste Prüfung
Deutlich weniger Klicks Veränderte Rankings, geringere Nachfrage, schlechtere Darstellung oder technische Einschränkung Leistung nach Suchanfragen, Seiten und Gerät vergleichen
Weniger Impressionen Verlust von Rankings, Suchinteresse oder Indexierbarkeit Betroffene URLs und Zeiträume gegenüberstellen
Viele neue ausgeschlossene Seiten Fehlerhafte Canonicals, noindex-Anweisungen, Weiterleitungen oder Crawling-Probleme Indexierungsbericht und konkrete URLs prüfen
Ungewöhnlich viele Weiterleitungen Umzüge, Ketten, fehlerhafte interne Links oder wechselnde URL-Strukturen Weiterleitungsziele und Statuscodes kontrollieren
Sinkende Sichtbarkeit einzelner Inhalte Veraltete Inhalte, falsche Suchintention oder stärkere Konkurrenz Inhalt, Suchergebnisse und interne Verlinkung vergleichen
Schlechte mobile Nutzung Zu kleine Bedienelemente, überlappende Elemente oder lange Ladezeiten Mobile Darstellung auf realen Geräten und mit Berichten prüfen

Diese Signale sollten nicht isoliert bewertet werden. Ein saisonaler Rückgang kann beispielsweise völlig normal sein, während ein gleichzeitiger Verlust von Impressionen und eine fehlerhafte robots.txt-Datei eher auf ein technisches Problem hindeuten.

SEO-Daten richtig beobachten

Suchleistung nach Zeiträumen vergleichen

Ein einzelner Tageswert ist für eine SEO-Diagnose meist wenig aussagekräftig. Vergleiche längere Zeiträume und stelle ihnen einen passenden Vergleichszeitraum gegenüber. Bei saisonalen Themen kann ein Vergleich mit dem Vorjahr sinnvoller sein als der direkte Vergleich mit der Vorwoche.

Betrachte mindestens Klicks, Impressionen, durchschnittliche Position und Klickrate. Segmentiere die Daten zusätzlich nach Suchanfrage, Zielseite, Land, Gerät und Suchtyp, sofern diese Informationen verfügbar sind. Dadurch wird sichtbar, ob ein Problem die gesamte Website betrifft oder nur bestimmte Inhalte.

Veränderungen nicht vorschnell als Rankingverlust bewerten

Weniger Klicks können verschiedene Gründe haben. Fallen Impressionen und Positionen gemeinsam, ist ein Sichtbarkeitsverlust wahrscheinlich. Bleiben Impressionen stabil, sinkt aber die Klickrate, können Seitentitel, Snippets, SERP-Elemente oder die Konkurrenzdarstellung eine Rolle spielen. Steigt die durchschnittliche Position, ohne dass Klicks zunehmen, kann sich die Nachfrage verändert haben oder die Suchergebnisse können mehr direkte Antworten enthalten.

Notiere für auffällige Entwicklungen immer den Startzeitpunkt. Prüfe danach, ob an diesem Tag eine Website-Änderung, ein Relaunch, eine neue Weiterleitungsregel, eine Anpassung von Metadaten oder eine Veränderung des Angebots stattgefunden hat. So entsteht eine belastbare zeitliche Spur.

Technische SEO-Probleme frühzeitig erkennen

Indexierung und Crawling prüfen

Eine Seite kann nur organisch sichtbar werden, wenn Suchmaschinen sie finden, abrufen und für die Suche berücksichtigen können. Prüfe deshalb regelmäßig, ob wichtige URLs indexierbar sind. Dabei sollten insbesondere folgende Punkte kontrolliert werden:

  • Ist die URL mit einem erfolgreichen HTTP-Status erreichbar?
  • Verhindert eine robots.txt-Regel den Zugriff?
  • Enthält die Seite versehentlich ein noindex-Signal?
  • Zeigt das Canonical-Element auf die gewünschte URL?
  • Ist die URL in der XML-Sitemap enthalten, wenn sie indexiert werden soll?
  • Existieren interne Links, über die Suchmaschinen und Nutzer die Seite erreichen?

Ein einzelner Indexierungsbericht liefert nicht immer die vollständige Erklärung. Nutze die URL-Prüfung für repräsentative Beispiele und vergleiche wichtige Seiten mit ähnlichen, bereits sichtbaren URLs. Besonders kritisch sind Veränderungen, die viele Seiten derselben Vorlage betreffen.

Statuscodes, Weiterleitungen und Fehlerseiten

Ein 404-Fehler ist nicht grundsätzlich problematisch. Er kann korrekt sein, wenn eine Seite dauerhaft entfernt wurde und keine gleichwertige Alternative existiert. Kritisch wird es, wenn wichtige Inhalte unerwartet einen Fehler liefern, interne Links auf nicht vorhandene URLs zeigen oder mehrere Weiterleitungen hintereinander auftreten.

Prüfe bei einem URL-Wechsel, ob die alte Adresse direkt auf die fachlich passende neue Adresse weiterleitet. Vermeide Weiterleitungsketten und leite nicht pauschal jede alte URL auf die Startseite. Das erschwert Nutzern die Orientierung und kann die thematische Zuordnung verwässern.

Seitenerfahrung und Geschwindigkeit als Diagnose, nicht als Selbstzweck

Ladezeit und mobile Bedienbarkeit beeinflussen, ob Menschen eine Seite problemlos nutzen können. Sie sind deshalb wichtige Qualitäts- und Diagnoseaspekte. Prüfe nicht nur einen technischen Einzelwert, sondern die reale Nutzung verschiedener Seitentypen: Startseite, Kategorie, Ratgeber, Produktseite und Kontaktbereich können sich deutlich unterscheiden.

Achte auf große Bilder, unnötige Skripte, Layoutverschiebungen, blockierende Ressourcen und schlecht erreichbare Bedienelemente. Eine Optimierung sollte immer mit einem konkreten Nutzerproblem beginnen. Ein guter Messwert allein ersetzt keine Prüfung der tatsächlichen Darstellung.

Inhaltliche und strukturelle SEO-Probleme aufdecken

Suchintention und Inhalt abgleichen

Ein Inhalt kann fachlich korrekt sein und trotzdem für eine Suchanfrage nicht gut funktionieren. Prüfe, welches Ziel hinter der Anfrage steht: Sucht die Person eine Erklärung, einen Vergleich, eine Anleitung, eine konkrete Lösung oder eine Bezugsquelle? Der Inhalt sollte dieses Ziel früh erkennbar bedienen.

Vergleiche die eigene Seite mit den aktuellen Suchergebnissen, ohne andere Texte einfach nachzuahmen. Frage dich:

  • Beantwortet die Seite die zentrale Frage direkt?
  • Ist die erwartete Detailtiefe vorhanden?
  • Wird erklärt, für wen die Empfehlung oder Anleitung gilt?
  • Sind Grenzen, Voraussetzungen und mögliche Ausnahmen nachvollziehbar?
  • Führen interne Links zu weiterführenden Informationen?

Wenn sich die Suchintention verändert hat, reicht es häufig nicht, einzelne Schlüsselbegriffe zu ergänzen. Dann muss die Struktur des Inhalts angepasst werden.

Veraltete, dünne und doppelte Inhalte

Überarbeite zuerst Seiten, die für wichtige Themen Sichtbarkeit verloren haben und noch einen klaren Nutzen besitzen. Prüfe Aussagen, Beispiele, Screenshots, interne Links und Handlungsanweisungen. Entferne überholte Details, statt nur neue Absätze anzuhängen.

Dünne Inhalte sind nicht allein wegen ihrer Wortzahl problematisch. Entscheidend ist, ob sie die Frage ausreichend beantworten und einen eigenständigen Zweck erfüllen. Mehrere nahezu identische Seiten können Nutzer verwirren und die interne Struktur schwächen. Überlege, ob Inhalte zusammengeführt, klar voneinander abgegrenzt oder auf eine passende Hauptseite verwiesen werden sollten.

Titel, Überschriften und Snippets

Ein verständlicher Seitentitel beschreibt präzise, was die Seite bietet. Die wichtigste Information sollte nicht durch allgemeine Formulierungen verdeckt werden. Überschriften helfen Nutzern, den Inhalt zu scannen; sie sollten eine logische Hierarchie bilden und keine bloße Sammlung von Suchbegriffen sein.

Eine niedrige Klickrate ist ein Anlass, Titel und Beschreibung zu prüfen, aber kein Beweis, dass ausschließlich diese Elemente die Ursache sind. Berücksichtige auch Position, Suchintention, Markensignale und die Darstellung konkurrierender Ergebnisse.

Interne Verlinkung und Website-Struktur kontrollieren

Interne Links verbinden Inhalte, unterstützen die Navigation und helfen Suchmaschinen, thematische Zusammenhänge zu erkennen. Ein Warnsignal sind wichtige Seiten, die nur über die XML-Sitemap oder über eine Suche erreichbar sind, aber kaum redaktionelle Links erhalten.

Erstelle eine Liste der zentralen Themen und ordne ihnen passende Unterseiten zu. Prüfe anschließend:

  • Verlinken relevante ältere Beiträge auf neue, passende Inhalte?
  • Führen Links zu Seiten, die noch existieren und den erwarteten Inhalt liefern?
  • Sind Ankertexte verständlich und nicht übermäßig wiederholt?
  • Erreichen Nutzer wichtige Inhalte mit wenigen sinnvollen Schritten?
  • Gibt es verwaiste Seiten ohne redaktionelle interne Links?

Eine gute Struktur ist nicht möglichst tief oder möglichst flach. Sie sollte die Denkweise der Nutzer abbilden und wichtige Inhalte eindeutig priorisieren. Änderungen an Navigation, Kategorien oder URL-Struktur sollten deshalb geplant und dokumentiert werden.

Ein praktikabler Prüfprozess in fünf Schritten

1. Auffälligkeit beschreiben

Formuliere das Problem konkret: „Die Impressionen wichtiger Ratgeberseiten sinken seit einem bestimmten Zeitraum“ ist hilfreicher als „Die SEO ist schlechter geworden“. Ergänze betroffene URLs, Geräte, Länder und Suchanfragen.

2. Umfang feststellen

Prüfe, ob nur eine URL, ein Seitentyp, ein Verzeichnis oder die gesamte Website betroffen ist. Ein Problem in einer Vorlage kann viele URLs gleichzeitig beeinflussen. Ein einzelner Inhalt erfordert dagegen meist eine andere Analyse.

3. Technische Ursachen ausschließen

Kontrolliere Erreichbarkeit, Statuscode, Indexierungsanweisungen, Canonical, interne Verlinkung und Sitemap. Führe diese Prüfung vor größeren redaktionellen Änderungen durch. Andernfalls kann ein technischer Fehler durch neue Inhalte verdeckt werden.

4. Inhalt und Suchergebnisse bewerten

Untersuche Suchintention, Aktualität, Verständlichkeit, Vollständigkeit und Nutzbarkeit. Schaue dir die Suchergebnisse zu wichtigen Suchanfragen an und notiere, welche Erwartungen dort sichtbar werden.

5. Eine Änderung nach der anderen dokumentieren

Lege fest, was geändert wird, warum die Änderung notwendig ist und woran der Erfolg gemessen werden soll. Vermeide es, gleichzeitig URL-Struktur, Seitentitel, Inhalt und interne Verlinkung umzubauen, wenn du die Ursache einer Entwicklung verstehen möchtest. Nach der Umsetzung braucht es eine angemessene Beobachtungsphase.

Welche SEO-Probleme haben Priorität?

Nicht jede Warnung verlangt sofort eine umfassende Maßnahme. Eine einfache Priorisierung berücksichtigt vier Fragen:

  1. Wie groß ist die betroffene Reichweite? Ein Fehler auf vielen wichtigen Seiten ist dringlicher als ein Detail auf einer kaum besuchten URL.
  2. Wie wichtig ist die betroffene Seite für das Geschäfts- oder Informationsziel? Eine zentrale Leistungsseite verdient besondere Aufmerksamkeit.
  3. Wie sicher ist die Diagnose? Ein belegter noindex-Fehler ist anders zu behandeln als eine Vermutung über veränderte Suchintention.
  4. Wie hoch ist das Risiko der Gegenmaßnahme? Große Umzüge oder Löschungen sollten sorgfältiger vorbereitet werden als eine Korrektur eines falschen Links.

Akute technische Blockaden, falsche Weiterleitungen und versehentlich ausgeschlossene Kernseiten gehören meist an den Anfang. Danach folgen strukturelle Probleme wie verwaiste Inhalte oder doppelte URL-Varianten. Inhaltliche Verbesserungen können parallel geplant, aber nach ihrer erwarteten Wirkung priorisiert werden.

Häufige Fehler bei der SEO-Diagnose

  • Nur Rankings betrachten: Rankings schwanken. Ergänze sie durch Klicks, Impressionen, Suchanfragen und technische Daten.
  • Zu schnell alles ändern: Viele gleichzeitige Änderungen machen die Ursachenanalyse schwierig.
  • Jeden Rückgang als Strafe interpretieren: Nachfrage, Wettbewerb, Saison und Suchergebnisdarstellung können sich ebenfalls verändern.
  • Nur die Startseite prüfen: Probleme liegen oft in Templates, Kategorien, mobilen Ansichten oder einzelnen Verzeichnissen.
  • Inhalte mit Suchbegriffen überladen: Verständlichkeit und tatsächlicher Nutzen sind wichtiger als künstliche Wiederholungen.
  • Warnungen ungeprüft automatisieren: Ein Tool kann auf eine mögliche Ursache hinweisen, aber nicht jede Empfehlung passt zur Website.

Eine gute SEO-Diagnose verbindet automatisierte Hinweise mit manueller Prüfung. Entscheidend ist nicht die Zahl der gefundenen Warnungen, sondern ob daraus eine nachvollziehbare, risikoarme Handlung entsteht.

FAQ

Wie oft sollte ich eine Website auf SEO-Probleme prüfen?

Die Häufigkeit hängt von Größe, Änderungsrate und Bedeutung der Website ab. Leistungsdaten können regelmäßig beobachtet werden; eine ausführliche technische Prüfung ist besonders nach Relaunches, größeren Template-Änderungen oder URL-Umzügen sinnvoll. Kleine Websites profitieren ebenfalls von einem festen Prüfintervall, damit Auffälligkeiten nicht über Monate unbemerkt bleiben.

Was ist der erste Schritt bei plötzlich sinkender Sichtbarkeit?

Bestätige zunächst den Zeitraum und den Umfang des Rückgangs. Vergleiche Klicks, Impressionen und Positionen nach Seiten und Suchanfragen. Prüfe anschließend, ob wichtige URLs erreichbar, indexierbar und korrekt verlinkt sind. Erst danach solltest du umfassende inhaltliche Änderungen planen.

Ist ein 404-Fehler immer ein SEO-Problem?

Nein. Eine nicht mehr vorhandene URL kann korrekt einen 404-Status liefern. Problematisch ist der Fehler, wenn die Seite weiterhin benötigt wird, viele interne Links auf sie zeigen oder eine fachlich passende neue Adresse existiert. Dann sollte die Ursache behoben oder eine sinnvolle Weiterleitung geprüft werden.

Wie erkenne ich, ob ein Inhalt veraltet ist?

Prüfe, ob Fakten, Beispiele, Empfehlungen, Screenshots und Links noch stimmen. Vergleiche außerdem die aktuelle Suchintention mit dem Inhalt. Ein Beitrag kann auch ohne sichtbare Datumsangabe veraltet sein, wenn sich Verfahren, Produkte oder Erwartungen der Nutzer verändert haben.

Welche Rolle spielt die Klickrate?

Die Klickrate zeigt, wie häufig ein Ergebnis im Verhältnis zu seinen Impressionen angeklickt wird. Sie sollte immer zusammen mit Position, Suchanfrage und Suchergebnisdarstellung betrachtet werden. Eine niedrige Klickrate kann auf einen unklaren Titel hindeuten, aber auch durch eine stark umkämpfte Suchanfrage oder zusätzliche Suchfunktionen entstehen.

Soll ich bei SEO-Problemen zuerst technische oder inhaltliche Änderungen vornehmen?

Schließe zunächst grundlegende technische Blockaden aus. Wenn eine Seite nicht erreichbar oder nicht indexierbar ist, bringt eine inhaltliche Überarbeitung wenig. Sind diese Punkte unauffällig, kannst du Suchintention, Qualität, Aktualität und interne Verlinkung untersuchen.

Wann ist professionelle Unterstützung sinnvoll?

Unterstützung kann sinnvoll sein, wenn ein Relaunch ansteht, viele URLs betroffen sind, die Ursachen unklar bleiben oder Änderungen ein hohes Risiko für wichtige Inhalte haben. Gute Unterstützung sollte Befunde verständlich erklären, Prioritäten begründen und zwischen gesicherten Fakten und Hypothesen unterscheiden.

Fazit: SEO-Probleme mit System frühzeitig erkennen

SEO-Probleme frühzeitig zu erkennen bedeutet nicht, jede kleine Schwankung zu bekämpfen. Es geht darum, relevante Veränderungen systematisch zu beobachten, ihren Umfang zu bestimmen und technische, inhaltliche sowie strukturelle Ursachen voneinander zu trennen. Ein fester Prüfprozess, dokumentierte Änderungen und eine klare Priorisierung schaffen dafür die Grundlage.

Beginne mit den wichtigsten Seiten und realen Nutzungssituationen. Prüfe zuerst, ob Suchmaschinen und Menschen die Inhalte zuverlässig erreichen. Bewerte danach Suchintention, Aktualität und interne Verbindungen. So entstehen Maßnahmen, die nicht nur kurzfristig Kennzahlen verbessern sollen, sondern die Website dauerhaft verständlicher, zugänglicher und hilfreicher machen.

Technische Website-Analyse im Überblick: Grundlagen, Ablauf und Prioritäten

Eine Website kann inhaltlich überzeugend sein und trotzdem Besucher verlieren, wenn technische Hindernisse die Nutzung oder das Crawling erschweren. Lange Ladezeiten, fehlerhafte Weiterleitungen, unklare interne Verlinkungen oder schlecht eingebundene mobile Ansichten bleiben im Alltag oft unbemerkt. Eine technische Website-Analyse macht solche Zusammenhänge sichtbar und schafft eine belastbare Grundlage für Verbesserungen.

Dieser Ratgeber erklärt, welche Bereiche dazugehören, wie eine Analyse sinnvoll abläuft und wie sich die gefundenen Aufgaben nach Aufwand und Wirkung ordnen lassen. Im Mittelpunkt steht nicht eine möglichst lange Liste von Warnungen, sondern die Frage: Welche technischen Änderungen helfen den Nutzern, Suchmaschinen und den Zielen der Website tatsächlich?

Was bedeutet technische Website-Analyse?

Bei einer technischen Website-Analyse wird untersucht, ob eine Website technisch erreichbar, verständlich strukturiert, sicher, mobil nutzbar und für Suchmaschinen sinnvoll zugänglich ist. Dabei werden sowohl einzelne Seiten als auch websiteweite Einstellungen betrachtet. Die Analyse kann eine kleine Unternehmenswebsite, einen Onlineshop, ein Magazin oder eine umfangreiche Plattform betreffen.

Technische Faktoren sind kein Ersatz für gute Inhalte. Sie schaffen vielmehr die Voraussetzungen dafür, dass Inhalte gefunden, geladen, verstanden und genutzt werden können. Ein hervorragender Artikel hilft wenig, wenn die wichtigste Version der Seite nicht erreichbar ist oder zentrale Inhalte nur nach einer unzuverlässigen Skriptausführung erscheinen.

Welche Ziele verfolgt die Analyse?

  • Erreichbarkeit: Besucher und Suchmaschinen sollen die relevanten Seiten zuverlässig aufrufen können.
  • Verständlichkeit: Struktur, Links und technische Signale sollen eindeutig sein.
  • Nutzbarkeit: Die Website soll auf unterschiedlichen Geräten und bei verschiedenen Verbindungsgeschwindigkeiten funktionieren.
  • Indexierbarkeit: Suchmaschinen sollen wichtige Inhalte entdecken, abrufen und der richtigen URL zuordnen können.
  • Sicherheit: Übertragung, Zugänge und technische Abhängigkeiten sollen angemessen geschützt sein.
  • Wartbarkeit: Änderungen sollen nachvollziehbar und ohne unnötige Folgerisiken möglich sein.

Die wichtigsten Prüfbereiche

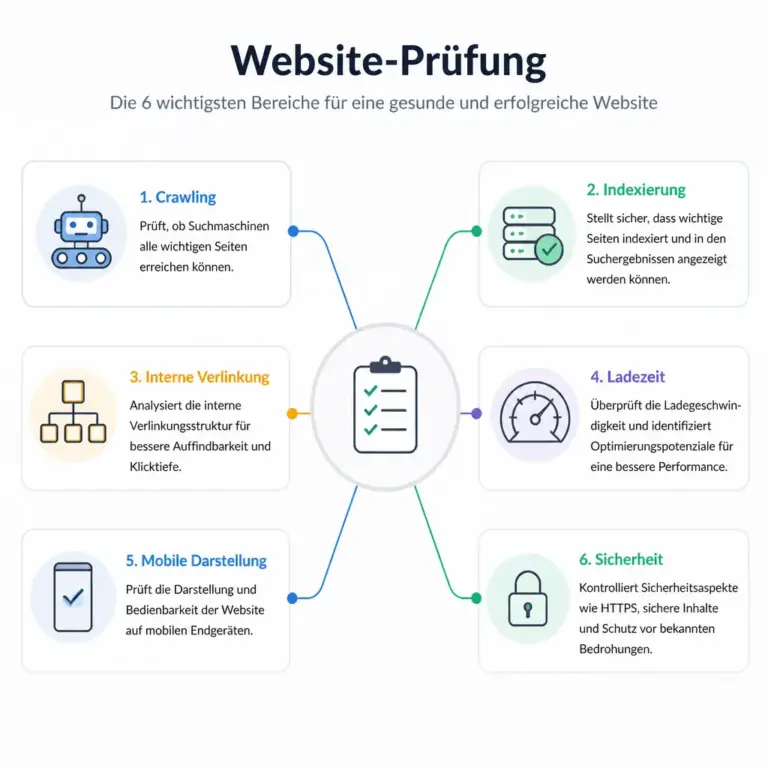
Die zentralen Pru00fcfbereiche einer technischen Website-Analyse
Eine technische Website-Analyse verbindet mehrere Prüfbereiche zu einem Gesamtbild.

Die Grafik zeigt, warum eine technische Prüfung nicht nur aus einem einzelnen Geschwindigkeitswert besteht. Leser erkennen auf einen Blick, wie Crawling, Struktur, Leistung und Sicherheit zusammenwirken.

Eine gute technische Website-Analyse betrachtet nicht nur einen einzelnen Messwert. Sie verbindet mehrere Prüfbereiche, weil technische Probleme häufig zusammenhängen. Eine langsame Seite kann beispielsweise durch große Bilder, ein überladenes Skript, einen langsamen Server oder eine ungünstige Einbindung externer Dienste entstehen.

1. Crawling und Indexierung

Zuerst sollte geklärt werden, welche URLs existieren, welche davon erreichbar sind und welche Seiten von Suchmaschinen aufgenommen werden sollen. Wichtige Prüfpunkte sind unter anderem:

  • Antwortcodes wie 200, 301, 302, 404 oder 5xx
  • Weiterleitungsketten und Weiterleitungsschleifen
  • Robots.txt und versehentlich gesperrte Verzeichnisse
  • Meta-Robots-Anweisungen wie noindex
  • XML-Sitemap und darin enthaltene URLs
  • kanonische Verweise bei ähnlichen oder mehrfach erreichbaren Inhalten
  • verwaiste Seiten ohne interne Links
  • Parameter, Filter-URLs und unnötige URL-Varianten

Besonders wichtig ist die Unterscheidung zwischen „technisch auffällig“ und „geschäftlich relevant“. Eine Website kann viele alte oder absichtlich ausgeschlossene URLs enthalten, ohne dass daraus ein dringendes Problem entsteht. Priorität haben zunächst wichtige Seiten, die trotz ihrer Bedeutung nicht erreichbar, nicht verlinkt oder unerwünscht aus dem Index ausgeschlossen sind.

2. Website-Struktur und interne Verlinkung

Die Informationsarchitektur zeigt, wie Themen, Kategorien und einzelne Seiten zusammenhängen. Eine klare Struktur hilft Menschen bei der Orientierung und erleichtert Suchmaschinen die Einordnung. Prüfen Sie, ob wichtige Inhalte mit wenigen sinnvollen Klicks erreichbar sind und ob die Linktexte verständlich beschreiben, wohin ein Link führt.

Interne Links sollten nicht ausschließlich auf die Startseite oder wenige besonders alte Beiträge zeigen. Sie können Nutzer zu ergänzenden Erklärungen, passenden Produkten, Kontaktmöglichkeiten und weiterführenden Ratgebern führen. Gleichzeitig sollte jede Verlinkung einen nachvollziehbaren Zweck haben. Eine große Zahl bedeutungsloser oder automatisch erzeugter Links verbessert die Orientierung nicht.

3. Ladezeit und technische Leistung

Die wahrgenommene Geschwindigkeit hängt von mehreren Faktoren ab: Serverantwort, HTML-Auslieferung, Bilder, Schriftdateien, JavaScript, CSS und nachgeladene Inhalte. Eine Messung sollte deshalb nicht bei einer einzelnen Punktzahl enden. Entscheidend ist, welche Ressource den Seitenaufbau bremst und ob diese Ressource für die eigentliche Nutzung notwendig ist.

Typische Ansatzpunkte sind:

  • Bilder in passenden Abmessungen und modernen, browsergeeigneten Formaten ausliefern
  • nicht benötigte Skripte entfernen oder später laden
  • kritische Styles gezielt priorisieren
  • Weiterleitungen bei wichtigen Einstiegsseiten reduzieren
  • Server- und Datenbankabfragen prüfen
  • Zwischenspeicherung sinnvoll konfigurieren
  • externe Dienste wie Schriftanbieter, Analysewerkzeuge oder Chatfunktionen kritisch bewerten

Die Geschwindigkeit sollte auf realistischen Geräten und unter unterschiedlichen Netzwerkbedingungen betrachtet werden. Eine Seite, die auf einem leistungsfähigen Bürorechner schnell wirkt, kann auf einem älteren Mobilgerät deutlich schwerfälliger sein.

4. Mobile Darstellung und Bedienbarkeit

Eine technische Analyse muss mobile Ansichten ausdrücklich einbeziehen. Prüfen Sie Lesbarkeit, Abstände, Navigation, Formulare, Tabellen, Bilder und interaktive Elemente. Inhalte sollten nicht horizontal aus dem Bildschirm laufen. Schaltflächen und Links müssen gut erkennbar und mit dem Finger zuverlässig bedienbar sein.

Die mobile Prüfung ist nicht nur eine Frage des Layouts. Auch Pop-ups, Cookie-Einstellungen, eingebettete Inhalte und komplexe Menüs können die Nutzung erheblich erschweren. Eine funktionierende Desktopversion sagt daher wenig über die Qualität der mobilen Erfahrung aus.

5. HTML, Metadaten und semantische Signale

Sauber strukturiertes HTML unterstützt sowohl die Nutzung als auch die technische Verarbeitung. Achten Sie auf eine logische Überschriftenhierarchie, aussagekräftige Seitentitel, passende Meta-Beschreibungen und eindeutige Sprachangaben. Überschriften sollten die inhaltliche Gliederung abbilden und nicht nur wegen ihrer Schriftgröße verwendet werden.

Strukturierte Daten können Suchmaschinen zusätzliche Informationen zu bestimmten Inhaltstypen geben. Sie sind jedoch kein Ersatz für korrekte sichtbare Inhalte. Markierungen müssen zum tatsächlichen Seiteninhalt passen. Unzutreffende oder übertriebene Auszeichnungen können Vertrauen beeinträchtigen und sollten vermieden werden.

6. Sicherheit, Datenschutz und technische Abhängigkeiten

Eine Website-Analyse sollte auch sicherheitsrelevante Grundlagen berücksichtigen. Dazu zählen eine korrekt eingerichtete verschlüsselte Verbindung, aktuelle Software, sichere Administrationszugänge und ein kontrollierter Umgang mit Drittanbietern. Welche Datenschutzanforderungen gelten, hängt vom Projekt, den eingesetzten Diensten und dem jeweiligen Nutzungsszenario ab. Eine technische Prüfung ersetzt deshalb keine rechtliche Beratung.

Prüfen Sie außerdem, welche externen Ressourcen geladen werden, ob sie für die Kernfunktion erforderlich sind und ob Ausfälle einzelner Anbieter die gesamte Seite beeinträchtigen. Je mehr Abhängigkeiten bestehen, desto wichtiger sind Dokumentation, Überwachung und ein sinnvoller Notfallplan.

So läuft eine technische Website-Analyse ab

Ein klarer Ablauf verhindert, dass einzelne Warnungen überbewertet werden. Die folgenden Schritte eignen sich als allgemeines Vorgehen und können je nach Websitegröße vertieft werden.

1. Ziel und Umfang festlegen

Definieren Sie zunächst, was untersucht werden soll. Geht es um einen allgemeinen Gesundheitscheck, einen Relaunch, einen Plattformwechsel, sinkende organische Sichtbarkeit oder konkrete Ladeprobleme? Legen Sie außerdem den Umfang fest: gesamte Domain, ausgewählte Verzeichnisse, mobile Version, internationale Varianten oder bestimmte Seitentypen.

Ohne diese Abgrenzung entsteht leicht ein Bericht, der viele technische Details enthält, aber keine klare Entscheidung unterstützt. Ein Onlineshop benötigt beispielsweise besondere Aufmerksamkeit für Filter, Produktvarianten, Warenkorb und Checkout, während bei einer kleinen Unternehmenswebsite die Kontakt- und Leistungsseiten im Vordergrund stehen können.

2. Bestandsaufnahme durchführen

Erfassen Sie die wichtigsten technischen Rahmenbedingungen: Content-Management-System, Hosting, verwendete Erweiterungen, Domains, Subdomains, Sprachversionen und relevante Vorfälle. Fragen Sie auch nach geplanten Änderungen. Ein bevorstehender Relaunch verändert die Prioritäten, weil manche Reparaturen besser direkt in der neuen Struktur umgesetzt werden.

Ergänzen Sie automatisierte Crawling- und Messverfahren durch manuelle Kontrollen. Werkzeuge können viele URLs schnell vergleichen, erkennen aber nicht zuverlässig, ob ein Kontaktweg verständlich ist, ob ein Hinweis irritiert oder ob eine wichtige Seite aus geschäftlicher Sicht fehlt.

3. Befunde prüfen und einordnen

Nicht jede Meldung eines Werkzeugs ist ein Fehler. Prüfen Sie zunächst, ob der Befund reproduzierbar ist und welche URLs tatsächlich betroffen sind. Danach folgen die Fragen:

  • Welche Nutzer oder Suchmaschinenprozesse sind betroffen?
  • Handelt es sich um eine wichtige oder eine nebensächliche Seite?
  • Entsteht ein konkreter Verlust an Zugänglichkeit, Verständlichkeit oder Vertrauen?
  • Kann die Änderung Nebenwirkungen auf andere Bereiche haben?
  • Wie hoch sind Aufwand, Abhängigkeiten und erforderliches Fachwissen?

Diese Einordnung trennt echte Handlungsfelder von rein kosmetischen Empfehlungen. Sie schützt auch vor vorschnellen Änderungen an funktionierenden URL-Strukturen.

4. Maßnahmen priorisieren

Eine praktikable Priorisierung kombiniert Wirkung, Reichweite, Dringlichkeit und Aufwand. Kritische Fehler wie eine nicht erreichbare Startseite, versehentlich blockierte wichtige Inhalte oder fehlerhafte Sicherheitskonfigurationen gehören in der Regel nach oben. Danach folgen Verbesserungen, die viele Nutzer betreffen oder mehrere Probleme gleichzeitig lösen.

Priorität Typischer Befund Erster Schritt
Hoch Wichtige Seiten sind nicht erreichbar oder werden unerwünscht ausgeschlossen. Betroffene URLs, Regeln und Weiterleitungen sofort prüfen und korrigieren.
Hoch Die mobile Nutzung oder ein zentraler Prozess ist deutlich beeinträchtigt. Den kritischen Nutzungspfad auf mehreren Geräten nachvollziehen.
Mittel Langsame Ressourcen oder unnötige technische Abhängigkeiten bremsen viele Seiten. Verursacher messen und nach Wirkung sortiert optimieren.
Mittel Interne Verlinkung und Seitensignale sind uneinheitlich. Vorlage, Navigationslogik und wichtige Seitentypen vereinheitlichen.
Niedrig Kleine formale Abweichungen ohne erkennbare Auswirkung. Bei Gelegenheit bündeln oder im Rahmen einer größeren Änderung bearbeiten.

5. Änderungen kontrolliert umsetzen

Technische Änderungen sollten möglichst zuerst in einer geeigneten Testumgebung geprüft werden. Sichern Sie relevante Konfigurationen und dokumentieren Sie, was wann geändert wurde. Bei Weiterleitungen, Canonicals, robots.txt und strukturellen Umbauten ist besondere Vorsicht nötig, weil kleine Fehler große Teile einer Website beeinflussen können.

Nach dem Rollout sollten die wichtigsten URLs, Formulare, Navigationen, mobilen Ansichten und Messungen erneut kontrolliert werden. Ein Befund ist erst dann erledigt, wenn die zugrunde liegende Ursache behoben und die Wirkung nachvollziehbar ist.

Werkzeuge sinnvoll einsetzen

Technische Website-Analyse profitiert von einer Kombination aus Werkzeugen und menschlicher Bewertung. Crawler liefern eine Übersicht über URLs, Statuscodes, Metadaten, Links und wiederkehrende Muster. Browser- und Netzwerkwerkzeuge zeigen, welche Ressourcen geladen werden und wann sie den Seitenaufbau beeinflussen. Serverprotokolle können Hinweise geben, welche Bots oder Nutzer auf Fehler stoßen.

Für die Überwachung sind Such- und Analyseplattformen, Fehlerprotokolle, Verfügbarkeitsprüfungen und Leistungsberichte hilfreich. Entscheidend ist nicht, möglichst viele Werkzeuge parallel zu verwenden. Besser ist eine überschaubare Auswahl mit klarer Zuständigkeit, regelmäßiger Auswertung und dokumentierten Schwellenwerten.

Automatisierte Berichte sollten immer mit Stichproben ergänzt werden. Ein Tool kann beispielsweise eine fehlende Beschreibung melden, obwohl die betreffende Seite bewusst nicht für Suchmaschinen gedacht ist. Umgekehrt kann ein formal korrekter Statuscode eine schlechte Nutzerführung nicht ausschließen.

Häufige Fehler bei der technischen Analyse

  • Nur auf eine Punktzahl schauen: Ein Gesamtwert erklärt selten die Ursache eines Problems. Einzelne wichtige Befunde müssen separat bewertet werden.
  • Alle Warnungen gleich behandeln: Kritikalität, Reichweite und geschäftliche Bedeutung sind wichtiger als die Anzahl der Meldungen.
  • Desktop als Standard nehmen: Mobile Geräte, Touchbedienung und langsamere Verbindungen gehören in jede realistische Prüfung.
  • Weiterleitungen vorschnell entfernen: Alte externe Links und bestehende Sichtbarkeit können von korrekt gesetzten Weiterleitungen abhängen.
  • Technik und Inhalt trennen: Eine technische Änderung kann die Darstellung, Auffindbarkeit oder Verständlichkeit von Inhalten beeinflussen.
  • Nach der Umsetzung nicht nachprüfen: Ohne Kontrolle bleibt unklar, ob die Ursache behoben wurde oder ein neues Problem entstanden ist.
  • Unklare Verantwortung: Jede Maßnahme sollte eine zuständige Person, einen Termin und ein überprüfbares Ergebnis haben.

Ergebnisse verständlich dokumentieren

Ein hilfreicher Bericht richtet sich nicht nur an technisch versierte Personen. Er sollte kurz erklären, was festgestellt wurde, warum es relevant ist, welche Seiten betroffen sind und welcher nächste Schritt empfohlen wird. Screenshots, konkrete URL-Beispiele und eine klare Einstufung erleichtern die Umsetzung.

Bewährt hat sich eine Maßnahmenliste mit den Spalten Befund, Auswirkung, betroffene Bereiche, Empfehlung, Priorität, Aufwand, zuständige Person und Kontrollkriterium. So wird aus einer Momentaufnahme ein Arbeitsplan. Bei größeren Websites sollte zusätzlich festgehalten werden, welche Bereiche bewusst unverändert bleiben und warum.

Eine wiederkehrende Prüfung ist sinnvoll, wenn die Website regelmäßig wächst, viele Redakteure beteiligt sind oder häufig Erweiterungen installiert werden. Die Häufigkeit richtet sich nach Änderungsrate und Risiko. Nach einem Relaunch, Domainwechsel oder größeren Systemupdate ist eine erneute umfassende Kontrolle besonders wichtig.

FAQ

Wie oft sollte eine technische Website-Analyse stattfinden?

Das hängt von Größe, Änderungsrate und technischer Komplexität ab. Kleine, selten veränderte Websites können mit einer regelmäßigen Grundprüfung auskommen. Bei Shops, Portalen oder häufig aktualisierten Projekten sind laufende Überwachung und zusätzliche Prüfungen nach Releases sinnvoll. Nach größeren Umbauten sollte immer eine gezielte Nachkontrolle erfolgen.

Wie lange dauert eine technische Website-Analyse?

Eine pauschale Dauer gibt es nicht. Maßgeblich sind URL-Anzahl, Seitentypen, Sprachversionen, Systeme und das Ziel der Analyse. Ein kurzer Check kann erste offensichtliche Probleme zeigen. Eine belastbare Untersuchung mit manuellen Stichproben, Priorisierung und konkreten Umsetzungshinweisen benötigt entsprechend mehr Zeit.

Ist eine technische Analyse auch ohne SEO-Ziel nützlich?

Ja. Erreichbarkeit, Geschwindigkeit, mobile Bedienbarkeit, Sicherheit und klare Navigation beeinflussen die allgemeine Qualität einer Website. Auch wenn Suchmaschinen keine Rolle spielen, bleiben diese Faktoren für Besucher, Kundendienst und interne Abläufe relevant.

Kann ein automatisches Tool die gesamte Analyse übernehmen?

Nein. Automatische Werkzeuge sind sehr nützlich, um große Mengen von URLs und Ressourcen zu prüfen. Sie bewerten jedoch nicht zuverlässig jede geschäftliche Priorität, jede Nutzerbarriere oder jede bewusste technische Entscheidung. Automatisierte Befunde sollten deshalb geprüft und mit manuellen Tests ergänzt werden.

Was ist wichtiger: Ladezeit oder technische Indexierung?

Das lässt sich nicht allgemein beantworten. Wenn wichtige Seiten gar nicht erreichbar oder unerwünscht ausgeschlossen sind, hat die Indexierung meist Vorrang. Wenn alle Inhalte zugänglich sind, aber die Nutzung stark durch langsame Seiten leidet, kann die Leistungsoptimierung dringlicher sein. Priorisiert wird anhand von Auswirkungen, Reichweite und Aufwand.

Welche Rolle spielt die robots.txt?

Die robots.txt kann automatisierten Crawlern Hinweise geben, welche Bereiche sie nicht anfragen sollen. Sie ist aber kein allgemeiner Schutzmechanismus und ersetzt keine Zugriffskontrolle. Änderungen sollten vorsichtig erfolgen, weil eine zu weit gefasste Regel wichtige Inhalte vom Crawling ausschließen kann.

Was sollte nach einer Analyse zuerst umgesetzt werden?

Beginnen Sie mit Befunden, die wichtige Inhalte, zentrale Nutzungsvorgänge, Sicherheit oder die grundsätzliche Erreichbarkeit betreffen. Danach folgen Maßnahmen mit hoher Reichweite und überschaubarem Aufwand. Kleine formale Verbesserungen können gesammelt werden, wenn sie keine erkennbare Auswirkung haben.

Fazit: Technik nach Wirkung verbessern

Eine technische Website-Analyse im Überblick zeigt nicht nur, ob einzelne Einstellungen korrekt wirken. Sie hilft dabei, die gesamte technische Grundlage einer Website aus Sicht von Besuchern, Suchmaschinen und Verantwortlichen zu beurteilen. Besonders wertvoll wird sie, wenn automatisierte Daten mit manuellen Prüfungen, konkreten URL-Beispielen und einer nachvollziehbaren Priorisierung verbunden werden.

Der sinnvollste nächste Schritt ist deshalb kein möglichst umfangreicher Warnungsbericht, sondern ein klarer Maßnahmenplan. Beheben Sie zuerst Probleme mit hoher Auswirkung, testen Sie Änderungen kontrolliert und beobachten Sie die Website anschließend weiter. So wird technische Qualität zu einem fortlaufenden Prozess statt zu einer einmaligen Momentaufnahme.