Wenn Suchmaschinen eine Website regelmäßig und vollständig crawlen können, werden neue und überarbeitete Inhalte schneller entdeckt und in den Suchindex aufgenommen. Crawling allein garantiert zwar keine guten Rankings, ist aber eine wichtige technische Grundlage für organische Sichtbarkeit. Dieser Ratgeber zeigt, wie Sie das Suchmaschinen-Crawling verbessern, typische Hindernisse erkennen und technische Maßnahmen sinnvoll priorisieren.
Im Mittelpunkt stehen keine kurzfristigen Tricks, sondern eine saubere Website-Struktur, eindeutig erreichbare Inhalte und verlässliche technische Signale. Die Empfehlungen eignen sich für kleinere Websites ebenso wie für umfangreichere Projekte mit vielen Unterseiten.
Was bedeutet Suchmaschinen-Crawling?
Beim Crawling rufen Suchmaschinen automatisiert Webseiten auf. Dafür folgen ihre Crawler, häufig auch Bots oder Suchroboter genannt, Links, lesen technische Hinweise und prüfen Inhalte. Die gefundenen Seiten können anschließend verarbeitet und – sofern sie die jeweiligen Voraussetzungen erfüllen – in den Suchindex aufgenommen werden.
Crawling und Indexierung sind nicht dasselbe. Eine Suchmaschine kann eine URL kennen und aufrufen, ohne sie in den Index aufzunehmen. Umgekehrt kann eine wichtige Seite schwer auffindbar sein, wenn sie intern schlecht verlinkt ist oder technische Barrieren bestehen. Wer das Suchmaschinen-Crawling verbessern möchte, sollte deshalb die gesamte Kette betrachten:
- Entdeckung: Kann der Crawler die URL über Links oder eine XML-Sitemap finden?
- Zugriff: Darf der Crawler die URL abrufen und erhält er eine verwertbare Antwort?
- Verarbeitung: Sind Inhalt, Canonical-Signal und technische Auszeichnung eindeutig?
- Priorisierung: Ist erkennbar, welche Seiten wichtig und aktuell sind?
Ein Crawling-Problem zeigt sich daher nicht immer als vollständiger Ausschluss. Auch unnötig häufige Aufrufe von unwichtigen URLs können Aufmerksamkeit und Ressourcen von relevanten Seiten abziehen.
Die wichtigsten Grundlagen für besseres Crawling
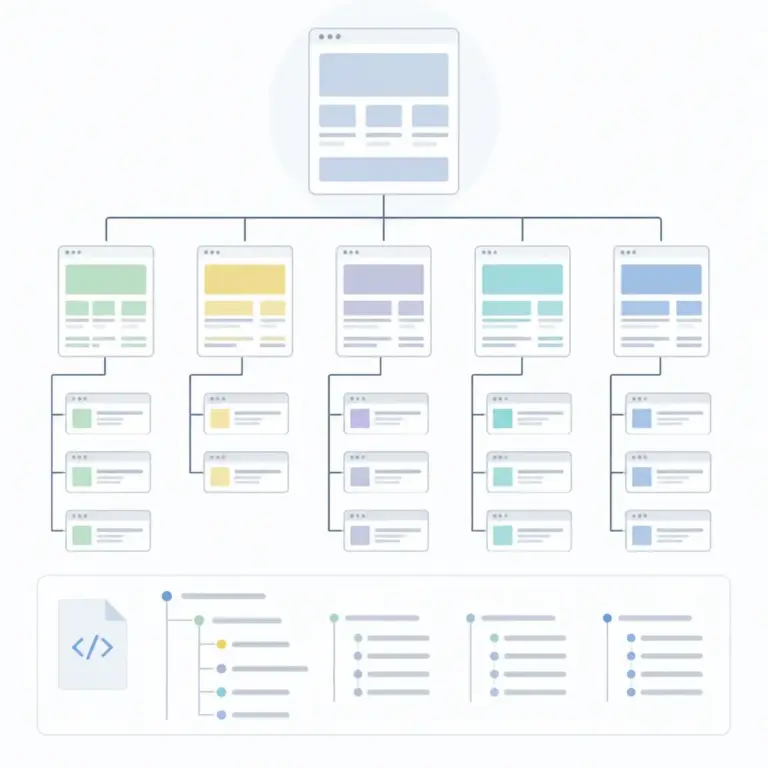
Die Grafik zeigt, wie Startseite, Übersichtsseiten und Inhalte sinnvoll miteinander verbunden werden können. Achten Sie besonders darauf, dass wichtige Seiten nicht als isolierte Endpunkte erscheinen.
Eine logisch aufgebaute Website-Struktur schaffen
Eine klare Informationsarchitektur erleichtert Menschen und Suchmaschinen die Orientierung. Ordnen Sie Inhalte nach nachvollziehbaren Themen und sorgen Sie dafür, dass wichtige Seiten mit wenigen sinnvollen Klicks erreichbar sind. Die genaue Klicktiefe ist kein alleiniger Qualitätsmaßstab, aber sehr verschachtelte Strukturen erschweren die Pflege und die Entdeckung von Inhalten.
Jede zentrale Seite sollte mindestens einen thematisch passenden internen Link von einer anderen erreichbaren Seite erhalten. Vermeiden Sie Strukturen, in denen wichtige Inhalte ausschließlich über eine interne Suche, Filter oder JavaScript-Interaktionen erreichbar sind. Ein sichtbarer HTML-Link mit einer verständlichen Zieladresse ist in der Regel die robusteste Grundlage.
Interne Links gezielt einsetzen
Interne Verlinkung verbindet Inhalte und hilft dabei, ihre Bedeutung innerhalb der Website einzuordnen. Verlinken Sie beispielsweise einen ausführlichen Leitfaden aus passenden Ratgeberartikeln, Kategorien und relevanten Übersichtsseiten. Der Linktext sollte kurz beschreiben, was auf der Zielseite zu erwarten ist.
Prüfen Sie regelmäßig, ob Links auf Fehlerseiten, Weiterleitungsketten oder veraltete URLs führen. Ein Linknetz mit vielen defekten Verbindungen erschwert die Navigation und kann dazu führen, dass wichtige Inhalte weniger zuverlässig entdeckt werden.
XML-Sitemap aktuell halten
Eine XML-Sitemap kann Suchmaschinen eine zusätzliche Übersicht über wichtige URLs geben. Sie ersetzt keine interne Verlinkung, ist aber besonders bei größeren Websites, häufigen Änderungen oder neuen Projekten hilfreich.
In die Sitemap gehören grundsätzlich nur URLs, die tatsächlich indexierbar sein sollen. Entfernen Sie nach Möglichkeit Seiten mit einem dauerhaften Ausschluss, nicht kanonische Varianten, Weiterleitungen und offensichtliche Fehler-URLs. Achten Sie außerdem auf gültige absolute URLs, einen erreichbaren Sitemap-Pfad und eine Aktualisierung nach relevanten Änderungen.
Die Sitemap sollte nicht als vollständiges Archiv jeder jemals erzeugten URL verstanden werden. Ihre Aufgabe ist es, Suchmaschinen eine kuratierte Liste wichtiger, gültiger und zugänglicher Seiten zu liefern.
Robots.txt, Meta-Robots und Zugriffssignale richtig verwenden
Die Datei robots.txt kann Crawlern mitteilen, welche Bereiche sie nicht abrufen sollen. Sie ist jedoch kein zuverlässiger Schutz für vertrauliche Inhalte. Nicht öffentlich bestimmte Informationen gehören hinter eine geeignete Zugriffskontrolle und sollten nicht allein durch robots.txt verborgen werden.
Ein zu großzügiger Ausschluss kann das Crawling erheblich behindern. Prüfen Sie deshalb jede Disallow-Regel darauf, ob sie wirklich notwendig ist. Besonders riskant sind pauschale Regeln für Verzeichnisse, in denen sich neben unwichtigen Parametervarianten auch redaktionell relevante Inhalte befinden.
Ein wichtiger Unterschied: Ein Crawling-Ausschluss in robots.txt verhindert in erster Linie den Abruf. Ein noindex-Signal wird dagegen erst ausgewertet, wenn die betreffende Seite abgerufen werden kann. Wer eine Seite gezielt aus dem Index entfernen möchte, sollte die passende Methode im jeweiligen technischen Umfeld sorgfältig prüfen und nicht mehrere widersprüchliche Signale ohne Plan kombinieren.
Typische Fehler bei robots.txt
- Die gesamte Website wird versehentlich mit einer allgemeinen Regel blockiert.
- CSS- oder JavaScript-Ressourcen werden gesperrt, obwohl sie für die Darstellung oder Verarbeitung relevant sind.
- Eine alte Testregel bleibt nach dem Relaunch bestehen.
- Parameter werden pauschal blockiert, obwohl dadurch wichtige Zielseiten nicht mehr erreichbar sind.
- Die Sitemap wird mit einer falschen oder nicht erreichbaren Adresse angegeben.
Nach Änderungen sollten Sie die Datei aus Sicht verschiedener URL-Typen prüfen: Startseite, wichtige Inhaltsseite, Kategorie, Medien- oder Produktseite sowie eine bewusst auszuschließende URL.
URL-Struktur, Statuscodes und Weiterleitungen prüfen
Eine verständliche URL-Struktur hilft bei der Verwaltung und reduziert unnötige Varianten. Vermeiden Sie, wenn möglich, mehrere URLs für denselben Inhalt, unkontrolliert erzeugte Parameter und dauerhaft wechselnde Pfade. URLs sollten stabil bleiben und den Inhalt nicht durch übermäßig viele technische Kennungen verschleiern.
Der HTTP-Statuscode liefert dem Crawler einen wichtigen Hinweis:
- 200: Die Ressource wurde erfolgreich ausgeliefert.
- 3xx: Die Anfrage wird weitergeleitet oder benötigt eine weitere Verarbeitung.
- 4xx: Die angeforderte Ressource ist aus Sicht des Servers nicht verfügbar.
- 5xx: Der Server konnte die Anfrage nicht erfolgreich verarbeiten.
Einzelne Fehler sind auf jeder größeren Website möglich. Problematisch wird es, wenn interne Links regelmäßig auf nicht vorhandene URLs zeigen, Weiterleitungen in Ketten auftreten oder viele relevante Seiten vorübergehend mit Serverfehlern antworten. Korrigieren Sie interne Links möglichst direkt und leiten Sie dauerhaft verschobene Inhalte auf die passendste neue URL weiter.
Beachten Sie auch, dass eine Weiterleitung kein Ersatz für eine konsequente interne Verlinkung ist. Wenn eine Seite dauerhaft umgezogen ist, sollten die wichtigsten Links auf die endgültige Adresse zeigen.
Duplicate Content und URL-Varianten reduzieren
Technische Systeme erzeugen häufig mehrere URLs mit gleichem oder sehr ähnlichem Inhalt. Beispiele sind Filter, Sortierungen, Tracking-Parameter, Druckansichten, Session-Kennungen oder unterschiedliche Schreibweisen. Dadurch kann eine Website unnötig viele crawlbare Adressen erzeugen.
Der erste Schritt ist eine Bestandsaufnahme: Welche URL-Varianten existieren, welche davon werden intern verlinkt und welche sollen überhaupt in den Suchindex gelangen? Danach lassen sich passende Maßnahmen auswählen:
- Parameter nur dann verwenden, wenn sie einen echten Zweck erfüllen.
- Für gleichartige Inhalte eine bevorzugte kanonische URL festlegen.
- Unnötige Varianten vermeiden oder technisch kontrolliert behandeln.
- Interne Links konsequent auf die gewünschte Hauptversion richten.
- Bei dauerhaft zusammengeführten Inhalten geeignete Weiterleitungen einsetzen.
Das rel="canonical"-Element ist ein Hinweis auf die bevorzugte Version, aber keine pauschale Garantie für die Auswahl durch eine Suchmaschine. Es sollte nur auf eine inhaltlich passende, erreichbare und indexierbare Ziel-URL verweisen. Ein Canonical auf eine thematisch unpassende Seite kann die technische Klarheit verschlechtern.
JavaScript, Rendering und wichtige Inhalte
Moderne Websites laden Inhalte teilweise nachträglich über JavaScript. Das kann funktionieren, macht die Verarbeitung aber komplexer als eine direkt ausgelieferte HTML-Struktur. Besonders wichtige Informationen sollten deshalb nicht ausschließlich nach einer Interaktion, einem Scrollvorgang oder einem clientseitigen Datenabruf erscheinen.
Prüfen Sie, ob der zentrale Text, interne Links, Überschriften und relevante Metadaten im ausgelieferten Dokument oder nach der vorgesehenen Verarbeitung zuverlässig vorhanden sind. Achten Sie außerdem darauf, dass Links echte, erreichbare Zieladressen besitzen und nicht nur durch Klick-Handler simuliert werden.
Eine gute Praxis ist die schrittweise Prüfung: Zuerst sollte die Seite ohne unnötige Abhängigkeiten eine verständliche Grundstruktur liefern. Danach können dynamische Funktionen die Darstellung und Bedienung erweitern. Bei einem Relaunch empfiehlt sich ein Vergleich wichtiger Seiten vor und nach der technischen Umstellung.
Serverleistung und Crawling-Budget verstehen
Suchmaschinen verfügen nicht über unbegrenzte Kapazitäten für jede Website. Die verfügbare Aufmerksamkeit hängt unter anderem von der Größe, Aktualität, Qualität, Erreichbarkeit und technischen Stabilität eines Projekts ab. Für kleine Websites ist das sogenannte Crawling-Budget oft kein akutes Problem. Bei großen oder stark parameterisierten Websites kann es jedoch wichtig werden.
Die sinnvollste Maßnahme ist nicht, Crawler um jeden Preis zu einer höheren Abruffrequenz zu bewegen. Stattdessen sollte die Website möglichst wenige unnötige URLs erzeugen und wichtige Inhalte zuverlässig ausliefern. Dazu gehören:
- stabile Serverantworten und möglichst geringe Ausfallzeiten,
- eine Begrenzung nutzloser Filter- und Parameterkombinationen,
- eine nachvollziehbare interne Verlinkung,
- aktuelle Sitemaps ohne Fehler- und Weiterleitungs-URLs,
- regelmäßige Kontrolle von Serverprotokollen und technischen Reports.
Langsame Ladezeiten sind nicht ausschließlich ein Crawling-Thema. Sie beeinflussen auch die Nutzung und die technische Verarbeitung. Priorisieren Sie daher die Ursachen: überlastete Server, unnötig große Ressourcen, fehlerhafte Caches oder ineffiziente Datenbankabfragen sollten getrennt untersucht werden.
Nach einem Relaunch das Crawling absichern
Ein Relaunch verändert häufig URLs, Navigation, Templates, interne Links und technische Regeln gleichzeitig. Deshalb sollte die Crawling-Prüfung bereits vor der Veröffentlichung beginnen. Erstellen Sie eine Liste der wichtigsten alten URLs und ordnen Sie ihnen – falls erforderlich – passende neue Zieladressen zu.
Direkt nach dem Start sollten Sie mindestens diese Punkte kontrollieren:
- Ist die Website öffentlich erreichbar und nicht versehentlich blockiert?
- Funktionieren wichtige alte und neue URLs mit dem vorgesehenen Statuscode?
- Gibt es Weiterleitungsketten oder massenhaft nicht gefundene Seiten?
- Enthält die neue Sitemap nur gültige Zieladressen?
- Sind Canonical- und Meta-Robots-Signale korrekt gesetzt?
- Führen interne Links nicht mehr auf alte oder falsche Pfade?
- Sind zentrale Inhalte auch ohne problematische Interaktionen auffindbar?
Die Nachkontrolle sollte nicht auf einen einzigen Tag beschränkt bleiben. Beobachten Sie technische Fehler und auffällige URL-Muster über einen angemessenen Zeitraum, da manche Probleme erst durch das erneute Crawling sichtbar werden.
Werkzeuge für die technische Kontrolle
Für die Analyse stehen verschiedene Werkzeugarten zur Verfügung. Nutzen Sie keine einzelne Quelle als vollständige Wahrheit, sondern vergleichen Sie die Perspektiven:
- Suchmaschinen-Tools: Sie zeigen häufig erkannte Indexierungs-, Abruf- oder Sitemap-Probleme für die jeweilige Property.
- Serverprotokolle: Sie dokumentieren, welche URLs tatsächlich von welchen Crawlern angefragt wurden und welche Antworten der Server zurückgab.
- Crawler für technische Audits: Sie können interne Links, Statuscodes, Canonicals, Weiterleitungen und viele URL-Varianten systematisch erfassen.
- Browser- und Entwicklerwerkzeuge: Sie helfen bei der Prüfung von Netzwerkaufrufen, gerendertem Inhalt und blockierten Ressourcen.
Bewerten Sie Ergebnisse immer im Kontext. Eine einzelne nicht gecrawlte URL ist weniger aussagekräftig als ein wiederkehrendes Muster aus vielen fehlerhaften Seiten, widersprüchlichen Signalen oder ständig neuen Parameteradressen. Dokumentieren Sie Befunde mit URL, Ursache, Priorität und geplanter Lösung.
Eine sinnvolle Priorisierung der Maßnahmen
Nicht jede technische Auffälligkeit verdient dieselbe Aufmerksamkeit. Beginnen Sie mit Problemen, die viele wichtige URLs betreffen oder den Zugriff grundsätzlich verhindern. Eine praktikable Reihenfolge lautet:
- Zugriff sichern: Blockierungen, Serverfehler und falsche Weiterleitungen beheben.
- Wichtige URLs eindeutig machen: Canonicals, interne Links und Zieladressen vereinheitlichen.
- Unnötige URL-Mengen reduzieren: Parameter, Filter und doppelte Varianten kontrollieren.
- Sitemap und Architektur bereinigen: wichtige Inhalte klar auffindbar und korrekt gelistet halten.
- Rendering und Leistung verbessern: zentrale Inhalte zuverlässig ausliefern und technische Engpässe reduzieren.
- Kontinuierlich überwachen: Änderungen dokumentieren und wiederkehrende Fehler erkennen.
Die Priorität sollte sich nach Auswirkungen, Umfang und Aufwand richten. Eine kleine Korrektur an einer robots.txt kann wichtiger sein als zahlreiche Detailverbesserungen an einzelnen Seiten. Umgekehrt lohnt sich eine aufwendige Bereinigung großer URL-Mengen erst dann, wenn die grundlegenden Zugriffsprobleme gelöst sind.
FAQ
Wie kann ich das Suchmaschinen-Crawling verbessern?
Beginnen Sie mit einer klaren internen Verlinkung, einer aktuellen XML-Sitemap und einer korrekten robots.txt. Prüfen Sie zusätzlich Statuscodes, Weiterleitungen, Canonical-Signale, URL-Varianten und die Erreichbarkeit wichtiger Inhalte. Entscheidend ist eine Kombination dieser Maßnahmen, nicht ein einzelner technischer Schalter.
Wie schnell werden Änderungen gecrawlt?
Das lässt sich nicht allgemein garantieren. Die Geschwindigkeit hängt unter anderem von Websitegröße, Aktualität, technischer Stabilität und der Bedeutung der jeweiligen URL ab. Nach wichtigen Änderungen sollten Sie die technische Erreichbarkeit sofort kontrollieren und die weitere Entwicklung anhand geeigneter Berichte beobachten.
Ist eine XML-Sitemap für jede Website notwendig?
Eine kleine, gut intern verlinkte Website kann auch ohne Sitemap auffindbar sein. Eine XML-Sitemap ist dennoch oft eine hilfreiche zusätzliche Orientierung, insbesondere bei vielen URLs, neuen Websites, häufigen Änderungen oder schwer überschaubaren Strukturen. Sie sollte gepflegt sein und keine beliebigen URL-Varianten enthalten.
Blockiert robots.txt eine Seite dauerhaft aus dem Index?
Robots.txt steuert in erster Linie, ob ein Crawler eine Ressource abrufen darf. Das ist nicht dasselbe wie ein garantiertes Entfernen aus dem Index. Für Ausschlüsse sollten Sie die gewünschte Wirkung, die Erreichbarkeit der Seite und vorhandene Meta- oder HTTP-Signale gemeinsam prüfen.
Was ist wichtiger: Sitemap oder interne Links?
Beides erfüllt unterschiedliche Aufgaben. Interne Links verbinden Inhalte innerhalb der Website und unterstützen ihre Auffindbarkeit und Einordnung. Die Sitemap bietet eine zusätzliche URL-Übersicht. Eine Sitemap sollte daher keine schwache interne Struktur kaschieren.
Kann JavaScript das Crawling verschlechtern?
JavaScript ist nicht automatisch ein Problem. Schwierigkeiten entstehen, wenn wichtige Inhalte, Links oder technische Signale nur unzuverlässig nachgeladen werden. Prüfen Sie deshalb, ob die zentrale Seitenstruktur auch bei der vorgesehenen Verarbeitung vollständig und verständlich verfügbar ist.
Wie erkenne ich unnötige Crawl-Varianten?
Achten Sie in Serverprotokollen, technischen Crawls und Suchmaschinenberichten auf wiederkehrende Parameter, Filterkombinationen, Session-IDs, Druckversionen oder verschiedene Schreibweisen derselben Inhalte. Vergleichen Sie diese Adressen mit Ihren internen Links und entscheiden Sie für jede Gruppe, ob sie indexierbar sein soll.
Fazit: Suchmaschinen-Crawling nachhaltig verbessern
Wer das Suchmaschinen-Crawling verbessern möchte, sollte zuerst die technische Grundlage ordnen: wichtige Inhalte müssen erreichbar, sinnvoll verlinkt, eindeutig adressiert und zuverlässig ausgeliefert werden. Eine aktuelle Sitemap, sorgfältig eingesetzte Zugriffssignale und kontrollierte URL-Varianten unterstützen diesen Prozess.
Besonders nachhaltig ist ein regelmäßiger Prüfablauf. Kontrollieren Sie nach Relaunches und größeren Änderungen die wichtigsten URLs, beobachten Sie Server- und Suchmaschinenberichte und dokumentieren Sie wiederkehrende Fehler. So wird Crawling nicht zu einer einmaligen Reparatur, sondern zu einem festen Bestandteil der Website-Qualität.