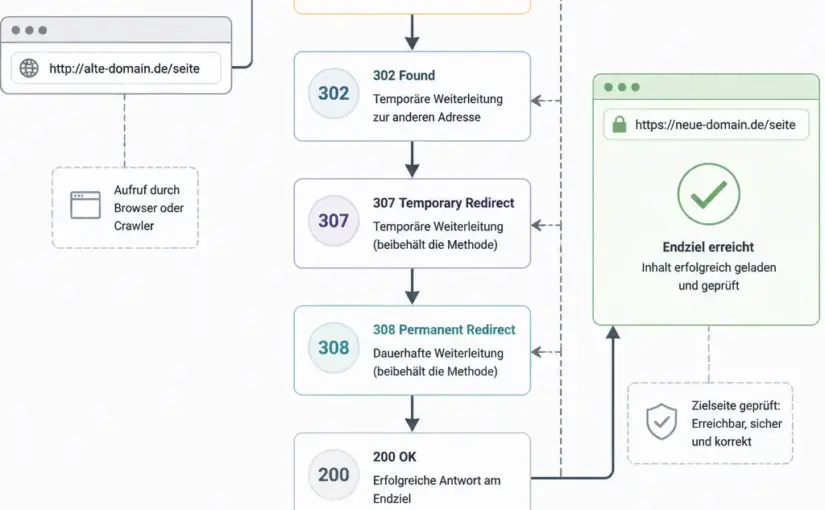
Weiterleitungsziel einer Domain prüfen: Methoden, Fehler und Praxisleitfaden

Wer eine Domain umzieht, neu aufsetzt oder mehrere Webadressen bündelt, sollte das Weiterleitungsziel einer Domain prüfen. Eine Weiterleitung kann technisch funktionieren und trotzdem auf die falsche URL, eine unnötige Zwischenstation oder sogar eine fehlerhafte Seite zeigen. Das wirkt sich auf Nutzer, Suchmaschinen, Tracking und die Wartbarkeit der Website aus.

Dieser Ratgeber zeigt, wie sich Weiterleitungsziele zuverlässig kontrollieren lassen, welche Statuscodes wichtig sind und wie typische Fehler systematisch eingegrenzt werden. Die beschriebenen Schritte funktionieren sowohl für einzelne URLs als auch für größere Weiterleitungslisten.

Was bedeutet das Weiterleitungsziel einer Domain?

Das Weiterleitungsziel ist die URL, an die ein Server, ein CDN oder eine andere technische Ebene einen Aufruf weiterleitet. Gibt jemand beispielsweise http://beispiel.de ein, kann der Server eine Antwort mit dem Hinweis senden, dass der Browser künftig https://www.beispiel.de verwenden soll.

Eine Weiterleitung besteht dabei nicht nur aus einem sichtbaren Wechsel im Browser. Entscheidend sind mehrere Bestandteile:

  • Ausgangsadresse: Die Domain oder URL, die aufgerufen wird.
  • HTTP-Statuscode: Er zeigt an, ob und auf welche Art weitergeleitet wird.
  • Location-Header: Er enthält bei einer HTTP-Weiterleitung das unmittelbare Ziel.
  • Weiterleitungskette: Mehrere aufeinanderfolgende Weiterleitungen können den Aufruf verlängern oder Fehler verursachen.
  • Endziel: Die URL, unter der letztlich der Inhalt ausgeliefert wird.

Das Ziel kann auf derselben Domain liegen, etwa von einer alten Unterseite auf eine neue. Ebenso sind Weiterleitungen zwischen unterschiedlichen Domains möglich. Für die Prüfung sollte immer zwischen dem direkten Ziel und dem letztlich erreichten Ziel unterschieden werden.

Warum sollte man das Weiterleitungsziel prüfen?

Eine unkontrollierte Weiterleitung ist häufig erst dann sichtbar, wenn Nutzer von einem Problem berichten. Eine regelmäßige Prüfung ist deshalb sinnvoll, bevor Änderungen veröffentlicht werden und nachdem DNS-, Hosting-, CMS- oder Serverkonfigurationen angepasst wurden.

Nutzerführung und Vertrauen

Besucher erwarten, dass eine alte Adresse direkt zu einer passenden neuen Seite führt. Ein Umweg über mehrere URLs, ein Wechsel auf eine unerwartete Domain oder eine Weiterleitung zu einer irrelevanten Startseite kann irritieren. Besonders kritisch ist ein Ziel, das nicht zum Anlass des ursprünglichen Aufrufs passt.

Technische Stabilität

Weiterleitungen können aufeinander verweisen. Beispiel: URL A führt zu URL B, URL B führt zurück zu URL A. Das erzeugt eine Weiterleitungsschleife. Auch eine Kette aus mehreren Stationen kann problematisch sein, wenn eine Zwischen-URL später entfernt oder falsch konfiguriert wird.

Suchmaschinen und interne Signale

Bei dauerhaften Umzügen wird meist ein permanenter Weiterleitungsstatus verwendet. Das hilft Suchmaschinen, die neue Adresse als Ersatz einzuordnen. Eine Weiterleitung allein ersetzt jedoch keine saubere interne Verlinkung, passende Canonical-Angaben und eine konsistente Sitemap. Das Ziel muss außerdem inhaltlich möglichst gut zur alten URL passen.

Analyse und Kampagnen

Eine Weiterleitung kann Parameter erhalten, entfernen oder verändern. Dadurch können Kampagnenkennzeichnungen, Referrer-Informationen oder andere Auswertungsdaten beeinflusst werden. Wer das Ziel prüft, sollte daher nicht nur die Adresse ohne Parameter testen, sondern auch typische Varianten aus E-Mails, Anzeigen und externen Verweisen.

Die wichtigsten HTTP-Statuscodes bei Weiterleitungen

Der Statuscode beschreibt die technische Antwort des Servers. Für eine erste Prüfung sind vor allem diese Codes relevant:

Statuscode Bedeutung Typischer Einsatz
301 Dauerhaft verschoben Eine URL wurde dauerhaft durch eine andere ersetzt.
302 Vorübergehend verschoben Das Ziel kann später wieder geändert werden.
303 Siehe andere URL Eine Anfrage soll über eine andere Adresse betrachtet werden.
307 Vorübergehend verschoben Die ursprüngliche HTTP-Methode soll erhalten bleiben.
308 Dauerhaft verschoben Die ursprüngliche HTTP-Methode soll erhalten bleiben.

Die Wahl des Codes hängt vom Anwendungsfall ab. Für einen dauerhaften Domain- oder URL-Umzug kommen häufig 301 oder 308 infrage. Bei vorübergehenden Änderungen werden häufig 302 oder 307 verwendet. Die Entscheidung sollte zur tatsächlichen Absicht passen und nicht nur danach getroffen werden, welcher Code gerade am einfachsten einzurichten ist.

Wichtig: Ein Statuscode von 200 am Ende bedeutet lediglich, dass die Zielseite erfolgreich ausgeliefert wurde. Er beweist nicht, dass die Weiterleitung fachlich richtig ist. Deshalb müssen Zieladresse, Inhalt und Weiterleitungskette gemeinsam bewertet werden.

Weiterleitungsziel einer Domain mit Browser und Entwicklerwerkzeugen prüfen

Für eine einzelne Adresse genügt oft eine manuelle Prüfung. Öffnen Sie die Ausgangs-URL in einem privaten Browserfenster und beobachten Sie die Adresszeile. Notieren Sie jede sichtbare Änderung, insbesondere:

  • Wechselt die Verbindung von HTTP zu HTTPS?
  • Wird zwischen der Version mit und ohne www umgeleitet?
  • Bleibt der Pfad erhalten?
  • Werden Query-Parameter übernommen?
  • Landet der Aufruf direkt auf der erwarteten Seite?

Die Adresszeile zeigt jedoch nur das Endergebnis. Für die einzelnen HTTP-Antworten sind die Entwicklerwerkzeuge des Browsers hilfreicher. Öffnen Sie den Bereich „Netzwerk“ beziehungsweise „Network“, laden Sie die Seite neu und wählen Sie die erste Anfrage aus. Dort lassen sich Status, Zieladresse und weitere Antwortinformationen ansehen.

Aktivieren Sie bei Bedarf die Option, dass das Netzwerkprotokoll beim Neuladen erhalten bleibt. So sehen Sie auch Weiterleitungen, die nur kurz erscheinen. Die Prüfung sollte möglichst mit deaktiviertem Cache oder in einem privaten Fenster erfolgen, weil gespeicherte Antworten das aktuelle Verhalten verdecken können.

Ein Browser testet allerdings immer aus Sicht eines Clients. Für eine vollständige Beurteilung können zusätzlich Serverprotokolle, CDN-Regeln und die Konfiguration des Webservers notwendig sein.

Weiterleitungsziel per Kommandozeile kontrollieren
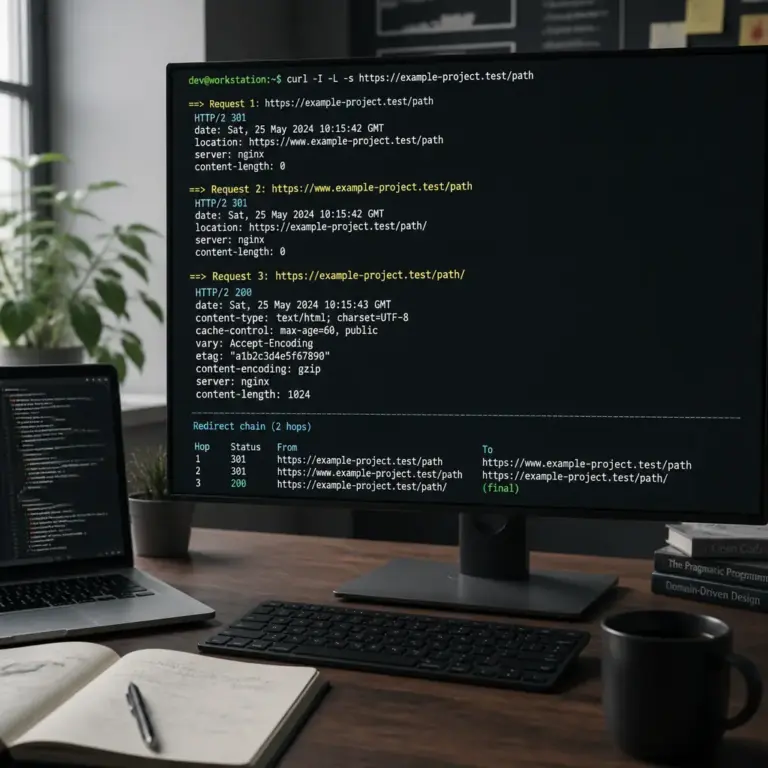
Terminalansicht zur Pru00fcfung einer Weiterleitungskette mit HTTP-Status und Zieladresse
Mit Headern lässt sich das direkte und endgültige Weiterleitungsziel nachvollziehen.

Die Abbildung macht sichtbar, welche Informationen bei einer Kommandozeilenprüfung wichtig sind: Statuscode, Location-Header und das finale Ziel. So lässt sich eine Weiterleitungskette auch unabhängig vom Browser systematisch beurteilen.

Für technische Prüfungen ist ein HTTP-Client nützlich. Mit curl können Header abgerufen und Weiterleitungen sichtbar gemacht werden. Ein einfacher Aufruf ohne automatische Verfolgung zeigt die erste Antwort:

curl -I https://www.beispiel.de/alte-seite

In der Ausgabe interessieren insbesondere der Status und ein vorhandener Location-Header. Soll die gesamte Kette bis zum Endziel verfolgt werden, kann die Weiterleitungsverfolgung aktiviert werden:

curl -I -L https://www.beispiel.de/alte-seite

Die Option -I ruft nur die Header ab. Das ist für eine schnelle Prüfung effizient, bildet aber nicht jede Besonderheit einer vollständigen Seitenanfrage ab. Manche Systeme behandeln HEAD- und GET-Anfragen unterschiedlich. Bei einem unklaren Ergebnis kann deshalb ein GET-Aufruf sinnvoll sein:

curl -L -o /dev/null -w "%{url_effective} %{http_code}\n" https://www.beispiel.de/alte-seite

Die Ausgabe sollte nicht isoliert betrachtet werden. Prüfen Sie zusätzlich, ob die Kette ungewöhnlich lang ist, ob ein unerwarteter Host auftaucht und ob das Endziel tatsächlich den erwarteten Inhalt enthält. Für sensible oder geschützte Bereiche können Authentifizierung, Cookies oder Sicherheitsregeln das Ergebnis verändern.

Weiterleitungen mit Online-Prüfungen und Crawling kontrollieren

Für gelegentliche Einzelprüfungen können Webdienste für HTTP-Header oder Redirect-Ketten hilfreich sein. Geben Sie dort nur URLs ein, deren Verarbeitung durch einen Drittanbieter zulässig ist. Interne, nicht öffentliche oder personenbezogene Adressen gehören nicht in fremde Prüfwerkzeuge.

Bei vielen URLs ist ein Crawler die bessere Wahl. Ein technischer Crawl kann unter anderem folgende Informationen liefern:

  • Ausgangs-URL und Statuscode
  • direktes Weiterleitungsziel
  • Endziel nach mehreren Schritten
  • Anzahl der Weiterleitungen
  • Weiterleitungsschleifen oder nicht erreichbare Ziele
  • interne Links, die noch auf alte Adressen zeigen

Vor dem Start sollten Sie den Prüfbereich festlegen. Eine Liste wichtiger alter URLs eignet sich für eine gezielte Kontrolle. Ein vollständiger Crawl ist nützlich, wenn Sie nicht wissen, wo alte Adressen noch verlinkt sind. Achten Sie auf eine angemessene Crawl-Geschwindigkeit und respektieren Sie Zugriffsbeschränkungen der Website.

Eine Weiterleitungsliste sollte mindestens die alte URL, das erwartete neue Ziel, den gewollten Statuscode und den tatsächlichen Prüftermin enthalten. So lassen sich Abweichungen nachvollziehbar dokumentieren. Bei einer Änderung am Hosting oder am Webserver kann die Liste erneut verwendet werden.

Weiterleitungsziel richtig bewerten: eine praktische Checkliste

Die technische Antwort ist nur ein Teil der Prüfung. Gehen Sie pro URL möglichst in dieser Reihenfolge vor:

  1. Ausgangs-URL festhalten: Prüfen Sie Protokoll, Host, Pfad, Groß- und Kleinschreibung sowie vorhandene Parameter.
  2. Erste Antwort prüfen: Notieren Sie Statuscode und unmittelbares Ziel aus dem Location-Header.
  3. Kette verfolgen: Ermitteln Sie jede weitere Station bis zum Endziel.
  4. Endziel vergleichen: Kontrollieren Sie, ob Host, Pfad und Inhalt fachlich zur alten URL passen.
  5. Endstatus prüfen: Das Endziel sollte erreichbar sein und keinen Fehlerstatus liefern.
  6. Varianten testen: Berücksichtigen Sie HTTP/HTTPS, www/non-www, Trailing Slash und typische Parameter.
  7. Interne Verlinkung prüfen: Aktualisieren Sie Links, wenn die alte Adresse nicht mehr verwendet werden soll.
  8. Dokumentieren: Speichern Sie Ergebnis, Zeitpunkt und gegebenenfalls die verantwortliche Konfiguration.

Ein gutes Weiterleitungsziel ist direkt, erreichbar, fachlich passend und dauerhaft konsistent. Eine pauschale Weiterleitung sämtlicher alter URLs auf die Startseite kann zwar technisch funktionieren, bietet aber oft wenig Orientierung. Besser ist eine Zuordnung zu einer möglichst passenden neuen Seite.

Häufige Fehler bei Domain-Weiterleitungen

Weiterleitungsschleifen

Eine Schleife entsteht, wenn sich zwei oder mehr Regeln gegenseitig auslösen. Häufige Ursachen sind widersprüchliche Einstellungen für HTTPS, www und die bevorzugte Domain. Prüfen Sie, ob sowohl das Hosting-Panel als auch der Webserver, das CMS oder ein CDN eigene Regeln anwenden.

Zu lange Weiterleitungsketten

Wenn eine alte URL über mehrere Zwischenziele zum Endziel führt, wird die Konfiguration schwerer nachvollziehbar. Nach Möglichkeit sollte die alte Adresse direkt auf die aktuelle Ziel-URL zeigen. Das reduziert Fehlerquellen und erleichtert spätere Änderungen.

Falsche Zielseite

Ein Statuscode kann korrekt sein, obwohl das Ziel inhaltlich nicht passt. Prüfen Sie bei jeder wichtigen URL, ob Titel, Thema, Sprache und gewünschte Handlung der alten Seite angemessen entsprechen.

Verlust von Pfad oder Parametern

Eine Regel, die nur die Domain ersetzt, kann den ursprünglichen Pfad abschneiden. Dadurch landen viele unterschiedliche Adressen auf derselben Seite. Prüfen Sie deshalb mehrere Pfade und entscheiden Sie bewusst, welche Parameter übernommen, bereinigt oder entfernt werden sollen.

HTTP- und HTTPS-Regeln widersprechen sich

Ein typisches Muster ist eine Umleitung von HTTP auf HTTPS, während eine zweite Regel HTTPS wieder auf HTTP verweist. Die bevorzugte Variante sollte eindeutig festgelegt und anschließend für alle Domainvarianten getestet werden.

Weiterleitung zu einer Fehlerseite

Manchmal zeigt der erste Redirect auf einen Pfad, der erst später gelöscht wurde. Eine erfolgreiche Weiterleitung ist dann nicht gegeben, wenn das Endziel einen Fehlerstatus liefert oder nur eine generische Fehlerseite darstellt.

Besondere Fälle: DNS, CDN, CMS und Server

Eine Domain-Weiterleitung kann an unterschiedlichen Stellen entstehen. DNS selbst liefert normalerweise keine klassische HTTP-Weiterleitung; DNS bestimmt zunächst, welcher Dienst für die Domain zuständig ist. Die eigentliche Weiterleitung erfolgt anschließend etwa durch einen Webserver, ein Hosting-Panel, ein CDN oder eine Anwendung.

Diese Unterscheidung ist bei der Fehlersuche wichtig. Zeigt eine Domain auf den falschen Server, sehen Sie möglicherweise eine fremde Standardseite oder eine unerwartete Regel. Bei einem CDN können zwischengespeicherte Antworten das aktuelle Serververhalten überlagern. Nach einer Konfigurationsänderung sollten Sie deshalb Cache-Einstellungen und die Auslieferung von verschiedenen Netzwerken aus berücksichtigen.

In einem CMS können Weiterleitungen durch Erweiterungen, Routing-Regeln oder individuelle Einstellungen erzeugt werden. Prüfen Sie, ob mehrere Komponenten dieselbe URL bearbeiten. Bei serverseitigen Regeln sollten Sie Änderungen zunächst nachvollziehbar sichern und nur mit ausreichenden Berechtigungen vornehmen. Eine kleine Syntaxänderung kann zahlreiche URLs beeinflussen.

Weiterleitungen nach einem Domainumzug prüfen

Bei einem Domainumzug reicht es nicht, nur die Startseite zu testen. Erstellen Sie vorab eine Liste wichtiger URLs, beispielsweise aus internen Links, Zugriffsdaten, vorhandenen Sitemaps und bekannten externen Verweisen. Die Liste sollte alte und neue Adresse eindeutig gegenüberstellen.

Prüfen Sie anschließend mindestens:

  • alle Varianten von Protokoll und Hostname, die bisher erreichbar waren;
  • wichtige Unterseiten, Medienpfade und Downloadadressen;
  • Weitergabe oder bewusste Entfernung von URL-Parametern;
  • die neue Sitemap und interne Verlinkungen;
  • Canonical- und hreflang-Angaben, sofern die Website diese verwendet;
  • Formular-, Login- und geschützte Bereiche mit den dafür vorgesehenen Zugriffsrechten.

Beobachten Sie nach der Umstellung Serverprotokolle und Fehlerberichte. Ein Anstieg nicht gefundener URLs kann auf fehlende Zuordnungen hindeuten. Auch externe Dienste, Newsletter und Werbemittel sollten schrittweise auf die neuen Zieladressen aktualisiert werden, statt dauerhaft von alten URLs abhängig zu bleiben.

FAQ

Wie sehe ich das direkte Weiterleitungsziel einer Domain?

Rufen Sie die Ausgangs-URL ab und prüfen Sie den Location-Header der ersten HTTP-Antwort. Im Browser helfen die Entwicklerwerkzeuge im Bereich „Netzwerk“. Mit einem Kommandozeilenwerkzeug wie curl -I lässt sich die erste Antwort ebenfalls anzeigen.

Wie finde ich das endgültige Ziel einer Weiterleitung?

Verfolgen Sie die vollständige Weiterleitungskette bis zur letzten Antwort. Mit curl -I -L können die Redirects verfolgt werden. Kontrollieren Sie danach zusätzlich, ob die letzte URL erreichbar ist und den erwarteten Inhalt ausliefert.

Ist eine Weiterleitung von HTTP auf HTTPS normal?

Ja, eine Umleitung von HTTP auf HTTPS ist ein übliches Konfigurationsmuster. Sie sollte jedoch eindeutig und ohne Rücksprung erfolgen. Testen Sie zusätzlich die bevorzugte Domainvariante sowie einzelne Unterseiten.

Was ist besser: 301 oder 302?

Das hängt davon ab, ob die Änderung dauerhaft oder vorübergehend ist. Für einen dauerhaften Umzug werden häufig 301 oder 308 eingesetzt, für eine vorübergehende Änderung häufig 302 oder 307. Entscheidend ist, dass der Statuscode die tatsächliche Absicht korrekt beschreibt.

Wie viele Weiterleitungen sind problematisch?

Es gibt keine für jeden Fall passende feste Grenze. Jede zusätzliche Station erhöht jedoch die Komplexität und kann die Fehleranalyse erschweren. Wenn möglich, sollte eine alte URL direkt auf das aktuelle Endziel zeigen.

Warum funktioniert die Weiterleitung im Browser, aber nicht im Prüfwerkzeug?

Browser und Prüfwerkzeuge können sich bei Cookies, Cache, User-Agent, HTTP-Methode und Authentifizierung unterscheiden. Prüfen Sie, ob die Regel nur für bestimmte Clients gilt. Wiederholen Sie den Test ohne Cache und vergleichen Sie HEAD- mit GET-Anfragen.

Kann DNS das Weiterleitungsziel festlegen?

DNS legt in der Regel fest, welcher Server oder Dienst angesprochen wird. Die HTTP-Weiterleitung selbst wird normalerweise erst dort erzeugt. Für die Fehlersuche sollten daher DNS-Ziel, Hosting, CDN und Webserverregel getrennt betrachtet werden.

Fazit: Weiterleitungsziel einer Domain zuverlässig prüfen

Eine verlässliche Prüfung verbindet technische und inhaltliche Kontrolle. Ermitteln Sie zunächst den Statuscode und das direkte Ziel, verfolgen Sie anschließend die gesamte Kette und bewerten Sie das Endziel anhand von Erreichbarkeit, URL-Struktur und thematischer Passung. Testen Sie relevante Domainvarianten und dokumentieren Sie die Ergebnisse.

Besonders nach einem Domainumzug oder einer Serveränderung lohnt sich ein systematischer Abgleich wichtiger URLs. So werden Schleifen, falsche Ziele, unnötige Zwischenstationen und nicht mehr erreichbare Seiten früh erkannt. Die Weiterleitung bleibt dadurch für Besucher, Suchmaschinen und die technische Wartung nachvollziehbar.
HTTP-Statuscodes verständlich erklärt: Bedeutung, Ursachen und Lösungen

Wer eine Website, eine API oder einen Onlineshop betreibt, kommt an HTTP-Statuscodes nicht vorbei. Sie zeigen an, ob eine Anfrage erfolgreich war, weitergeleitet wurde oder auf ein Problem gestoßen ist. Für Besucher erscheinen diese Informationen meist nur indirekt, etwa als „404 – Seite nicht gefunden“. Für Entwickler, Redaktionen und Administratoren sind sie jedoch wichtige Hinweise bei der Fehlersuche und bei der technischen Pflege einer Website.

Dieser Ratgeber erklärt HTTP-Statuscodes verständlich: von den fünf Codeklassen über häufige Fehler bis zu praktischen Schritten für die Analyse. Dabei geht es nicht nur darum, einzelne Nummern auswendig zu lernen. Entscheidend ist, den Kontext zu verstehen, die richtige Reaktion abzuleiten und zwischen einem vorübergehenden Problem, einer gewollten Weiterleitung und einem echten Konfigurationsfehler zu unterscheiden.

Was sind HTTP-Statuscodes?

Ein HTTP-Statuscode ist eine dreistellige Zahl, die ein Webserver als Teil seiner Antwort auf eine Anfrage zurückgibt. Ruft ein Browser eine URL auf, sendet er eine HTTP-Anfrage an den zuständigen Server. Dieser verarbeitet die Anfrage und antwortet unter anderem mit einem Statuscode.

Der Code beschreibt zunächst das Ergebnis dieser Verarbeitung. Ein erfolgreicher Abruf kann mit 200 beantwortet werden. Wenn eine angeforderte Ressource dauerhaft unter einer anderen Adresse liegt, kann der Server 301 senden. Ist die Ressource nicht vorhanden, lautet die Antwort häufig 404.

Ein Statuscode ist dabei nicht immer eine vollständige Fehlerdiagnose. Ein 500 sagt beispielsweise, dass auf dem Server ein interner Fehler aufgetreten ist. Die konkrete Ursache kann aber in einer fehlerhaften Anwendung, einer Datenbankverbindung, einer Serverkonfiguration oder einem anderen Bestandteil der Infrastruktur liegen. Für eine belastbare Analyse müssen deshalb zusätzlich Antworttext, Serverprotokolle, Anfrageadresse und Zeitpunkt betrachtet werden.

Die fünf Klassen der HTTP-Statuscodes

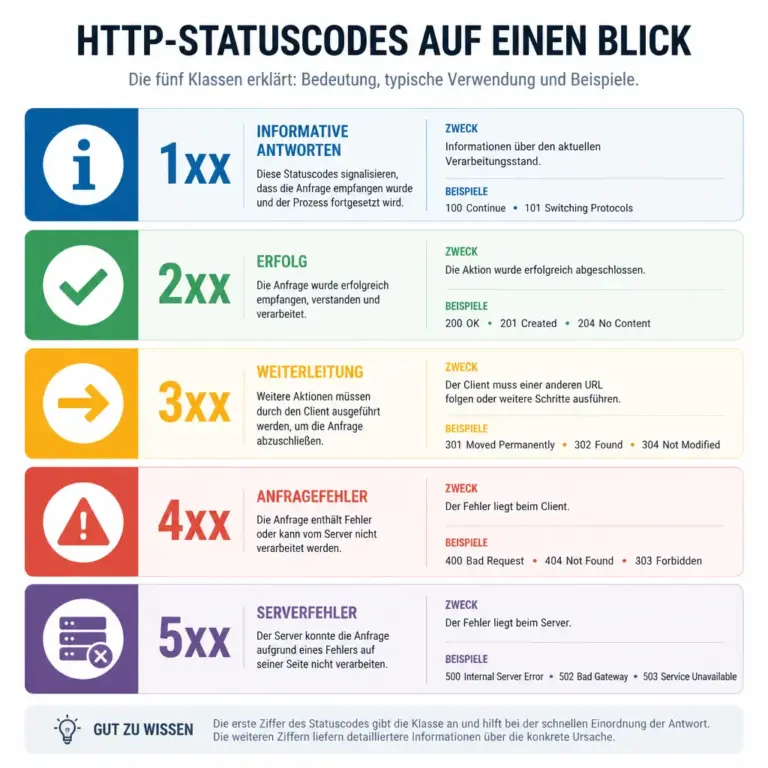
Die fu00fcnf Klassen der HTTP-Statuscodes von 1xx bis 5xx im u00dcberblick
Die erste Ziffer ordnet jeden HTTP-Statuscode einer grundlegenden Antwortklasse zu.

Die Grafik zeigt auf einen Blick, wie die erste Ziffer eines Statuscodes die Antwort einordnet. So lässt sich ein unbekannter Code schneller einem passenden Analyseweg zuordnen.

Die erste Ziffer ordnet jeden Statuscode einer von fünf Klassen zu. Diese Einteilung ist der wichtigste Ausgangspunkt, wenn Sie HTTP-Statuscodes verständlich einordnen möchten.

  • 1xx – Informative Antworten: Die Anfrage wurde angenommen oder wird noch verarbeitet. Diese Codes spielen im normalen Website-Alltag vergleichsweise selten eine sichtbare Rolle.
  • 2xx – Erfolgreiche Antworten: Die Anfrage wurde erfolgreich verarbeitet. Der genaue Code beschreibt, wie die Antwort zustande kam.
  • 3xx – Weiterleitungen: Für die angeforderte Ressource ist eine weitere Aktion erforderlich, häufig der Abruf einer anderen URL.
  • 4xx – Fehler auf Anfrage- oder Clientseite: Die Anfrage kann so nicht verarbeitet werden, etwa weil die Ressource fehlt, die Berechtigung nicht ausreicht oder die Anfrage ungültig ist.
  • 5xx – Serverfehler: Der Server konnte eine offenbar gültige Anfrage nicht erfolgreich bearbeiten.

Die Klassen sind eine Orientierung, aber keine absolute Schuldzuweisung. Ein 4xx-Code kann beispielsweise durch einen defekten Link auf einer Website ausgelöst werden, obwohl der Besucher nichts falsch gemacht hat. Umgekehrt kann ein falsch eingerichteter Server eine Anfrage mit einem unpassenden Statuscode beantworten.

Wichtige 2xx-Statuscodes: Anfrage erfolgreich

200 OK

200 OK ist die klassische erfolgreiche Antwort. Eine Website, ein Bild, ein Stylesheet oder eine API-Antwort wurde bereitgestellt. Bei einer normalen HTML-Seite ist dieser Code in der Regel das erwartete Ergebnis.

Ein 200 bedeutet jedoch nicht automatisch, dass die Seite inhaltlich oder technisch perfekt ist. Eine Fehlerseite kann versehentlich mit 200 ausgeliefert werden. Dann sieht der Server die Anfrage als erfolgreich, obwohl Besucher keine hilfreiche Zielseite erhalten. Solche falsch positiven Antworten erschweren die Analyse und können auch die Verarbeitung durch Suchmaschinen beeinflussen.

201 Created

201 Created wird häufig von APIs verwendet, wenn durch eine Anfrage eine neue Ressource angelegt wurde. Das kann zum Beispiel ein neu gespeicherter Datensatz sein. Bei klassischen Webseiten ist dieser Code weniger auffällig, bei Schnittstellen aber sehr nützlich, weil er klar zwischen einer erfolgreichen Erstellung und einer bloßen Abfrage unterscheidet.

204 No Content

204 No Content zeigt an, dass die Anfrage erfolgreich war, die Antwort aber keinen Inhaltskörper enthält. Dieser Statuscode passt etwa zu einer Aktion, bei der ein Datensatz gelöscht oder eine Änderung gespeichert wurde und keine weitere Darstellung zurückgesendet werden muss.

Wichtige 3xx-Statuscodes: Weiterleitungen richtig einsetzen

Weiterleitungen sind nicht grundsätzlich problematisch. Sie helfen bei Domainwechseln, URL-Änderungen, der Umstellung auf HTTPS oder bei der Zusammenführung ähnlicher Adressen. Wichtig ist, dass der verwendete Code zur geplanten Dauer und zur Art der Weiterleitung passt.

301 Moved Permanently

301 Moved Permanently signalisiert, dass eine Ressource dauerhaft an eine andere URL verschoben wurde. Dieser Code ist typisch, wenn eine alte Artikelseite durch eine neue URL ersetzt wird oder eine Website dauerhaft von einer alten Domain auf eine neue Domain umzieht.

Bei einem dauerhaften Umzug sollten interne Links, Navigation, XML-Sitemaps und gegebenenfalls externe Verweise nach Möglichkeit direkt auf die neue Adresse zeigen. Eine Weiterleitungskette, bei der URL A erst zu B und anschließend zu C führt, ist unnötig kompliziert. Besser ist meist eine direkte Weiterleitung von A nach C.

302 Found

302 Found wird traditionell für eine vorübergehende Weiterleitung verwendet. Die ursprüngliche URL bleibt dabei grundsätzlich relevant, während Besucher vorübergehend an eine andere Adresse geschickt werden. Der genaue Umgang mit Weiterleitungsstatus kann vom verwendeten Client und der konkreten HTTP-Version abhängen.

Ein häufiger Fehler ist, jede Weiterleitung pauschal als 302 einzurichten. Wenn der Umzug dauerhaft gemeint ist, sollte die Konfiguration diese Absicht klar ausdrücken. Andernfalls bleiben alte Adressen länger im System, als es nötig wäre, und technische Auswertungen werden schwerer verständlich.

307 und 308: Methode bleibt erhalten

307 Temporary Redirect und 308 Permanent Redirect entsprechen in ihrer Grundidee temporären beziehungsweise dauerhaften Weiterleitungen. Ein wichtiger Unterschied zu älteren Weiterleitungsvarianten besteht darin, dass die HTTP-Methode und der Anfrageinhalt erhalten bleiben sollen. Das ist bei API-Anfragen relevant, bei denen beispielsweise eine POST-Anfrage nicht unbeabsichtigt in eine GET-Anfrage umgewandelt werden darf.

Wichtige 4xx-Statuscodes: Fehler bei der Anfrage

400 Bad Request

400 Bad Request bedeutet, dass der Server die Anfrage als ungültig oder fehlerhaft einstuft. Mögliche Gründe sind eine unvollständige Anfrage, ungültige Parameter, fehlerhafte JSON-Daten oder eine beschädigte Anfrageübertragung.

Für eine gute Fehlersuche sollten Sie prüfen, ob die URL korrekt codiert ist, ob erforderliche Parameter vorhanden sind und ob die Anfrage das erwartete Format verwendet. Bei APIs ist eine präzise Fehlermeldung besonders hilfreich. Sie sollte möglichst erklären, welches Feld oder welcher Parameter nicht akzeptiert wurde, ohne vertrauliche interne Informationen preiszugeben.

401 Unauthorized

401 Unauthorized weist normalerweise darauf hin, dass eine Authentifizierung fehlt oder nicht akzeptiert wurde. Der Name ist etwas missverständlich: Es geht meist nicht um eine fehlende Berechtigung im engeren Sinn, sondern um die Identität beziehungsweise die Zugangsdaten.

Prüfen Sie bei diesem Statuscode, ob ein gültiges Zugriffstoken, Cookie oder eine andere erwartete Anmeldeinformation übertragen wird. Auch ein abgelaufenes Token oder eine falsch gesetzte Autorisierungszeile kann die Ursache sein.

403 Forbidden

403 Forbidden bedeutet, dass der Server die Anfrage verstanden hat, den Zugriff aber verweigert. Die Identität kann dabei bekannt sein oder die Ressource kann auch ohne Anmeldung grundsätzlich nicht zugänglich sein.

Typische Ursachen sind fehlende Rollen oder Rechte, gesperrte Verzeichnisse, eine Sicherheitsregel, eine blockierte IP-Adresse oder eine nicht erlaubte Zugriffsmethode. Bei der Analyse sollte geklärt werden, ob die Sperre beabsichtigt ist. Eine öffentlich verlinkte Seite, die versehentlich mit 403 geschützt wird, ist ein Konfigurationsproblem und kein Sicherheitsgewinn.

404 Not Found

404 Not Found ist einer der bekanntesten HTTP-Statuscodes. Er besagt, dass der Server für die angeforderte URL keine passende Ressource gefunden hat. Das kann eine gelöschte Seite, ein Tippfehler, ein veralteter interner Link oder eine falsch konfigurierte Route sein.

Eine hilfreiche 404-Seite sollte den Fehler erklären, zur Startseite oder zu passenden Inhalten führen und eine gut sichtbare Navigation bieten. Technisch ist es wichtig, die Ursache zu unterscheiden: Eine absichtlich entfernte Seite kann eine individuelle Lösung benötigen, während ein versehentlich veränderter Permalink eher durch einen korrekten Redirect behoben werden sollte. Nicht jede unbekannte URL muss auf eine thematisch unpassende Seite umgeleitet werden. Eine ehrliche 404-Antwort ist oft hilfreicher als eine pauschale Weiterleitung.

405 Method Not Allowed

405 Method Not Allowed zeigt, dass die Ressource existiert, die verwendete HTTP-Methode dort aber nicht erlaubt ist. Beispielsweise kann eine Route nur GET akzeptieren, während eine Anfrage mit POST eintrifft. Bei einer solchen Antwort sollte geprüft werden, ob die Client-Anwendung die richtige Methode verwendet und ob der Server die erlaubten Methoden korrekt meldet.

408 Request Timeout

408 Request Timeout tritt auf, wenn der Server nicht rechtzeitig eine vollständige Anfrage erhalten hat. Eine instabile Verbindung, ein überlasteter Client oder ein zu knapp gesetztes Zeitlimit können eine Rolle spielen. Einzelne vorübergehende Vorkommnisse sind nicht automatisch ein größeres Problem. Häufen sich die Antworten, sollten Netzwerk, Reverse Proxy und Serverauslastung gemeinsam untersucht werden.

409 Conflict

409 Conflict beschreibt einen Konflikt mit dem aktuellen Zustand der Ressource. Das kann bei gleichzeitigen Änderungen, doppelten Datensätzen oder widersprüchlichen Zuständen in einer Anwendung vorkommen. Eine gute API-Antwort sollte erklären, wie der Konflikt gelöst werden kann, beispielsweise durch erneutes Abrufen des aktuellen Zustands.

429 Too Many Requests

429 Too Many Requests bedeutet, dass ein Client in einem bestimmten Zeitraum zu viele Anfragen gesendet hat. Der Statuscode wird häufig bei Rate-Limits eingesetzt. Eine robuste Anwendung berücksichtigt gegebenenfalls den Header Retry-After und versucht es nach einer angemessenen Wartezeit erneut. Dauerhaftes, aggressives Wiederholen kann die Situation verschärfen.

Wichtige 5xx-Statuscodes: Probleme auf dem Server

500 Internal Server Error

500 Internal Server Error ist eine allgemeine Meldung für einen unerwarteten internen Fehler. Die Ursache kann im Anwendungscode, in einer Erweiterung, in einer Serverregel, in einer Datenbankverbindung oder in einer fehlerhaften Umgebungsvariable liegen.

Für die Analyse sind Server- und Anwendungsprotokolle meist aussagekräftiger als die öffentliche Fehlermeldung. Prüfen Sie, ob der Fehler nach einer Änderung begonnen hat, ob nur eine bestimmte URL betroffen ist und ob die Antwort reproduzierbar auftritt. Besucher sollten keine technischen Details wie Dateipfade, Zugangsdaten oder Stacktraces sehen.

502 Bad Gateway

502 Bad Gateway tritt häufig auf, wenn ein Gateway oder Reverse Proxy von einem nachgelagerten Server keine gültige Antwort erhält. Beteiligte Komponenten können beispielsweise ein Webserver, ein Anwendungsserver, ein CDN oder ein weiterer Dienst sein.

Bei diesem Code ist die Frage wichtig, welcher Dienst die Antwort tatsächlich erzeugt hat. Prüfen Sie deshalb die Kommunikation zwischen den beteiligten Ebenen, die Erreichbarkeit des Upstreams und die Protokolle beider Seiten. Ein Problem muss nicht auf dem System liegen, das im Browser sichtbar wird.

503 Service Unavailable

503 Service Unavailable signalisiert, dass der Dienst vorübergehend nicht verfügbar ist. Gründe können Wartungsarbeiten, Überlastung oder ein ausgefallener abhängiger Dienst sein. Wenn der Ausfall voraussichtlich vorübergehend ist, kann ein Hinweis auf eine spätere Wiederholung sinnvoll sein.

Bei geplanten Wartungen sollte die Antwort möglichst kontrolliert und konsistent erfolgen. Dauert ein 503 unerwartet lange an, sind Auslastung, Prozesse, Abhängigkeiten, Deployments und Gesundheitsprüfungen zu untersuchen.

504 Gateway Timeout

504 Gateway Timeout bedeutet, dass ein Gateway oder Proxy innerhalb seines Zeitlimits keine Antwort vom Upstream erhalten hat. Das kann an einer langsamen Datenbankabfrage, einem überlasteten Anwendungsserver, einem Netzwerkproblem oder einem zu kurzen Timeout liegen.

Einfach nur das Timeout zu erhöhen, löst die Ursache nicht zwingend. Besser ist es, langsame Verarbeitungsschritte zu identifizieren und zu prüfen, ob Anfragen effizienter gestaltet, Ergebnisse zwischengespeichert oder abhängige Dienste stabiler betrieben werden können.

HTTP-Statuscodes in der Praxis prüfen

Bei einer konkreten Auffälligkeit hilft ein strukturierter Ablauf. Beginnen Sie mit der exakten URL, dem Zeitpunkt und der verwendeten Anfrage. Ein Browser kann eine Seite anders darstellen als ein API-Client, weil Cookies, Cache, Weiterleitungen oder Authentifizierungsdaten unterschiedlich behandelt werden.

  1. Antwort nachvollziehen: Prüfen Sie Statuscode, Ziel-URL, Weiterleitungskette und relevante Antwort-Header.
  2. Fehler eingrenzen: Vergleichen Sie, ob das Problem bei anderen URLs, Nutzern, Geräten oder Zeitpunkten ebenfalls auftritt.
  3. Änderungen prüfen: Suchen Sie nach kürzlich geänderten Plugins, Deployments, DNS-Einträgen, Serverregeln oder Berechtigungen.
  4. Protokolle auswerten: Bei 5xx-Fehlern sind Webserver-, Anwendungs-, Datenbank- und Proxy-Logs besonders wertvoll.
  5. Korrektur verifizieren: Rufen Sie die Adresse erneut auf und prüfen Sie auch verwandte URLs, Weiterleitungen und interne Links.

Entwickler können zusätzlich mit Kommandozeilenwerkzeugen oder den Netzwerkfunktionen der Browser-Entwicklertools arbeiten. Für die Bewertung zählen nicht nur der erste sichtbare Code, sondern auch Weiterleitungen, Antwortzeiten, Cache-Header und die Frage, ob die Antwort für alle oder nur für bestimmte Anfragen auftritt.

HTTP-Statuscodes, SEO und Nutzerfreundlichkeit

Statuscodes beeinflussen die technische Zugänglichkeit einer Website und damit mittelbar auch ihre Auffindbarkeit. Suchmaschinen müssen erkennen können, ob eine Seite dauerhaft umgezogen, vorübergehend nicht verfügbar oder tatsächlich nicht vorhanden ist. Eine korrekte Weiterleitung hilft beim dauerhaften URL-Wechsel, während eine echte 404-Antwort den nicht vorhandenen Inhalt klar kennzeichnet.

Problematisch sind vor allem lange Weiterleitungsketten, viele unbeabsichtigte 404-Fehler und Fehlerseiten, die trotz fehlendem Inhalt mit 200 ausgeliefert werden. Auch kurzfristige 5xx-Probleme sollten ernst genommen werden, wenn sie regelmäßig auftreten. Technische Korrektheit allein reicht aber nicht: Eine verständliche 404-Seite, klare Navigation und hilfreiche Alternativen verbessern die Erfahrung der Besucher unmittelbar.

Häufige Fehler bei der Arbeit mit Statuscodes

  • Alle unbekannten URLs auf die Startseite umleiten: Das verschleiert fehlende Inhalte und führt Besucher oft an ein unpassendes Ziel.
  • 301 und 302 ohne klare Absicht verwenden: Die Weiterleitungsdauer sollte zur tatsächlichen Planung passen.
  • Nur den Browser prüfen: Cache und Cookies können ein Ergebnis beeinflussen. Eine zweite Anfrage ohne diese Faktoren kann zusätzliche Hinweise liefern.
  • Fehlercodes unterdrücken: Eine individuell gestaltete Fehlerseite sollte den korrekten HTTP-Statuscode weiterhin ausliefern.
  • 5xx-Probleme nur am Frontend untersuchen: Die Ursache liegt oft in einer tieferen Anwendungsschicht oder einer abhängigen Infrastruktur.
  • Technische Details öffentlich anzeigen: Interne Pfade, Konfigurationswerte und Stacktraces gehören in geschützte Protokolle, nicht in eine öffentliche Fehlermeldung.

FAQ

Was bedeutet ein HTTP-Statuscode?

Ein HTTP-Statuscode ist eine dreistellige Serverantwort auf eine HTTP-Anfrage. Er zeigt an, ob die Anfrage erfolgreich war, eine Weiterleitung benötigt oder auf ein Problem gestoßen ist.

Ist jeder 4xx-Statuscode ein Fehler des Besuchers?

Nein. Ein 4xx-Code beschreibt zwar ein Problem mit der Anfrage oder dem Zugriff, kann aber durch einen defekten Link, eine falsche Website-Konfiguration oder eine veraltete URL verursacht werden.

Was ist der Unterschied zwischen 401 und 403?

401 weist meist auf fehlende oder ungültige Authentifizierung hin. 403 bedeutet dagegen, dass der Server den Zugriff trotz grundsätzlich verstandener Anfrage verweigert.

Wann sollte ich 301 statt 302 verwenden?

Verwenden Sie eine dauerhafte Weiterleitung, wenn eine URL dauerhaft ersetzt wurde. Eine vorübergehende Weiterleitung passt, wenn die ursprüngliche Adresse grundsätzlich bestehen bleibt und nur zeitweise ein anderes Ziel verwendet wird.

Warum zeigt eine Seite 404 an, obwohl die Datei vorhanden ist?

Eine URL kann trotz vorhandener Datei durch Routing, Webserver-Regeln, Groß- und Kleinschreibung, falsche Pfade oder fehlende Berechtigungen nicht gefunden werden. Entscheidend ist, welche Ressource die Anwendung unter genau dieser URL erwartet.

Was sollte ich bei einem 500-Fehler zuerst prüfen?

Prüfen Sie Zeitpunkt, betroffene URL, kürzlich vorgenommene Änderungen und die Server- beziehungsweise Anwendungsprotokolle. Eine öffentliche Fehlermeldung allein enthält meist nicht genug Informationen für die Ursachenanalyse.

Sind Weiterleitungen schlecht für eine Website?

Nein. Sinnvoll eingesetzte Weiterleitungen sind ein normaler Bestandteil der Website-Pflege. Problematisch werden sie vor allem bei unnötigen Ketten, falschen Zieladressen oder einer unklaren Unterscheidung zwischen dauerhaftem und vorübergehendem Umzug.

Fazit: HTTP-Statuscodes verständlich nutzen

HTTP-Statuscodes sind kompakte Signale über den Zustand einer Anfrage. Die erste Ziffer liefert die grundlegende Einordnung: Erfolg, Weiterleitung, Anfrageproblem oder Serverfehler. Für die praktische Arbeit sind besonders 200, 301, 302, 404, 401, 403, 500, 502, 503 und 504 wichtig.

Wer Statuscodes nicht isoliert, sondern zusammen mit URL, Weiterleitung, Headern, Logs und Anwendungskontext betrachtet, kann Fehler schneller eingrenzen. Eine korrekte Antwort ist zugleich ein technisches Signal, eine Hilfe für Suchmaschinen und ein Bestandteil einer verständlichen Nutzererfahrung.