Die Datei robots.txt gehört zu den kleinsten, aber häufig missverstandenen Bestandteilen einer Website. Sie kann Suchmaschinen-Crawlern Hinweise geben, welche Bereiche sie abrufen dürfen und welche nicht. Gleichzeitig ist sie weder ein sicherer Zugriffsschutz noch eine Garantie dafür, dass Seiten aus dem Suchindex verschwinden. Wer die Datei richtig einordnet, kann Crawling-Ressourcen gezielter steuern, typische SEO-Fehler vermeiden und technische Probleme schneller erkennen.
Dieser Ratgeber zeigt, wie Sie robots.txt prüfen und verstehen, welche Direktiven relevant sind, wie Sie die Datei testen und welche Grenzen sie hat. Die Beispiele sind bewusst allgemein gehalten, damit Sie die Regeln auf unterschiedliche Content-Management-Systeme und Hosting-Umgebungen übertragen können.
Was ist eine robots.txt?
Die Datei robots.txt ist eine einfache Textdatei im Hauptverzeichnis einer Website. Sie ist normalerweise unter dieser Adresse erreichbar:
https://www.beispiel.de/robots.txtEin Crawler ruft diese Datei ab, bevor er weitere URLs derselben Website crawlt. Darin können Regeln stehen, die sich an bestimmte Crawler oder an alle Crawler richten. Die Regeln beziehen sich vor allem darauf, welche Pfade ein Crawler abrufen soll oder nicht abrufen soll.
Wichtig ist die Unterscheidung zwischen Crawling und Indexierung. Crawling bedeutet, dass ein Bot eine URL abruft und ihren Inhalt verarbeitet. Indexierung bedeutet, dass eine Suchmaschine eine URL in ihren Suchindex aufnimmt und sie möglicherweise in den Suchergebnissen anzeigt. Eine Sperre in der robots.txt verhindert in erster Linie den Abruf. Sie ist keine zuverlässige Anweisung, eine bereits bekannte URL aus dem Index zu entfernen.
Die Datei ist öffentlich. Jeder kann sie aufrufen und ihren Inhalt lesen. Deshalb sollten Sie dort keine vertraulichen Verzeichnisse, internen Projektnamen oder Hinweise auf sensible Systembereiche aufführen, wenn diese Informationen nicht öffentlich sichtbar sein sollen.
Warum sollte man robots.txt prüfen und verstehen?
Eine fehlerhafte robots.txt kann dazu führen, dass wichtige Inhalte, Produktseiten, Kategorien oder JavaScript- und CSS-Dateien nicht wie erwartet gecrawlt werden. Ein versehentlich gesetztes Disallow: / würde beispielsweise den gesamten Abruf einer Website für den betroffenen Crawler blockieren. Umgekehrt kann eine sehr großzügige Konfiguration unnötige URL-Varianten, Suchergebnisse oder Filterkombinationen crawlen lassen.
Die Prüfung ist besonders sinnvoll, wenn eine Website neu veröffentlicht, migriert oder technisch umgebaut wurde. Auch nach Änderungen am Shopsystem, an einem SEO-Plugin, an der Domainstruktur oder an wichtigen Verzeichnissen lohnt sich ein Blick auf die Datei. Sie sollten außerdem kontrollieren, ob die Datei tatsächlich unter der richtigen Domain und mit dem erwarteten Statuscode erreichbar ist.
Typische Ziele einer Prüfung
- prüfen, ob wichtige Inhalte versehentlich gesperrt werden;
- unnötige Crawling-Pfade wie interne Suchseiten oder bestimmte Parameter begrenzen;
- unbeabsichtigte Unterschiede zwischen www-, nicht-www-, HTTP- und HTTPS-Versionen erkennen;
- eine Sitemap-URL korrekt bekannt machen;
- Syntaxfehler und widersprüchliche Regeln identifizieren;
- feststellen, ob eine robots.txt fälschlich als Zugriffsschutz verwendet wird.
Die wichtigsten Bestandteile einer robots.txt
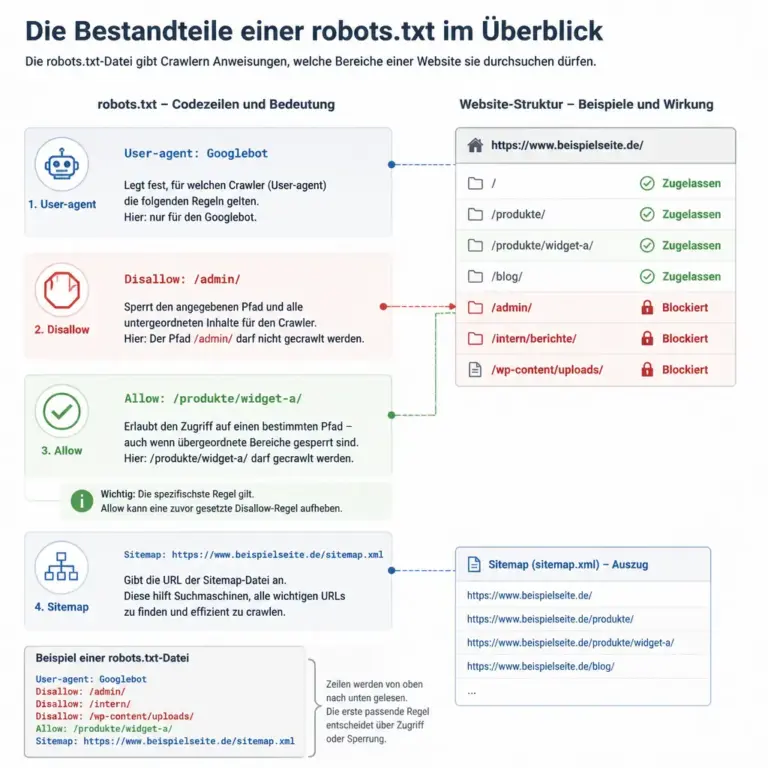
Achten Sie auf die Zuordnung zwischen einer Direktive und dem jeweiligen Pfad. Die Darstellung macht sichtbar, dass eine Regel nicht isoliert, sondern immer im Zusammenhang mit dem angesprochenen Crawler gelesen werden sollte.
Eine robots.txt besteht aus einzelnen Anweisungen. Die wichtigsten Elemente sind User-agent, Disallow, Allow und Sitemap. Leerzeilen werden häufig verwendet, um Regelgruppen übersichtlich voneinander zu trennen. Kommentare beginnen mit einem Doppelkreuz und werden von unterstützenden Crawlern ignoriert.
User-agent
Mit User-agent legen Sie fest, für welchen Crawler eine nachfolgende Regelgruppe gilt. Mit dem Sternchen sprechen Sie alle Crawler an:
User-agent: *Daneben können einzelne Crawler gezielt angesprochen werden. Das ist jedoch nur sinnvoll, wenn Sie einen konkreten technischen Grund haben und genau wissen, wie der jeweilige Crawler seine Regeln verarbeitet. Unterschiedliche Suchmaschinen oder Spezial-Crawler können eigene Bezeichnungen und eigene Interpretationen verwenden.
Disallow
Disallow kennzeichnet einen Pfad, den der betreffende Crawler nicht abrufen soll. Ein leerer Wert bedeutet normalerweise, dass kein Pfad gesperrt wird:
User-agent: *
Disallow:
Ein Pfad mit einem abschließenden Schrägstrich bezieht sich typischerweise auf diesen Verzeichnisbereich und seine Unterpfade:
User-agent: *
Disallow: /admin/
Das ist nicht dasselbe wie ein sicherer Schutz des Verzeichnisses. Der Server kann die angeforderte Ressource weiterhin ausliefern, wenn jemand die URL direkt aufruft.
Allow
Allow kann verwendet werden, um innerhalb eines gesperrten Bereichs einen bestimmten Pfad wieder freizugeben. Die genaue Auswertung kann von der Crawler-Implementierung und von konkurrierenden Regeln abhängen. Deshalb sollten Ausnahmen möglichst klar und sparsam formuliert werden.
User-agent: *
Disallow: /intern/
Allow: /intern/oeffentliches-dokument.pdf
Wenn Regeln kompliziert werden, ist es oft besser, die URL-Struktur oder die technische Auslieferung zu vereinfachen. Eine kurze, verständliche Datei ist leichter zu warten als eine Sammlung vieler Ausnahmen.
Sitemap
Mit Sitemap können Sie Suchmaschinen auf eine XML-Sitemap hinweisen. Die vollständige absolute URL ist empfehlenswert:
Sitemap: https://www.beispiel.de/sitemap.xmlEine Sitemap ist keine Erlaubnis zum Crawlen und ersetzt auch keine interne Verlinkung. Sie liefert lediglich eine zusätzliche Quelle für URLs, die eine Suchmaschine prüfen kann. In einer robots.txt können auch mehrere Sitemap-URLs angegeben werden, etwa wenn eine Website getrennte Sitemaps für Beiträge, Produkte und Kategorien verwendet.
So prüfen Sie Ihre robots.txt Schritt für Schritt
1. Die richtige Datei aufrufen
Rufen Sie die Datei direkt auf der betreffenden Host- und Protokollvariante auf. Eine robots.txt für https://www.beispiel.de gilt nicht automatisch für eine separate Subdomain wie https://shop.beispiel.de. Ebenso sollten Sie Weiterleitungen, unterschiedliche Domains und mögliche Staging-Umgebungen kontrollieren.
Prüfen Sie, ob die Antwort tatsächlich eine Textdatei mit den erwarteten Regeln ist. Eine HTML-Fehlerseite, ein Login, ein Serverfehler oder eine unerwartete Weiterleitung kann die Funktion beeinträchtigen. Eine temporäre Nichterreichbarkeit ist anders zu bewerten als eine bewusst leere Datei.
2. Inhalt und Format kontrollieren
Die Datei sollte gut lesbar sein und pro Zeile eine Anweisung enthalten. Achten Sie auf Tippfehler bei den Direktiven, überflüssige Leerzeichen, nicht beabsichtigte Sonderzeichen und Pfade, die nicht zur aktuellen Website-Struktur passen. Kommentare können erklären, warum eine Regel existiert und wer sie bei Änderungen überprüfen sollte.
Ein einfacher Anfang kann so aussehen:
User-agent: *
Disallow: /interne-suche/
Disallow: /konto/
Disallow: /warenkorb/
Sitemap: https://www.beispiel.de/sitemap.xml
Ob diese Regeln sinnvoll sind, hängt von Ihrer Website ab. Bei einer redaktionellen Website gibt es andere technische Bereiche als in einem Onlineshop. Übernehmen Sie Beispiele deshalb nicht blind.
3. Jede Regel auf wichtige URLs anwenden
Erstellen Sie eine kleine Liste wichtiger URL-Typen: Startseite, redaktioneller Beitrag, Produktseite, Kategorie, Bild- oder Dokumentseite sowie gegebenenfalls eine paginierte Übersichtsseite. Prüfen Sie anschließend, ob ein Disallow-Muster diese Pfade berührt. Besonders gefährlich sind sehr allgemeine Muster wie ein gesperrter Ordnername, der auch wichtige Inhalte enthält.
Denken Sie außerdem an Verzeichnisse für Ressourcen. Eine Suchmaschine muss nicht jede technische Datei indexieren, benötigt aber gegebenenfalls Zugriff auf Ressourcen, um eine Seite zu rendern und ihre Inhalte richtig zu verstehen. Sperren Sie CSS-, JavaScript- oder Bildpfade daher nicht pauschal, ohne die Auswirkungen zu prüfen.
4. Mit einem geeigneten Testwerkzeug nachprüfen
Für eine zusätzliche Kontrolle können Sie die Prüf- und Berichtsfunktionen der jeweiligen Suchmaschinen-Tools verwenden, sofern sie für Ihre Property verfügbar sind. Solche Werkzeuge helfen dabei, einzelne URLs gegen eine veröffentlichte robots.txt zu beurteilen. Sie ersetzen jedoch nicht die manuelle Prüfung der Datei und der tatsächlichen Serverantwort.
Testen Sie nicht nur eine Muster-URL. Ein erfolgreicher Test für eine Produktseite sagt wenig aus, wenn beispielsweise alle Kategorieseiten oder die Sitemap blockiert sind. Prüfen Sie repräsentative URL-Typen und wiederholen Sie die Kontrolle nach jeder Änderung.
Häufige Fehler und ihre Folgen
Die gesamte Website versehentlich sperren
Diese Regel ist besonders weitreichend:
User-agent: *
Disallow: /
Sie kann in einer Entwicklungsumgebung sinnvoll sein, ist für eine öffentlich auffindbare Produktionswebsite aber meist problematisch. Ein häufiger Fehler besteht darin, diese Einstellung beim Wechsel von Staging zu Live zu übernehmen. Kontrollieren Sie deshalb nach einem Launch sofort die robots.txt und wichtige URLs.
Wichtige Verzeichnisse blockieren
Ein Pfad wie /blog/, /content/ oder /produkte/ kann je nach Website zentrale Inhalte enthalten. Auch scheinbar technische Ordner können Bilder, Skripte oder andere Ressourcen bereitstellen. Prüfen Sie zuerst, welche Dateien und URL-Typen tatsächlich darunter liegen.
robots.txt mit noindex verwechseln
Die robots.txt ist kein zuverlässiger Ersatz für eine noindex-Anweisung. Wenn eine Suchmaschine eine URL nicht abrufen darf, kann sie deren Inhalt und ein dort gesetztes noindex unter Umständen nicht lesen. Für die Indexierungssteuerung müssen Sie die passende Methode verwenden, beispielsweise ein Robots-Meta-Element oder einen entsprechenden HTTP-Header, sofern der Crawler die Seite abrufen darf.
Wenn eine bereits indexierte URL dauerhaft aus den Suchergebnissen verschwinden soll, sind je nach Fall andere Maßnahmen erforderlich. Dazu gehören die korrekte Indexierungsanweisung, die Entfernung oder Weiterleitung des Inhalts und gegebenenfalls die Nutzung von Funktionen zur vorübergehenden Entfernung in den Webmaster-Werkzeugen.
Interne Suchseiten und Parameter unüberlegt blockieren
Interne Suchseiten, Sortierungen und Filter können eine große Zahl ähnlicher URLs erzeugen. Das kann ein berechtigter Anlass sein, bestimmte Pfade zu begrenzen. Eine pauschale Sperre nach einem allgemeinen Parameterzeichen kann jedoch auch wertvolle URLs treffen. Prüfen Sie zuerst, welche Parameter tatsächlich vorkommen und ob sie für Nutzer oder Suchmaschinen relevante Inhalte erzeugen.
Die Sitemap falsch eintragen
Eine Sitemap-Angabe mit Tippfehler, falscher Domain oder nicht erreichbarer Datei hilft nicht weiter. Die Sitemap sollte auf eine gültige, öffentlich abrufbare XML-Datei zeigen. Achten Sie bei mehreren Sprach- oder Domainvarianten darauf, dass die URL zur jeweiligen Website gehört und die enthaltenen URLs zur richtigen Property passen.
robots.txt als Zugriffsschutz: Was sie nicht kann
Die Datei richtet sich an kooperative Crawler. Sie verhindert nicht, dass Menschen eine URL aufrufen, und sie hält keinen böswilligen Bot zuverlässig auf. Auch sensible Daten, Backups, Zugangsdaten, interne Dokumente oder Verwaltungsoberflächen gehören nicht lediglich durch eine robots.txt geschützt ins Internet.
Für vertrauliche Bereiche benötigen Sie eine serverseitige Zugriffskontrolle, beispielsweise Authentifizierung, geeignete Berechtigungen oder eine Beschränkung auf ein internes Netzwerk. Zusätzlich sollten sensible Dateien gar nicht erst öffentlich gespeichert werden. Eine robots.txt darf höchstens ergänzend eingesetzt werden, nicht als Sicherheitsmaßnahme.
Beachten Sie auch, dass gesperrte URLs unter Umständen trotzdem bekannt werden können, etwa durch externe Verweise. Suchmaschinen können dann möglicherweise die URL, aber nicht den Inhalt anzeigen. Daraus folgt: Eine Sperre kann Sichtbarkeit nicht in jedem Fall verhindern.
Praktische Entscheidungsregeln für die eigene Website
Bevor Sie eine neue Regel hinzufügen, beantworten Sie einige konkrete Fragen:
- Welches Problem soll gelöst werden? Benennen Sie den konkreten URL-Bereich oder das Crawling-Problem.
- Welche URLs sind betroffen? Prüfen Sie echte Beispieladressen und nicht nur die Ordnerbezeichnung.
- Soll der Inhalt nicht gecrawlt oder nicht indexiert werden? Wählen Sie die Maßnahme nach dem Ziel aus.
- Ist die Sperre für alle Crawler notwendig? Eine allgemeine Regel ist weitreichender als eine gezielte Regel.
- Wie wird die Änderung kontrolliert? Legen Sie fest, welche URLs nach der Veröffentlichung getestet werden.
- Wer pflegt die Datei? Dokumentieren Sie Verantwortlichkeit und Anlass der Regel, damit sie nicht dauerhaft aus Gewohnheit bestehen bleibt.
In vielen Fällen ist eine saubere interne Verlinkung, eine konsistente URL-Struktur und eine korrekte Indexierungssteuerung nachhaltiger als eine lange Liste von Sperren. Die robots.txt sollte ein gezieltes technisches Werkzeug bleiben.
robots.txt nach einem Relaunch oder Domainwechsel prüfen
Bei einem Relaunch ändern sich häufig Verzeichnisse, Parameter, Weiterleitungen und Sitemap-Adressen gleichzeitig. Führen Sie die Prüfung deshalb als festen Bestandteil der technischen Abnahme durch. Kontrollieren Sie die Datei auf der produktiven Domain, testen Sie die wichtigsten URL-Typen und stellen Sie sicher, dass die Sitemap aktualisiert wurde.
Vergleichen Sie die neue Version mit der alten Datei, aber übernehmen Sie nicht automatisch jede historische Regel. Eine frühere Sperre kann für die neue Struktur falsch sein. Prüfen Sie außerdem, ob ein temporärer Schutz aus der Entwicklungsphase entfernt wurde und ob die Domain nicht versehentlich auf eine fremde oder nicht öffentliche Sitemap verweist.
Nach dem Launch sollten Sie die Berichte der Suchmaschinen beobachten. Ein einzelner Hinweis ist nicht immer ein Beweis für einen Fehler, aber wiederkehrende Crawling- oder Indexierungsprobleme verdienen eine genaue Untersuchung der betroffenen URLs, Serverantworten, Canonicals und robots.txt-Regeln.
FAQ
Wo muss die robots.txt liegen?
Sie gehört in das Hauptverzeichnis der jeweiligen Host- und Protokollvariante und sollte unter /robots.txt erreichbar sein. Eine Datei in einem Unterordner gilt nicht automatisch für die gesamte Domain. Für Subdomains muss die Konfiguration separat betrachtet werden.
Kann robots.txt eine Seite aus Google entfernen?
Eine Sperre verhindert in erster Linie den Abruf und ist keine zuverlässige Entfernung aus dem Index. Für eine kontrollierte Indexierung benötigen Sie eine passende Maßnahme, die der Crawler lesen kann, oder eine andere geeignete Entfernung beziehungsweise Deindexierung im jeweiligen Fall.
Ist eine leere robots.txt problematisch?
Eine leere Datei bedeutet üblicherweise, dass keine Pfade ausdrücklich gesperrt werden. Das kann für eine kleine Website völlig in Ordnung sein. Entscheidend ist, ob die Website besondere Crawling-Probleme hat und ob andere technische Maßnahmen die gewünschten Signale liefern.
Sollte ich CSS und JavaScript sperren?
Eine pauschale Sperre ist meist keine gute Idee. Suchmaschinen können Ressourcen benötigen, um Layout und Inhalte einer Seite zu verstehen. Prüfen Sie einzelne Pfade und sperren Sie nur Bereiche, deren Abruf tatsächlich unnötig ist und keine wichtige Darstellung oder Funktionsweise beeinflusst.
Wie oft sollte man robots.txt prüfen?
Eine feste monatliche Pflicht gibt es nicht. Sinnvoll ist eine Prüfung bei Relaunches, Migrationen, Änderungen am Shopsystem, Wechseln von SEO-Erweiterungen und auffälligen Crawling- oder Indexierungsdaten. Zusätzlich kann eine regelmäßige technische Checkliste helfen, unbemerkte Änderungen zu erkennen.
Kann ich mit robots.txt schädliche Bots blockieren?
Nur kooperative Bots können die Datei freiwillig beachten. Für unerwünschten oder missbräuchlichen Traffic benötigen Sie serverseitige oder vorgeschaltete Schutzmechanismen. Die robots.txt sollte nicht als Sicherheits- oder Lastschutz betrachtet werden.
Was bedeutet ein Pfad mit Schrägstrich am Ende?
Ein abschließender Schrägstrich beschreibt üblicherweise einen Verzeichnisbereich und seine Unterpfade. Ob ein konkretes Muster eine URL erfasst, hängt jedoch von der Schreibweise und der Auswertung des Crawlers ab. Testen Sie daher reale Beispiel-URLs, insbesondere bei ähnlichen Pfaden.
Fazit: robots.txt systematisch prüfen
Wer robots.txt prüfen und verstehen möchte, sollte nicht nur nach einer einzelnen fehlerhaften Zeile suchen. Entscheidend ist das Zusammenspiel aus URL-Struktur, Crawling, Indexierung, Ressourcen, Sitemaps und Zugriffsschutz. Rufen Sie die Datei auf der richtigen Domain auf, lesen Sie jede Regel im Kontext, testen Sie wichtige URL-Typen und dokumentieren Sie bewusst gesetzte Ausnahmen.
Eine gute robots.txt ist nicht möglichst lang, sondern nachvollziehbar und zielgerichtet. Verwenden Sie sie für begrenzte Crawling-Steuerung, aber nicht für vertrauliche Daten oder als Ersatz für noindex. Nach technischen Änderungen sollte die Prüfung Teil der Abnahme sein. So erkennen Sie verhinderte Crawling-Zugriffe früh und schaffen eine verlässlichere Grundlage für die technische Suchmaschinenoptimierung.