Sitemap bei Google einreichen: Anleitung, Fehlerbehebung und SEO-Tipps

Eine Sitemap hilft Suchmaschinen dabei, wichtige URLs einer Website zu entdecken und ihre Zusammenhänge besser zu verstehen. Besonders bei neuen, umfangreichen oder regelmäßig aktualisierten Websites kann es sinnvoll sein, die Sitemap bei Google einzureichen. Der Vorgang ist unkompliziert, ersetzt jedoch weder hochwertige Inhalte noch eine technisch erreichbare Website.

In diesem Ratgeber erfahren Sie, was eine Sitemap leistet, wie Sie sie in der Google Search Console einreichen, welche Dateiformate geeignet sind und wie Sie typische Fehler systematisch beheben. Außerdem geht es darum, wann eine Einreichung sinnvoll ist und welche Erwartungen realistisch sind.

Was ist eine Sitemap?

Eine Sitemap ist eine maschinenlesbare Datei, in der wichtige URLs einer Website aufgeführt werden. Für klassische Websites wird meist eine XML-Sitemap verwendet. Sie kann Suchmaschinen zusätzliche Hinweise zu Seiten, Beiträgen, Bildern oder Videos geben und die Orientierung in einer größeren Website erleichtern.

Eine XML-Sitemap ist keine vollständige Kopie der Website und auch kein Inhaltsverzeichnis für Besucher. Sie sollte vor allem URLs enthalten, die tatsächlich in den Google-Index aufgenommen werden sollen. Nicht relevante, doppelte, gelöschte oder ausdrücklich gesperrte Seiten gehören in der Regel nicht hinein.

Viele Content-Management-Systeme und SEO-Erweiterungen erzeugen eine Sitemap automatisch. Häufig liegt sie beispielsweise unter einer Adresse wie https://www.beispiel.de/sitemap.xml. Bei manchen Systemen gibt es stattdessen eine Sitemap-Indexdatei, die auf mehrere einzelne Sitemaps verweist.

Warum sollte man eine Sitemap bei Google einreichen?
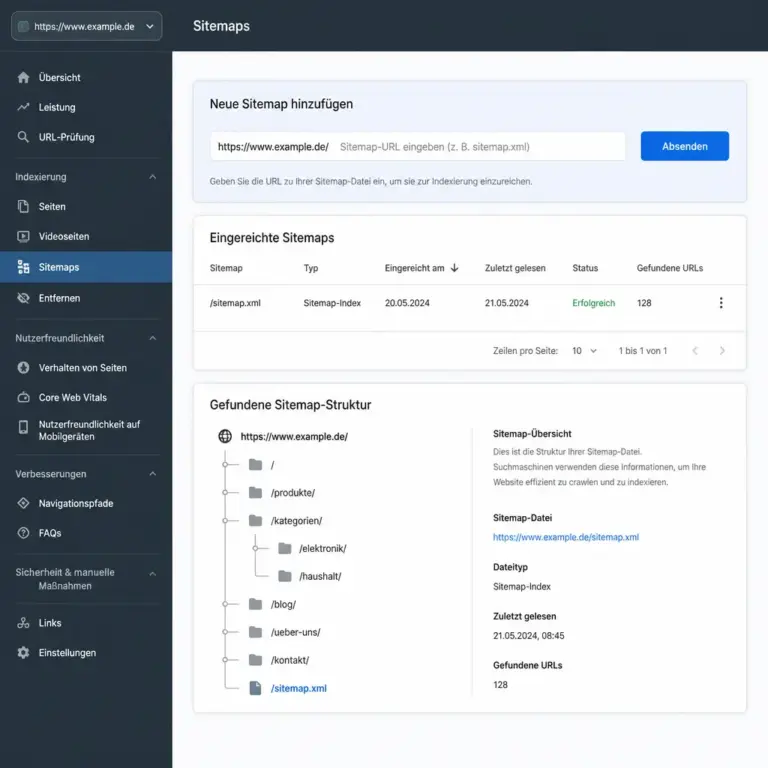
Eingabebereich zum Einreichen einer Sitemap in einer Suchmaschinenverwaltung
Die Sitemap wird über den dafür vorgesehenen Bereich der Search Console übermittelt.

Die Abbildung zeigt, wo der Pfad der Sitemap eingetragen wird und warum die Auswahl der richtigen Website-Property wichtig ist. Leser sollten auf die vollständige URL und den anschließenden Statusbericht achten.

Google kann Sitemaps häufig auch selbst entdecken, etwa über interne Links oder einen Eintrag in der Datei robots.txt. Die manuelle Einreichung über die Google Search Console schafft jedoch einen klaren Kommunikationsweg und liefert zusätzliche Informationen zum Verarbeitungsstatus.

  • Bessere Auffindbarkeit: Neue oder tief verschachtelte URLs können leichter entdeckt werden, sofern sie technisch zugänglich sind.
  • Mehr Übersicht: Die Search Console zeigt, ob Google die angegebene Sitemap abrufen und verarbeiten konnte.
  • Frühere Fehlererkennung: Ungültige URLs, Abrufprobleme oder Formatfehler werden eher sichtbar.
  • Unterstützung bei großen Websites: Viele URLs lassen sich strukturierter an Google übermitteln.
  • Hilfreich bei Änderungen: Nach einem Relaunch oder einer größeren Überarbeitung kann die aktuelle Sitemap die Orientierung unterstützen.

Wichtig ist die richtige Erwartung: Eine eingereichte Sitemap garantiert weder eine Indexierung noch gute Rankings. Google entscheidet für jede URL unabhängig, ob sie gecrawlt, indexiert und in den Suchergebnissen angezeigt wird.

Voraussetzungen vor der Einreichung

Bevor Sie die Sitemap bei Google einreichen, sollten einige Grundlagen stimmen. Dadurch vermeiden Sie, dass die Search Console zwar eine Datei akzeptiert, diese aber viele problematische URLs enthält.

Die richtige Website-Property auswählen

Für die Google Search Console benötigen Sie eine bestätigte Property. Dabei muss die Sitemap zur richtigen Website und zum passenden Protokoll gehören. Eine Sitemap für https://www.beispiel.de sollte nicht versehentlich in einer Property für eine andere Domain oder ausschließlich für http:// eingereicht werden.

Bei Domain-Properties werden mehrere Varianten einer Domain zusammengefasst. Bei URL-Präfix-Properties ist der erfasste Bereich enger. Prüfen Sie deshalb vor dem Absenden, ob Sie sich in der richtigen Property befinden.

Die Sitemap muss erreichbar sein

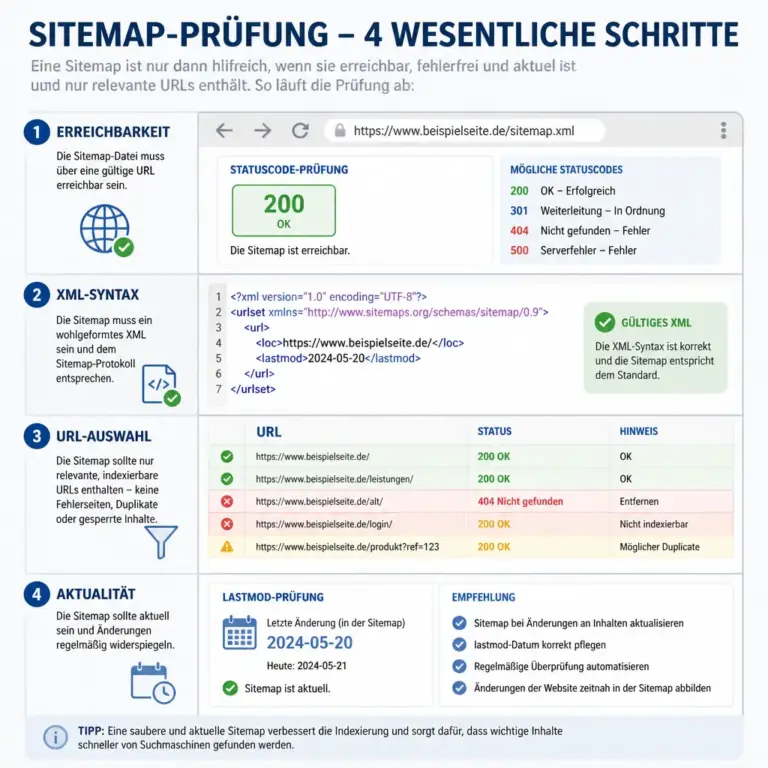
Rufen Sie die Sitemap zunächst selbst im Browser auf. Sie sollte ohne Login, Blockierung oder Weiterleitungskette erreichbar sein. Eine XML-Datei muss nicht besonders lesefreundlich aussehen; entscheidend ist, dass der Server sie korrekt ausliefert und der Inhalt gültig ist.

Prüfen Sie außerdem, ob die Sitemap nicht versehentlich durch eine Firewall, ein Sicherheits-Plugin oder eine Zugriffsbeschränkung blockiert wird. Bei einer geschützten Entwicklungsumgebung kann Google die Datei nicht zuverlässig abrufen.

Nur kanonische und indexierbare URLs aufnehmen

Die enthaltenen URLs sollten grundsätzlich erreichbar sein und eine sinnvolle Indexierung ermöglichen. Entfernen Sie insbesondere URLs, die auf eine andere Adresse weiterleiten, einen Fehlerstatus liefern oder per noindex von der Indexierung ausgeschlossen sind.

Auch Parameter-URLs, interne Suchergebnisse, Filterkombinationen und nahezu identische Varianten können eine Sitemap unnötig aufblähen. Die Datei sollte die wichtigsten Inhalte priorisieren, nicht jede technisch erzeugbare URL dokumentieren.

Sitemap bei Google einreichen: Schritt für Schritt

Die Einreichung erfolgt in der Google Search Console. Die Bezeichnungen der Oberfläche können sich gelegentlich ändern, das grundlegende Vorgehen bleibt jedoch ähnlich.

1. Google Search Console öffnen

Melden Sie sich mit dem Google-Konto an, das Zugriff auf die betreffende Property besitzt. Wählen Sie anschließend im Auswahlfeld die Website aus, für die Sie die Sitemap einreichen möchten.

2. Zum Bereich für Sitemaps wechseln

Öffnen Sie in der Navigation den Bereich Sitemaps. Dort finden Sie ein Eingabefeld, über das eine neue Sitemap übermittelt werden kann. Bereits bekannte Dateien und deren Status werden meist darunter angezeigt.

3. Sitemap-URL eintragen

Bei vielen Properties tragen Sie nicht die komplette Domain, sondern nur den Pfad der Sitemap ein, zum Beispiel sitemap.xml oder sitemap_index.xml. Achten Sie genau auf Schreibweise, Groß- und Kleinschreibung sowie den verwendeten Dateinamen.

Wenn die Search Console bereits einen Teil der URL vorausfüllt, ergänzen Sie nur den fehlenden Pfad. Prüfen Sie vor dem Absenden, ob die daraus entstehende vollständige Adresse tatsächlich auf die gewünschte Datei zeigt.

4. Übermittlung absenden

Klicken Sie auf die Schaltfläche zum Einreichen. Google versucht anschließend, die Datei abzurufen und zu verarbeiten. Das Ergebnis kann je nach Umfang, Serverreaktion und aktueller Verarbeitung nicht sofort vollständig sichtbar sein.

5. Status kontrollieren

Sehen Sie später erneut im Sitemap-Bericht nach. Ein erfolgreicher Abruf bedeutet, dass Google die Datei erreichen und grundsätzlich verarbeiten konnte. Das ist jedoch nicht dasselbe wie die Indexierung jeder einzelnen enthaltenen URL.

Bei einer Sitemap-Indexdatei kann Google zusätzlich einzelne untergeordnete Sitemaps verarbeiten. Kontrollieren Sie auch diese Einträge, wenn im Bericht Warnungen oder Fehler auftauchen.

Welche Sitemap-Formate unterstützt Google?

Für die meisten Websites ist eine XML-Sitemap die beste Wahl. Sie kann einzelne Seiten-URLs oder Verweise auf weitere Sitemap-Dateien enthalten. Eine Sitemap-Indexdatei ist besonders praktisch, wenn die Website so groß ist, dass mehrere Dateien verwaltet werden müssen.

Je nach Website-Typ können außerdem spezielle Sitemaps für Bilder, Videos oder Nachrichten relevant sein. Sie sind nicht automatisch für jede Website erforderlich. Entscheidend ist, ob der betreffende Inhalt tatsächlich einen zusätzlichen strukturierten Hinweis benötigt und ob das verwendete System ihn korrekt erzeugt.

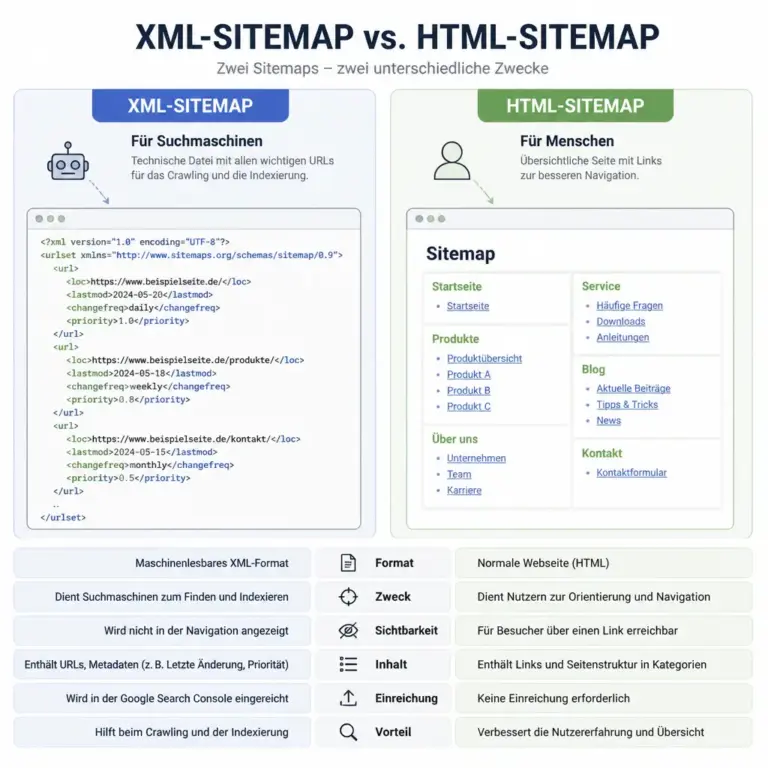
Eine HTML-Seite mit einer Liste von Links ist keine XML-Sitemap im engeren Sinn. Sie kann für Besucher und interne Verlinkung nützlich sein, wird aber in der Search Console nicht wie eine XML-Sitemap behandelt.

Was gehört in eine gute XML-Sitemap?

Eine gute Sitemap ist aktuell, übersichtlich und auf wertvolle Inhalte konzentriert. Für jede URL sollten mehrere Kriterien erfüllt sein:

  • Die Adresse verwendet das bevorzugte Protokoll, üblicherweise HTTPS.
  • Die URL ist mit dem Statuscode 200 erreichbar oder wird technisch korrekt ausgeliefert.
  • Die Seite ist nicht durch noindex ausgeschlossen.
  • Die URL entspricht der bevorzugten kanonischen Version.
  • Der Inhalt ist für Nutzer relevant und nicht bloß eine technische Variante.
  • Die Datei enthält keine veralteten oder dauerhaft entfernten Adressen.

Das Änderungsdatum einer URL, häufig als lastmod angegeben, sollte nur gepflegt werden, wenn sich der wesentliche Inhalt tatsächlich geändert hat. Ein bei jedem Aufruf automatisch aktualisiertes Datum liefert keinen verlässlichen Hinweis und kann die Aussagekraft der Sitemap schwächen.

Die Prioritätsangaben und Änderungsfrequenzen, die manche Generatoren anbieten, sind kein Ersatz für eine gute Website-Struktur. Verwenden Sie solche Angaben nur, wenn Ihr System sie sinnvoll und konsistent erzeugt.

Typische Fehler beim Einreichen einer Sitemap

Wenn Google eine Sitemap nicht verarbeiten kann, liegt die Ursache häufig nicht bei der Search Console selbst. Prüfen Sie die Datei und die betroffenen URLs in mehreren Schritten.

Die Sitemap wurde nicht gefunden

Eine Meldung wie Sitemap konnte nicht abgerufen werden kann auf eine falsche URL, einen Serverfehler, eine Blockierung oder eine kurzfristige Nichterreichbarkeit hindeuten. Öffnen Sie die Datei im Browser und prüfen Sie zusätzlich die Server- und Sicherheitsprotokolle.

Ungültiges XML oder falsche Kodierung

XML verlangt eine korrekte Struktur. Nicht maskierte Sonderzeichen, beschädigte Zeichenkodierungen, zusätzliche Inhalte vor der XML-Deklaration oder fehlerhafte Tags können die Verarbeitung verhindern. Lassen Sie die Datei gegebenenfalls mit einem geeigneten XML-Prüfwerkzeug validieren.

URLs aus einer anderen Domain

Die Sitemap sollte zum vorgesehenen Website-Bereich passen. Verweise auf eine fremde Domain oder eine nicht passende Subdomain können zu Warnungen führen. Prüfen Sie auch, ob www- und non-www-Varianten sowie HTTP und HTTPS konsistent verwendet werden.

Weiterleitungen und Fehlerseiten

Eine Sitemap mit vielen Weiterleitungen, nicht gefundenen Seiten oder Serverfehlern ist ein deutliches Wartungssignal. Aktualisieren Sie den Generator, entfernen Sie gelöschte URLs und ersetzen Sie alte Adressen durch ihre aktuelle kanonische Version.

Die Sitemap ist blockiert

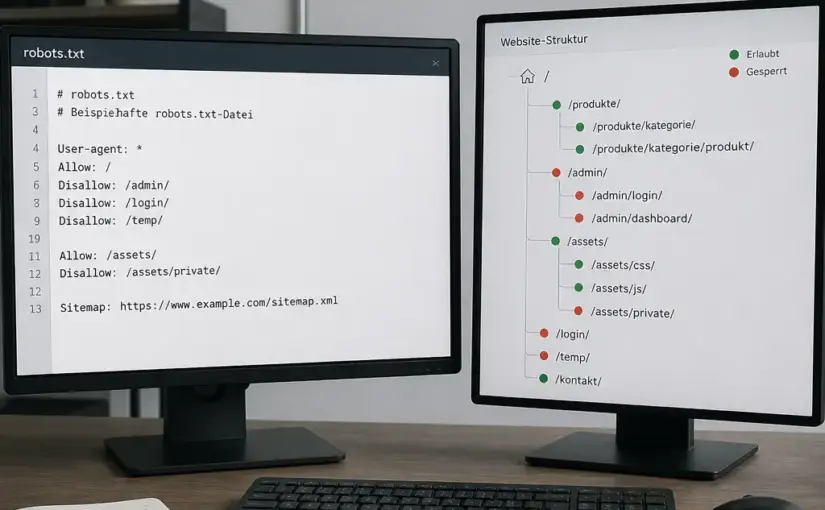
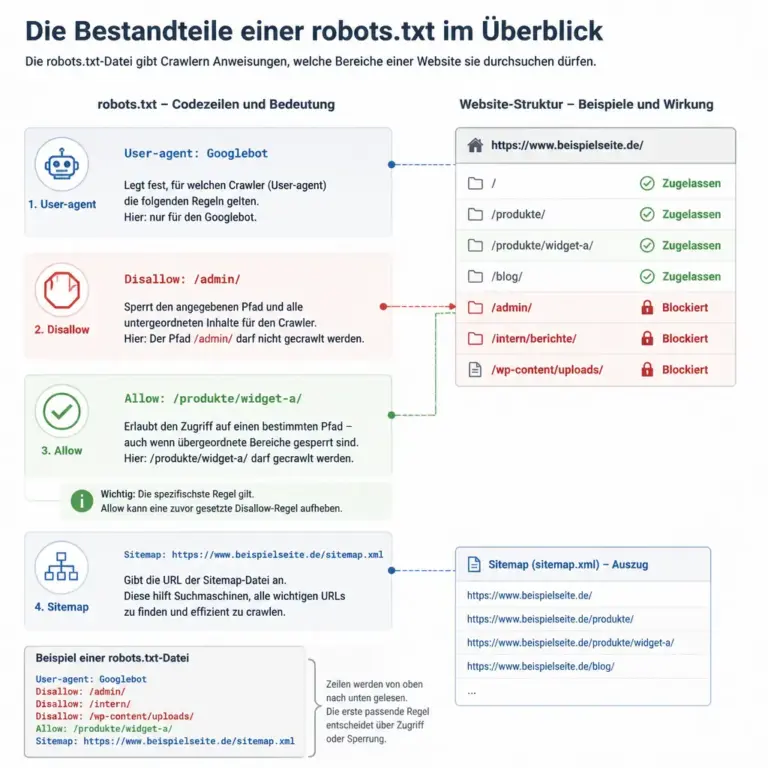
Die Datei darf nicht durch robots.txt, Zugriffsschutz oder eine Serverregel unerreichbar sein. Die robots.txt kann zusätzlich die vollständige Sitemap-Adresse nennen, etwa mit einer Zeile wie Sitemap: https://www.beispiel.de/sitemap.xml. Das ersetzt die Einreichung in der Search Console nicht zwingend, verbessert aber die Auffindbarkeit.

Sitemap nach einem Relaunch oder einer Migration

Nach einem Domainwechsel, einer Umstellung auf HTTPS oder einer neuen URL-Struktur sollten Sie besonders sorgfältig vorgehen. Richten Sie zunächst die passenden Properties in der Search Console ein und stellen Sie sicher, dass die neue Sitemap ausschließlich die neuen, erreichbaren URLs enthält.

Weiterleitungen von alten auf neue Adressen sollten dauerhaft und inhaltlich passend eingerichtet werden. Eine Sitemap mit alten URLs hilft nach einer Migration nur begrenzt. Sie sollte vielmehr den aktuellen Zielzustand abbilden, während interne Links, kanonische Angaben und Weiterleitungen konsistent auf die neue Struktur verweisen.

Bei einer größeren Umstellung empfiehlt sich eine technische Prüfung nach dem Livegang. Kontrollieren Sie unter anderem wichtige Statuscodes, die robots.txt, Canonical-Tags, interne Verlinkung und die Abdeckung relevanter Seiten. Die Sitemap ist dabei ein Kontrollinstrument, aber keine vollständige Relaunch-Prüfung.

Wie oft sollte man eine Sitemap einreichen?

Eine Sitemap muss normalerweise nicht nach jeder kleinen Änderung erneut eingereicht werden. Wenn die Datei unter derselben URL automatisch aktualisiert wird, kann Google die Änderungen bei späteren Abrufen erkennen.

Eine erneute Übermittlung kann sinnvoll sein, wenn sich der Dateipfad geändert hat, eine neue Sitemap-Indexdatei verwendet wird oder die Website nach einer größeren technischen Änderung aktualisiert wurde. Das wiederholte Einreichen derselben unveränderten Datei beschleunigt die Indexierung nicht automatisch.

Wichtiger als häufiges Absenden sind eine stabile Erreichbarkeit, korrekte URLs und eine nachvollziehbare Website-Struktur. Für einzelne besonders wichtige neue Seiten kann zusätzlich die Funktion zur Prüfung einer einzelnen URL in der Search Console relevant sein. Auch sie garantiert jedoch keine sofortige Aufnahme in den Index.

Sitemap und SEO: Was sie leisten und was nicht

Eine Sitemap verbessert nicht direkt die Qualität eines Textes, die Nutzererfahrung oder die Autorität einer Website. Sie kann Google jedoch helfen, bereits vorhandene Inhalte effizienter zu entdecken. Der größte Nutzen entsteht deshalb, wenn die technischen Grundlagen und die Inhalte gleichzeitig gepflegt werden.

Für eine nachhaltige Suchmaschinenoptimierung sind unter anderem klare interne Links, hilfreiche und eigenständige Inhalte, eine gute mobile Darstellung, kurze Ladezeiten sowie verständliche Seitentitel und Beschreibungen wichtig. Eine Sitemap kann diese Maßnahmen ergänzen, aber nicht ersetzen.

Bei kleinen Websites mit gut verlinkten Seiten ist der zusätzliche Effekt oft begrenzt. Bei großen Onlineshops, Nachrichtenseiten, Portalen, vielen Beiträgen oder neuen Websites mit wenigen externen Verweisen kann eine gepflegte Sitemap dagegen besonders nützlich sein.

Praktische Checkliste für die Einreichung

  • Ist die richtige Property in der Google Search Console ausgewählt?
  • Ist die Sitemap-URL ohne Login und ohne unerwartete Blockierung erreichbar?
  • Enthält die Datei nur aktuelle, kanonische und indexierbare URLs?
  • Verwendet die Sitemap die richtige Domain- und Protokollvariante?
  • Sind Weiterleitungen, Fehlerseiten und gelöschte URLs entfernt?
  • Ist die XML-Struktur gültig?
  • Wird ein realistisches Änderungsdatum verwendet?
  • Wurde der Status nach der Übermittlung kontrolliert?
  • Passt die Sitemap zur aktuellen Website-Struktur und zum letzten Relaunch?

Wenn Sie diese Punkte regelmäßig prüfen, wird die Sitemap zu einem verlässlichen Bestandteil der technischen Website-Pflege. Bei sehr großen Websites kann es zusätzlich sinnvoll sein, Sitemaps nach Inhaltstyp, Verzeichnis oder Aktualität zu strukturieren, solange die Aufteilung nachvollziehbar bleibt.

FAQ

Muss jede Website eine Sitemap haben?

Nein. Kleine, gut intern verlinkte Websites können auch ohne manuell eingereichte Sitemap gefunden werden. Sie ist dennoch eine sinnvolle Ergänzung, wenn viele URLs, häufige Änderungen, neue Inhalte oder eine komplexe Struktur vorliegen.

Garantiert das Einreichen die Indexierung?

Nein. Die Sitemap übermittelt Hinweise zu URLs, garantiert aber weder Crawling noch Indexierung oder Rankings. Google bewertet zusätzlich technische Zugänglichkeit, Qualität, Eigenständigkeit, Relevanz und weitere Signale.

Wo finde ich die Sitemap meiner WordPress-Website?

Viele WordPress-Installationen stellen automatisch eine Sitemap bereit. Je nach Version, Theme oder Erweiterung kann der Pfad unterschiedlich sein. Prüfen Sie die Einstellungen Ihrer Website und rufen Sie die vermutete Adresse direkt auf. Vermeiden Sie es, mehrere konkurrierende Sitemap-Systeme unkontrolliert parallel zu betreiben.

Kann ich mehrere Sitemaps einreichen?

Ja. Das kann bei großen Websites oder verschiedenen Inhaltstypen sinnvoll sein. Häufig wird dafür eine Sitemap-Indexdatei verwendet, die auf einzelne Dateien verweist. Jede Datei sollte korrekt aufgebaut sein und einen klar abgegrenzten URL-Bestand enthalten.

Was bedeutet der Status „Erfolgreich“?

Der Status zeigt in der Regel, dass Google die Sitemap abrufen und verarbeiten konnte. Er bestätigt nicht, dass jede enthaltene URL indexiert wurde. Für einzelne Seiten müssen Sie die Indexierungsinformationen separat betrachten.

Wie lange dauert es, bis Google die Sitemap verarbeitet?

Das lässt sich nicht pauschal vorhersagen. Die Verarbeitung hängt unter anderem von Serververfügbarkeit, Umfang und Aktualität der Website ab. Eine Sitemap ist ein Hinweis, kein Auftrag zur sofortigen Indexierung.

Ist eine Sitemap für Bilder oder Videos immer nötig?

Nein. Spezielle Sitemaps können bei umfangreichen Bild- oder Videobeständen hilfreich sein, sind aber nicht für jede Website erforderlich. Entscheidend ist, ob sie zusätzliche, korrekt gepflegte Informationen liefern und vom verwendeten System zuverlässig erzeugt werden.

Fazit: Sitemap gezielt und sauber einreichen

Eine Sitemap bei Google einzureichen ist schnell erledigt, wenn die Datei korrekt erzeugt wird und die richtige Search-Console-Property ausgewählt ist. Der nachhaltige Nutzen entsteht jedoch erst durch eine laufende Pflege: Die Sitemap sollte aktuelle, erreichbare und tatsächlich relevante URLs enthalten.

Kontrollieren Sie nach der Einreichung den Verarbeitungsstatus, beheben Sie technische Fehler und betrachten Sie die Sitemap als Teil eines größeren SEO-Prozesses. Gute Inhalte, sinnvolle interne Verlinkung und eine stabile technische Grundlage bleiben entscheidend dafür, dass Google Ihre Website nicht nur findet, sondern ihre Seiten auch sinnvoll bewerten kann.
Canonical oder Noindex? Der praktische SEO-Ratgeber zur richtigen Entscheidung

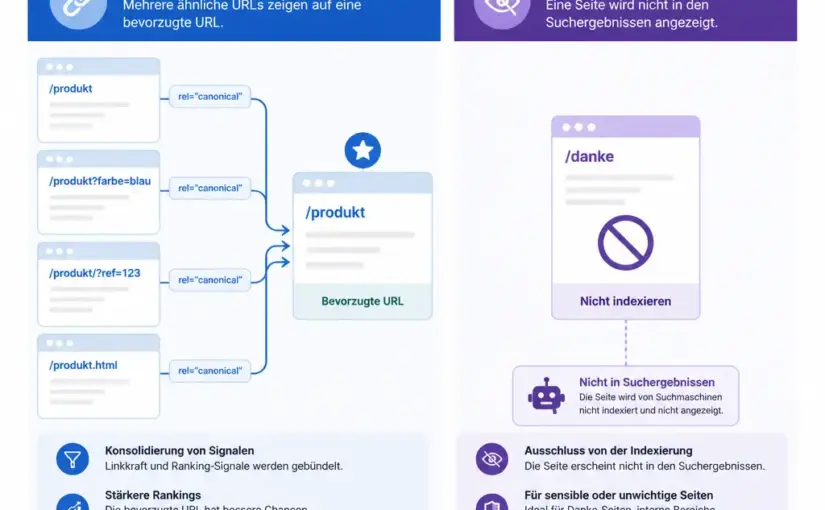
Canonical oder Noindex? Beide Signale helfen dabei, Suchmaschinen bei der Bewertung ähnlicher oder unerwünschter URLs zu unterstützen. Sie verfolgen jedoch unterschiedliche Ziele: Ein Canonical weist auf die bevorzugte Version mehrerer ähnlicher Seiten hin, während noindex verhindern soll, dass eine konkrete Seite in den Suchergebnissen erscheint. Die falsche Wahl kann dazu führen, dass wichtige Inhalte aus dem Index verschwinden oder doppelte URLs weiterhin unnötige Aufmerksamkeit erhalten.

Dieser Ratgeber erklärt die Unterschiede, zeigt typische Anwendungsfälle und bietet eine praktische Entscheidungshilfe für Websites, Onlineshops, Blogs und technische Plattformen. Dabei gilt: Keine der beiden Maßnahmen ersetzt eine saubere Informationsarchitektur, verständliche Inhalte und eine sorgfältige technische Prüfung.

Was bedeuten Canonical und Noindex?

Canonical und Noindex sind zwei verschiedene Steuerungssignale für Suchmaschinen. Sie werden häufig gemeinsam genannt, weil beide bei ähnlichen, doppelten oder nicht gewünschten URLs zum Einsatz kommen können. Inhaltlich sind sie aber nicht austauschbar.

Canonical: Welche URL ist die bevorzugte Version?

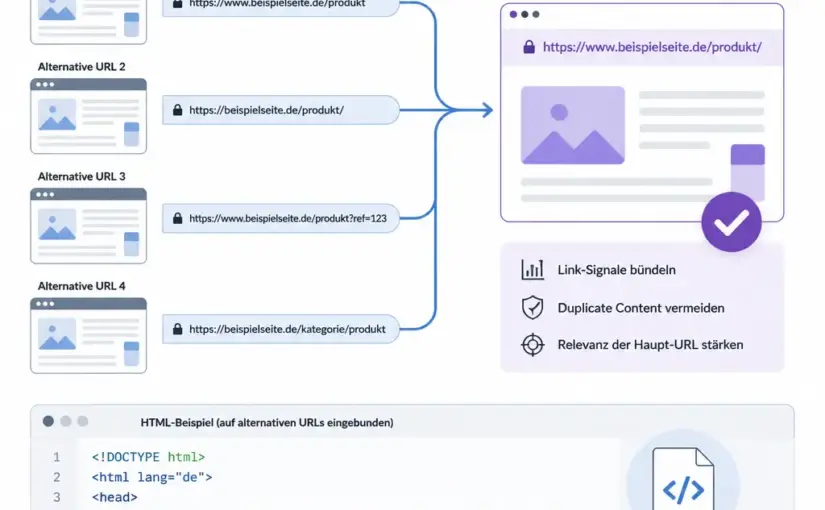
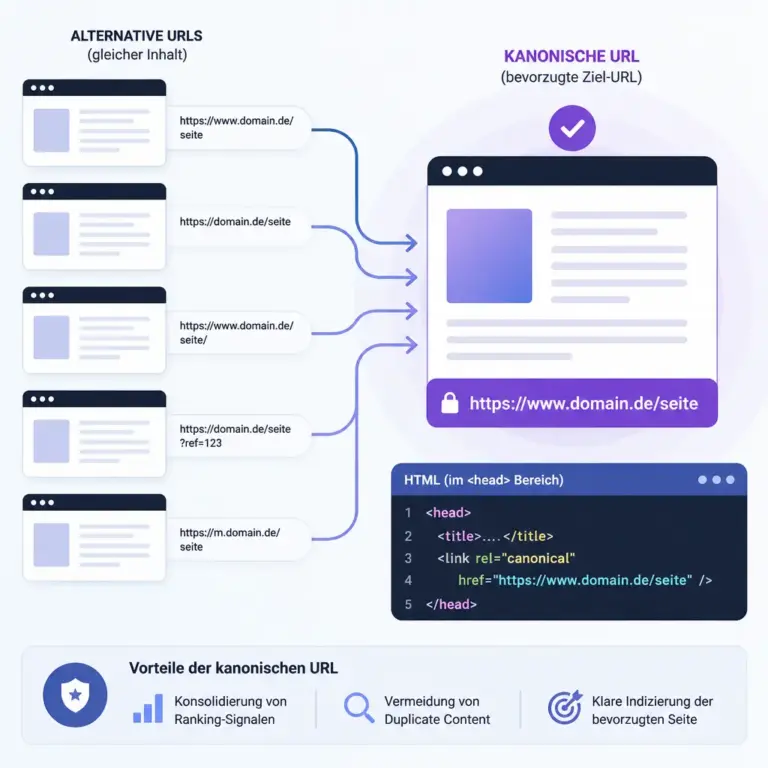
Mit einem Canonical-Link wird eine bevorzugte URL für inhaltlich gleiche oder sehr ähnliche Seiten angegeben. Das Signal lautet sinngemäß: „Von mehreren erreichbaren Varianten ist diese URL die wichtigste Version.“

Ein Canonical wird im <head> einer HTML-Seite eingebunden:

<link rel="canonical" href="https://www.beispiel.de/ratgeber/canonical-noindex">

In vielen Fällen verweist eine Seite auf sich selbst. Das wird als selbstreferenzierendes Canonical bezeichnet. Bei URL-Varianten kann eine alternative Seite hingegen auf eine andere, bevorzugte URL verweisen. Suchmaschinen können dieses Signal bei der Auswahl der indexierten und in Suchergebnissen angezeigten URL berücksichtigen.

Wichtig ist die Formulierung „Signal“: Ein Canonical ist keine absolute Anweisung. Suchmaschinen prüfen zusätzlich den Inhalt, interne Verlinkungen, Weiterleitungen, Sitemap-Einträge und weitere technische Hinweise. Ein Canonical sollte daher zu den übrigen Signalen der Website passen.

Noindex: Diese konkrete URL soll nicht in den Suchergebnissen erscheinen

noindex ist eine Anweisung beziehungsweise ein starkes Robots-Meta-Signal, eine bestimmte Seite nicht in den Suchindex aufzunehmen oder dort wieder zu entfernen. Die Seite kann weiterhin erreichbar sein und von Nutzern verwendet werden.

Typischerweise wird das Signal so im <head> hinterlegt:

<meta name="robots" content="noindex, follow">

Die häufig verwendete Kombination noindex, follow bedeutet: Die Seite selbst soll nicht in den Suchergebnissen erscheinen; Links auf der Seite dürfen grundsätzlich weiterhin entdeckt und verfolgt werden. Das follow ist meist nicht notwendig, weil Suchmaschinen Links auch ohne diese ausdrückliche Angabe verarbeiten können. Entscheidend ist der Teil noindex.

Damit Suchmaschinen das Meta-Tag sehen können, darf die URL nicht durch die robots.txt vom Crawling ausgeschlossen sein. Eine blockierte URL kann das enthaltene Noindex-Signal unter Umständen nicht zuverlässig übermitteln.

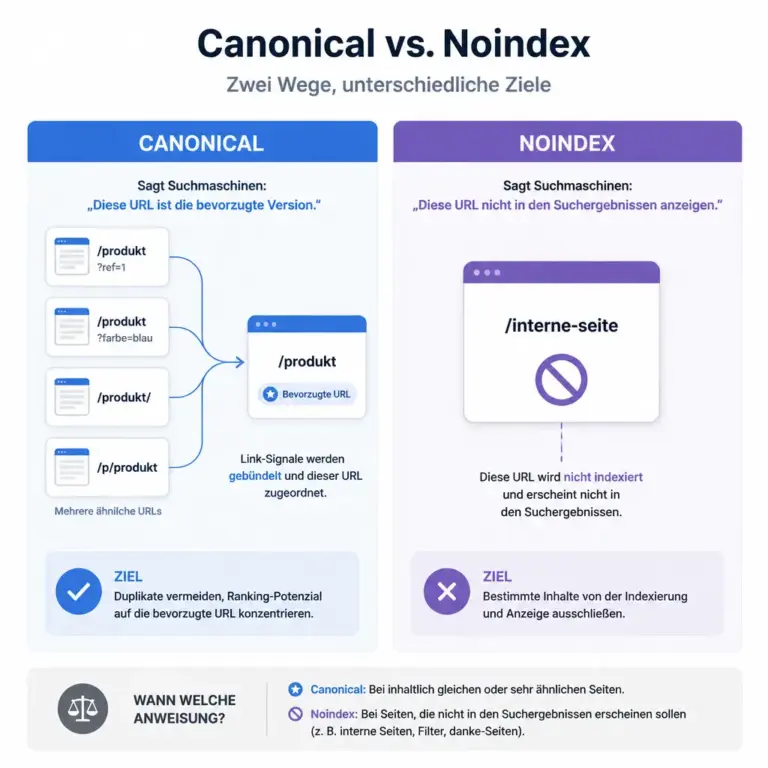
Der wichtigste Unterschied zwischen Canonical und Noindex

Infografik zum Unterschied zwischen Canonical und Noindex 1
Frage Canonical Noindex
Was wird gesteuert? Die bevorzugte URL innerhalb ähnlicher Versionen Die Aufnahme einer konkreten URL in den Suchindex
Bleibt die Seite erreichbar? Ja Ja, sofern keine andere Zugriffsbeschränkung besteht
Wird die Seite aus dem Index entfernt? Nicht zwingend Das ist das Ziel des Signals
Wofür ist es besonders geeignet? Duplikate und URL-Varianten mit einem bevorzugten Original Interne Seiten, dünne Inhalte oder nicht suchrelevante Bereiche
Was passiert mit Linksignalen? Signale können der bevorzugten URL zugeordnet werden Die Seite wird nicht als Suchergebnis gewünscht; die interne Verlinkung bleibt gesondert zu bewerten

Die Kurzform lautet: Canonical bündelt ähnliche Varianten auf eine bevorzugte URL, Noindex schließt eine konkrete URL aus den Suchergebnissen aus. Diese Kurzform hilft bei der ersten Einordnung, ersetzt aber nicht die Prüfung des jeweiligen Seitentyps.

Canonical oder Noindex: Eine praktische Entscheidungshilfe

Bevor eine technische Maßnahme gesetzt wird, sollte die eigentliche Absicht klar sein. Stelle dir nacheinander diese Fragen:

  1. Existiert eine andere URL mit demselben oder nahezu demselben Inhalt? Wenn ja, kann ein Canonical auf die bevorzugte Version passen.
  2. Soll die konkrete URL grundsätzlich nicht in der Suche erscheinen? Dann ist Noindex meist das passendere Signal.
  3. Hat die Seite einen eigenständigen Nutzen für Suchende? Wenn der Inhalt eine eigene Suchintention vollständig beantwortet, sollte er nicht vorschnell auf eine andere URL kanonisiert oder auf Noindex gesetzt werden.
  4. Ist die Seite nur eine technische oder funktionale Variante? Filter-, Sortier-, Warenkorb- oder interne Suchseiten benötigen oft eine andere Behandlung als redaktionelle Landingpages.
  5. Kann die bevorzugte Ziel-URL gecrawlt und indexiert werden? Ein Canonical auf eine blockierte, weitergeleitete oder ebenfalls nicht indexierbare URL ist häufig widersprüchlich.

Eine einfache Entscheidungsregel lautet: Gibt es ein sichtbares, eigenständiges Suchergebnisziel, sollte die Seite zunächst als mögliche Indexierungsseite betrachtet werden. Gibt es dagegen mehrere nahezu gleiche URLs und nur eine soll als Hauptversion dienen, ist ein Canonical naheliegend. Soll keine der Varianten in den Suchergebnissen auftauchen, reicht ein Canonical allein nicht aus; dann muss die Indexierungsabsicht ausdrücklich geprüft werden.

Typische Anwendungsfälle für ein Canonical

URL-Parameter für Tracking

Eine redaktionelle Seite kann durch Tracking-Parameter in mehreren URL-Varianten erreichbar sein, etwa durch Kampagnen- oder Analyseparameter. Wenn der Seiteninhalt gleich bleibt und die Parameter keine eigene Suchintention abbilden, kann die saubere Haupt-URL als Canonical angegeben werden.

Zusätzlich sollten interne Links möglichst direkt auf die bevorzugte URL zeigen. Das Canonical ist kein Ersatz für eine konsistente Verlinkung. Werden beide Varianten dauerhaft in der Website verlinkt, bleibt für Suchmaschinen und Nutzer unnötige URL-Komplexität bestehen.

Sortierung und Darstellung in einem Katalog

Ein Katalog kann dieselben Produkte oder Beiträge nach Preis, Aktualität, Farbe oder anderen Kriterien sortieren. Wenn die Sortieransichten keinen eigenständigen, suchrelevanten Inhalt bieten, kann die Hauptansicht als bevorzugte URL definiert werden.

Ob ein Canonical genügt, hängt davon ab, ob die Varianten weiterhin sinnvoll crawlbar sein sollen und ob sie für Nutzer oder externe Verweise benötigt werden. Bei umfangreichen Filterkombinationen ist eine Gesamtlösung aus URL-Konzept, interner Verlinkung, Crawl-Steuerung und gegebenenfalls Noindex oft sinnvoller als ein pauschales Signal auf jeder Variante.

Druckansicht oder alternative Layout-Version

Eine Druckansicht enthält häufig denselben Text wie die normale Seite, aber eine veränderte Darstellung. Wenn sie öffentlich erreichbar bleiben soll, jedoch nicht als eigenständiges Suchergebnis gewünscht ist, kann eine kanonische Zuordnung zur normalen Inhaltsseite geprüft werden. Bei rein funktionalen Varianten kann je nach Ziel auch Noindex angemessen sein.

Ähnliche Produkt- oder Beitragsseiten

Ein Canonical ist nicht automatisch richtig, nur weil zwei Seiten thematisch ähnlich sind. Wenn zwei Seiten unterschiedliche Fragen beantworten, verschiedene Produkte beschreiben oder jeweils einen eigenständigen Nutzen besitzen, sollten sie nicht ohne sorgfältige Prüfung zusammengelegt werden.

Bei echten Duplikaten oder nahezu identischen Varianten ist ein Canonical plausibler. Bei nur oberflächlicher Ähnlichkeit sollte stattdessen geprüft werden, ob beide Seiten durch bessere Abgrenzung, zusätzliche Informationen oder eine neue Informationsarchitektur eigenständig werden können.

Typische Anwendungsfälle für Noindex

Interne Suchergebnisse

Interne Suchseiten werden häufig automatisch aus Suchbegriffen erzeugt. Sie können für die Website-Navigation hilfreich sein, sind aber nicht grundsätzlich als öffentliche Landingpages gedacht. Wenn diese Seiten keinen kuratierten, stabilen und eigenständigen Inhalt besitzen, ist Noindex oft eine passende Option.

Warenkorb, Kasse und persönliche Bereiche

Warenkorb-, Konto-, Login- und vergleichbare Funktionsseiten richten sich an konkrete Nutzeraktionen. Sie sollen in der Regel nicht als informative Suchergebnisse gefunden werden. Hier ist Noindex meist näher an der eigentlichen Absicht als ein Canonical, weil nicht eine andere Inhaltsversion bevorzugt, sondern die Funktion aus dem Suchindex herausgehalten werden soll.

Vorläufige oder dünne Seiten

Eine noch nicht fertige Vorschauseite, ein interner Entwurf oder eine Seite mit sehr wenig eigenständigem Inhalt kann vorübergehend mit Noindex versehen werden. Vor einer späteren Veröffentlichung sollte die Maßnahme wieder entfernt und die Seite technisch wie redaktionell geprüft werden.

Mehrere Varianten ohne brauchbare Hauptversion

Manchmal existieren viele nahezu gleiche URLs, aber keine davon ist als dauerhaftes Suchergebnis sinnvoll. In diesem Fall kann ein Canonical auf eine nicht passende Seite das Problem nur verschieben. Noindex kann dann geeigneter sein, sofern die URLs weiterhin erreichbar sein müssen. Langfristig ist jedoch eine Bereinigung der URL-Erzeugung meist die robustere Lösung.

Wann Canonical und Noindex nicht einfach kombiniert werden sollten

Ein häufiges Missverständnis ist die Kombination aus Noindex und Canonical auf derselben Seite mit dem Gedanken, beide Signale würden sich gegenseitig verstärken. Das kann widersprüchlich sein: Einerseits wird die Seite als nicht indexierbar markiert, andererseits wird eine bevorzugte URL genannt. Suchmaschinen können das Canonical unter solchen Bedingungen weniger zuverlässig berücksichtigen.

Wenn eine Seite nicht im Index erscheinen soll, sollte zunächst Noindex die klare Hauptabsicht ausdrücken. Wenn mehrere indexierbare Varianten auf eine bevorzugte Version verweisen sollen, sollte das Canonical sauber und konsistent eingesetzt werden. Eine Kombination kann in speziellen technischen Szenarien sinnvoll sein, sollte aber nicht als pauschale Standardlösung verwendet werden.

Ebenso problematisch ist ein Canonical auf eine URL, die selbst noindex trägt. Die Zielseite sollte normalerweise als gültige, indexierbare Hauptversion vorgesehen sein. Widersprüchliche Signale erschweren die Verarbeitung und machen die gewünschte Indexierungslogik weniger eindeutig.

Technische Umsetzung und Qualitätskontrolle

Die korrekte Syntax ist nur der erste Schritt. Nach der Implementierung sollte geprüft werden, ob die Maßnahme tatsächlich zur URL-Strategie passt.

Checkliste für Canonical

  • Die Canonical-URL ist vollständig und verwendet das gewünschte Protokoll sowie die gewünschte Host-Version.
  • Die Ziel-URL ist erreichbar und liefert nicht dauerhaft auf eine andere Adresse weiter.
  • Die Zielseite ist nicht absichtlich mit Noindex versehen.
  • Die Zielseite enthält den gleichen oder den klar bevorzugten Inhalt.
  • Interne Links, XML-Sitemap und hreflang-Verweise widersprechen der bevorzugten URL nicht.
  • Es gibt keine unnötigen Ketten von Canonical-Verweisen.
  • Die URL verwendet eine konsistente Schreibweise, etwa bei Großschreibung, abschließendem Schrägstrich und Parametern.

Checkliste für Noindex

  • Das Robots-Meta-Tag steht in der ausgelieferten HTML-Seite oder wird zuverlässig über einen passenden HTTP-Header gesetzt.
  • Die URL ist für Suchmaschinen erreichbar, damit das Noindex-Signal gelesen werden kann.
  • Die Seite soll tatsächlich nicht als Suchergebnis erscheinen.
  • Wichtige Inhalte wurden nicht versehentlich mit Noindex versehen.
  • Die Seite wird nicht unnötig in XML-Sitemaps als indexierbare Ziel-URL geführt.
  • Interne Links verweisen nur dann prominent auf die URL, wenn sie für Nutzer weiterhin eine wichtige Funktion erfüllt.
  • Bei einer zeitlich begrenzten Maßnahme ist dokumentiert, wann die Einstellung erneut geprüft wird.

Häufige Fehler bei Canonical und Noindex

Canonical als Ersatz für eine Weiterleitung

Wenn eine alte URL dauerhaft auf eine neue URL umziehen soll und Nutzer ebenfalls automatisch weitergeleitet werden sollen, ist eine serverseitige Weiterleitung meist die passendere Lösung. Ein Canonical lässt die alte URL erreichbar und informiert vor allem Suchmaschinen über die bevorzugte Variante. Beide Maßnahmen verfolgen also nicht dasselbe Ziel.

Noindex für jede ähnliche Seite

Ähnliche Themen sind nicht automatisch doppelte Inhalte. Wer vorschnell viele Seiten auf Noindex setzt, kann wertvolle Suchintentionen und nützliche Einstiegsseiten verlieren. Vor der Entscheidung sollte geklärt werden, ob die Seite eine eigene Frage beantwortet und ob sie für Besucher einen eigenständigen Nutzen hat.

Blockierung in der robots.txt statt Noindex

Ein Crawling-Verbot und ein Noindex-Signal sind nicht gleichbedeutend. Wenn eine URL gar nicht abgerufen werden darf, kann ihr Inhalt nicht zuverlässig auf ein Meta-Tag geprüft werden. Soll eine Seite aus dem Index verschwinden, muss die technische Umsetzung diesen Unterschied berücksichtigen.

Canonical auf die Startseite

Die Startseite ist nicht automatisch die passende Sammelstelle für fehlerhafte, dünne oder doppelte URLs. Ein Canonical sollte auf die inhaltlich passende Hauptversion zeigen. Ist keine solche Version vorhanden, sind eine Überarbeitung, eine Weiterleitung oder Noindex möglicherweise sinnvoller.

Nach der Veröffentlichung nicht kontrollieren

CMS, Plugins, Shopsysteme und Templates können Canonical- oder Noindex-Angaben automatisch erzeugen. Nach Änderungen sollten deshalb nicht nur die Einstellungen im Backend, sondern auch der tatsächlich ausgelieferte Quelltext und die betroffenen URL-Muster geprüft werden.

Eine sinnvolle Vorgehensweise bei großen Websites

Bei vielen URLs sollte die Entscheidung nicht einzeln und zufällig getroffen werden. Besser ist ein wiederholbarer Prozess:

  1. URL-Muster erfassen: Gruppiere Seiten nach Parametern, Filterkombinationen, Seitentypen, Sprachversionen und Funktionen.
  2. Suchintention bewerten: Notiere, welche Gruppen für Suchende eigenständige Antworten oder Angebote liefern.
  3. Hauptversion bestimmen: Lege bei echten Duplikaten eine klare, stabile bevorzugte URL fest.
  4. Signal auswählen: Nutze Canonical für bevorzugte Varianten und Noindex für Seiten, die nicht in den Suchergebnissen erscheinen sollen.
  5. Begleitsignale angleichen: Prüfe interne Links, Sitemaps, Weiterleitungen, hreflang und strukturierte Daten.
  6. Ergebnis beobachten: Kontrolliere nach der Umsetzung, ob die Suchmaschinen die gewünschte URL-Auswahl und Indexierung nachvollziehbar verarbeiten.

Besonders wichtig ist eine Dokumentation: Für jedes URL-Muster sollte festgehalten werden, welche Seiten indexierbar sein sollen, welche Hauptversion gilt und warum eine bestimmte Maßnahme gewählt wurde. Das erleichtert spätere Relaunches, Plugin-Wechsel und Fehleranalysen.

FAQ

Ist Canonical dasselbe wie Noindex?

Nein. Canonical nennt eine bevorzugte URL unter ähnlichen Varianten. Noindex weist darauf hin, dass eine konkrete URL nicht in den Suchergebnissen erscheinen soll. Beide Signale beantworten unterschiedliche Fragen.

Was ist besser bei doppelten Seiten: Canonical oder Noindex?

Wenn eine Version als Hauptseite erhalten bleiben und die Varianten auf sie verweisen sollen, ist Canonical meist passend. Wenn keine der betreffenden URLs als Suchergebnis erscheinen soll, kann Noindex näher an der gewünschten Absicht liegen. Bei dauerhaft identischen URLs kann zusätzlich eine URL-Bereinigung oder Weiterleitung sinnvoll sein.

Kann eine noindex-Seite trotzdem gecrawlt werden?

Ja. Noindex verhindert grundsätzlich nicht, dass die Seite erreichbar oder abrufbar ist. Damit das Signal verarbeitet werden kann, darf der Zugriff für den relevanten Crawler nicht gleichzeitig durch die robots.txt blockiert sein.

Verhindert ein Canonical garantiert die Indexierung der URL?

Nein. Ein Canonical ist ein starkes Signal, aber keine absolute Garantie. Suchmaschinen bewerten zusätzlich Inhalt, interne Verlinkung, technische Erreichbarkeit und weitere Signale. Die bevorzugte URL sollte deshalb eindeutig und konsistent ausgezeichnet werden.

Soll jede Seite ein selbstreferenzierendes Canonical haben?

Ein selbstreferenzierendes Canonical kann bei vielen indexierbaren Seiten eine klare technische Grundlage schaffen, ist aber kein Ersatz für ein durchdachtes URL-Konzept. Entscheidend ist, dass die Angabe korrekt, konsistent und für den jeweiligen Seitentyp sinnvoll ist.

Was sollte ich bei Filterseiten im Onlineshop verwenden?

Das hängt davon ab, ob ein Filter eine eigene, dauerhaft nützliche Suchintention bedient. Für rein technische Kombinationen kann eine kanonische Hauptseite oder eine andere Crawl- und Indexierungsstrategie passen. Wertvolle Filter-Landingpages sollten dagegen nicht pauschal auf Noindex gesetzt werden.

Kann ich eine URL mit Noindex in der XML-Sitemap lassen?

Technisch kann sie dort stehen, sinnvoll ist es normalerweise nicht. Eine XML-Sitemap sollte vor allem URLs enthalten, die als wichtige, indexierbare Seiten vorgesehen sind. Widersprüchliche Signale erschweren die klare Kommunikation der Website-Struktur.

Wie lange dauert es, bis Noindex oder Canonical verarbeitet wird?

Das lässt sich nicht pauschal festlegen. Die Verarbeitung hängt unter anderem davon ab, wann die URL erneut gecrawlt wird und welche weiteren Signale vorliegen. Nach einer Änderung sollte deshalb nicht sofort aus einzelnen Suchergebnissen auf den endgültigen Zustand geschlossen werden.

Fazit: Die Absicht entscheidet

Bei der Frage „Canonical oder Noindex?“ ist nicht die technische Kürze des Signals entscheidend, sondern die gewünschte Funktion der URL. Ein Canonical bündelt ähnliche Varianten unter einer bevorzugten Adresse. Noindex hält eine konkrete Seite aus den Suchergebnissen heraus, während sie für Nutzer weiterhin erreichbar bleiben kann.

Prüfe deshalb zuerst die Suchintention, den eigenständigen Nutzen und die Rolle der URL in der Website. Setze anschließend ein eindeutiges Signal und gleiche interne Links, Sitemaps, Weiterleitungen und weitere technische Angaben daran an. Eine regelmäßige Kontrolle des tatsächlich ausgelieferten Codes verhindert, dass CMS-Einstellungen oder URL-Parameter die geplante SEO-Struktur unbemerkt wieder auflösen.

Noindex richtig verwenden: Anleitung für WordPress und SEO

Das Meta-Tag noindex ist ein präzises Werkzeug für die Suchmaschinenoptimierung. Es teilt Suchmaschinen mit, dass eine bestimmte Seite nicht in den Suchergebnissen erscheinen soll. Richtig eingesetzt, hilft es dabei, dünne, doppelte oder intern wenig hilfreiche Inhalte aus dem Suchindex herauszuhalten. Falsch eingesetzt, kann es jedoch wichtige Seiten unsichtbar machen.

In diesem Ratgeber erfahren Sie, wann Noindex richtig verwenden sinnvoll ist, wie sich noindex von robots.txt und einem Canonical-Tag unterscheidet und wie Sie die Einstellung in WordPress kontrolliert umsetzen. Außerdem finden Sie eine praktische Prüfliste, typische Fehler und Antworten auf häufige Fragen.

Was bedeutet „noindex“?

noindex ist eine Anweisung im HTML-Code einer Seite oder im HTTP-Header. Sie richtet sich an Suchmaschinen-Crawler und bedeutet sinngemäß: Diese URL soll nicht in den Suchergebnissen gelistet werden.

Die häufigste Variante steht im <head>-Bereich des Dokuments:

<meta name="robots" content="noindex, follow">

Die Kombination noindex, follow verhindert die Aufnahme der Seite in den Index, erlaubt aber grundsätzlich weiterhin das Verfolgen von Links auf dieser Seite. Alternativ kann eine Seite mit noindex, nofollow versehen werden. Damit wird zusätzlich signalisiert, dass Links auf der Seite nicht verfolgt werden sollen.

Für die meisten redaktionellen Anwendungsfälle ist noindex, follow die differenziertere Einstellung. Sie sollten nofollow nicht pauschal ergänzen, nur weil eine Seite selbst nicht indexiert werden soll.

Wann ist Noindex sinnvoll?

Noindex eignet sich für URLs, die technisch erreichbar oder intern nützlich sind, aber keinen eigenständigen Wert für Suchende haben. Entscheidend ist nicht, ob eine Seite existiert, sondern ob sie als eigenständiges Suchergebnis hilfreich wäre.

Typische Anwendungsfälle

  • Interne Suchergebnisse: Suchseiten mit frei kombinierbaren Suchbegriffen liefern häufig wechselnde oder sehr ähnliche Inhalte.
  • Filter- und Sortier-URLs: Parameter wie Farbe, Größe, Sortierung oder Ansicht können zahlreiche Varianten derselben Seite erzeugen.
  • Doppelte Archivseiten: Datums-, Autoren- oder Schlagwortarchive sind nicht automatisch problematisch, können aber bei geringer eigener Aussagekraft entbehrlich sein.
  • Interne Hilfsseiten: Bestellbestätigungen, Warenkörbe, Login-Seiten oder bestimmte Kontoansichten sind normalerweise keine sinnvollen öffentlichen Suchergebnisse.
  • Test- und Übergangsseiten: Vor der Veröffentlichung kann eine Seite vorübergehend aus dem Suchindex herausgehalten werden.
  • Inhalte mit sehr geringem eigenständigem Nutzen: Dazu können automatisch erzeugte Übersichten oder fast leere Taxonomien gehören.

Die Entscheidung sollte immer URL für URL oder anhand einer klar definierten Regel getroffen werden. Eine pauschale Noindex-Regel für ganze Verzeichnisse oder Inhaltstypen kann leicht wertvolle Seiten erfassen.

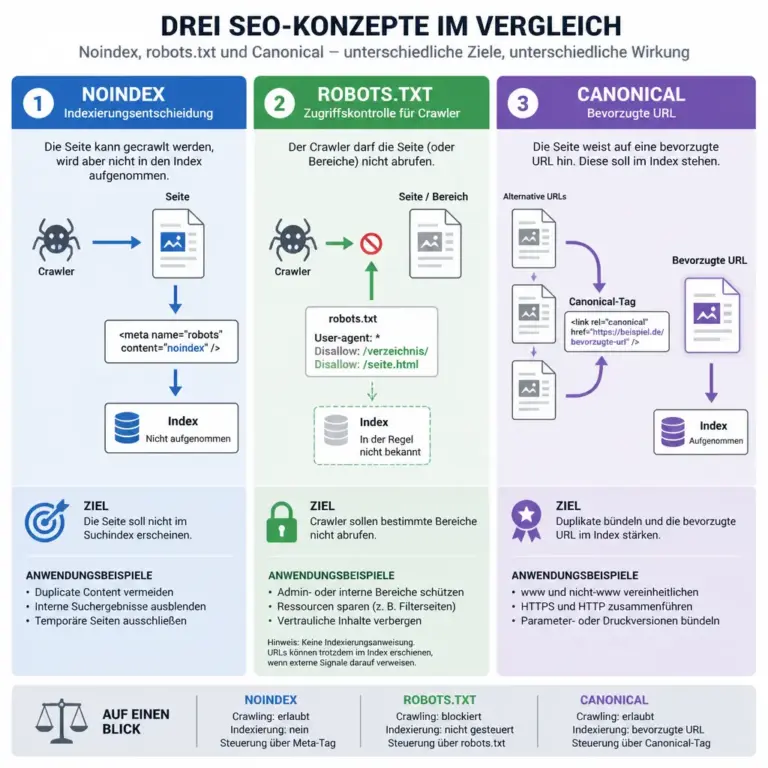
Noindex, robots.txt und Canonical im Vergleich

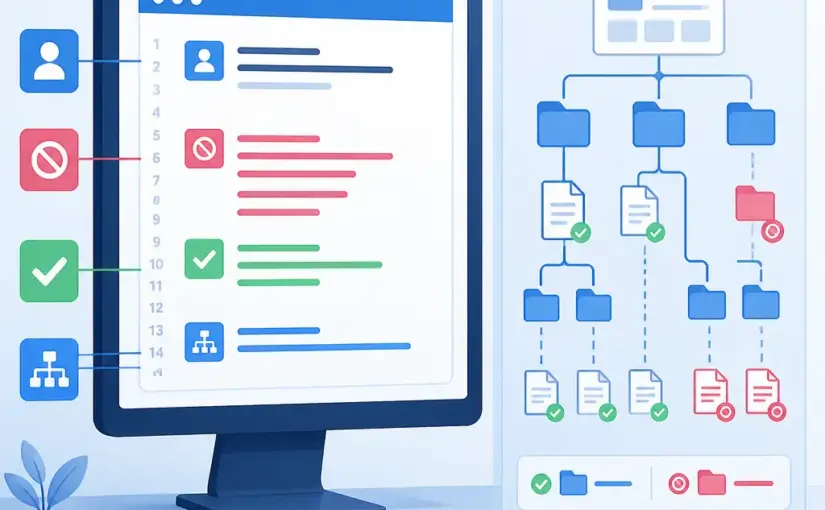
Vergleich von Noindex, robots.txt und Canonical in einer SEO-Infografik
Die drei Signale erfüllen unterschiedliche Aufgaben bei der technischen SEO.

Die Grafik macht sichtbar, dass Noindex, robots.txt und Canonical nicht austauschbar sind. Besonders wichtig ist die Trennung zwischen Zugriff auf eine URL und ihrer Aufnahme in den Suchindex.

Diese drei SEO-Maßnahmen werden häufig verwechselt, verfolgen aber unterschiedliche Ziele. Eine gute technische Strategie beginnt damit, ihre Funktionen sauber zu trennen.

Maßnahme Hauptzweck Wichtiger Hinweis
noindex Eine URL soll nicht in den Suchindex aufgenommen oder dort entfernt werden. Die Suchmaschine muss die Anweisung abrufen können, um sie zuverlässig zu sehen.
robots.txt Crawler sollen bestimmte Bereiche möglichst nicht abrufen. Eine blockierte URL kann dadurch daran gehindert werden, ein Noindex-Signal auszulesen.
Canonical Eine bevorzugte URL unter mehreren ähnlichen oder doppelten Varianten angeben. Ein Canonical ist ein Hinweis, keine Garantie für die Auswahl durch die Suchmaschine.

Wenn eine URL sicher nicht indexiert werden soll, darf sie nicht zugleich in der robots.txt blockiert sein, sofern die Suchmaschine das Noindex-Signal noch auslesen muss. Die beiden Maßnahmen lösen unterschiedliche Probleme: Die Datei robots.txt steuert den Zugriff, während noindex die Indexierung betrifft.

Ein Canonical ist dagegen oft besser geeignet, wenn mehrere URL-Varianten denselben wichtigen Inhalt darstellen und eine Hauptversion in den Suchergebnissen erscheinen soll. Noindex wäre in diesem Fall möglicherweise zu streng, weil damit auch eine eigenständige Suchintention verloren gehen kann.

Noindex richtig verwenden: Entscheidungskriterien

Bevor Sie eine Seite auf Noindex setzen, helfen einige konkrete Fragen. Sie verhindern, dass die Einstellung nur als schnelle Lösung für ein ungeklärtes Strukturproblem dient.

1. Hat die URL eine eigene Suchintention?

Prüfen Sie, ob Nutzer nach genau diesem Inhalt suchen könnten und ob die Seite diese Erwartung erfüllt. Eine eigenständige Kategorie mit verständlicher Beschreibung kann wertvoll sein. Eine automatisch erzeugte Kombination aus drei Filtern ist dagegen oft kein sinnvolles Ziel für die organische Suche.

2. Ist der Inhalt ausreichend vollständig?

Eine kurze Seite ist nicht automatisch schlecht. Problematisch wird es, wenn sie die Frage des Nutzers nicht beantwortet, fast ausschließlich aus Navigation besteht oder nur minimale Unterschiede zu vielen anderen URLs aufweist. In manchen Fällen ist eine Überarbeitung die bessere Lösung als Noindex.

3. Gibt es eine bessere Haupt-URL?

Wenn mehrere Seiten denselben Zweck erfüllen, sollten Sie entscheiden, ob eine URL gestärkt und die anderen zusammengeführt, per Canonical bevorzugt oder aus dem Index ausgeschlossen werden sollen. Noindex ist nicht automatisch die richtige Maßnahme gegen jede Form von Duplicate Content.

4. Brauchen Besucher diese Seite direkt?

Eine nicht indexierte Seite kann weiterhin über interne Links, Lesezeichen oder direkte Verweise erreichbar sein. Das ist bei Konto-, Warenkorb- oder Bestätigungsseiten sinnvoll. Prüfen Sie aber, ob sensible Inhalte wirklich angemessen geschützt sind: Noindex ist kein Zugriffsschutz.

5. Soll die Einstellung dauerhaft gelten?

Bei einer temporären Baustelle ist es wichtig, später eine Wiedervorlage einzuplanen. Bei dauerhaft unnötigen URLs können Sie zusätzlich die interne Verlinkung, URL-Struktur oder Erzeugungslogik verbessern.

Noindex in WordPress umsetzen

In WordPress wird Noindex meist über ein SEO-Plugin, die Einstellungen des jeweiligen Inhaltstyps oder eine individuelle technische Konfiguration gesetzt. Die genaue Bezeichnung kann je nach Plugin und Version abweichen. Suchen Sie nach Optionen wie „Suchmaschinen erlauben, diesen Beitrag in den Suchergebnissen anzuzeigen?“ oder „Indexierung erlauben“.

Einzelne Seite oder einzelnen Beitrag ausschließen

  1. Öffnen Sie den betreffenden Beitrag oder die Seite im WordPress-Editor.
  2. Rufen Sie die SEO-Einstellungen des Dokuments auf.
  3. Deaktivieren Sie die Option, die eine Indexierung erlaubt, beziehungsweise wählen Sie „noindex“.
  4. Speichern oder aktualisieren Sie den Inhalt.
  5. Rufen Sie den Quelltext der veröffentlichten URL auf und suchen Sie nach noindex.

Verlassen Sie sich nicht ausschließlich auf die Anzeige im Editor. Entscheidend ist, was die öffentlich ausgelieferte URL tatsächlich enthält. Caching, mehrere SEO-Erweiterungen oder individuelle Theme-Funktionen können die Ausgabe beeinflussen.

Archiv- und Taxonomieseiten steuern

Für Kategorien, Schlagwörter, Autoren- oder Datumsarchive bieten viele Plugins globale Einstellungen. Hier ist besondere Vorsicht erforderlich. Eine sinnvolle Kategorieübersicht kann Suchenden Orientierung geben und sollte nicht allein deshalb auf Noindex stehen, weil sie ein Archiv ist.

Bewerten Sie zunächst die Qualität und Funktion der jeweiligen Archivart. Wenn Sie eine Taxonomie dauerhaft nicht benötigen, kann das Entfernen oder Zusammenführen leerer Begriffe besser sein. Wenn die Archive intern nützlich, aber für Suchmaschinen nicht relevant sind, ist Noindex eine mögliche kontrollierte Einstellung.

Robots-Meta-Tag und X-Robots-Tag

HTML-Dokumente verwenden häufig das Robots-Meta-Tag im <head>. Bei nicht-HTML-Dateien wie PDF-Dokumenten kann der Server stattdessen einen HTTP-Header ausliefern:

X-Robots-Tag: noindex

Die technische Umsetzung des Headers hängt vom Webserver, dem Hosting und der verwendeten Infrastruktur ab. Änderungen an Serverregeln sollten Sie erst nach einer Sicherung und mit einer nachvollziehbaren Rückfallmöglichkeit durchführen. Bei Unsicherheit ist die Dokumentation des Hosters oder die Unterstützung einer fachkundigen Person sinnvoll.

Kontrolle und Prüfung nach der Änderung

Eine Noindex-Einstellung ist erst dann zuverlässig bewertet, wenn Sie die veröffentlichte Ausgabe und die technischen Rahmenbedingungen kontrollieren. Arbeiten Sie am besten mit einer kleinen, wiederholbaren Prüfroutine.

  • Quelltext prüfen: Suchen Sie nach einem Robots-Meta-Tag und kontrollieren Sie, ob es tatsächlich noindex enthält.
  • HTTP-Antwort prüfen: Bei Dateien und speziellen Konfigurationen kann ein X-Robots-Tag relevant sein.
  • Robots.txt kontrollieren: Stellen Sie sicher, dass die URL nicht blockiert wird, wenn das Noindex-Signal noch abgerufen werden muss.
  • Interne Links prüfen: Entfernen Sie unnötige Links zu ausgeschlossenen Seiten, ohne wichtige Nutzerwege zu zerstören.
  • Sitemap prüfen: Nicht indexierbare URLs sollten normalerweise nicht in der XML-Sitemap stehen. Die genaue Sitemap-Konfiguration hängt vom System ab.
  • Weiterleitungen und Canonicals ansehen: Eine Noindex-Seite sollte nicht versehentlich gleichzeitig auf eine andere URL weiterleiten oder ein widersprüchliches Canonical ausgeben.
  • Nachkontrolle einplanen: Caches, Plugin-Updates und Template-Änderungen können technische Signale verändern.

Eine URL-Prüfung in einem Suchmaschinen-Tool kann zusätzliche Hinweise liefern. Dabei sollten Sie die dort angezeigten Informationen als Diagnosehilfe verstehen und mit dem tatsächlich ausgelieferten Quelltext abgleichen. Die Entfernung einer bereits bekannten URL aus einem Index kann außerdem zeitversetzt erfolgen.

Häufige Fehler beim Einsatz von Noindex

Die komplette Website auf Noindex setzen

Ein falsch gesetztes globales Robots-Signal kann alle wichtigen Inhalte betreffen. Prüfen Sie deshalb nach Änderungen an Theme, SEO-Plugin oder Hosting besonders die Startseite, wichtige Landingpages, Kategorien und Beiträge.

Noindex mit Zugriffsschutz verwechseln

Jede Person, die die URL kennt oder über einen Link erreicht, kann eine nicht indexierte Seite weiterhin aufrufen, sofern keine Authentifizierung oder andere Schutzmaßnahme greift. Für vertrauliche Inhalte benötigen Sie einen echten Zugriffsschutz.

Die URL in robots.txt sperren und Noindex erwarten

Wenn ein Crawler eine URL wegen der robots.txt nicht abrufen darf, sieht er möglicherweise auch das Meta-Tag nicht. Eine Sperre kann deshalb die gewünschte Verarbeitung des Noindex-Signals verhindern.

Wichtige Inhalte wegen geringer Wortzahl ausschließen

Die Länge allein entscheidet nicht über den Nutzen. Eine kompakte Kontakt-, Produkt- oder Hilfeseite kann für Besucher sehr relevant sein. Bewerten Sie Inhalt, Suchintention, Aktualität und Nutzerführung gemeinsam.

Noindex als Ersatz für eine schlechte Informationsarchitektur nutzen

Wenn tausende Filter-URLs entstehen, ist es oft besser, die URL-Erzeugung, interne Verlinkung und Crawling-Steuerung grundsätzlich zu analysieren. Noindex kann eine sinnvolle Maßnahme sein, sollte aber nicht die einzige Antwort auf strukturelle Probleme bleiben.

Praktische Noindex-Checkliste

Die folgende Checkliste eignet sich für einzelne Seiten ebenso wie für größere WordPress-Bereinigungen:

  1. Definieren Sie, warum die konkrete URL nicht in den Suchergebnissen erscheinen soll.
  2. Prüfen Sie, ob Überarbeitung, Zusammenlegung, Weiterleitung oder Canonical die passendere Lösung wäre.
  3. Setzen Sie Noindex gezielt auf der betroffenen URL oder in einer klar begrenzten Regel.
  4. Vermeiden Sie widersprüchliche Einstellungen in SEO-Plugin, Theme, Server und robots.txt.
  5. Entfernen Sie die URL aus der XML-Sitemap, sofern sie dort nicht benötigt wird.
  6. Kontrollieren Sie Meta-Tag oder HTTP-Header in der veröffentlichten Version.
  7. Dokumentieren Sie den Grund und prüfen Sie bei temporären Maßnahmen ein Ablaufdatum.
  8. Beobachten Sie wichtige Seiten nach Plugin-, Theme- oder Serveränderungen erneut.

FAQ

Ist Noindex schlecht für SEO?

Nein. Noindex ist zunächst eine Steuerungsanweisung. Sie kann SEO unterstützen, wenn unwichtige oder nicht eigenständige URLs aus dem Index herausgehalten werden. Problematisch wird sie nur, wenn relevante Seiten versehentlich ausgeschlossen werden.

Kann eine Noindex-Seite weiterhin aufgerufen werden?

Ja. Noindex verhindert grundsätzlich die Aufnahme in Suchergebnisse, sperrt aber nicht den direkten Zugriff. Für private oder geschützte Inhalte brauchen Sie Authentifizierung, Berechtigungen oder eine andere geeignete Zugriffskontrolle.

Soll ich noindex mit nofollow kombinieren?

Nicht automatisch. Wenn die Seite selbst nicht indexiert werden soll, Links darauf aber weiterhin für die interne Navigation relevant sind, kann noindex, follow passender sein. Die Wahl hängt vom Zweck der Seite und Ihrer Linkstrategie ab.

Wie unterscheidet sich Noindex von einem Canonical?

Noindex weist darauf hin, dass eine URL nicht gelistet werden soll. Ein Canonical nennt dagegen eine bevorzugte Version aus mehreren ähnlichen URLs. Wenn eine Variante weiterhin als Suchergebnis infrage kommt, kann ein Canonical die passendere Lösung sein.

Kann ich Noindex in der robots.txt eintragen?

Nein, noindex ist kein regulärer Ersatz für eine Robots.txt-Regel. Das Signal wird typischerweise im HTML-Meta-Tag oder über den X-Robots-Tag im HTTP-Header übertragen. Die robots.txt steuert vor allem, welche URLs ein Crawler abrufen darf.

Wie schnell verschwindet eine URL aus dem Index?

Das lässt sich nicht pauschal festlegen. Die Suchmaschine muss die URL erneut abrufen und das Signal verarbeiten. Eine Änderung im Quelltext führt daher nicht zwingend sofort zu einer sichtbaren Änderung der Suchergebnisse.

Soll eine Noindex-Seite aus der Sitemap entfernt werden?

In der Regel ja, weil eine XML-Sitemap bevorzugt URLs enthalten sollte, die Suchmaschinen indexieren dürfen und sollen. Prüfen Sie jedoch die konkrete Sitemap-Konfiguration und beheben Sie die Ursache, wenn ausgeschlossene URLs automatisch wieder aufgenommen werden.

Fazit: Noindex gezielt statt pauschal einsetzen

Noindex richtig verwenden bedeutet, die Anweisung als präzises Steuerungswerkzeug zu betrachten. Nicht jede kurze, doppelte oder technisch erzeugte URL muss automatisch ausgeschlossen werden. Entscheidend sind Suchintention, eigenständiger Nutzen, Zugriffszweck und die Frage, ob eine andere SEO-Maßnahme besser passt.

Setzen Sie Noindex möglichst gezielt, vermeiden Sie Konflikte mit robots.txt und Canonical, prüfen Sie die tatsächlich ausgelieferte Version und dokumentieren Sie wichtige Änderungen. So bleibt Ihre WordPress-Website für Besucher zugänglich, während der Suchindex auf die Inhalte konzentriert wird, die dort wirklich einen eigenständigen Beitrag leisten.

Indexierung einer Website überprüfen: Der umfassende Ratgeber

Wer organischen Traffic gewinnen möchte, muss zuerst sicherstellen, dass Suchmaschinen die wichtigen Seiten einer Website finden, crawlen und in ihren Index aufnehmen können. Eine technisch erreichbare Seite ist nämlich nicht automatisch auch in den Suchergebnissen sichtbar. Mit einer systematischen Prüfung lassen sich fehlende Seiten, versehentliche Sperren und Qualitätsprobleme meist deutlich schneller erkennen.

Dieser Ratgeber zeigt, wie Sie die Indexierung einer Website überprüfen, welche Werkzeuge dafür geeignet sind und wie Sie typische Ursachen für fehlende Sichtbarkeit unterscheiden. Dabei geht es nicht nur um einzelne URLs, sondern um das Zusammenspiel aus Crawling, Indexierung, internen Verlinkungen, Inhaltsqualität und technischen Signalen.

Was bedeutet Indexierung?

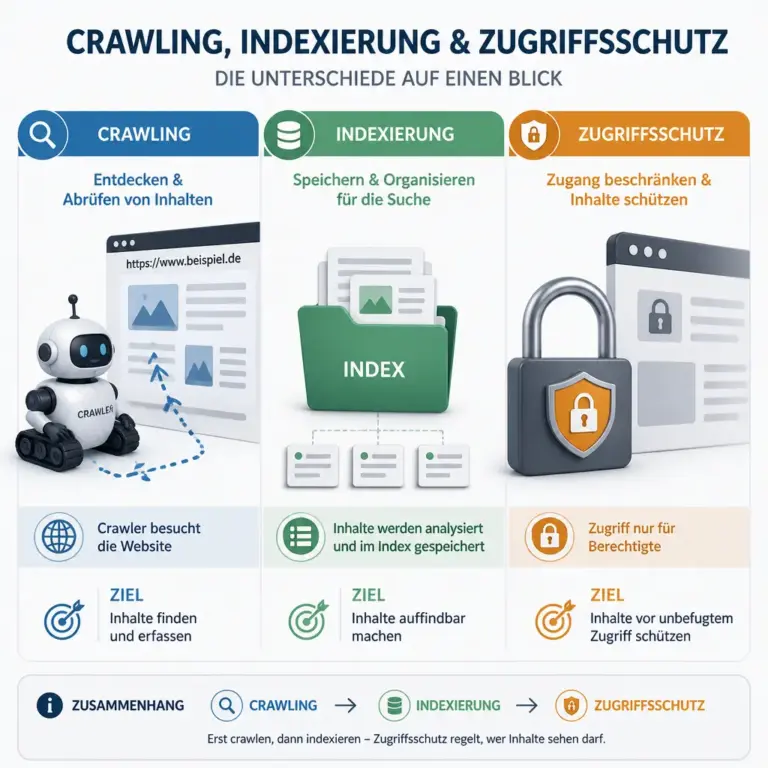
Beim Crawling ruft ein Suchmaschinenbot eine URL ab und analysiert deren Inhalt. Bei der Indexierung entscheidet die Suchmaschine anschließend, ob und in welcher Form die Seite in ihren Suchindex aufgenommen wird. Erst danach kann sie für passende Suchanfragen als Ergebnis erscheinen.

Diese Schritte sind voneinander zu unterscheiden:

  • Entdeckung: Die Suchmaschine erhält Kenntnis von einer URL, zum Beispiel über einen Link, eine XML-Sitemap oder bereits bekannte Daten.
  • Crawling: Ein Bot ruft die URL ab und versucht, den Inhalt technisch zu verarbeiten.
  • Indexierung: Die Seite wird bewertet und gegebenenfalls in den Index aufgenommen.
  • Ausspielung: Die indexierte Seite kann bei geeigneten Suchanfragen sichtbar werden.

Eine Seite kann also gecrawlt, aber nicht indexiert sein. Ebenso kann sie indexiert sein, ohne für ein wichtiges Keyword eine gute Position zu erreichen. Deshalb sollte eine Indexierungsprüfung nicht mit einer einfachen Suche nach dem Domainnamen enden.

Warum die Indexierung einer Website regelmäßig überprüft werden sollte

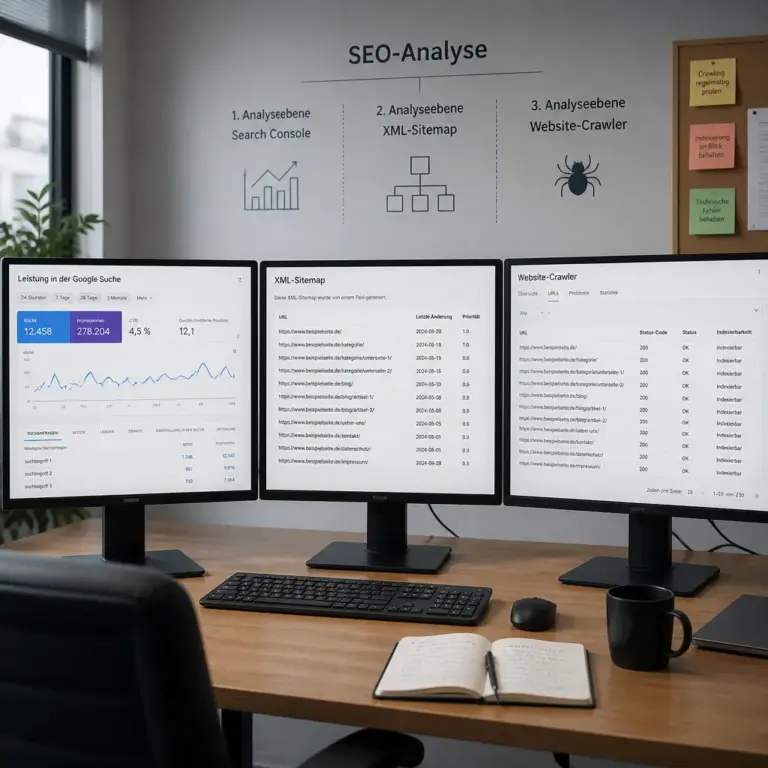
Werkzeuge zur Pru00fcfung der Website-Indexierung
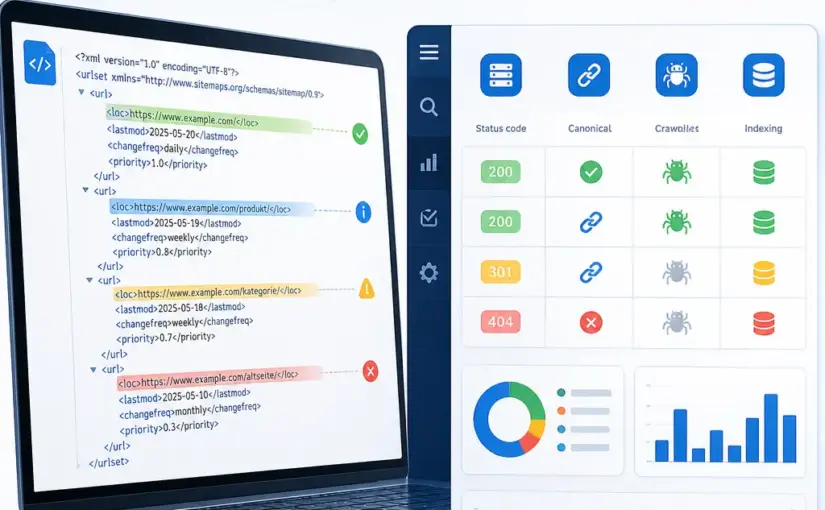
Mehrere Datenquellen ergänzen sich bei der Indexierungsprüfung.

Die Darstellung sollte zeigen, dass eine verlässliche Prüfung nicht auf einem einzigen Werkzeug beruht. Besonders wichtig ist der Abgleich zwischen URL-Status, Sitemap und technischer Website-Analyse.

Neue Websites, Relaunches und größere technische Änderungen bringen häufig unbeabsichtigte Folgen mit sich. Eine Entwicklungsumgebung kann beispielsweise eine globale Noindex-Anweisung enthalten, die beim Livegang übersehen wird. Auch Änderungen an Canonical-Tags, Weiterleitungen, URL-Strukturen oder internen Links können die Auffindbarkeit beeinflussen.

Eine regelmäßige Kontrolle hilft unter anderem dabei, folgende Probleme früh zu erkennen:

  • wichtige Seiten mit einem versehentlichen noindex-Meta-Tag,
  • gesperrte Verzeichnisse in der robots.txt,
  • fehlerhafte oder nicht erreichbare XML-Sitemaps,
  • verwaiste Seiten ohne interne Links,
  • mehrere URLs mit nahezu identischem Inhalt,
  • falsche Canonical-Verweise,
  • Serverfehler, Weiterleitungsketten oder Soft-404-Seiten,
  • Seiten, die zwar indexiert sind, aber keinen ausreichenden eigenständigen Nutzen bieten.

Die Prüfung ist besonders wichtig, wenn sich die Anzahl indexierter URLs stark verändert. Ein Rückgang muss nicht automatisch eine Strafe bedeuten; er kann durch eine technische Bereinigung, entfernte Inhalte oder eine veränderte Erfassung entstehen. Entscheidend ist, ob die betroffenen URLs absichtlich entfernt wurden und ob die wichtigen Seiten weiterhin verfügbar sind.

Die wichtigsten Werkzeuge für eine Indexierungsprüfung

Kein einzelnes Werkzeug zeigt die gesamte Situation perfekt. Aussagekräftiger wird die Analyse, wenn mehrere Datenquellen miteinander verglichen werden.

Google Search Console

Für Websites in der Google-Suche ist die Search Console eine zentrale Anlaufstelle. Im Bericht zur Indexierung lässt sich nachvollziehen, welche URLs als indexiert gelten und welche ausgeschlossen wurden. Die jeweiligen Gründe liefern wichtige Hinweise, etwa „Durch noindex ausgeschlossen“, „Duplikat“ oder „Gecrawlt – derzeit nicht indexiert“.

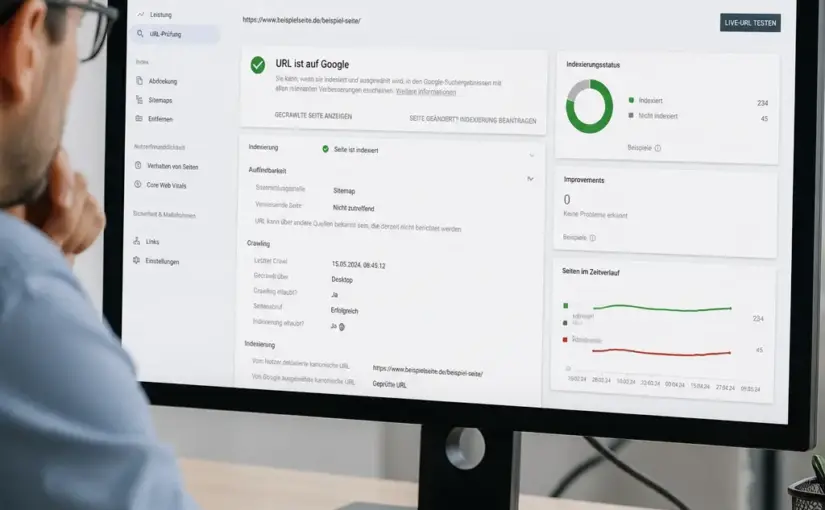
Mit der URL-Prüfung können Sie einzelne Seiten untersuchen. Sie erhalten unter anderem Informationen zur zuletzt bekannten Version, zur Indexierbarkeit und zum ausgewählten Canonical. Die Live-Prüfung kann zusätzlich zeigen, ob eine Seite aktuell abrufbar ist. Sie ersetzt jedoch keine vollständige Qualitäts- oder Rankinganalyse.

Bing Webmaster Tools

Wenn Sichtbarkeit in mehreren Suchmaschinen relevant ist, sollten auch die Bing Webmaster Tools berücksichtigt werden. Die Berichte können zusätzliche Hinweise zu Crawling, Sitemaps und technischen Auffälligkeiten geben. Unterschiedliche Suchmaschinen können dieselbe Website unterschiedlich verarbeiten; ein Vergleich ist daher sinnvoll.

Suchoperatoren als schneller Plausibilitätscheck

Eine Suche mit site:beispiel.de zeigt eine Auswahl von Seiten, die eine Suchmaschine der Domain zuordnet. Das ist ein schneller Hinweis, aber keine vollständige und exakte Bestandsaufnahme. Die angezeigte Anzahl kann schwanken, und nicht jede indexierte URL wird immer in der sichtbaren Trefferliste dargestellt.

Zusätzliche Suchabfragen können helfen, problematische Muster zu finden, etwa bestimmte Verzeichnisse, Parameter oder alte URL-Strukturen. Solche Abfragen sollten als Ergänzung und nicht als Ersatz für die Search Console verstanden werden.

Crawler und eigene URL-Listen

Ein Website-Crawler kann interne Links, Statuscodes, Canonical-Tags, Meta-Robots-Anweisungen, Weiterleitungen und viele weitere Merkmale erfassen. Für größere Websites ist eine solche technische Bestandsaufnahme besonders hilfreich. Die Ergebnisse sollten anschließend mit einer Liste der tatsächlich gewünschten indexierbaren Seiten verglichen werden.

Eine einfache Tabelle mit URL, Seitentyp, gewünschtem Indexierungsstatus, HTTP-Status, Canonical und Priorität schafft dabei Transparenz. So wird sichtbar, ob beispielsweise Produktseiten, Ratgeberartikel oder Kategorieseiten unterschiedlich behandelt werden müssen.

Indexierung einer Website überprüfen: Schritt-für-Schritt-Anleitung

1. Gewünschte indexierbare Seiten definieren

Bevor Sie Fehler suchen, sollten Sie festlegen, welche Seitentypen überhaupt in den Suchindex gehören. Das können beispielsweise hochwertige Leistungsseiten, Produktseiten, redaktionelle Ratgeber oder lokale Standortseiten sein. Nicht jede URL muss indexiert werden. Interne Suchergebnisse, Warenkorbseiten, persönliche Kontobereiche und viele Filterkombinationen sind häufig keine eigenständigen Suchergebnisse.

Erstellen Sie deshalb eine Zielvorstellung: Welche Seiten sollen gefunden werden, welche dürfen zugänglich bleiben, sollen aber nicht im Index erscheinen, und welche URLs können vollständig entfernt oder weitergeleitet werden? Ohne diese Unterscheidung wirkt eine hohe Zahl ausgeschlossener URLs schnell wie ein Fehler, obwohl sie beabsichtigt sein kann.

2. Die Indexierungsberichte auswerten

Beginnen Sie mit der Search Console und betrachten Sie nicht nur die Gesamtzahl, sondern vor allem die konkreten Ausschlussgründe. Prüfen Sie, ob sich die betroffenen URLs auf wichtige Seitentypen konzentrieren. Ein Ausschluss ist nicht automatisch problematisch; problematisch wird er, wenn eine wertvolle Zielseite betroffen ist.

Priorisieren Sie die Analyse nach geschäftlicher und redaktioneller Bedeutung. Eine einzelne wichtige Angebotsseite kann dringender sein als viele bewusst ausgeschlossene Parameter-URLs. Dokumentieren Sie für jeden relevanten Fall die vermutete Ursache, die gewünschte Lösung und den Zeitpunkt der erneuten Prüfung.

3. Einzelne wichtige URLs mit der URL-Prüfung kontrollieren

Wählen Sie repräsentative URLs aus: die Startseite, wichtige Kategorie- oder Leistungsseiten, neue Inhalte, stark verlinkte Artikel und Seiten mit auffälligen Zugriffsrückgängen. Prüfen Sie, ob die URL indexiert ist und ob die angezeigte Canonical-URL der eigenen Absicht entspricht.

Wenn eine Seite nicht indexiert ist, kontrollieren Sie die Live-Version zusätzlich. Eine Diskrepanz zwischen der zuletzt gespeicherten Version und dem aktuellen Zustand kann darauf hindeuten, dass Änderungen noch nicht verarbeitet wurden oder dass die technische Situation inzwischen anders ist.

4. Technische Indexierungssignale prüfen

Für jede wichtige Seite sollten mehrere Signale zusammenpassen:

  • Der Server liefert einen erfolgreichen Statuscode, normalerweise 200.
  • Die Seite ist ohne Anmeldung erreichbar und wird nicht durch eine fehlerhafte Weiterleitung ersetzt.
  • Es gibt kein unbeabsichtigtes noindex im HTML oder in einem HTTP-Header.
  • Die robots.txt blockiert den benötigten Abruf nicht.
  • Der Canonical verweist auf die bevorzugte, indexierbare URL.
  • Die Seite enthält eigenständigen und nützlichen Inhalt.
  • Sie ist über sinnvolle interne Links erreichbar.

Wichtig ist das Zusammenspiel dieser Signale. Ein Canonical-Tag kann eine Präferenz ausdrücken, ersetzt aber keine sinnvolle URL-Struktur. Eine XML-Sitemap kann eine URL bekannt machen, hebt eine Noindex-Anweisung jedoch nicht automatisch auf.

5. XML-Sitemap und interne Verlinkung abgleichen

Die XML-Sitemap sollte bevorzugt URLs enthalten, die dauerhaft erreichbar, kanonisch und tatsächlich indexierbar sind. Entfernen Sie dort nach Möglichkeit Weiterleitungen, Fehlerseiten, nicht kanonische Varianten und Seiten, die ausdrücklich nicht in den Index sollen.

Vergleichen Sie die Sitemap anschließend mit den internen Links und den Search-Console-Daten. Fehlt eine wichtige Seite in der Sitemap, kann sie trotzdem indexiert werden, sollte aber nicht unnötig schwer auffindbar sein. Umgekehrt ist ein Eintrag in der Sitemap keine Garantie für eine Indexierung.

Besonders kritisch sind verwaiste Seiten. Wenn eine URL nur in der Sitemap steht, aber von keiner relevanten Seite intern verlinkt wird, fehlen Suchmaschinen und Nutzern wichtige Kontextsignale. Ergänzen Sie passende Links in thematisch verwandten Inhalten, Navigationselementen oder Übersichtsseiten.

6. Inhalte auf eigenständigen Nutzen prüfen

Technische Erreichbarkeit allein reicht nicht immer aus. Suchmaschinen können Seiten mit sehr wenig eigenständigem Inhalt, automatisch erzeugten Varianten oder stark ähnlichen Texten nicht prominent berücksichtigen oder gar nicht indexieren. Prüfen Sie deshalb, ob eine Seite eine klar erkennbare Suchintention beantwortet und gegenüber ähnlichen URLs einen eigenen Zweck erfüllt.

Hilfreiche Fragen sind:

  • Welche konkrete Frage oder Aufgabe beantwortet diese URL?
  • Ist der Inhalt verständlich, aktuell und ausreichend präzise?
  • Enthält die Seite Informationen, die nicht nur aus austauschbaren Standardtexten bestehen?
  • Kann ein Nutzer nach dem Lesen eine sinnvolle Entscheidung treffen oder einen nächsten Schritt ausführen?
  • Gibt es eine andere URL auf der Website, die dieselbe Aufgabe besser erfüllt?

Wenn mehrere URLs nahezu denselben Zweck haben, können eine Zusammenführung, eine klare Canonical-Strategie oder eine gezielte Aussonderung sinnvoller sein. Die richtige Lösung hängt vom Inhalt und von der Nutzerführung ab.

Häufige Gründe für fehlende Indexierung

Noindex-Anweisung

Ein Meta-Robots-Tag mit noindex oder ein entsprechender HTTP-Header weist Suchmaschinen an, die Seite nicht in den Index aufzunehmen. Das ist bei nicht öffentlichen oder funktionalen Seiten nützlich, wird aber bei Relaunches oder durch fehlerhafte Vorlagen manchmal versehentlich auf wichtige Inhalte übertragen.

Blockierung durch robots.txt

Die robots.txt steuert, welche Bereiche gecrawlt werden dürfen. Eine Sperre kann den Abruf einer Seite verhindern, ist aber nicht das geeignete Mittel, um eine bereits bekannte URL zuverlässig aus dem Index zu entfernen. Prüfen Sie Regeln immer im Zusammenhang mit dem gewünschten Ziel und vermeiden Sie pauschale Sperren ganzer Verzeichnisse, wenn darin wichtige Inhalte liegen.

Falsches Canonical

Verweist das Canonical einer Seite auf eine andere URL, kann die Suchmaschine diese andere Adresse als bevorzugte Version behandeln. Ein Fehler entsteht beispielsweise, wenn viele unterschiedliche Seiten auf die Startseite oder eine alte URL kanonisiert werden. Das Canonical sollte zur tatsächlichen Inhaltsstruktur passen und auf eine erreichbare, indexierbare Zielseite zeigen.

„Gecrawlt – derzeit nicht indexiert“

Dieser Status bedeutet nicht zwangsläufig einen technischen Defekt. Er kann darauf hindeuten, dass die Seite zwar abgerufen wurde, aber derzeit keinen ausreichenden eigenständigen Wert erkennen lässt, sehr ähnlich zu anderen URLs ist oder noch nicht verarbeitet wurde. Prüfen Sie Inhalt, interne Verlinkung, Seitentyp und technische Signale gemeinsam, statt die URL lediglich mehrfach zur Indexierung einzureichen.

Server- und Weiterleitungsfehler

Statuscodes wie 404 oder 410 sind bei absichtlich entfernten Inhalten normal, bei wichtigen Landingpages jedoch problematisch. Auch dauerhafte Weiterleitungen sollten möglichst direkt auf das passende Ziel führen. Ketten, Schleifen und wechselnde Weiterleitungsziele erschweren die Verarbeitung und verschlechtern die Nutzererfahrung.

JavaScript und schwer zugängliche Inhalte

Moderne Websites können Inhalte dynamisch laden. Wenn der wesentliche Text erst durch fehlerhaftes JavaScript erscheint oder wichtige Links nicht als normale, verarbeitbare Verknüpfungen vorliegen, kann die Verarbeitung erschwert werden. Prüfen Sie daher, ob der Hauptinhalt auch in einer technisch robusten Auslieferung vorhanden ist und ob zentrale Navigationswege funktionieren.

Wie Sie Indexierungsprobleme sinnvoll beheben

Beginnen Sie mit der Ursache und nicht mit dem erneuten Einreichen jeder betroffenen URL. Entfernen Sie eine unbeabsichtigte Noindex-Anweisung, korrigieren Sie den Canonical, beheben Sie den Serverfehler oder verbessern Sie die interne Verlinkung. Bei Qualitätsproblemen sollte zuerst der Inhalt überarbeitet werden.

Danach können Sie die betroffene URL in der Search Console erneut prüfen lassen oder eine Validierung des entsprechenden Problems anstoßen. Die Verarbeitung benötigt Zeit und ist keine Garantie für eine Aufnahme. Kontrollieren Sie nach angemessener Wartezeit, ob sich der Status und die Sichtbarkeit tatsächlich verändert haben.

Bei vielen URLs empfiehlt sich ein kontrolliertes Vorgehen:

  1. Problem und betroffene URL-Gruppe dokumentieren.
  2. Ursache anhand von Quellcode, Serverantwort, robots.txt, Sitemap und internen Links bestätigen.
  3. Änderung zunächst an repräsentativen URLs testen.
  4. Die technische Umsetzung auf weitere URLs ausrollen.
  5. Nachverfolgen, ob die wichtigen Seiten erreichbar, indexierbar und in den Berichten korrekt eingeordnet sind.

Messbare Kriterien für eine verlässliche Kontrolle

Eine gute Prüfung beschränkt sich nicht auf „indexiert“ oder „nicht indexiert“. Sinnvolle Kontrollgrößen sind unter anderem:

Kriterium Worauf Sie achten sollten
Indexierbare Zielseiten Wichtige URLs sind technisch erreichbar, nicht versehentlich gesperrt und eindeutig zugeordnet.
Ausschlussgründe Bewusste Ausschlüsse sind nachvollziehbar; wichtige Inhalte tauchen nicht unerwartet darin auf.
XML-Sitemap Sie enthält aktuelle, kanonische und indexierbare URLs ohne unnötige Varianten.
Interne Verlinkung Relevante Seiten sind über thematisch passende Links erreichbar.
Statuscodes Wichtige Inhalte liefern eine passende erfolgreiche Antwort und keine Fehler- oder Umleitungskette.
Organische Sichtbarkeit Indexierung und Suchleistung werden getrennt bewertet; eine indexierte Seite muss nicht automatisch gut ranken.

Für kleine Websites reicht oft eine monatliche oder anlassbezogene Kontrolle, etwa nach einem Relaunch. Größere Websites mit häufigen Veröffentlichungen sollten technische Warnungen, Sitemap-Änderungen und wichtige URL-Gruppen enger überwachen. Der passende Rhythmus richtet sich nach Änderungsfrequenz und Risiko.

FAQ

Wie kann ich schnell prüfen, ob eine einzelne Seite indexiert ist?

Geben Sie die vollständige URL in die URL-Prüfung der Google Search Console ein. Als ergänzenden Plausibilitätscheck können Sie nach der exakten URL oder mit dem Operator site: suchen. Die Search Console liefert für die eigene bestätigte Website in der Regel die aussagekräftigere technische Einordnung.

Ist eine Website mit einer Suche nach „site:Domain“ vollständig geprüft?

Nein. Der Suchoperator zeigt keine garantiert vollständige Liste und kann eine ungenaue oder schwankende Anzahl anzeigen. Er eignet sich für einen schnellen Überblick, sollte aber mit Search-Console-Berichten, einer Sitemap und einer technischen URL-Analyse kombiniert werden.

Warum wird eine Seite trotz XML-Sitemap nicht indexiert?

Eine Sitemap macht eine URL bekannt, erzwingt aber keine Indexierung. Gründe können unter anderem eine Noindex-Anweisung, ein falsches Canonical, sehr ähnlicher Inhalt, fehlende interne Verlinkung, technische Fehler oder ein noch nicht abgeschlossener Verarbeitungsprozess sein.

Wie lange dauert es, bis eine Änderung berücksichtigt wird?

Das lässt sich nicht pauschal vorhersagen. Es hängt unter anderem von der Website, der URL, der Änderungsfrequenz und der technischen Situation ab. Nach einer Korrektur sollten Sie die Seite erneut prüfen, aber nicht aus einer kurzen Verzögerung sofort auf einen dauerhaften Fehler schließen.

Sollten alle Seiten einer Website indexiert werden?

Nein. Funktionale Seiten, interne Suchergebnisse, bestimmte Filtervarianten oder private Bereiche haben oft keinen eigenständigen Nutzen für Suchende. Entscheidend ist, dass die für Nutzer und Suchmaschinen relevanten Seiten gezielt indexierbar sind und unnötige Varianten nicht die Website-Struktur verwässern.

Was ist der Unterschied zwischen Crawling und Indexierung?

Crawling bezeichnet den Abruf und die Verarbeitung einer URL durch einen Suchmaschinenbot. Indexierung ist die anschließende Entscheidung, ob und wie diese Seite im Suchindex gespeichert wird. Eine gecrawlte Seite kann deshalb trotzdem nicht indexiert sein.

Kann eine indexierte Seite trotzdem unsichtbar wirken?

Ja. Indexierung bedeutet nur, dass eine Seite grundsätzlich im Index vorhanden sein kann. Sie kann für ein bestimmtes Keyword eine sehr niedrige Position haben, eine andere Suchintention bedienen oder in einer personalisierten beziehungsweise lokal unterschiedlichen Suche nicht prominent erscheinen. Für die Bewertung müssen Indexierung, Suchintention und Ranking getrennt betrachtet werden.

Fazit: Indexierung systematisch statt zufällig prüfen

Wer die Indexierung einer Website überprüfen möchte, sollte mehrere Ebenen verbinden: gewünschte Zielseiten, Search-Console-Daten, technische Signale, XML-Sitemap, interne Verlinkung und die Qualität der Inhalte. Eine einzelne Suchabfrage oder ein einzelner Status reicht selten für eine verlässliche Diagnose.

Am effizientesten ist ein priorisiertes Vorgehen. Definieren Sie zunächst, welche URLs sichtbar sein sollen, prüfen Sie danach deren technische Erreichbarkeit und untersuchen Sie erst anschließend größere URL-Mengen. So unterscheiden Sie bewusste Ausschlüsse von echten Fehlern und investieren Ihre Zeit dort, wo die Website und ihre Nutzer am meisten profitieren.

Suchmaschinen-Crawling verbessern: Ein praxisnaher Leitfaden für Websites

Wenn Suchmaschinen eine Website regelmäßig und vollständig crawlen können, werden neue und überarbeitete Inhalte schneller entdeckt und in den Suchindex aufgenommen. Crawling allein garantiert zwar keine guten Rankings, ist aber eine wichtige technische Grundlage für organische Sichtbarkeit. Dieser Ratgeber zeigt, wie Sie das Suchmaschinen-Crawling verbessern, typische Hindernisse erkennen und technische Maßnahmen sinnvoll priorisieren.

Im Mittelpunkt stehen keine kurzfristigen Tricks, sondern eine saubere Website-Struktur, eindeutig erreichbare Inhalte und verlässliche technische Signale. Die Empfehlungen eignen sich für kleinere Websites ebenso wie für umfangreichere Projekte mit vielen Unterseiten.

Was bedeutet Suchmaschinen-Crawling?

Beim Crawling rufen Suchmaschinen automatisiert Webseiten auf. Dafür folgen ihre Crawler, häufig auch Bots oder Suchroboter genannt, Links, lesen technische Hinweise und prüfen Inhalte. Die gefundenen Seiten können anschließend verarbeitet und – sofern sie die jeweiligen Voraussetzungen erfüllen – in den Suchindex aufgenommen werden.

Crawling und Indexierung sind nicht dasselbe. Eine Suchmaschine kann eine URL kennen und aufrufen, ohne sie in den Index aufzunehmen. Umgekehrt kann eine wichtige Seite schwer auffindbar sein, wenn sie intern schlecht verlinkt ist oder technische Barrieren bestehen. Wer das Suchmaschinen-Crawling verbessern möchte, sollte deshalb die gesamte Kette betrachten:

  • Entdeckung: Kann der Crawler die URL über Links oder eine XML-Sitemap finden?
  • Zugriff: Darf der Crawler die URL abrufen und erhält er eine verwertbare Antwort?
  • Verarbeitung: Sind Inhalt, Canonical-Signal und technische Auszeichnung eindeutig?
  • Priorisierung: Ist erkennbar, welche Seiten wichtig und aktuell sind?

Ein Crawling-Problem zeigt sich daher nicht immer als vollständiger Ausschluss. Auch unnötig häufige Aufrufe von unwichtigen URLs können Aufmerksamkeit und Ressourcen von relevanten Seiten abziehen.

Die wichtigsten Grundlagen für besseres Crawling

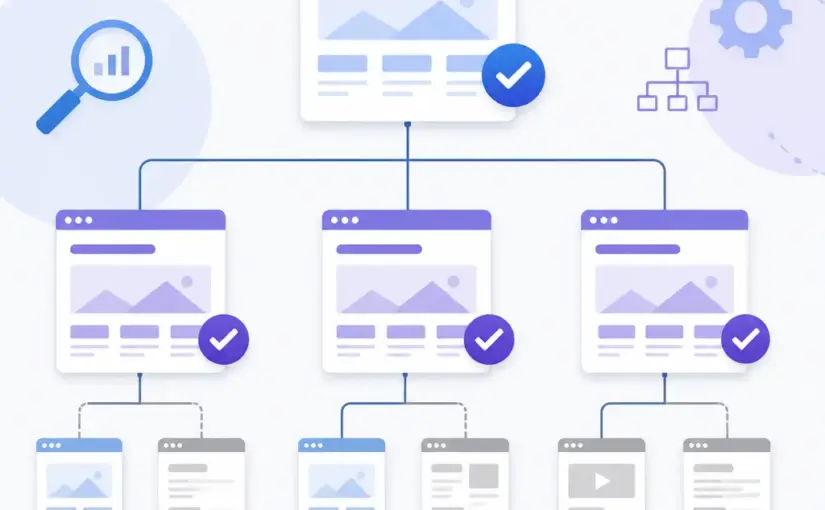
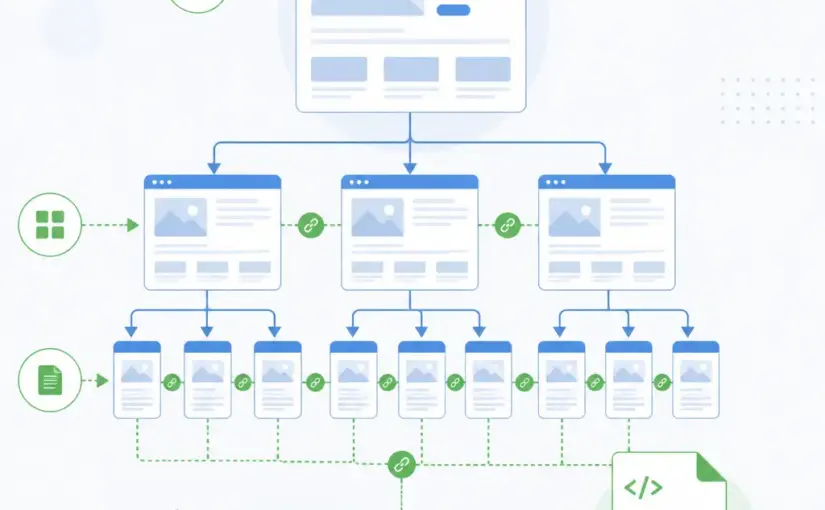
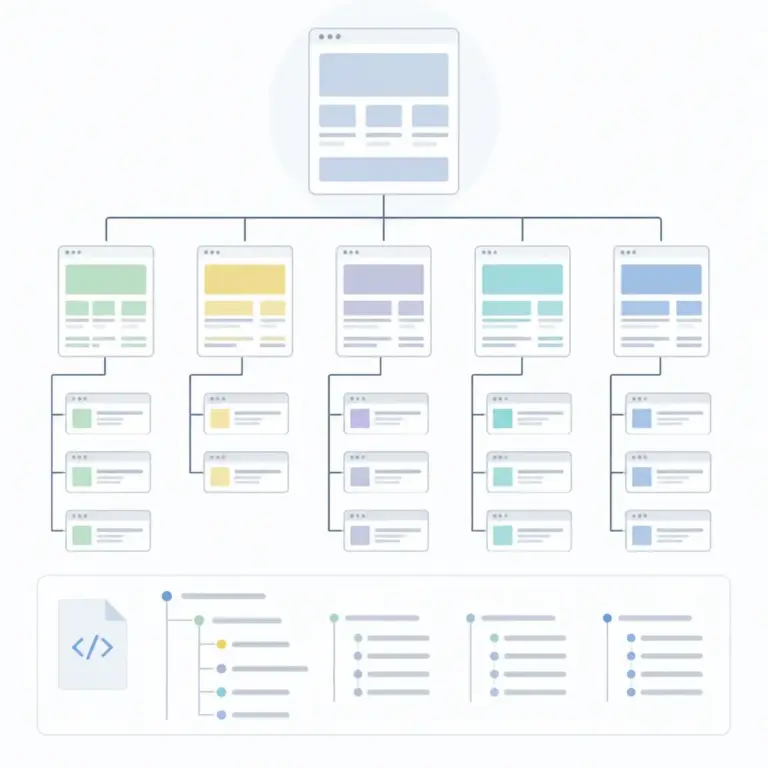
u00dcbersichtliche Website-Struktur mit Kategorien, Inhaltsseiten und internen Verbindungen
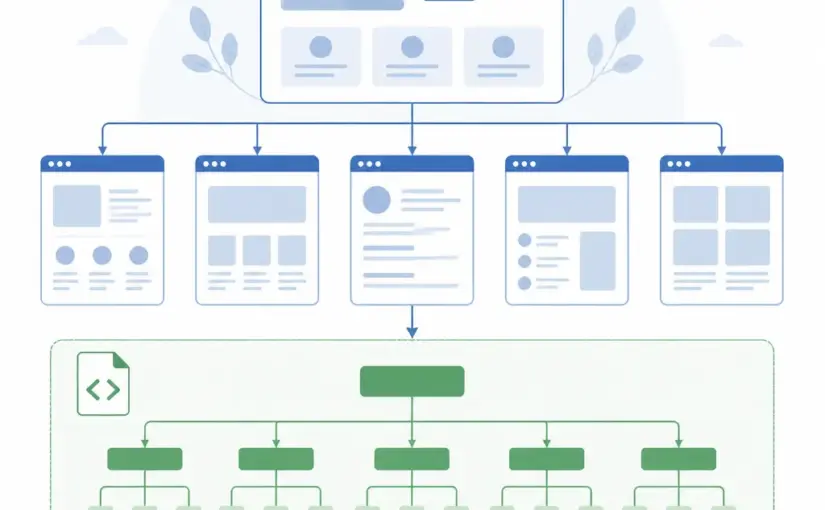
Eine klare Website-Struktur erleichtert die Auffindbarkeit wichtiger Inhalte.

Die Grafik zeigt, wie Startseite, Übersichtsseiten und Inhalte sinnvoll miteinander verbunden werden können. Achten Sie besonders darauf, dass wichtige Seiten nicht als isolierte Endpunkte erscheinen.

Eine logisch aufgebaute Website-Struktur schaffen

Eine klare Informationsarchitektur erleichtert Menschen und Suchmaschinen die Orientierung. Ordnen Sie Inhalte nach nachvollziehbaren Themen und sorgen Sie dafür, dass wichtige Seiten mit wenigen sinnvollen Klicks erreichbar sind. Die genaue Klicktiefe ist kein alleiniger Qualitätsmaßstab, aber sehr verschachtelte Strukturen erschweren die Pflege und die Entdeckung von Inhalten.

Jede zentrale Seite sollte mindestens einen thematisch passenden internen Link von einer anderen erreichbaren Seite erhalten. Vermeiden Sie Strukturen, in denen wichtige Inhalte ausschließlich über eine interne Suche, Filter oder JavaScript-Interaktionen erreichbar sind. Ein sichtbarer HTML-Link mit einer verständlichen Zieladresse ist in der Regel die robusteste Grundlage.

Interne Links gezielt einsetzen

Interne Verlinkung verbindet Inhalte und hilft dabei, ihre Bedeutung innerhalb der Website einzuordnen. Verlinken Sie beispielsweise einen ausführlichen Leitfaden aus passenden Ratgeberartikeln, Kategorien und relevanten Übersichtsseiten. Der Linktext sollte kurz beschreiben, was auf der Zielseite zu erwarten ist.

Prüfen Sie regelmäßig, ob Links auf Fehlerseiten, Weiterleitungsketten oder veraltete URLs führen. Ein Linknetz mit vielen defekten Verbindungen erschwert die Navigation und kann dazu führen, dass wichtige Inhalte weniger zuverlässig entdeckt werden.

XML-Sitemap aktuell halten

Eine XML-Sitemap kann Suchmaschinen eine zusätzliche Übersicht über wichtige URLs geben. Sie ersetzt keine interne Verlinkung, ist aber besonders bei größeren Websites, häufigen Änderungen oder neuen Projekten hilfreich.

In die Sitemap gehören grundsätzlich nur URLs, die tatsächlich indexierbar sein sollen. Entfernen Sie nach Möglichkeit Seiten mit einem dauerhaften Ausschluss, nicht kanonische Varianten, Weiterleitungen und offensichtliche Fehler-URLs. Achten Sie außerdem auf gültige absolute URLs, einen erreichbaren Sitemap-Pfad und eine Aktualisierung nach relevanten Änderungen.

Die Sitemap sollte nicht als vollständiges Archiv jeder jemals erzeugten URL verstanden werden. Ihre Aufgabe ist es, Suchmaschinen eine kuratierte Liste wichtiger, gültiger und zugänglicher Seiten zu liefern.

Robots.txt, Meta-Robots und Zugriffssignale richtig verwenden

Die Datei robots.txt kann Crawlern mitteilen, welche Bereiche sie nicht abrufen sollen. Sie ist jedoch kein zuverlässiger Schutz für vertrauliche Inhalte. Nicht öffentlich bestimmte Informationen gehören hinter eine geeignete Zugriffskontrolle und sollten nicht allein durch robots.txt verborgen werden.

Ein zu großzügiger Ausschluss kann das Crawling erheblich behindern. Prüfen Sie deshalb jede Disallow-Regel darauf, ob sie wirklich notwendig ist. Besonders riskant sind pauschale Regeln für Verzeichnisse, in denen sich neben unwichtigen Parametervarianten auch redaktionell relevante Inhalte befinden.

Ein wichtiger Unterschied: Ein Crawling-Ausschluss in robots.txt verhindert in erster Linie den Abruf. Ein noindex-Signal wird dagegen erst ausgewertet, wenn die betreffende Seite abgerufen werden kann. Wer eine Seite gezielt aus dem Index entfernen möchte, sollte die passende Methode im jeweiligen technischen Umfeld sorgfältig prüfen und nicht mehrere widersprüchliche Signale ohne Plan kombinieren.

Typische Fehler bei robots.txt

  • Die gesamte Website wird versehentlich mit einer allgemeinen Regel blockiert.
  • CSS- oder JavaScript-Ressourcen werden gesperrt, obwohl sie für die Darstellung oder Verarbeitung relevant sind.
  • Eine alte Testregel bleibt nach dem Relaunch bestehen.
  • Parameter werden pauschal blockiert, obwohl dadurch wichtige Zielseiten nicht mehr erreichbar sind.
  • Die Sitemap wird mit einer falschen oder nicht erreichbaren Adresse angegeben.

Nach Änderungen sollten Sie die Datei aus Sicht verschiedener URL-Typen prüfen: Startseite, wichtige Inhaltsseite, Kategorie, Medien- oder Produktseite sowie eine bewusst auszuschließende URL.

URL-Struktur, Statuscodes und Weiterleitungen prüfen

Eine verständliche URL-Struktur hilft bei der Verwaltung und reduziert unnötige Varianten. Vermeiden Sie, wenn möglich, mehrere URLs für denselben Inhalt, unkontrolliert erzeugte Parameter und dauerhaft wechselnde Pfade. URLs sollten stabil bleiben und den Inhalt nicht durch übermäßig viele technische Kennungen verschleiern.

Der HTTP-Statuscode liefert dem Crawler einen wichtigen Hinweis:

  • 200: Die Ressource wurde erfolgreich ausgeliefert.
  • 3xx: Die Anfrage wird weitergeleitet oder benötigt eine weitere Verarbeitung.
  • 4xx: Die angeforderte Ressource ist aus Sicht des Servers nicht verfügbar.
  • 5xx: Der Server konnte die Anfrage nicht erfolgreich verarbeiten.

Einzelne Fehler sind auf jeder größeren Website möglich. Problematisch wird es, wenn interne Links regelmäßig auf nicht vorhandene URLs zeigen, Weiterleitungen in Ketten auftreten oder viele relevante Seiten vorübergehend mit Serverfehlern antworten. Korrigieren Sie interne Links möglichst direkt und leiten Sie dauerhaft verschobene Inhalte auf die passendste neue URL weiter.

Beachten Sie auch, dass eine Weiterleitung kein Ersatz für eine konsequente interne Verlinkung ist. Wenn eine Seite dauerhaft umgezogen ist, sollten die wichtigsten Links auf die endgültige Adresse zeigen.

Duplicate Content und URL-Varianten reduzieren

Technische Systeme erzeugen häufig mehrere URLs mit gleichem oder sehr ähnlichem Inhalt. Beispiele sind Filter, Sortierungen, Tracking-Parameter, Druckansichten, Session-Kennungen oder unterschiedliche Schreibweisen. Dadurch kann eine Website unnötig viele crawlbare Adressen erzeugen.

Der erste Schritt ist eine Bestandsaufnahme: Welche URL-Varianten existieren, welche davon werden intern verlinkt und welche sollen überhaupt in den Suchindex gelangen? Danach lassen sich passende Maßnahmen auswählen:

  • Parameter nur dann verwenden, wenn sie einen echten Zweck erfüllen.
  • Für gleichartige Inhalte eine bevorzugte kanonische URL festlegen.
  • Unnötige Varianten vermeiden oder technisch kontrolliert behandeln.
  • Interne Links konsequent auf die gewünschte Hauptversion richten.
  • Bei dauerhaft zusammengeführten Inhalten geeignete Weiterleitungen einsetzen.

Das rel="canonical"-Element ist ein Hinweis auf die bevorzugte Version, aber keine pauschale Garantie für die Auswahl durch eine Suchmaschine. Es sollte nur auf eine inhaltlich passende, erreichbare und indexierbare Ziel-URL verweisen. Ein Canonical auf eine thematisch unpassende Seite kann die technische Klarheit verschlechtern.

JavaScript, Rendering und wichtige Inhalte

Moderne Websites laden Inhalte teilweise nachträglich über JavaScript. Das kann funktionieren, macht die Verarbeitung aber komplexer als eine direkt ausgelieferte HTML-Struktur. Besonders wichtige Informationen sollten deshalb nicht ausschließlich nach einer Interaktion, einem Scrollvorgang oder einem clientseitigen Datenabruf erscheinen.

Prüfen Sie, ob der zentrale Text, interne Links, Überschriften und relevante Metadaten im ausgelieferten Dokument oder nach der vorgesehenen Verarbeitung zuverlässig vorhanden sind. Achten Sie außerdem darauf, dass Links echte, erreichbare Zieladressen besitzen und nicht nur durch Klick-Handler simuliert werden.

Eine gute Praxis ist die schrittweise Prüfung: Zuerst sollte die Seite ohne unnötige Abhängigkeiten eine verständliche Grundstruktur liefern. Danach können dynamische Funktionen die Darstellung und Bedienung erweitern. Bei einem Relaunch empfiehlt sich ein Vergleich wichtiger Seiten vor und nach der technischen Umstellung.

Serverleistung und Crawling-Budget verstehen

Suchmaschinen verfügen nicht über unbegrenzte Kapazitäten für jede Website. Die verfügbare Aufmerksamkeit hängt unter anderem von der Größe, Aktualität, Qualität, Erreichbarkeit und technischen Stabilität eines Projekts ab. Für kleine Websites ist das sogenannte Crawling-Budget oft kein akutes Problem. Bei großen oder stark parameterisierten Websites kann es jedoch wichtig werden.

Die sinnvollste Maßnahme ist nicht, Crawler um jeden Preis zu einer höheren Abruffrequenz zu bewegen. Stattdessen sollte die Website möglichst wenige unnötige URLs erzeugen und wichtige Inhalte zuverlässig ausliefern. Dazu gehören:

  • stabile Serverantworten und möglichst geringe Ausfallzeiten,
  • eine Begrenzung nutzloser Filter- und Parameterkombinationen,
  • eine nachvollziehbare interne Verlinkung,
  • aktuelle Sitemaps ohne Fehler- und Weiterleitungs-URLs,
  • regelmäßige Kontrolle von Serverprotokollen und technischen Reports.

Langsame Ladezeiten sind nicht ausschließlich ein Crawling-Thema. Sie beeinflussen auch die Nutzung und die technische Verarbeitung. Priorisieren Sie daher die Ursachen: überlastete Server, unnötig große Ressourcen, fehlerhafte Caches oder ineffiziente Datenbankabfragen sollten getrennt untersucht werden.

Nach einem Relaunch das Crawling absichern

Ein Relaunch verändert häufig URLs, Navigation, Templates, interne Links und technische Regeln gleichzeitig. Deshalb sollte die Crawling-Prüfung bereits vor der Veröffentlichung beginnen. Erstellen Sie eine Liste der wichtigsten alten URLs und ordnen Sie ihnen – falls erforderlich – passende neue Zieladressen zu.

Direkt nach dem Start sollten Sie mindestens diese Punkte kontrollieren:

  • Ist die Website öffentlich erreichbar und nicht versehentlich blockiert?
  • Funktionieren wichtige alte und neue URLs mit dem vorgesehenen Statuscode?
  • Gibt es Weiterleitungsketten oder massenhaft nicht gefundene Seiten?
  • Enthält die neue Sitemap nur gültige Zieladressen?
  • Sind Canonical- und Meta-Robots-Signale korrekt gesetzt?
  • Führen interne Links nicht mehr auf alte oder falsche Pfade?
  • Sind zentrale Inhalte auch ohne problematische Interaktionen auffindbar?

Die Nachkontrolle sollte nicht auf einen einzigen Tag beschränkt bleiben. Beobachten Sie technische Fehler und auffällige URL-Muster über einen angemessenen Zeitraum, da manche Probleme erst durch das erneute Crawling sichtbar werden.

Werkzeuge für die technische Kontrolle

Für die Analyse stehen verschiedene Werkzeugarten zur Verfügung. Nutzen Sie keine einzelne Quelle als vollständige Wahrheit, sondern vergleichen Sie die Perspektiven:

  • Suchmaschinen-Tools: Sie zeigen häufig erkannte Indexierungs-, Abruf- oder Sitemap-Probleme für die jeweilige Property.
  • Serverprotokolle: Sie dokumentieren, welche URLs tatsächlich von welchen Crawlern angefragt wurden und welche Antworten der Server zurückgab.
  • Crawler für technische Audits: Sie können interne Links, Statuscodes, Canonicals, Weiterleitungen und viele URL-Varianten systematisch erfassen.
  • Browser- und Entwicklerwerkzeuge: Sie helfen bei der Prüfung von Netzwerkaufrufen, gerendertem Inhalt und blockierten Ressourcen.

Bewerten Sie Ergebnisse immer im Kontext. Eine einzelne nicht gecrawlte URL ist weniger aussagekräftig als ein wiederkehrendes Muster aus vielen fehlerhaften Seiten, widersprüchlichen Signalen oder ständig neuen Parameteradressen. Dokumentieren Sie Befunde mit URL, Ursache, Priorität und geplanter Lösung.

Eine sinnvolle Priorisierung der Maßnahmen

Nicht jede technische Auffälligkeit verdient dieselbe Aufmerksamkeit. Beginnen Sie mit Problemen, die viele wichtige URLs betreffen oder den Zugriff grundsätzlich verhindern. Eine praktikable Reihenfolge lautet:

  1. Zugriff sichern: Blockierungen, Serverfehler und falsche Weiterleitungen beheben.
  2. Wichtige URLs eindeutig machen: Canonicals, interne Links und Zieladressen vereinheitlichen.
  3. Unnötige URL-Mengen reduzieren: Parameter, Filter und doppelte Varianten kontrollieren.
  4. Sitemap und Architektur bereinigen: wichtige Inhalte klar auffindbar und korrekt gelistet halten.
  5. Rendering und Leistung verbessern: zentrale Inhalte zuverlässig ausliefern und technische Engpässe reduzieren.
  6. Kontinuierlich überwachen: Änderungen dokumentieren und wiederkehrende Fehler erkennen.

Die Priorität sollte sich nach Auswirkungen, Umfang und Aufwand richten. Eine kleine Korrektur an einer robots.txt kann wichtiger sein als zahlreiche Detailverbesserungen an einzelnen Seiten. Umgekehrt lohnt sich eine aufwendige Bereinigung großer URL-Mengen erst dann, wenn die grundlegenden Zugriffsprobleme gelöst sind.

FAQ

Wie kann ich das Suchmaschinen-Crawling verbessern?

Beginnen Sie mit einer klaren internen Verlinkung, einer aktuellen XML-Sitemap und einer korrekten robots.txt. Prüfen Sie zusätzlich Statuscodes, Weiterleitungen, Canonical-Signale, URL-Varianten und die Erreichbarkeit wichtiger Inhalte. Entscheidend ist eine Kombination dieser Maßnahmen, nicht ein einzelner technischer Schalter.

Wie schnell werden Änderungen gecrawlt?

Das lässt sich nicht allgemein garantieren. Die Geschwindigkeit hängt unter anderem von Websitegröße, Aktualität, technischer Stabilität und der Bedeutung der jeweiligen URL ab. Nach wichtigen Änderungen sollten Sie die technische Erreichbarkeit sofort kontrollieren und die weitere Entwicklung anhand geeigneter Berichte beobachten.

Ist eine XML-Sitemap für jede Website notwendig?

Eine kleine, gut intern verlinkte Website kann auch ohne Sitemap auffindbar sein. Eine XML-Sitemap ist dennoch oft eine hilfreiche zusätzliche Orientierung, insbesondere bei vielen URLs, neuen Websites, häufigen Änderungen oder schwer überschaubaren Strukturen. Sie sollte gepflegt sein und keine beliebigen URL-Varianten enthalten.

Blockiert robots.txt eine Seite dauerhaft aus dem Index?

Robots.txt steuert in erster Linie, ob ein Crawler eine Ressource abrufen darf. Das ist nicht dasselbe wie ein garantiertes Entfernen aus dem Index. Für Ausschlüsse sollten Sie die gewünschte Wirkung, die Erreichbarkeit der Seite und vorhandene Meta- oder HTTP-Signale gemeinsam prüfen.

Was ist wichtiger: Sitemap oder interne Links?

Beides erfüllt unterschiedliche Aufgaben. Interne Links verbinden Inhalte innerhalb der Website und unterstützen ihre Auffindbarkeit und Einordnung. Die Sitemap bietet eine zusätzliche URL-Übersicht. Eine Sitemap sollte daher keine schwache interne Struktur kaschieren.

Kann JavaScript das Crawling verschlechtern?

JavaScript ist nicht automatisch ein Problem. Schwierigkeiten entstehen, wenn wichtige Inhalte, Links oder technische Signale nur unzuverlässig nachgeladen werden. Prüfen Sie deshalb, ob die zentrale Seitenstruktur auch bei der vorgesehenen Verarbeitung vollständig und verständlich verfügbar ist.

Wie erkenne ich unnötige Crawl-Varianten?

Achten Sie in Serverprotokollen, technischen Crawls und Suchmaschinenberichten auf wiederkehrende Parameter, Filterkombinationen, Session-IDs, Druckversionen oder verschiedene Schreibweisen derselben Inhalte. Vergleichen Sie diese Adressen mit Ihren internen Links und entscheiden Sie für jede Gruppe, ob sie indexierbar sein soll.

Fazit: Suchmaschinen-Crawling nachhaltig verbessern

Wer das Suchmaschinen-Crawling verbessern möchte, sollte zuerst die technische Grundlage ordnen: wichtige Inhalte müssen erreichbar, sinnvoll verlinkt, eindeutig adressiert und zuverlässig ausgeliefert werden. Eine aktuelle Sitemap, sorgfältig eingesetzte Zugriffssignale und kontrollierte URL-Varianten unterstützen diesen Prozess.

Besonders nachhaltig ist ein regelmäßiger Prüfablauf. Kontrollieren Sie nach Relaunches und größeren Änderungen die wichtigsten URLs, beobachten Sie Server- und Suchmaschinenberichte und dokumentieren Sie wiederkehrende Fehler. So wird Crawling nicht zu einer einmaligen Reparatur, sondern zu einem festen Bestandteil der Website-Qualität.

Häufige Fehler in der robots.txt: Anleitung zur Prüfung und Behebung

Die Datei robots.txt wirkt unscheinbar, kann aber maßgeblich beeinflussen, welche Bereiche einer Website Suchmaschinen-Crawler erreichen. Ein einzelner zu weit gefasster Pfad, ein falsch gesetztes Zeichen oder eine veraltete Regel kann dazu führen, dass wichtige Inhalte seltener gecrawlt werden oder gar nicht erst in den Suchindex gelangen. Gleichzeitig wird die robots.txt häufig überschätzt: Sie ist kein sicherer Zugriffsschutz und ersetzt weder Authentifizierung noch technische Sicherheitsmaßnahmen.

Dieser Ratgeber zeigt die häufigsten Fehler in der robots.txt, erklärt ihre Auswirkungen und bietet eine systematische Vorgehensweise zur Prüfung. Dabei geht es nicht nur um einzelne Direktiven, sondern auch um den Zusammenhang mit internen Links, XML-Sitemaps, Meta-Robots-Anweisungen, Weiterleitungen und der tatsächlichen Website-Struktur.

Was die robots.txt tatsächlich steuert

Die robots.txt liegt normalerweise im Hauptverzeichnis einer Domain, zum Beispiel unter https://www.beispiel.de/robots.txt. Crawler rufen diese Datei ab, bevor sie URLs derselben Website crawlen. Darin können Regeln stehen, die bestimmten User-Agents den Zugriff auf bestimmte Pfade erlauben oder untersagen.

Wichtig ist die Unterscheidung zwischen Crawling und Indexierung. Eine Disallow-Regel sagt im Kern: Der betreffende Crawler soll den angegebenen Pfad nicht abrufen. Sie garantiert jedoch nicht, dass eine URL niemals im Index auftaucht. Wenn eine blockierte URL von anderen Seiten verlinkt wird, kann eine Suchmaschine ihre Existenz unter Umständen trotzdem erkennen und die URL ohne ausgelesenen Inhalt anzeigen.

Die robots.txt ist deshalb vor allem ein Werkzeug zur Steuerung des Crawlings. Für den Schutz vertraulicher Inhalte sind beispielsweise Zugriffsbeschränkungen, Serverberechtigungen oder eine geeignete Authentifizierung erforderlich. Für die Steuerung der Indexierung kommen unter anderem Meta-Robots-Anweisungen oder HTTP-Header wie X-Robots-Tag infrage, sofern der Crawler die betreffende Ressource abrufen darf.

Die häufigsten Fehler in der robots.txt

Infografik zum Unterschied zwischen Crawling, Indexierung und Zugriffsschutz
Die robots.txt steuert vor allem das Crawling und ersetzt keinen Zugriffsschutz.

Die Grafik sollte zeigen, dass eine robots.txt den Abruf bestimmter Pfade beeinflusst, aber keine vertraulichen Inhalte schützt. Der getrennte Bereich für Indexierung macht sichtbar, warum Disallow und Noindex nicht dasselbe sind.

Die gesamte Website versehentlich blockieren

Der folgenreichste Fehler ist eine Regel, die nahezu alle URLs blockiert:

User-agent: *
Disallow: /

Diese Kombination kann in einer Entwicklungsumgebung sinnvoll sein, wenn eine nicht öffentliche Website nicht von Suchmaschinen gecrawlt werden soll. Auf einer produktiven Website verhindert sie jedoch das Crawling praktisch aller Pfade. Besonders kritisch ist, wenn die Regel beim Umzug, bei einem Relaunch oder durch die Übernahme einer Staging-Konfiguration aktiv bleibt.

Prüfen Sie daher nach jedem Relaunch, jeder Migration und jedem Wechsel des Hosting-Systems, ob die Datei noch zur Produktionsumgebung passt. Die Website sollte außerdem über eine eindeutige Umgebungskontrolle verfügen: Eine Regel, die auf einer Testdomain sinnvoll ist, darf nicht ungeprüft auf der Live-Domain eingesetzt werden.

Wichtige Verzeichnisse zu weit sperren

Ein Pfad kann harmlos wirken, obwohl darunter wichtige Inhalte liegen. Beispiele sind pauschale Sperren für /wp-content/, /assets/, /media/ oder /static/. Werden dort Bilder, Stylesheets, JavaScript-Dateien oder eingebundene Inhalte gespeichert, kann ein Crawler die Darstellung und den funktionalen Aufbau einer Seite möglicherweise nicht vollständig beurteilen.

Früher wurden technische Ressourcen oft pauschal blockiert, um Crawl-Budget zu sparen. In vielen Fällen ist das jedoch kontraproduktiv. Suchmaschinen müssen eine Seite in ihrer ausgelieferten Form verstehen können. Statt ganze Verzeichnisse zu sperren, sollte geprüft werden, ob tatsächlich problematische URL-Muster existieren und ob diese auf andere Weise bereinigt werden können.

Besonders sorgfältig sollten Sie Regeln behandeln, die ein übergeordnetes Verzeichnis betreffen. Eine Sperre für /shop/ erfasst in der Regel auch /shop/produkte/, /shop/kategorien/ und weitere Unterpfade. Die gewünschte Wirkung sollte deshalb immer anhand konkreter Beispiel-URLs kontrolliert werden.

Fehlerhafte Schreibweise von User-agent und Direktiven

Die Grundstruktur einer Regel besteht aus einem User-Agent-Block und einer oder mehreren Direktiven:

User-agent: *
Disallow: /intern/

Typische Schreibfehler sind fehlende Doppelpunkte, vertauschte Feldnamen, zusätzliche Sonderzeichen oder eine unklare Mischung aus mehreren Blöcken. Die Namen der Direktiven sollten korrekt geschrieben werden, insbesondere User-agent, Disallow und Allow. Unbekannte oder nicht unterstützte Anweisungen werden nicht automatisch so interpretiert, wie der Verfasser es beabsichtigt hat.

Auch Kommentare sollten sauber mit einem # beginnen. Ein Kommentar kann bei der Pflege helfen, darf aber nicht versehentlich einen Teil einer wirksamen Regel ausblenden. Für eine verständliche Datei sind kurze, sachliche Kommentare sinnvoll, etwa zur Kennzeichnung einer temporären Ausnahme oder eines bewusst gesperrten Suchparameters.

Allow und Disallow falsch miteinander kombinieren

Mit Allow können Ausnahmen innerhalb eines gesperrten Bereichs formuliert werden, sofern der jeweilige Crawler diese Direktive unterstützt und die Regeln nach seinen Prioritätsregeln auswertet. Ein Beispiel ist:

User-agent: *
Disallow: /bereich/
Allow: /bereich/oeffentlich/

Solche Ausnahmen sind fehleranfällig, wenn mehrere Regeln ähnliche Pfade betreffen. Entscheidend ist nicht nur die Reihenfolge der Zeilen. Je nach Auswertung spielen unter anderem die konkretere Übereinstimmung und die unterstützte Syntax eine Rolle. Verlassen Sie sich daher nicht auf ein Bauchgefühl, sondern prüfen Sie konkrete URLs mit einem geeigneten Validator oder einer dokumentierten Testmethode.

Oft ist eine einfachere Struktur besser: Wenn nur wenige private Verzeichnisse nicht gecrawlt werden sollen, können diese direkt genannt werden. Eine lange Kette aus verschachtelten Ausnahmen erschwert die spätere Wartung und erhöht die Gefahr widersprüchlicher Regeln.

Wildcards unpräzise oder zu großzügig verwenden

Wildcards können wiederkehrende Muster erfassen, etwa URLs mit bestimmten Parametern. Eine zu breite Regel kann jedoch weit mehr blockieren als beabsichtigt. Ein Muster wie Disallow: /*? zielt beispielsweise auf URLs mit einem Fragezeichen. Je nach Website können darunter aber auch nützliche, indexierbare URLs liegen, die nicht bloß Sortierungen oder Tracking-Parameter enthalten.

Vor jeder Wildcard-Regel sollten Sie eine Liste realer URLs betrachten. Welche Parameter erzeugen Duplikate? Welche verändern den eigentlichen Seiteninhalt? Welche werden intern verlinkt? Eine pauschale Sperre ist nicht automatisch die beste Lösung, denn sie kann auch das Crawling wertvoller Varianten unterbinden. Häufig sind eine saubere interne Verlinkung, kanonische Angaben und eine konsistente URL-Logik langfristig robuster.

Slash, Groß- und Kleinschreibung sowie Pfadgrenzen übersehen

Pfadangaben müssen zur tatsächlichen URL-Struktur passen. /admin und /administrator sind unterschiedliche Pfade. Ebenso kann /shop je nach Regelwerk nicht dieselbe Bedeutung haben wie /shop/. Eine Regel, die einen Pfad ohne abschließenden Schrägstrich erfasst, sollte deshalb auf ihre Wirkung bei ähnlichen Pfaden geprüft werden.

Auch die Schreibweise kann relevant sein. Wenn der Server zwischen Groß- und Kleinschreibung unterscheidet, sind /Download/ und /download/ nicht zwingend identisch. Verwenden Sie exakt die Pfade, die auf der Website ausgeliefert werden, und prüfen Sie Varianten, Weiterleitungen sowie mögliche alternative URL-Schreibweisen.

Die Sitemap falsch oder veraltet angeben

Ein häufiger Fehler ist eine Sitemap-Adresse, die nicht erreichbar ist, auf eine andere Domain zeigt oder nur für eine frühere Website-Version gilt. Eine Sitemap kann am Ende der robots.txt genannt werden:

Sitemap: https://www.beispiel.de/sitemap.xml

Die absolute URL sollte zur tatsächlichen Domain und zum verwendeten Protokoll passen. Bei einer Website mit mehreren Sprachversionen, Subdomains oder getrennten Sitemaps müssen die Einträge bewusst verwaltet werden. Eine robots.txt auf shop.beispiel.de sollte nicht automatisch auf eine Sitemap einer völlig anderen Host-Adresse verweisen, wenn diese nicht die relevanten URLs enthält.

Die Sitemap ersetzt keine gute interne Verlinkung und hebt eine Disallow-Regel nicht auf. Wenn eine URL in der Sitemap steht und gleichzeitig durch die robots.txt blockiert wird, entsteht ein widersprüchliches Signal. Die Sitemap sollte daher nur URLs enthalten, die erreichbar, technisch gültig und für die Indexierung grundsätzlich vorgesehen sind.

Vertrauliche Inhalte nur durch robots.txt schützen

Eine robots.txt ist öffentlich erreichbar. Jeder kann ihre Inhalte abrufen und daraus ableiten, welche Pfade der Betreiber möglicherweise verborgen halten möchte. Außerdem sind Crawler nicht verpflichtet, freiwillige Regeln einzuhalten. Schadsoftware, aggressive Bots oder neugierige Personen können die Datei ignorieren.

Bereiche mit persönlichen Daten, internen Dokumenten, Administrationsfunktionen oder nicht veröffentlichten Projekten gehören deshalb hinter eine Zugriffskontrolle. Entfernen Sie vertrauliche Dateien vom öffentlich erreichbaren Server oder schützen Sie sie mit geeigneten technischen Maßnahmen. Eine Disallow-Regel kann zusätzlich die Crawl-Steuerung verbessern, ist aber keine Sicherheitsbarriere.

Typische Probleme bei WordPress-Websites

Bei WordPress entsteht die robots.txt häufig dynamisch, sofern keine eigene Datei im Webroot angelegt wurde. Zusätzlich können SEO-Plugins oder Hosting-Konfigurationen Regeln beeinflussen. Dadurch ist nicht immer auf den ersten Blick erkennbar, welche Version tatsächlich ausgeliefert wird.

Prüfen Sie zunächst die öffentlich erreichbare Adresse und vergleichen Sie sie mit den Einstellungen in WordPress sowie im verwendeten Plugin. Nach einem Plugin-Wechsel oder einer Änderung der Lesbarkeitseinstellungen kann sich die Ausgabe verändern. Auch Cache-Systeme und Content-Delivery-Netzwerke können eine ältere Version ausliefern. Änderungen sollten daher nach der Veröffentlichung erneut direkt im Browser und möglichst aus verschiedenen Netzwerkperspektiven kontrolliert werden.

Ein weiterer Fehler ist, die robots.txt als Ersatz für die WordPress-Einstellung zur Sichtbarkeit in Suchmaschinen zu betrachten. Diese Einstellung kann zusätzliche technische Signale auslösen, die nicht mit einer einzelnen Zeile in der robots.txt identisch sind. Bei einem Relaunch sollten deshalb die WordPress-Konfiguration, die robots.txt, Meta-Robots-Anweisungen, Canonical-URLs und die XML-Sitemap gemeinsam geprüft werden.

So prüfen Sie eine robots.txt systematisch

1. Die tatsächlich ausgelieferte Datei abrufen

Beginnen Sie mit der URL der produktiven Domain und rufen Sie die Datei direkt auf. Prüfen Sie dabei auch Varianten mit und ohne www, falls beide Hostnamen erreichbar sind. Eine Weiterleitung kann technisch funktionieren, sollte aber bewusst eingerichtet und zur bevorzugten Domain passend sein.

Achten Sie auf Statuscode, Inhalt, Zeichencodierung und ungewöhnliche Fehlermeldungen. Eine HTML-Fehlerseite anstelle einer Textdatei, ein Serverfehler oder eine unerwartete Weiterleitung sind wichtige Hinweise. Die Datei sollte nicht nur im lokalen Editor korrekt aussehen, sondern auch genau so vom Server ausgeliefert werden.

2. Die wichtigsten URL-Gruppen sammeln

Erstellen Sie eine kleine Prüfliste mit repräsentativen URLs: Startseite, wichtige Kategorie- und Produktseiten, redaktionelle Inhalte, Bilder, CSS- und JavaScript-Ressourcen, Suchergebnisse, Filterseiten, Login-Bereiche und bekannte technische Pfade. Nehmen Sie sowohl URLs auf, die erreichbar sein sollen, als auch solche, die bewusst nicht gecrawlt werden sollen.

Diese Auswahl macht sichtbar, ob eine Regel zu breit oder zu schmal greift. Eine robots.txt sollte nicht abstrakt, sondern anhand konkreter URL-Beispiele bewertet werden. Bei großen Websites können Server-Logs, Crawling-Daten und URL-Listen aus dem CMS die Auswahl unterstützen.

3. Regeln mit Suchmaschinen-Tools und Validatoren vergleichen

Nutzen Sie ein aktuelles Prüfwerkzeug, das die robots.txt-Syntax und die Wirkung auf konkrete URLs nachvollziehbar darstellt. Ein Tool ersetzt jedoch nicht die fachliche Prüfung: Nicht jede Suchmaschine unterstützt jede Erweiterung gleich, und ein Tester bildet möglicherweise nur einen bestimmten User-Agent ab.

Vergleichen Sie die Ergebnisse mit den realen Anforderungen der Website. Wenn ein Tool eine URL als erlaubt meldet, bedeutet das nicht automatisch, dass die Seite indexiert wird. Umgekehrt kann eine blockierte URL weiterhin über externe Links bekannt werden. Für eine belastbare Diagnose müssen Crawling, Indexierung und Zugriffsschutz getrennt betrachtet werden.

4. Googlebot, allgemeine Crawler und Sonderfälle auseinanderhalten

Ein Block für User-agent: * richtet sich grundsätzlich an Crawler, die diesen allgemeinen Block berücksichtigen. Ein zusätzlicher spezifischer Block kann für einen bestimmten Crawler gelten. Dadurch entstehen leicht Missverständnisse, wenn eine Regel für einen User-Agent getestet wird, aber ein anderer Crawler sie anders auswertet.

Definieren Sie spezifische Blöcke nur, wenn es dafür einen klaren Grund gibt. Je mehr Ausnahmen und Agenten enthalten sind, desto schwieriger wird die Datei. Dokumentieren Sie die Absicht hinter Sonderregeln und entfernen Sie sie, sobald der ursprüngliche Anwendungsfall nicht mehr besteht.

5. Nach der Änderung erneut kontrollieren

Speichern Sie die Datei in einer kontrollierten Änderung und prüfen Sie anschließend erneut die Live-Version. Kontrollieren Sie nicht nur die geänderte URL, sondern auch wichtige Nachbarpfade. Eine Änderung an /shop/ kann beispielsweise viele Unterbereiche betreffen.

Beobachten Sie danach die Server-Logs und die Berichte der verfügbaren Suchmaschinen-Werkzeuge. Änderungen an Crawling-Signalen wirken nicht immer sofort. Ein kurzfristig unveränderter Bericht beweist daher weder, dass die Änderung wirkungslos ist, noch dass sie vollständig verarbeitet wurde.

Praktische Entscheidungskriterien für Regeln

Vor einer neuen Disallow-Regel sollten Sie fünf Fragen beantworten:

  • Welches konkrete Problem soll gelöst werden? Geht es um Serverlast, URL-Parameter, doppelte Inhalte, interne Suchseiten oder einen nicht öffentlichen Bereich?
  • Welche exakten URLs sind betroffen? Beschreiben Sie einige erlaubte und gesperrte Beispiele, statt nur ein allgemeines Verzeichnis zu nennen.
  • Ist Crawling-Sperrung wirklich das richtige Mittel? Für vertrauliche Inhalte, Indexierungssteuerung oder technische Fehler können andere Maßnahmen passender sein.
  • Welche Nebenwirkungen entstehen? Prüfen Sie Ressourcen, Unterverzeichnisse, Sprachversionen, Weiterleitungen und Links aus Sitemaps.
  • Wer pflegt die Regel später? Eine verständliche, kurze Datei mit dokumentierter Absicht ist sicherer als ein kaum nachvollziehbares Geflecht aus Ausnahmen.

Ein gutes Ergebnis ist nicht die längste oder technisch ausgefeilteste robots.txt, sondern eine Datei, deren Regeln eine klar erkennbare Aufgabe erfüllen. Wenn keine belastbare Begründung für eine Sperre existiert, sollte sie nicht allein aus Gewohnheit übernommen werden.

FAQ

Kann eine fehlerhafte robots.txt das Ranking direkt verschlechtern?

Eine falsche Sperre kann verhindern, dass wichtige Inhalte oder benötigte Ressourcen gecrawlt werden. Dadurch können Suchmaschinen Seiten schlechter verstehen oder neue Inhalte später entdecken. Die robots.txt verändert jedoch nicht als direkte Bewertungszahl die Qualität einer Seite. Die konkrete Auswirkung hängt davon ab, welche URLs betroffen sind und welche anderen Signale vorliegen.

Ist Disallow dasselbe wie Noindex?

Nein. Disallow steuert das Crawling und verhindert den Abruf eines Pfads für den jeweiligen Crawler. Noindex ist ein Signal zur Indexierung und kann nur zuverlässig verarbeitet werden, wenn die Seite oder Ressource abgerufen werden darf. Wer eine URL aus dem Index entfernen möchte, sollte daher nicht ausschließlich auf eine robots.txt-Sperre setzen.

Warum sollte ich CSS- und JavaScript-Dateien nicht pauschal sperren?

Diese Ressourcen können für die Darstellung und das Verständnis einer Seite relevant sein. Wenn ein Crawler sie nicht laden darf, kann seine Einschätzung der ausgelieferten Seite unvollständig sein. Sperren Sie technische Dateien nur dann, wenn ein konkreter Grund besteht, und prüfen Sie vorher, ob sie für wichtige Seiten benötigt werden.

Kann die robots.txt geheime Verzeichnisse verstecken?

Nein. Die Datei ist öffentlich und freiwillige Regeln können ignoriert werden. Außerdem macht eine Disallow-Regel einen Pfad nicht unsichtbar, wenn er beispielsweise verlinkt wird. Vertrauliche Bereiche benötigen Zugriffsschutz oder dürfen gar nicht öffentlich ausgeliefert werden.

Wie oft sollte die robots.txt geprüft werden?

Eine feste allgemeine Frist ist weniger wichtig als anlassbezogene Kontrollen. Prüfen Sie die Datei bei Relaunches, Domainwechseln, Änderungen an CMS oder SEO-Plugins, neuen Verzeichnisstrukturen und größeren Änderungen an Sitemaps. Zusätzlich kann eine regelmäßige technische Überwachung sinnvoll sein, damit unerwartete Änderungen schnell auffallen.

Ist eine leere robots.txt problematisch?

Eine leere Datei enthält keine Sperrregeln und lässt Crawler grundsätzlich auf die erreichbaren Pfade zugreifen. Das ist nicht automatisch falsch. Ob die Konfiguration sinnvoll ist, hängt von der Website ab. Auch bei einer leeren Datei bleiben andere Themen wie Indexierungsregeln, URL-Parameter, interne Suchseiten und Zugriffsschutz relevant.

Was bedeutet ein Sternchen bei User-agent oder Wildcards?

Bei User-agent: * steht das Sternchen für einen allgemeinen User-Agent-Block. In Pfadangaben kann ein Sternchen als Platzhalter für Zeichenfolgen verwendet werden, sofern der jeweilige Crawler diese Syntax unterstützt. Weil Wildcards schnell zu weit greifen, sollten sie immer mit konkreten URLs und einem passenden Testwerkzeug überprüft werden.

Fazit: Die robots.txt bewusst und nachvollziehbar pflegen

Die häufigsten Fehler in der robots.txt entstehen durch pauschale Sperren, veraltete Konfigurationen, unpräzise Wildcards und die Verwechslung von Crawling, Indexierung und Sicherheit. Eine wirksame Prüfung beginnt deshalb mit der tatsächlich ausgelieferten Datei und führt über konkrete URL-Beispiele bis zur Kontrolle von Sitemap, Ressourcen und Website-Umgebung.

Halten Sie Regeln so kurz wie möglich, dokumentieren Sie ungewöhnliche Ausnahmen und testen Sie Änderungen nach jedem wichtigen technischen Eingriff erneut. So wird die robots.txt zu einem nachvollziehbaren Bestandteil der technischen Suchmaschinenoptimierung, statt selbst zur Ursache schwer erkennbarer Crawling-Probleme zu werden.

Warum jede Website eine Sitemap braucht: Der umfassende Ratgeber

Eine Sitemap ist kein sichtbares Gütesiegel und auch kein direkter Garant für bessere Rankings. Dennoch gehört sie für die meisten Websites zu den wichtigsten technischen Grundlagen der Suchmaschinenoptimierung. Sie hilft Suchmaschinen dabei, relevante URLs zu entdecken, die Struktur einer Website besser zu verstehen und Änderungen effizienter zu verarbeiten.

In diesem Ratgeber erfahren Sie, warum jede Website eine Sitemap braucht, welche Sitemap-Arten es gibt, wann sie besonders wichtig ist und wie Sie eine Sitemap sinnvoll erstellen, prüfen und dauerhaft pflegen. Dabei geht es nicht nur um Suchmaschinen: Eine gut geplante Sitemap kann auch die interne Organisation und die technische Qualität eines Webauftritts verbessern.

Was ist eine Sitemap?

Vergleich zwischen XML-Sitemap fu00fcr Suchmaschinen und HTML-Sitemap fu00fcr Besucher
Eine XML-Sitemap unterstützt Suchmaschinen, während eine HTML-Sitemap Menschen Orientierung bietet.

Die Abbildung macht sichtbar, dass beide Sitemap-Arten unterschiedliche Aufgaben erfüllen. Die technische Liste ist nicht als Ersatz für die sichtbare Navigation gedacht.

Eine Sitemap ist eine strukturierte Übersicht wichtiger Seiten, Dateien oder Inhalte einer Website. Im Zusammenhang mit Suchmaschinen ist meist die XML-Sitemap gemeint. Sie wird in einem standardisierten Format bereitgestellt und enthält vor allem URLs, die von Suchmaschinen gefunden und berücksichtigt werden sollen.

Eine XML-Sitemap kann zusätzliche Informationen enthalten, beispielsweise den Zeitpunkt der letzten wesentlichen Änderung. Diese Angaben sind Hinweise, keine Anweisungen. Eine Suchmaschine entscheidet selbst, welche URL sie crawlt, wie häufig sie sie besucht und ob sie in den Suchindex aufgenommen wird.

Daneben gibt es die HTML-Sitemap. Sie richtet sich hauptsächlich an Besucherinnen und Besucher und stellt wichtige Bereiche einer Website als übersichtliche Linkliste dar. Bei kleinen Websites ist eine HTML-Sitemap nicht immer erforderlich, bei umfangreichen oder komplex strukturierten Angeboten kann sie jedoch die Orientierung erleichtern.

Wichtig ist die Unterscheidung zwischen einer Sitemap und der Navigation. Die Navigation dient der täglichen Nutzung durch Menschen. Die XML-Sitemap dient vor allem dazu, Suchmaschinen und anderen technischen Systemen eine zusätzliche, strukturierte Orientierung zu geben. Sie ersetzt weder eine logische Menüführung noch eine gute interne Verlinkung.

Warum jede Website eine Sitemap braucht

Die zentrale Aufgabe einer Sitemap besteht darin, wichtige URLs auffindbar zu machen. Suchmaschinen folgen zwar Links und entdecken dadurch viele Inhalte, doch dieser Prozess ist nicht bei jeder Website gleich zuverlässig. Neue, tief verschachtelte, selten verlinkte oder technisch schwer erreichbare Seiten können leichter übersehen werden.

Neue Inhalte schneller auffindbar machen

Wenn ein Blogartikel, eine Produktseite oder ein wichtiger Ratgeber veröffentlicht wird, muss eine Suchmaschine zunächst von dieser URL erfahren. Eine automatisch aktualisierte Sitemap kann die neue Seite als Teil des vorhandenen Inhaltsbestands sichtbar machen. Das bedeutet nicht, dass die URL sofort gecrawlt oder indexiert wird. Die Entdeckung wird jedoch grundsätzlich erleichtert.

Besonders nützlich ist das bei Websites, auf denen regelmäßig neue Inhalte entstehen. Dazu zählen Nachrichtenportale, Onlineshops, Wissensdatenbanken, Veranstaltungsseiten und große Unternehmenswebsites. Auch eine kleine Website profitiert davon, wenn zentrale neue Seiten nicht lange nur über wenige interne Links erreichbar sind.

Große Websites besser strukturieren

Bei mehreren Hundert oder Tausenden von URLs wird die technische Kontrolle anspruchsvoller. Eine Sitemap kann dabei helfen, den vorgesehenen Inhaltsbestand von zufälligen oder unwichtigen URLs zu trennen. So lässt sich leichter prüfen, ob wichtige Bereiche enthalten sind und ob sich unerwartete URLs eingeschlichen haben.

Eine Sitemap ist deshalb auch ein Kontrollinstrument für Betreiber. Wer regelmäßig überprüft, welche URLs darin stehen, erkennt häufig technische Probleme: versehentlich veröffentlichte Testseiten, veraltete Produktadressen, fehlerhafte Weiterleitungen oder Seiten, die trotz ihrer Bedeutung nicht erfasst werden.

Websites mit schwacher interner Verlinkung unterstützen

Eine Sitemap kann fehlende interne Links nicht reparieren. Sie kann aber als zusätzliche Entdeckungshilfe dienen, wenn bestimmte Seiten nur wenige eingehende Links besitzen. Das betrifft beispielsweise Landingpages aus Kampagnen, Archive, Filterkombinationen oder spezielle Informationsseiten.

Die richtige Schlussfolgerung lautet daher nicht: „Mit einer Sitemap sind interne Links überflüssig.“ Besser ist: „Die Sitemap ergänzt eine starke interne Verlinkung.“ Wichtige Inhalte sollten weiterhin von passenden, gut erreichbaren Seiten aus verlinkt werden.

Technische Änderungen transparenter machen

Bei Migrationen, Relaunches oder umfangreichen Überarbeitungen ist eine Sitemap besonders hilfreich. Sie kann nach dem Umzug die neue URL-Struktur abbilden und als Grundlage für Kontrollen dienen. Gemeinsam mit Weiterleitungen, einer aktuellen internen Verlinkung und einer technischen Prüfung entsteht ein belastbareres Bild der Website.

Auch nach größeren Änderungen sollte geprüft werden, ob nur die gewünschten URLs in der Sitemap stehen. Eine veraltete Sitemap mit alten Adressen kann die technische Auswertung erschweren und unnötige Signale senden.

XML-Sitemap, HTML-Sitemap und Bild-Sitemap im Vergleich

Sitemap-Art Hauptzweck Typische Zielgruppe Besonderheit
XML-Sitemap Wichtige URLs strukturiert mitteilen Suchmaschinen und technische Systeme Für SEO und Crawling besonders relevant
HTML-Sitemap Inhalte als übersichtliche Linkliste zeigen Besucherinnen und Besucher Kann Orientierung und interne Verlinkung verbessern
Bild-Sitemap Relevante Bilder zusätzlich beschreiben Bildersuchsysteme Vor allem bei bildorientierten Websites interessant
Video-Sitemap Videoinhalte strukturiert kennzeichnen Suchmaschinen Für umfangreiche Videobibliotheken sinnvoll

Die meisten Websites benötigen zunächst eine gepflegte XML-Sitemap. Bild- oder Video-Sitemaps sind keine Pflicht für jedes Projekt. Sie können sich lohnen, wenn Bilder oder Videos einen wesentlichen Teil des Angebots ausmachen und technisch relevante Zusatzinformationen vorhanden sind.

Welche URLs gehören in eine Sitemap?

In eine XML-Sitemap gehören grundsätzlich die kanonischen, öffentlich erreichbaren URLs, die für Nutzerinnen und Nutzer einen eigenständigen Wert haben. Dazu zählen beispielsweise Startseiten, wichtige Leistungsseiten, Ratgeber, redaktionelle Beiträge, Produktseiten und relevante Kategorieseiten.

Nicht jede technisch erreichbare URL sollte aufgenommen werden. Eine Sitemap ist keine vollständige Liste aller Adressen, die ein Server ausliefern kann. Sie sollte vielmehr den gewünschten, qualitativ relevanten Bestand der Website abbilden.

Geeignete URLs

  • Seiten mit einem erfolgreichen Serverstatus, normalerweise einer erreichbaren HTML-Antwort.
  • Indexierbare Inhalte, die nicht ausdrücklich von Suchmaschinen ausgeschlossen werden.
  • Kanonische URLs, auf die keine andere Adresse als bevorzugte Version verweist.
  • Inhalte, die für die Zielgruppe nützlich und dauerhaft relevant sind.
  • Neue oder wesentlich aktualisierte Seiten, sofern sie weiterhin veröffentlicht bleiben sollen.

Ungeeignete URLs

  • Seiten mit einer Weiterleitung oder einem Fehlerstatus.
  • URLs mit einem Ausschluss durch Robots-Meta-Angaben oder andere technische Vorgaben.
  • Doppelte Inhalte, alternative Parameter-Varianten und interne Suchergebnisse.
  • Warenkorb-, Kassen-, Login- oder persönliche Kontoseiten.
  • Temporäre Testseiten, Vorschauen und nicht fertige Entwürfe.
  • Seiten, die zwar technisch existieren, aber keinen eigenständigen Nutzen bieten.

Eine wichtige Qualitätsprüfung lautet: Würde diese URL auch dann für Suchmaschinen relevant sein, wenn sie über einen normalen Link entdeckt wird? Wenn die Antwort klar nein lautet, gehört sie meist nicht in die Sitemap.

Wie wird eine Sitemap erstellt?

Der beste Weg hängt vom verwendeten System und vom Umfang der Website ab. Viele Content-Management-Systeme erzeugen automatisch eine Sitemap. Häufig ist sie unter einer Adresse wie /sitemap.xml erreichbar. Bei größeren Websites kann das System mehrere Sitemap-Dateien erstellen und über eine Sitemap-Indexdatei miteinander verbinden.

Bei einer manuellen Erstellung werden die gewünschten URLs in einem gültigen XML-Format hinterlegt. Das ist für kleine, selten veränderte Websites möglich, erfordert aber regelmäßige Pflege. Schon eine einzelne veraltete oder falsch formatierte Adresse kann die Qualität der Datei beeinträchtigen.

Bei dynamischen Websites ist eine automatische Generierung meist sinnvoller. Sie sollte jedoch nicht blind aktiviert werden. Manche Erweiterungen nehmen standardmäßig Archive, Parameterseiten oder andere URL-Typen auf, die nicht zum gewünschten Index gehören. Die Einstellungen sollten deshalb nach der Einrichtung kontrolliert werden.

Worauf sollte das XML-Format achten?

Eine XML-Sitemap muss technisch gültig sein und die vorgesehenen Elemente korrekt verwenden. URLs sollten vollständig angegeben werden und die tatsächliche bevorzugte Version der Adresse darstellen. Einheitlichkeit ist wichtig: Werden beispielsweise sichere und unsichere Protokollvarianten oder verschiedene Hostnamen vermischt, entsteht unnötige Unklarheit.

Das Änderungsdatum sollte nur dann aktualisiert werden, wenn sich der Inhalt tatsächlich wesentlich verändert hat. Ein tägliches Aktualisieren aller URLs ohne inhaltlichen Grund liefert keinen verlässlichen Hinweis. Auch die optionale Angabe einer Priorität sollte nicht als direkte Rankingsteuerung missverstanden werden.

Sitemap bei Suchmaschinen einreichen

Eine Sitemap kann über die robots.txt referenziert werden. Dort wird die vollständige URL der Datei angegeben. Zusätzlich kann sie in den jeweiligen Bereichen für Website-Verwaltung und Suchanalyse eingereicht werden. Das erleichtert die Zuordnung zur richtigen Website und stellt häufig nützliche Statusinformationen bereit.

Das Einreichen bedeutet nicht, dass jede enthaltene Seite indexiert wird. Es teilt vielmehr mit, welche URLs der Betreiber als relevant betrachtet. Suchmaschinen vergleichen diese Angaben mit ihren eigenen Erkenntnissen, etwa mit gefundenen Links, Statuscodes, Weiterleitungen und Qualitätsmerkmalen.

Nach einer Einreichung sollten Betreiber auf Warnungen und Fehler achten. Ein einzelner Fehler in einer Datei ist nicht automatisch ein schweres Problem. Wiederkehrende Abweichungen zwischen Sitemap und tatsächlichem Websitezustand deuten jedoch auf Pflege- oder Konfigurationsbedarf hin.

Sitemap und Crawling: Was sie leisten kann und was nicht

Eine Sitemap verbessert die Möglichkeit, URLs zu entdecken. Sie garantiert weder Crawling noch Indexierung und schon gar nicht eine bestimmte Position in den Suchergebnissen. Suchmaschinen bewerten unter anderem die Zugänglichkeit, den Inhalt, die interne Verlinkung, technische Signale und die erwartete Bedeutung einer Seite.

Auch die Crawling-Belastung wird durch eine Sitemap nicht automatisch gelöst. Wenn eine Website sehr viele minderwertige oder doppelte URLs enthält, sollte das Problem an der URL-Struktur gelöst werden. Eine Sitemap, die lediglich alle vorhandenen Adressen auflistet, kann die Übersicht sogar verschlechtern.

Für eine gute technische Grundlage sollten deshalb mehrere Elemente zusammenpassen:

  • eine klare Informationsarchitektur,
  • relevante interne Links,
  • korrekte Statuscodes und Weiterleitungen,
  • eine konsistente Canonical-Konfiguration,
  • eine sinnvolle Steuerung von indexierbaren und nicht indexierbaren Bereichen,
  • eine aktuelle, fehlerarme Sitemap.

Die Sitemap ist damit ein wichtiges Puzzleteil, aber kein Ersatz für eine insgesamt saubere Website.

Besondere Fälle: kleine Websites, Onlineshops und Relaunches

Kleine Unternehmenswebsite

Bei einer kleinen Website mit wenigen, gut verlinkten Seiten ist eine Sitemap nicht immer zwingend erforderlich. Trotzdem ist sie meist mit geringem Aufwand verfügbar und schafft eine zusätzliche technische Absicherung. Gerade bei Änderungen oder einem späteren Ausbau kann sie wertvoll sein.

Blog oder redaktionelles Portal

Regelmäßig wachsende Websites profitieren besonders von einer automatisch gepflegten Sitemap. Neue Beiträge, Kategorien und Aktualisierungen sollten nach einer passenden Strategie berücksichtigt werden. Alte Inhalte sollten nicht automatisch entfernt werden, wenn sie weiterhin nützlich und erreichbar sind.

Onlineshop

Shops müssen besonders sorgfältig zwischen wertvollen Produktseiten und wenig hilfreichen URL-Varianten unterscheiden. Filter, Sortierungen, Suchergebnisse und Sitzungsparameter können eine große Zahl ähnlicher Adressen erzeugen. In die Sitemap gehören in der Regel die gewünschten, kanonischen Produkt- und Kategorieseiten, nicht jede Filterkombination.

Website-Relaunch

Vor einem Relaunch sollte bekannt sein, welche URLs künftig bestehen bleiben, geändert oder entfernt werden. Nach dem Start muss die Sitemap die neue Struktur abbilden. Alte Adressen gehören nicht einfach weiter in die neue Datei, sondern sollten passend weitergeleitet oder bewusst mit einem geeigneten Status beendet werden.

Sitemap regelmäßig prüfen und pflegen

Eine Sitemap ist nur dann dauerhaft nützlich, wenn sie dem tatsächlichen Websitezustand entspricht. Für kleine Websites genügt oft eine Prüfung nach größeren Änderungen. Bei Shops, Portalen und stark wachsenden Projekten sollte die Kontrolle in einen festen technischen Prozess integriert werden.

Eine praktische Prüfung kann folgende Fragen enthalten:

  • Sind alle enthaltenen URLs erreichbar?
  • Gibt es Weiterleitungen oder Fehlerseiten in der Datei?
  • Stimmen Protokoll, Domain und bevorzugte URL-Version?
  • Sind ausgeschlossene oder nicht öffentliche Bereiche enthalten?
  • Fehlen wichtige neue Seiten?
  • Entsprechen Änderungsdaten den tatsächlichen inhaltlichen Änderungen?
  • Wird die Sitemap nach einem Relaunch automatisch oder manuell aktualisiert?

Zusätzlich lohnt sich ein Vergleich zwischen Sitemap, intern verlinkten Seiten und den Berichten der Suchmaschinenverwaltung. Abweichungen sind nicht immer Fehler, liefern aber Hinweise für eine genauere Untersuchung.

Häufige Fehler bei Sitemaps

Zu den häufigsten Problemen gehört eine Sitemap, die zu viele URLs enthält. Je größer die Datei, desto wichtiger ist die Auswahl. Ebenso problematisch sind URLs, die auf Weiterleitungen zeigen, nicht erreichbar sind oder durch widersprüchliche technische Angaben ausgeschlossen werden.

Ein weiterer Fehler ist die Annahme, dass die Sitemap Rankings erzwingt. Sie kann die Entdeckung unterstützen, aber keinen schwachen Inhalt, eine schlechte Nutzerführung oder technische Barrieren ausgleichen. Auch eine veraltete Sitemap nach einem Domainwechsel oder Relaunch kann zu unnötigen Unklarheiten führen.

Manche Betreiber erstellen außerdem eine Sitemap, reichen sie einmal ein und vergessen sie danach. Sinnvoller ist ein Prozess, bei dem die Datei automatisch gepflegt und in regelmäßigen Abständen stichprobenartig kontrolliert wird.

FAQ

Ist eine Sitemap für jede Website verpflichtend?

Nein. Eine Sitemap ist normalerweise keine allgemeine Pflicht. Für die meisten Websites ist sie dennoch empfehlenswert, weil sie die Entdeckung wichtiger URLs erleichtert und eine zusätzliche Kontrolle über den veröffentlichten Inhaltsbestand ermöglicht.

Verbessert eine Sitemap automatisch das Ranking?

Nein. Eine Sitemap ist kein direkter Rankingfaktor im Sinne einer garantierten Verbesserung. Sie kann Suchmaschinen helfen, relevante Inhalte zu finden. Ob eine Seite indexiert wird und wie sie bewertet wird, hängt von vielen weiteren technischen und inhaltlichen Signalen ab.

Reicht eine Sitemap allein für gute SEO aus?

Nein. Sie ergänzt unter anderem interne Verlinkung, eine klare Seitenstruktur, gute Inhalte, korrekte Statuscodes und eine sinnvolle Indexierungssteuerung. Eine Sitemap kann grundlegende Probleme nicht ersetzen oder verdecken.

Wie oft sollte eine Sitemap aktualisiert werden?

Sie sollte aktualisiert werden, sobald sich der gewünschte Bestand wichtiger URLs ändert. Bei dynamischen Websites geschieht das idealerweise automatisch. Das Änderungsdatum einzelner URLs sollte trotzdem nur bei wesentlichen Änderungen angepasst werden.

Kann eine Sitemap zu viele URLs enthalten?

Ja. Eine Sitemap sollte nicht jede technisch erzeugbare Adresse enthalten. Doppelte, unwichtige, private, weitergeleitete oder ausgeschlossene URLs gehören normalerweise nicht hinein. Eine kleinere, sorgfältig ausgewählte Datei ist hilfreicher als eine vollständige Liste aller Varianten.

Braucht eine kleine Website zusätzlich eine HTML-Sitemap?

Nicht unbedingt. Wenn die Navigation übersichtlich ist und alle wichtigen Seiten gut erreichbar sind, kann eine HTML-Sitemap entbehrlich sein. Bei vielen Unterseiten, älteren Inhalten oder einer komplexen Struktur kann sie Besucherinnen und Besuchern dennoch zusätzliche Orientierung geben.

Was passiert, wenn die Sitemap fehlerhafte URLs enthält?

Einzelne Fehler führen nicht automatisch zu einem großen Problem. Häufen sich jedoch falsche URLs, kann die Datei ihre Funktion als verlässliche Übersicht verlieren. Die fehlerhaften Adressen sollten geprüft und entfernt oder korrigiert werden. Wichtig ist außerdem, die Ursache in der automatischen Generierung zu beheben.

Fazit: Eine Sitemap schafft technische Klarheit

Warum jede Website eine Sitemap braucht, lässt sich vor allem mit drei Punkten beantworten: Sie unterstützt die Entdeckung wichtiger URLs, schafft Transparenz über den gewünschten Inhaltsbestand und erleichtert die Kontrolle bei Wachstum oder technischen Änderungen. Besonders große, regelmäßig aktualisierte oder komplex strukturierte Websites profitieren davon.

Eine gute Sitemap ist nicht möglichst umfangreich, sondern möglichst präzise. Sie enthält indexierbare, kanonische und wertvolle URLs, wird automatisch oder zuverlässig aktualisiert und regelmäßig auf Fehler geprüft. Zusammen mit einer verständlichen Navigation, einer starken internen Verlinkung und technisch sauberen Seiten bildet sie eine solide Grundlage für eine gut auffindbare Website.

Sitemap.xml prüfen und optimieren: Der umfassende Ratgeber für bessere Crawlbarkeit

Eine gut gepflegte sitemap.xml hilft Suchmaschinen dabei, wichtige URLs einer Website effizient zu entdecken und regelmäßig zu crawlen. Sie ersetzt weder eine klare interne Verlinkung noch hochwertige Inhalte, kann aber besonders bei großen, neuen oder häufig veränderten Websites wertvolle Orientierung geben. In diesem Ratgeber erfahren Sie, wie Sie Ihre Sitemap.xml prüfen, typische Fehler erkennen und die Datei dauerhaft sinnvoll optimieren.

Was ist eine Sitemap.xml und welche Aufgabe hat sie?

Eine XML-Sitemap ist eine maschinenlesbare Datei, in der die indexierbaren URLs einer Website aufgelistet werden. Sie liegt häufig unter einer Adresse wie https://www.beispiel.de/sitemap.xml oder verweist als Sitemap-Index auf mehrere einzelne Sitemaps. Suchmaschinen können diese URLs abrufen und mit den Informationen aus der Sitemap abgleichen.

Wichtig ist die richtige Einordnung: Eine Sitemap ist keine Liste von Seiten, die automatisch indexiert werden. Sie ist vielmehr ein Hinweis an Suchmaschinen, welche URLs Sie für relevant halten. Ob eine Seite tatsächlich gecrawlt und in den Suchindex aufgenommen wird, hängt zusätzlich von Faktoren wie Inhalt, interner Verlinkung, Zugriffsmöglichkeit, Canonical-Angabe und technischen Signalen ab.

Für kleine Websites mit wenigen, gut verlinkten Seiten ist eine Sitemap nicht immer entscheidend. Dennoch gehört sie heute meist zur technischen Grundausstattung. Besonders nützlich ist sie in folgenden Situationen:

  • Die Website enthält viele Seiten oder wird regelmäßig erweitert.
  • Neue Inhalte sind nur über wenige interne Links erreichbar.
  • Es gibt Archive, Filterseiten oder andere große URL-Strukturen, die sorgfältig gesteuert werden müssen.
  • Die Website enthält Bilder, Videos oder Nachrichteninhalte mit speziellen Anforderungen.
  • Die interne Verlinkung ist noch nicht vollständig ausgebaut.
  • Nach einem Relaunch sollen wichtige URLs schneller erkannt werden.

Sitemap.xml prüfen: Die wichtigsten Kontrollen im Überblick

Infografik mit den wichtigsten Pru00fcfschritten fu00fcr eine Sitemap.xml
Diese Übersicht zeigt die zentralen Prüfschritte einer Sitemap-Kontrolle.

Achten Sie in der Grafik auf die Verbindung zwischen technischer Erreichbarkeit und der Qualität der enthaltenen URLs. Eine Sitemap ist erst dann hilfreich, wenn sie sowohl gültig ausgeliefert wird als auch relevante, indexierbare Seiten enthält.

Beim Prüfen der Sitemap geht es nicht nur darum, ob die Datei technisch erreichbar ist. Entscheidend ist, ob sie konsistente und tatsächlich wertvolle URLs enthält. Eine kurze, saubere Sitemap ist in der Regel nützlicher als eine sehr große Datei mit zahlreichen Weiterleitungen, Fehlerseiten oder irrelevanten Parametervarianten.

Prüfbereich Worauf Sie achten sollten Typische Maßnahme
Erreichbarkeit Die Datei liefert eine erfolgreiche HTTP-Antwort und ist öffentlich abrufbar. Server, URL und Zugriffsregeln kontrollieren.
Format Die XML-Struktur ist gültig und sauber codiert. XML-Validator oder Suchmaschinen-Tool verwenden.
URL-Auswahl Nur kanonische, indexierbare und relevante URLs sind enthalten. Weiterleitungen, Fehlerseiten und Ausschlussseiten entfernen.
Aktualität Neue, geänderte oder entfernte Inhalte werden korrekt berücksichtigt. Generierung und Aktualisierungslogik prüfen.
Abdeckung Wichtige Seitentypen werden vollständig erfasst. Stichproben mit Website-Struktur und Indexbericht vergleichen.
Technische Grenzen Datei- und URL-Grenzen werden eingehalten. Sitemap-Index für größere Websites einsetzen.

Erreichbarkeit und Statuscode kontrollieren

Rufen Sie die Sitemap direkt im Browser oder über ein technisches Prüfwerkzeug auf. Sie sollte ohne Anmeldung, Cookie-Abfrage oder JavaScript-Ausführung erreichbar sein. Prüfen Sie außerdem, ob die Datei den erwarteten Inhalt ausliefert und nicht versehentlich auf eine HTML-Fehlerseite, eine Startseite oder eine veraltete Domain weiterleitet.

Ein erfolgreicher Statuscode allein reicht nicht immer aus. Manche Server liefern bei nicht vorhandenen Dateien eine eigene Fehlerseite mit einem technisch erfolgreichen Statuscode aus. Deshalb sollte auch der Inhalt überprüft werden: Beginnt die Datei mit einer gültigen XML-Struktur und enthält sie die erwarteten Sitemap-Elemente?

XML-Syntax und Zeichencodierung prüfen

Eine Sitemap muss syntaktisch korrekt sein. Achten Sie unter anderem auf korrekt geschlossene Elemente, gültige URLs und eine passende Zeichencodierung. Sonderzeichen in URLs müssen korrekt behandelt werden. Auch unzulässige Steuerzeichen oder fehlerhafte Einträge können dazu führen, dass Teile der Datei nicht verarbeitet werden.

Die grundlegende Struktur einer URL-Sitemap sieht beispielsweise so aus:

<?xml version="1.0" encoding="UTF-8"?>
<urlset xmlns="http://www.sitemaps.org/schemas/sitemap/0.9">
  <url>
    <loc>https://www.beispiel.de/wichtige-seite/</loc>
  </url>
</urlset>

Die Beispielstruktur ist bewusst einfach gehalten. Zusätzliche Elemente wie lastmod können sinnvoll sein, wenn der angegebene Änderungszeitpunkt zuverlässig gepflegt wird.

Welche URLs gehören in eine Sitemap?

Die zentrale Entscheidungsfrage lautet: Würde die Website diese URL einem Suchmaschinen-Crawler und einem potenziellen Besucher als eigenständige, wertvolle Seite empfehlen? Wenn die Antwort eindeutig Nein lautet, gehört die URL meist nicht in die Sitemap.

In der Regel sollten enthalten sein:

  • kanonische URLs mit dem bevorzugten Protokoll und Hostnamen,
  • öffentlich erreichbare Seiten mit relevantem, eigenständigem Inhalt,
  • indexierbare Kategorien, Produkte, Dienstleistungen oder Ratgeberseiten,
  • wichtige Seiten, die dauerhaft Bestandteil der Website bleiben,
  • aktualisierte URLs, wenn deren Inhalt tatsächlich überarbeitet wurde.

Eine URL sollte möglichst gleichzeitig mehrere Bedingungen erfüllen: Sie ist mit dem HTTP-Statuscode 200 erreichbar, nicht durch noindex ausgeschlossen, nicht per robots.txt blockiert und verweist über das Canonical-Element auf sich selbst oder wird von der Website als kanonische Variante behandelt.

Welche URLs sollten ausgeschlossen werden?

Häufige Kandidaten für den Ausschluss sind:

  • Weiterleitungsziele, wenn die alte URL selbst noch in der Sitemap steht,
  • 404- und 410-Seiten,
  • URLs mit noindex,
  • interne Suchergebnisse, Warenkörbe und Konto-Seiten,
  • Session-IDs und unnötige Tracking-Parameter,
  • technische Varianten mit falschem Protokoll oder falschem Hostnamen,
  • doppelte Inhalte ohne eigenständigen Suchwert,
  • unvollständige oder vorläufige Seiten.

Ein häufiger Fehler ist die automatische Aufnahme jeder URL, die ein Content-Management-System erzeugt. Dazu können beispielsweise Autorenarchive, Schlagwortseiten, Druckversionen, facettierte Filter oder paginierte Varianten gehören. Diese URL-Typen müssen nicht grundsätzlich ausgeschlossen werden. Entscheidend ist, ob sie einen eigenständigen Nutzen haben und bewusst indexiert werden sollen.

Die Sitemap.xml sinnvoll optimieren

Die Optimierung beginnt mit einer klaren Trennung zwischen wichtigen Inhalts-URLs und technischen Nebenprodukten. Ziel ist kein möglichst umfangreiches Verzeichnis, sondern ein verlässliches Signal über die Seiten, die Suchmaschinen tatsächlich berücksichtigen sollen.

Nur kanonische URLs verwenden

Wenn eine Seite unter mehreren Varianten erreichbar ist, sollte nur die bevorzugte Version in der Sitemap stehen. Typische Varianten entstehen durch HTTP und HTTPS, verschiedene Hostnamen, Groß- und Kleinschreibung, abschließende Schrägstriche oder Parameter. Legen Sie eine konsistente URL-Struktur fest und verwenden Sie sie überall: in der Sitemap, in Canonical-Tags, in internen Links und möglichst auch in Weiterleitungen.

Die Sitemap darf nicht als Ort dienen, an dem Suchmaschinen zwischen mehreren konkurrierenden URL-Varianten wählen müssen. Je klarer das Signal, desto leichter lässt sich die technische Struktur prüfen.

Das Änderungsdatum vorsichtig einsetzen

Das Element lastmod beschreibt, wann sich der Inhalt einer URL zuletzt wesentlich geändert hat. Es sollte nicht bei jedem automatischen Seitenaufruf oder jeder kleinen Systemänderung aktualisiert werden. Ein ständig wechselndes Datum ohne relevante Inhaltsänderung verliert an Aussagekraft.

Verwenden Sie lastmod vor allem dann, wenn die Daten zuverlässig aus dem Redaktionssystem stammen. Eine echte Überarbeitung eines Ratgebers, eine Änderung zentraler Produktinformationen oder eine wichtige Aktualisierung eines Leistungsangebots sind plausible Anlässe. Das Datum sollte sich auf den Inhalt beziehen, nicht lediglich auf das technische Erstellungsdatum einer neuen Sitemap-Datei.

Priorität und Änderungsfrequenz nicht überschätzen

Ältere Sitemap-Felder wie eine allgemeine Priorität oder eine Änderungsfrequenz werden von modernen Suchmaschinen nicht als verbindliche Steuerung verstanden. Sie ersetzen keine gute Informationsarchitektur und garantieren keinen häufigeren Crawl. Konzentrieren Sie sich daher auf korrekte URLs, verlässliche Änderungsdaten und eine sinnvolle Auswahl.

Sitemap-Index für umfangreiche Websites einsetzen

Große Websites können mehrere thematische oder technische Sitemaps verwenden, etwa getrennt nach Produkten, Ratgebern, Kategorien oder Sprachen. Ein Sitemap-Index bündelt diese Dateien. Das erleichtert die Wartung und ermöglicht eine gezielte Fehleranalyse.

Achten Sie auf eine verständliche Benennung. Eine Aufteilung nach Seitentypen kann sinnvoller sein als eine rein zufällige Aufteilung nach Dateigröße. Wenn bei einem Relaunch nur die Produkt-Sitemap fehlerhaft ist, lässt sich das Problem schneller eingrenzen, wenn die Struktur klar erkennbar ist.

Sitemap.xml und robots.txt richtig verbinden

Die robots.txt-Datei und die Sitemap erfüllen unterschiedliche Aufgaben. Die robots.txt kann das Crawling bestimmter Bereiche einschränken. Die Sitemap listet URLs auf, die als relevant und zugänglich betrachtet werden. Sie sollten deshalb keine URL in der Sitemap angeben, deren Abruf Sie gleichzeitig über robots.txt verhindern.

Ein Verweis in der robots.txt kann die Auffindbarkeit der Sitemap verbessern. Er kann beispielsweise auf die vollständige absolute URL der Sitemap oder des Sitemap-Index zeigen. Prüfen Sie dabei, dass der Hostname und das Protokoll genau zur Website passen.

Beachten Sie außerdem: Eine robots.txt-Sperre ist kein verlässlicher Ersatz für noindex, wenn eine URL aus dem Suchindex entfernt werden soll. Ist eine Seite bereits bekannt, kann eine reine Crawling-Sperre verhindern, dass Suchmaschinen das gewünschte Ausschlusssignal abrufen. Technische Maßnahmen sollten daher nach dem konkreten Ziel ausgewählt werden.

Sitemap in Suchmaschinen-Tools einreichen und überwachen

Reichen Sie die Sitemap beziehungsweise den Sitemap-Index in den passenden Verwaltungsoberflächen der Suchmaschinen ein. Das ist meist nur ein Hinweis und keine Garantie für Crawling oder Indexierung. Der Vorteil liegt vor allem in der Überwachung: Sie können erkennen, ob die Datei abgerufen wurde, ob Fehler gemeldet werden und wie sich bekannte URLs im Verhältnis zu den tatsächlich indexierten Seiten entwickeln.

Vergleichen Sie die Sitemap nicht unkritisch mit jeder URL, die in einem Indexbericht auftaucht. Suchmaschinen können URLs entdecken, die nicht in Ihrer Sitemap stehen, beispielsweise über interne oder externe Links. Umgekehrt kann eine URL in der Sitemap stehen, ohne indexiert zu werden. Diese Abweichung ist ein Anlass zur Analyse, aber nicht automatisch ein technischer Fehler.

Für eine belastbare Prüfung kombinieren Sie mehrere Perspektiven:

  • Sitemap-Inhalt und Sitemap-Fehlermeldungen,
  • Crawling- und Indexierungsberichte,
  • Server-Logs oder Crawling-Daten, sofern verfügbar,
  • interne Verlinkung und Website-Struktur,
  • Stichproben bei wichtigen Seitentypen,
  • Weiterleitungen, Canonical-Tags und Statuscodes.

Typische Fehler beim Prüfen und Optimieren

Die Sitemap enthält jede automatisch erzeugte URL

Eine automatische Generierung ist bequem, aber nicht automatisch sinnvoll. Prüfen Sie die Regeln des eingesetzten Systems. Manche Erweiterungen nehmen standardmäßig Archive, Filter oder Medienseiten auf, obwohl diese für die organische Suche keine eigenständige Rolle spielen sollen.

Die Datei ist aktuell, aber inhaltlich unzuverlässig

Eine täglich neu geschriebene Sitemap ist nicht automatisch besser. Wenn entfernte Seiten, alte Weiterleitungen oder falsche Änderungsdaten enthalten bleiben, entsteht ein dauerhaftes Qualitätsproblem. Entscheidend ist die Logik hinter der Generierung: Wird vor der Ausgabe geprüft, ob eine URL indexierbar, erreichbar und kanonisch ist?

Wichtige Seiten fehlen trotz vorhandener Sitemap

Manchmal wird nur die Startseite oder nur eine bestimmte Kategorie erfasst. Prüfen Sie deshalb nicht nur die Datei selbst, sondern auch die Seitentypen, die das System einbezieht. Ein Vergleich mit der XML-Struktur, der Navigation und einer repräsentativen URL-Liste zeigt häufig, ob Produkte, Beiträge, Landingpages oder regionale Seiten fehlen.

Sitemap und interne Links werden verwechselt

Eine URL in der Sitemap ist kein Ersatz für eine gute interne Verlinkung. Wichtige Seiten sollten über nachvollziehbare Menüs, Kategorien, kontextbezogene Links oder thematische Übersichten erreichbar sein. Die Sitemap kann die Entdeckung unterstützen, vermittelt aber nicht automatisch die inhaltliche Bedeutung einer Seite.

Nach dem Relaunch bleiben alte URLs enthalten

Bei Domainwechseln, Strukturänderungen und Migrationen sollte die Sitemap Bestandteil der Abnahmekontrolle sein. Entfernen Sie alte URLs, die dauerhaft weiterleiten oder nicht mehr existieren, und stellen Sie sicher, dass die neue Sitemap nur die aktuelle Zielstruktur enthält. Prüfen Sie außerdem, ob Verweise in der robots.txt und in Suchmaschinen-Tools aktualisiert wurden.

Praktische Checkliste für die regelmäßige Kontrolle

Eine wiederkehrende Prüfung muss nicht kompliziert sein. Die folgende Checkliste eignet sich als monatlicher oder anlassbezogener Ablauf:

  1. Öffnen Sie die Sitemap oder den Sitemap-Index direkt und kontrollieren Sie die Erreichbarkeit.
  2. Prüfen Sie die XML-Syntax und achten Sie auf Fehlermeldungen.
  3. Überprüfen Sie stichprobenartig wichtige URLs auf Statuscode, Canonical und Indexierbarkeit.
  4. Suchen Sie nach Weiterleitungen, Fehlerseiten, gesperrten URLs und noindex-Seiten.
  5. Vergleichen Sie die Sitemap mit den wichtigsten Seitentypen der Website.
  6. Kontrollieren Sie, ob neue Inhalte erscheinen und entfernte Inhalte verschwinden.
  7. Bewerten Sie die Aussagekraft der Änderungsdaten.
  8. Prüfen Sie Sitemap-Index, robots.txt und Einreichungen in den Suchmaschinen-Tools.
  9. Dokumentieren Sie größere Änderungen, etwa nach einem Relaunch oder einer CMS-Umstellung.

Für Websites mit vielen Veröffentlichungen, häufigen Produktänderungen oder mehreren Sprachversionen kann eine automatisierte Überwachung sinnvoll sein. Lassen Sie dabei nicht nur die Verfügbarkeit, sondern auch Stichproben der URL-Qualität und auffällige Mengenänderungen prüfen.

FAQ

Wie oft sollte man eine Sitemap.xml prüfen?

Für eine stabile kleine Website genügt meist eine regelmäßige Kontrolle in größeren Abständen sowie eine Prüfung nach wichtigen technischen Änderungen. Bei häufig aktualisierten oder großen Websites ist eine laufende beziehungsweise monatliche Überwachung sinnvoll. Nach einem Relaunch, einer Migration oder einer Änderung des CMS sollte die Sitemap sofort kontrolliert werden.

Garantiert eine Sitemap die Indexierung aller enthaltenen URLs?

Nein. Eine Sitemap ist ein Hinweis auf bevorzugte URLs, aber keine Indexierungsgarantie. Suchmaschinen bewerten zusätzlich Qualität, Einzigartigkeit, interne Verlinkung, technische Erreichbarkeit und weitere Signale. Wenn viele URLs aus der Sitemap nicht indexiert werden, sollten Sie die Auswahl und den Nutzen dieser Seiten prüfen.

Sollten Seiten mit „noindex“ in der Sitemap stehen?

In der Regel nicht. Die Sitemap sollte möglichst konsistent mit Ihrem Indexierungsziel sein. Wenn eine URL bewusst mit noindex versehen wurde, gehört sie normalerweise nicht in die Liste der URLs, die Sie als indexierbar empfehlen.

Kann eine Sitemap zu groß sein?

Ja. XML-Sitemaps unterliegen technischen Grenzen für Dateigröße und URL-Anzahl. Große Websites sollten deshalb einen Sitemap-Index und mehrere einzelne Dateien verwenden. Unabhängig von der Dateigröße ist eine überfüllte Sitemap mit irrelevanten URLs auch inhaltlich problematisch.

Ist eine HTML-Sitemap besser als eine XML-Sitemap?

Beide Formate haben unterschiedliche Aufgaben. Eine HTML-Sitemap kann Besuchern und Suchmaschinen bei der Navigation helfen und die interne Verlinkung verbessern. Eine XML-Sitemap ist dagegen speziell für maschinenlesbare URL-Hinweise gedacht. Je nach Website können beide Varianten sinnvoll sein.

Was bedeutet es, wenn eine Sitemap nicht alle indexierten URLs enthält?

Das ist nicht automatisch ein Fehler. Suchmaschinen können URLs über Links oder andere Signale entdecken. Die Sitemap sollte sich auf Ihre bevorzugten und relevanten URLs konzentrieren. Wenn wichtige Seiten fehlen, sollten Sie jedoch die Generierungsregeln und die technische Abdeckung überprüfen.

Wie erkennt man falsche lastmod-Daten?

Vergleichen Sie die angegebenen Änderungsdaten mit dem tatsächlichen Redaktionsverlauf oder dem Inhalt der Seiten. Wenn viele URLs dasselbe aktuelle Datum erhalten, obwohl sich ihre Inhalte nicht geändert haben, ist die Datenquelle wahrscheinlich zu pauschal. In diesem Fall sollte die Generierung auf echte Inhaltsänderungen abgestimmt werden.

Fazit: Sitemap.xml prüfen und optimieren

Eine gute Sitemap.xml ist übersichtlich, technisch gültig und auf die wirklich wichtigen URLs konzentriert. Prüfen Sie nicht nur, ob die Datei erreichbar ist, sondern auch, ob ihre Einträge mit Canonical-Tags, Statuscodes, Indexierungsregeln und der tatsächlichen Website-Struktur übereinstimmen. Entfernen Sie Weiterleitungen, Fehlerseiten und irrelevante technische Varianten. Nutzen Sie einen Sitemap-Index, wenn die Website umfangreich ist, und behandeln Sie Änderungsdaten mit der nötigen Sorgfalt.

Die beste Wirkung entsteht im Zusammenspiel mit einer klaren Informationsarchitektur, sinnvoller interner Verlinkung und hochwertigen Inhalten. Wer die Sitemap nach größeren Änderungen und in regelmäßigen Abständen kontrolliert, schafft ein verlässliches technisches Signal und erkennt Probleme meist, bevor sie die Auffindbarkeit wichtiger Seiten beeinträchtigen.

robots.txt prüfen und verstehen: Der umfassende Ratgeber für Website-Betreiber

Die Datei robots.txt gehört zu den kleinsten, aber häufig missverstandenen Bestandteilen einer Website. Sie kann Suchmaschinen-Crawlern Hinweise geben, welche Bereiche sie abrufen dürfen und welche nicht. Gleichzeitig ist sie weder ein sicherer Zugriffsschutz noch eine Garantie dafür, dass Seiten aus dem Suchindex verschwinden. Wer die Datei richtig einordnet, kann Crawling-Ressourcen gezielter steuern, typische SEO-Fehler vermeiden und technische Probleme schneller erkennen.

Dieser Ratgeber zeigt, wie Sie robots.txt prüfen und verstehen, welche Direktiven relevant sind, wie Sie die Datei testen und welche Grenzen sie hat. Die Beispiele sind bewusst allgemein gehalten, damit Sie die Regeln auf unterschiedliche Content-Management-Systeme und Hosting-Umgebungen übertragen können.

Was ist eine robots.txt?

Die Datei robots.txt ist eine einfache Textdatei im Hauptverzeichnis einer Website. Sie ist normalerweise unter dieser Adresse erreichbar:

https://www.beispiel.de/robots.txt

Ein Crawler ruft diese Datei ab, bevor er weitere URLs derselben Website crawlt. Darin können Regeln stehen, die sich an bestimmte Crawler oder an alle Crawler richten. Die Regeln beziehen sich vor allem darauf, welche Pfade ein Crawler abrufen soll oder nicht abrufen soll.

Wichtig ist die Unterscheidung zwischen Crawling und Indexierung. Crawling bedeutet, dass ein Bot eine URL abruft und ihren Inhalt verarbeitet. Indexierung bedeutet, dass eine Suchmaschine eine URL in ihren Suchindex aufnimmt und sie möglicherweise in den Suchergebnissen anzeigt. Eine Sperre in der robots.txt verhindert in erster Linie den Abruf. Sie ist keine zuverlässige Anweisung, eine bereits bekannte URL aus dem Index zu entfernen.

Die Datei ist öffentlich. Jeder kann sie aufrufen und ihren Inhalt lesen. Deshalb sollten Sie dort keine vertraulichen Verzeichnisse, internen Projektnamen oder Hinweise auf sensible Systembereiche aufführen, wenn diese Informationen nicht öffentlich sichtbar sein sollen.

Warum sollte man robots.txt prüfen und verstehen?

Eine fehlerhafte robots.txt kann dazu führen, dass wichtige Inhalte, Produktseiten, Kategorien oder JavaScript- und CSS-Dateien nicht wie erwartet gecrawlt werden. Ein versehentlich gesetztes Disallow: / würde beispielsweise den gesamten Abruf einer Website für den betroffenen Crawler blockieren. Umgekehrt kann eine sehr großzügige Konfiguration unnötige URL-Varianten, Suchergebnisse oder Filterkombinationen crawlen lassen.

Die Prüfung ist besonders sinnvoll, wenn eine Website neu veröffentlicht, migriert oder technisch umgebaut wurde. Auch nach Änderungen am Shopsystem, an einem SEO-Plugin, an der Domainstruktur oder an wichtigen Verzeichnissen lohnt sich ein Blick auf die Datei. Sie sollten außerdem kontrollieren, ob die Datei tatsächlich unter der richtigen Domain und mit dem erwarteten Statuscode erreichbar ist.

Typische Ziele einer Prüfung

  • prüfen, ob wichtige Inhalte versehentlich gesperrt werden;
  • unnötige Crawling-Pfade wie interne Suchseiten oder bestimmte Parameter begrenzen;
  • unbeabsichtigte Unterschiede zwischen www-, nicht-www-, HTTP- und HTTPS-Versionen erkennen;
  • eine Sitemap-URL korrekt bekannt machen;
  • Syntaxfehler und widersprüchliche Regeln identifizieren;
  • feststellen, ob eine robots.txt fälschlich als Zugriffsschutz verwendet wird.

Die wichtigsten Bestandteile einer robots.txt

Die wichtigsten Direktiven einer robots.txt im u00dcberblick
Diese Übersicht zeigt, wie zentrale robots.txt-Direktiven zusammenspielen.

Achten Sie auf die Zuordnung zwischen einer Direktive und dem jeweiligen Pfad. Die Darstellung macht sichtbar, dass eine Regel nicht isoliert, sondern immer im Zusammenhang mit dem angesprochenen Crawler gelesen werden sollte.

Eine robots.txt besteht aus einzelnen Anweisungen. Die wichtigsten Elemente sind User-agent, Disallow, Allow und Sitemap. Leerzeilen werden häufig verwendet, um Regelgruppen übersichtlich voneinander zu trennen. Kommentare beginnen mit einem Doppelkreuz und werden von unterstützenden Crawlern ignoriert.

User-agent

Mit User-agent legen Sie fest, für welchen Crawler eine nachfolgende Regelgruppe gilt. Mit dem Sternchen sprechen Sie alle Crawler an:

User-agent: *

Daneben können einzelne Crawler gezielt angesprochen werden. Das ist jedoch nur sinnvoll, wenn Sie einen konkreten technischen Grund haben und genau wissen, wie der jeweilige Crawler seine Regeln verarbeitet. Unterschiedliche Suchmaschinen oder Spezial-Crawler können eigene Bezeichnungen und eigene Interpretationen verwenden.

Disallow

Disallow kennzeichnet einen Pfad, den der betreffende Crawler nicht abrufen soll. Ein leerer Wert bedeutet normalerweise, dass kein Pfad gesperrt wird:

User-agent: *
Disallow:

Ein Pfad mit einem abschließenden Schrägstrich bezieht sich typischerweise auf diesen Verzeichnisbereich und seine Unterpfade:

User-agent: *
Disallow: /admin/

Das ist nicht dasselbe wie ein sicherer Schutz des Verzeichnisses. Der Server kann die angeforderte Ressource weiterhin ausliefern, wenn jemand die URL direkt aufruft.

Allow

Allow kann verwendet werden, um innerhalb eines gesperrten Bereichs einen bestimmten Pfad wieder freizugeben. Die genaue Auswertung kann von der Crawler-Implementierung und von konkurrierenden Regeln abhängen. Deshalb sollten Ausnahmen möglichst klar und sparsam formuliert werden.

User-agent: *
Disallow: /intern/
Allow: /intern/oeffentliches-dokument.pdf

Wenn Regeln kompliziert werden, ist es oft besser, die URL-Struktur oder die technische Auslieferung zu vereinfachen. Eine kurze, verständliche Datei ist leichter zu warten als eine Sammlung vieler Ausnahmen.

Sitemap

Mit Sitemap können Sie Suchmaschinen auf eine XML-Sitemap hinweisen. Die vollständige absolute URL ist empfehlenswert:

Sitemap: https://www.beispiel.de/sitemap.xml

Eine Sitemap ist keine Erlaubnis zum Crawlen und ersetzt auch keine interne Verlinkung. Sie liefert lediglich eine zusätzliche Quelle für URLs, die eine Suchmaschine prüfen kann. In einer robots.txt können auch mehrere Sitemap-URLs angegeben werden, etwa wenn eine Website getrennte Sitemaps für Beiträge, Produkte und Kategorien verwendet.

So prüfen Sie Ihre robots.txt Schritt für Schritt

1. Die richtige Datei aufrufen

Rufen Sie die Datei direkt auf der betreffenden Host- und Protokollvariante auf. Eine robots.txt für https://www.beispiel.de gilt nicht automatisch für eine separate Subdomain wie https://shop.beispiel.de. Ebenso sollten Sie Weiterleitungen, unterschiedliche Domains und mögliche Staging-Umgebungen kontrollieren.

Prüfen Sie, ob die Antwort tatsächlich eine Textdatei mit den erwarteten Regeln ist. Eine HTML-Fehlerseite, ein Login, ein Serverfehler oder eine unerwartete Weiterleitung kann die Funktion beeinträchtigen. Eine temporäre Nichterreichbarkeit ist anders zu bewerten als eine bewusst leere Datei.

2. Inhalt und Format kontrollieren

Die Datei sollte gut lesbar sein und pro Zeile eine Anweisung enthalten. Achten Sie auf Tippfehler bei den Direktiven, überflüssige Leerzeichen, nicht beabsichtigte Sonderzeichen und Pfade, die nicht zur aktuellen Website-Struktur passen. Kommentare können erklären, warum eine Regel existiert und wer sie bei Änderungen überprüfen sollte.

Ein einfacher Anfang kann so aussehen:

User-agent: *
Disallow: /interne-suche/
Disallow: /konto/
Disallow: /warenkorb/
Sitemap: https://www.beispiel.de/sitemap.xml

Ob diese Regeln sinnvoll sind, hängt von Ihrer Website ab. Bei einer redaktionellen Website gibt es andere technische Bereiche als in einem Onlineshop. Übernehmen Sie Beispiele deshalb nicht blind.

3. Jede Regel auf wichtige URLs anwenden

Erstellen Sie eine kleine Liste wichtiger URL-Typen: Startseite, redaktioneller Beitrag, Produktseite, Kategorie, Bild- oder Dokumentseite sowie gegebenenfalls eine paginierte Übersichtsseite. Prüfen Sie anschließend, ob ein Disallow-Muster diese Pfade berührt. Besonders gefährlich sind sehr allgemeine Muster wie ein gesperrter Ordnername, der auch wichtige Inhalte enthält.

Denken Sie außerdem an Verzeichnisse für Ressourcen. Eine Suchmaschine muss nicht jede technische Datei indexieren, benötigt aber gegebenenfalls Zugriff auf Ressourcen, um eine Seite zu rendern und ihre Inhalte richtig zu verstehen. Sperren Sie CSS-, JavaScript- oder Bildpfade daher nicht pauschal, ohne die Auswirkungen zu prüfen.

4. Mit einem geeigneten Testwerkzeug nachprüfen

Für eine zusätzliche Kontrolle können Sie die Prüf- und Berichtsfunktionen der jeweiligen Suchmaschinen-Tools verwenden, sofern sie für Ihre Property verfügbar sind. Solche Werkzeuge helfen dabei, einzelne URLs gegen eine veröffentlichte robots.txt zu beurteilen. Sie ersetzen jedoch nicht die manuelle Prüfung der Datei und der tatsächlichen Serverantwort.

Testen Sie nicht nur eine Muster-URL. Ein erfolgreicher Test für eine Produktseite sagt wenig aus, wenn beispielsweise alle Kategorieseiten oder die Sitemap blockiert sind. Prüfen Sie repräsentative URL-Typen und wiederholen Sie die Kontrolle nach jeder Änderung.

Häufige Fehler und ihre Folgen

Die gesamte Website versehentlich sperren

Diese Regel ist besonders weitreichend:

User-agent: *
Disallow: /

Sie kann in einer Entwicklungsumgebung sinnvoll sein, ist für eine öffentlich auffindbare Produktionswebsite aber meist problematisch. Ein häufiger Fehler besteht darin, diese Einstellung beim Wechsel von Staging zu Live zu übernehmen. Kontrollieren Sie deshalb nach einem Launch sofort die robots.txt und wichtige URLs.

Wichtige Verzeichnisse blockieren

Ein Pfad wie /blog/, /content/ oder /produkte/ kann je nach Website zentrale Inhalte enthalten. Auch scheinbar technische Ordner können Bilder, Skripte oder andere Ressourcen bereitstellen. Prüfen Sie zuerst, welche Dateien und URL-Typen tatsächlich darunter liegen.

robots.txt mit noindex verwechseln

Die robots.txt ist kein zuverlässiger Ersatz für eine noindex-Anweisung. Wenn eine Suchmaschine eine URL nicht abrufen darf, kann sie deren Inhalt und ein dort gesetztes noindex unter Umständen nicht lesen. Für die Indexierungssteuerung müssen Sie die passende Methode verwenden, beispielsweise ein Robots-Meta-Element oder einen entsprechenden HTTP-Header, sofern der Crawler die Seite abrufen darf.

Wenn eine bereits indexierte URL dauerhaft aus den Suchergebnissen verschwinden soll, sind je nach Fall andere Maßnahmen erforderlich. Dazu gehören die korrekte Indexierungsanweisung, die Entfernung oder Weiterleitung des Inhalts und gegebenenfalls die Nutzung von Funktionen zur vorübergehenden Entfernung in den Webmaster-Werkzeugen.

Interne Suchseiten und Parameter unüberlegt blockieren

Interne Suchseiten, Sortierungen und Filter können eine große Zahl ähnlicher URLs erzeugen. Das kann ein berechtigter Anlass sein, bestimmte Pfade zu begrenzen. Eine pauschale Sperre nach einem allgemeinen Parameterzeichen kann jedoch auch wertvolle URLs treffen. Prüfen Sie zuerst, welche Parameter tatsächlich vorkommen und ob sie für Nutzer oder Suchmaschinen relevante Inhalte erzeugen.

Die Sitemap falsch eintragen

Eine Sitemap-Angabe mit Tippfehler, falscher Domain oder nicht erreichbarer Datei hilft nicht weiter. Die Sitemap sollte auf eine gültige, öffentlich abrufbare XML-Datei zeigen. Achten Sie bei mehreren Sprach- oder Domainvarianten darauf, dass die URL zur jeweiligen Website gehört und die enthaltenen URLs zur richtigen Property passen.

robots.txt als Zugriffsschutz: Was sie nicht kann

Die Datei richtet sich an kooperative Crawler. Sie verhindert nicht, dass Menschen eine URL aufrufen, und sie hält keinen böswilligen Bot zuverlässig auf. Auch sensible Daten, Backups, Zugangsdaten, interne Dokumente oder Verwaltungsoberflächen gehören nicht lediglich durch eine robots.txt geschützt ins Internet.

Für vertrauliche Bereiche benötigen Sie eine serverseitige Zugriffskontrolle, beispielsweise Authentifizierung, geeignete Berechtigungen oder eine Beschränkung auf ein internes Netzwerk. Zusätzlich sollten sensible Dateien gar nicht erst öffentlich gespeichert werden. Eine robots.txt darf höchstens ergänzend eingesetzt werden, nicht als Sicherheitsmaßnahme.

Beachten Sie auch, dass gesperrte URLs unter Umständen trotzdem bekannt werden können, etwa durch externe Verweise. Suchmaschinen können dann möglicherweise die URL, aber nicht den Inhalt anzeigen. Daraus folgt: Eine Sperre kann Sichtbarkeit nicht in jedem Fall verhindern.

Praktische Entscheidungsregeln für die eigene Website

Bevor Sie eine neue Regel hinzufügen, beantworten Sie einige konkrete Fragen:

  1. Welches Problem soll gelöst werden? Benennen Sie den konkreten URL-Bereich oder das Crawling-Problem.
  2. Welche URLs sind betroffen? Prüfen Sie echte Beispieladressen und nicht nur die Ordnerbezeichnung.
  3. Soll der Inhalt nicht gecrawlt oder nicht indexiert werden? Wählen Sie die Maßnahme nach dem Ziel aus.
  4. Ist die Sperre für alle Crawler notwendig? Eine allgemeine Regel ist weitreichender als eine gezielte Regel.
  5. Wie wird die Änderung kontrolliert? Legen Sie fest, welche URLs nach der Veröffentlichung getestet werden.
  6. Wer pflegt die Datei? Dokumentieren Sie Verantwortlichkeit und Anlass der Regel, damit sie nicht dauerhaft aus Gewohnheit bestehen bleibt.

In vielen Fällen ist eine saubere interne Verlinkung, eine konsistente URL-Struktur und eine korrekte Indexierungssteuerung nachhaltiger als eine lange Liste von Sperren. Die robots.txt sollte ein gezieltes technisches Werkzeug bleiben.

robots.txt nach einem Relaunch oder Domainwechsel prüfen

Bei einem Relaunch ändern sich häufig Verzeichnisse, Parameter, Weiterleitungen und Sitemap-Adressen gleichzeitig. Führen Sie die Prüfung deshalb als festen Bestandteil der technischen Abnahme durch. Kontrollieren Sie die Datei auf der produktiven Domain, testen Sie die wichtigsten URL-Typen und stellen Sie sicher, dass die Sitemap aktualisiert wurde.

Vergleichen Sie die neue Version mit der alten Datei, aber übernehmen Sie nicht automatisch jede historische Regel. Eine frühere Sperre kann für die neue Struktur falsch sein. Prüfen Sie außerdem, ob ein temporärer Schutz aus der Entwicklungsphase entfernt wurde und ob die Domain nicht versehentlich auf eine fremde oder nicht öffentliche Sitemap verweist.

Nach dem Launch sollten Sie die Berichte der Suchmaschinen beobachten. Ein einzelner Hinweis ist nicht immer ein Beweis für einen Fehler, aber wiederkehrende Crawling- oder Indexierungsprobleme verdienen eine genaue Untersuchung der betroffenen URLs, Serverantworten, Canonicals und robots.txt-Regeln.

FAQ

Wo muss die robots.txt liegen?

Sie gehört in das Hauptverzeichnis der jeweiligen Host- und Protokollvariante und sollte unter /robots.txt erreichbar sein. Eine Datei in einem Unterordner gilt nicht automatisch für die gesamte Domain. Für Subdomains muss die Konfiguration separat betrachtet werden.

Kann robots.txt eine Seite aus Google entfernen?

Eine Sperre verhindert in erster Linie den Abruf und ist keine zuverlässige Entfernung aus dem Index. Für eine kontrollierte Indexierung benötigen Sie eine passende Maßnahme, die der Crawler lesen kann, oder eine andere geeignete Entfernung beziehungsweise Deindexierung im jeweiligen Fall.

Ist eine leere robots.txt problematisch?

Eine leere Datei bedeutet üblicherweise, dass keine Pfade ausdrücklich gesperrt werden. Das kann für eine kleine Website völlig in Ordnung sein. Entscheidend ist, ob die Website besondere Crawling-Probleme hat und ob andere technische Maßnahmen die gewünschten Signale liefern.

Sollte ich CSS und JavaScript sperren?

Eine pauschale Sperre ist meist keine gute Idee. Suchmaschinen können Ressourcen benötigen, um Layout und Inhalte einer Seite zu verstehen. Prüfen Sie einzelne Pfade und sperren Sie nur Bereiche, deren Abruf tatsächlich unnötig ist und keine wichtige Darstellung oder Funktionsweise beeinflusst.

Wie oft sollte man robots.txt prüfen?

Eine feste monatliche Pflicht gibt es nicht. Sinnvoll ist eine Prüfung bei Relaunches, Migrationen, Änderungen am Shopsystem, Wechseln von SEO-Erweiterungen und auffälligen Crawling- oder Indexierungsdaten. Zusätzlich kann eine regelmäßige technische Checkliste helfen, unbemerkte Änderungen zu erkennen.

Kann ich mit robots.txt schädliche Bots blockieren?

Nur kooperative Bots können die Datei freiwillig beachten. Für unerwünschten oder missbräuchlichen Traffic benötigen Sie serverseitige oder vorgeschaltete Schutzmechanismen. Die robots.txt sollte nicht als Sicherheits- oder Lastschutz betrachtet werden.

Was bedeutet ein Pfad mit Schrägstrich am Ende?

Ein abschließender Schrägstrich beschreibt üblicherweise einen Verzeichnisbereich und seine Unterpfade. Ob ein konkretes Muster eine URL erfasst, hängt jedoch von der Schreibweise und der Auswertung des Crawlers ab. Testen Sie daher reale Beispiel-URLs, insbesondere bei ähnlichen Pfaden.

Fazit: robots.txt systematisch prüfen

Wer robots.txt prüfen und verstehen möchte, sollte nicht nur nach einer einzelnen fehlerhaften Zeile suchen. Entscheidend ist das Zusammenspiel aus URL-Struktur, Crawling, Indexierung, Ressourcen, Sitemaps und Zugriffsschutz. Rufen Sie die Datei auf der richtigen Domain auf, lesen Sie jede Regel im Kontext, testen Sie wichtige URL-Typen und dokumentieren Sie bewusst gesetzte Ausnahmen.

Eine gute robots.txt ist nicht möglichst lang, sondern nachvollziehbar und zielgerichtet. Verwenden Sie sie für begrenzte Crawling-Steuerung, aber nicht für vertrauliche Daten oder als Ersatz für noindex. Nach technischen Änderungen sollte die Prüfung Teil der Abnahme sein. So erkennen Sie verhinderte Crawling-Zugriffe früh und schaffen eine verlässlichere Grundlage für die technische Suchmaschinenoptimierung.

Canonical-Tag richtig einsetzen: Der umfassende SEO-Ratgeber

Ein Canonical-Tag hilft Suchmaschinen dabei, die bevorzugte URL für identische oder sehr ähnliche Inhalte zu erkennen. Das ist besonders wichtig, wenn eine Website mehrere URLs für dieselbe Seite erzeugt, etwa durch Filter, Tracking-Parameter, Druckansichten oder alternative Pfade. Richtig eingesetzt, kann das Canonical-Signal die Indexierung übersichtlicher machen und Signale auf eine zentrale URL bündeln. Falsch eingesetzt, kann es dagegen wichtige Seiten aus dem Index drängen.

Dieser Ratgeber erklärt, wie du den Canonical-Tag richtig einsetzen kannst, wann er sinnvoll ist, welche Fehler häufig auftreten und wie du die Implementierung systematisch prüfst.

Was ist ein Canonical-Tag?

Der Canonical-Tag ist ein HTML-Link-Element im <head> einer Webseite. Es weist auf die bevorzugte, sogenannte kanonische URL eines Inhalts hin. Ein typisches Beispiel sieht so aus:

<link rel="canonical" href="https://www.beispiel.de/ratgeber/canonical-tag/">

Die URL im Attribut href ist die Adresse, die Suchmaschinen bevorzugt berücksichtigen sollen. Andere URLs können weiterhin erreichbar sein, werden aber als alternative Varianten desselben oder eines sehr ähnlichen Inhalts signalisiert.

Wichtig ist die Einordnung: Ein Canonical-Tag ist kein harter Weiterleitungsbefehl. Besucherinnen und Besucher bleiben auf der aufgerufenen URL, sofern keine andere technische Maßnahme greift. Außerdem ist das Canonical-Signal für Suchmaschinen eine Empfehlung, keine Garantie. Ob es übernommen wird, hängt unter anderem von der technischen Konsistenz und der inhaltlichen Ähnlichkeit der beteiligten Seiten ab.

Warum ist der Canonical-Tag für SEO wichtig?

Illustration zum Canonical-Tag mit mehreren URL-Varianten und einer bevorzugten kanonischen URL 1

Websites erzeugen häufig mehrere URLs, obwohl dahinter derselbe Inhalt steht. Das kann durch URL-Parameter, Sortierungen, interne Suchfunktionen, verschiedene URL-Schreibweisen oder Content-Management-Systeme passieren. Ohne klare Signale müssen Suchmaschinen selbst einschätzen, welche Variante relevant ist.

Ein sauber gesetztes Canonical kann dabei helfen, drei praktische Ziele zu erreichen:

  • Duplikate einordnen: Sehr ähnliche URLs werden als Varianten eines bevorzugten Dokuments gekennzeichnet.
  • Signale bündeln: Verweise und andere Signale können stärker mit der bevorzugten URL verbunden werden, sofern die Suchmaschine das Canonical akzeptiert.
  • Indexierung steuern: Die gewünschte URL erhält eine klarere Priorität gegenüber technisch erzeugten Varianten.

Der Canonical-Tag löst jedoch nicht jedes Duplicate-Content-Problem. Bei vollständig unterschiedlichen Seiten ist er ungeeignet. Auch eine fehlerhafte interne Verlinkung, falsche Weiterleitungen oder unzugängliche Zielseiten werden durch ein Canonical nicht automatisch behoben.

Canonical-Tag richtig einsetzen: Die wichtigsten Regeln

Eine bevorzugte URL eindeutig festlegen

Bevor du ein Canonical setzt, solltest du entscheiden, welche URL dauerhaft die maßgebliche Version des Inhalts sein soll. Berücksichtige dabei die gewünschte Domain, das Protokoll, die Schreibweise des Pfades und die URL-Struktur.

Diese Varianten können technisch unterschiedliche Adressen sein:

  • http://www.beispiel.de/seite/
  • https://www.beispiel.de/seite/
  • https://beispiel.de/seite/
  • https://www.beispiel.de/seite

Welche Variante kanonisch sein soll, ist eine strategische Entscheidung. Entscheidend ist, dass sie auf der Website konsequent verwendet wird. HTTPS ist für die meisten modernen Websites die naheliegende Wahl. Ob die Domain mit oder ohne „www“ verwendet wird und ob ein abschließender Schrägstrich dazugehört, sollte zur bestehenden URL-Architektur passen.

Selbstreferenzierende Canonicals verwenden

Auch die bevorzugte Originalseite kann ein Canonical auf sich selbst enthalten. Dieses sogenannte selbstreferenzierende Canonical sieht beispielsweise so aus:

<link rel="canonical" href="https://www.beispiel.de/ratgeber/canonical-tag/">

Damit wird die bevorzugte URL auch auf ihrer eigenen Seite eindeutig benannt. Das kann besonders hilfreich sein, wenn URLs durch Parameter oder andere technische Varianten erreichbar sind. Die selbstreferenzierende Variante ist kein Ersatz für eine saubere URL-Struktur, aber ein klares zusätzliches Signal.

Absolute URLs nutzen

Verwende im Canonical-Tag möglichst vollständige absolute URLs mit Protokoll und Domain. Eine vollständige Angabe ist leichter zu prüfen und verringert das Risiko, dass relative Pfade in unterschiedlichen Umgebungen falsch interpretiert werden.

Bevorzugt:

<link rel="canonical" href="https://www.beispiel.de/produkte/kaffeemuehle/">

Weniger eindeutig:

<link rel="canonical" href="/produkte/kaffeemuehle/">

Die absolute Schreibweise sollte exakt der tatsächlich erreichbaren Ziel-URL entsprechen. Achte auf Groß- und Kleinschreibung, URL-Codierung, den abschließenden Schrägstrich und mögliche Weiterleitungsketten.

Das Canonical auf eine indexierbare Zielseite setzen

Die kanonische Zielseite sollte normalerweise erreichbar sein, einen erfolgreichen HTTP-Status liefern und nicht durch noindex von der Indexierung ausgeschlossen werden. Verweist ein Canonical auf eine blockierte, nicht erreichbare oder dauerhaft weitergeleitete URL, entsteht ein widersprüchliches Signal.

Prüfe deshalb vor dem Einsatz:

  • Die Ziel-URL ist öffentlich erreichbar.
  • Sie antwortet nicht mit einem Fehlerstatus.
  • Sie wird nicht unnötig über mehrere Stationen weitergeleitet.
  • Sie enthält den maßgeblichen Inhalt.
  • Sie ist nicht durch widersprüchliche Robots-Anweisungen ausgeschlossen.

Eine Zielseite muss nicht in jedem Szenario identisch mit der Ausgangsseite sein. Je größer der inhaltliche Unterschied jedoch ist, desto schwächer und riskanter wird das Signal. Das Canonical sollte nicht als pauschales Mittel verwendet werden, um beliebige Seiten auf eine zentrale Übersichtsseite zu verweisen.

Typische Einsatzgebiete für Canonical-Tags

URL-Parameter für Tracking

Marketing- oder Analyseparameter wie ?utm_source=newsletter verändern häufig nicht den eigentlichen Seiteninhalt. Die URL mit Parameter kann separat aufgerufen werden, soll aber meist nicht als eigene Inhaltsversion gelten. In diesem Fall kann die parameterfreie URL als Canonical dienen.

Beispiel:

Aufgerufene URL: https://www.beispiel.de/angebot/?utm_source=newsletter
Canonical:       https://www.beispiel.de/angebot/

Wichtig ist, dass der Parameter tatsächlich keinen relevanten Seiteninhalt verändert. Wenn ein Parameter eine echte Produktvariante, Sprache oder redaktionell wichtige Auswahl erzeugt, darf er nicht automatisch entfernt werden.

Sortier- und Filtervarianten in Shops

Onlineshops erzeugen oft URL-Varianten für Sortierungen, Farben, Größen oder Preisfilter. Nicht jede dieser URLs sollte dieselbe kanonische Zielseite erhalten. Entscheidend ist, ob die Variante eine eigenständige Suchintention bedient und dauerhaft als eigene Landingpage gepflegt wird.

Eine rein technische Sortierung wie „Preis aufsteigend“ ist häufig keine eigenständige Inhaltsseite. Eine sorgfältig erstellte Kategorie für ein klar definiertes Sortiment kann dagegen eine eigene kanonische URL verdienen. Die Entscheidung sollte mit der Informationsarchitektur, der internen Verlinkung und der redaktionellen Pflege zusammenpassen.

Druckansichten und alternative Darstellungen

Wenn eine Druckansicht denselben Inhalt in einem anderen Layout ausgibt, kann sie auf die normale Inhaltsseite verweisen. Dasselbe gilt für bestimmte mobile oder vereinfachte Darstellungen, sofern diese nicht als eigenständige Inhalte gedacht sind.

Bei responsiven Websites ist eine separate mobile URL häufig gar nicht erforderlich. Falls dennoch alternative Adressen existieren, müssen Canonicals, hreflang-Angaben und Weiterleitungen als zusammenhängendes System geprüft werden.

Produktvarianten

Bei Produkten ist die Situation differenziert. Varianten wie Farbe oder Speichergröße können denselben Grundinhalt teilen, aber unterschiedliche Suchabsichten erfüllen. Eine gemeinsame kanonische Produktseite kann sinnvoll sein, wenn die Varianten inhaltlich kaum voneinander abweichen. Eigene Seiten sind eher gerechtfertigt, wenn sich Name, technische Daten, Verfügbarkeit, Bilder und Beschreibung wesentlich unterscheiden.

Verwende den Canonical-Tag hier nicht automatisch für alle Varianten. Prüfe stattdessen, ob Nutzerinnen und Nutzer eine Variante als eigenständiges Angebot finden und verstehen sollten.

Ähnliche redaktionelle Inhalte

Bei redaktionellen Seiten ist ein Canonical nur dann passend, wenn eine Seite im Wesentlichen eine alternative URL für denselben Inhalt darstellt. Ähnliche Ratgeber mit unterschiedlichen Schwerpunkten sollten nicht einfach aufeinander kanonisiert werden. Besser sind eine klare thematische Abgrenzung, interne Verlinkung und gegebenenfalls eine Überarbeitung überschneidender Inhalte.

Canonical-Tag, Weiterleitung und noindex im Vergleich

Diese drei Maßnahmen werden häufig verwechselt, erfüllen aber unterschiedliche Aufgaben.

Maßnahme Wirkung Geeignet für
Canonical-Tag Empfiehlt eine bevorzugte URL, die aufgerufene Seite bleibt erreichbar. Ähnliche oder technisch erzeugte URL-Varianten.
301-Weiterleitung Leitet Besucherinnen und Besucher dauerhaft auf eine andere URL weiter. Zusammengelegte, umgezogene oder dauerhaft ersetzte Inhalte.
noindex Signalisiert, dass eine Seite nicht in den Suchindex aufgenommen werden soll. Seiten, die erreichbar bleiben, aber nicht als Suchergebnis erscheinen sollen.

Wenn eine alte URL nicht mehr benötigt wird, ist eine Weiterleitung meist klarer als ein Canonical. Wenn eine Seite für Nutzer weiterhin zugänglich sein muss, aber keine eigenständige Suchversion darstellen soll, kann ein Canonical oder noindex infrage kommen. Die passende Lösung hängt vom Zweck der URL ab.

Canonical-Tags in verschiedenen technischen Umgebungen

HTML im Head

Die häufigste Implementierung erfolgt im <head> des HTML-Dokuments. Pro Seite sollte die Implementierung eindeutig sein. Mehrere unterschiedliche Canonical-Tags auf derselben Seite schaffen kein klares Signal.

<head>
  <title>Canonical-Tag richtig einsetzen</title>
  <link rel="canonical" href="https://www.beispiel.de/ratgeber/canonical-tag/">
</head>

Content-Management-Systeme

Viele Content-Management-Systeme oder SEO-Erweiterungen erzeugen Canonicals automatisch. Das ist bequem, kann aber bei individuellen URL-Strukturen zu Fehlern führen. Prüfe deshalb nicht nur die Einstellungen im Backend, sondern auch den tatsächlich ausgelieferten Quelltext.

Besondere Aufmerksamkeit verdienen:

  • Archivseiten und paginierte Übersichten
  • Parameter-URLs aus Such- und Filterfunktionen
  • Mehrsprachige Inhalte
  • Staging- oder Testumgebungen
  • Seiten mit Weiterleitungen oder wechselnden Permalinks

Canonical über HTTP-Header

Für bestimmte nicht-HTML-Dokumente, etwa PDF-Dateien, kann ein Canonical-Signal über einen HTTP-Header übermittelt werden. Das ist eine technische Sonderlösung und sollte sauber mit der Serverkonfiguration abgestimmt werden. Bei normalen HTML-Seiten ist das Link-Element im Dokument meist leichter zu verwalten und zu kontrollieren.

Häufige Fehler beim Canonical-Tag

Canonical auf eine nicht passende Seite

Ein Canonical von einer Produktseite auf die Startseite oder von einem ausführlichen Ratgeber auf eine allgemeine Kategorie ist in der Regel zu weit gefasst. Die Zielseite sollte den gleichen oder nahezu gleichen Kerninhalt repräsentieren.

Mehrere Canonical-Tags

Wenn ein System im Template, ein Plugin und eine weitere Erweiterung jeweils ein Canonical ausgeben, können widersprüchliche Angaben entstehen. Suche im gerenderten HTML nach rel="canonical" und stelle sicher, dass pro Dokument nur eine eindeutige Angabe vorhanden ist.

Canonical auf eine 404- oder 5xx-Seite

Gelöschte oder technisch fehlerhafte Zielseiten sind als kanonische Ziele ungeeignet. Nach Migrationen und URL-Änderungen sollte deshalb geprüft werden, ob alle Canonical-Ziele weiterhin existieren.

Canonical und interne Links widersprechen sich

Wenn die meisten internen Links auf eine Varianten-URL zeigen, das Canonical aber auf eine andere Adresse verweist, entstehen unnötige Signalkonflikte. Verlinke intern möglichst direkt auf die bevorzugte URL. Das verbessert die Orientierung für Menschen und erleichtert die technische Verarbeitung.

Lokale URLs oder Testdomains ausliefern

Bei Umzügen, Staging-Systemen und Domainwechseln kann versehentlich eine Testdomain im Canonical stehen. Prüfe deshalb vor jeder Veröffentlichung das Protokoll, die Domain und den vollständigen Pfad. Ein Canonical auf eine nicht öffentliche Umgebung kann die Auffindbarkeit der Produktionsseite beeinträchtigen.

Eine praktische Checkliste zur Prüfung

Mit der folgenden Reihenfolge kannst du Canonicals systematisch kontrollieren:

  1. URL auswählen: Bestimme für jede relevante Seite die gewünschte kanonische Adresse.
  2. Quelltext prüfen: Suche im ausgelieferten HTML nach dem Canonical-Link.
  3. Eindeutigkeit kontrollieren: Stelle sicher, dass nur ein Canonical vorhanden ist.
  4. Ziel aufrufen: Prüfe, ob die URL erreichbar ist und den erwarteten Inhalt liefert.
  5. Weiterleitungen untersuchen: Vermeide Canonicals auf URLs, die erst über mehrere Schritte weiterleiten.
  6. Indexierungsanweisungen abgleichen: Vergleiche Canonical, Robots-Metaangabe, HTTP-Header und robots.txt.
  7. Interne Links prüfen: Verweise möglichst direkt auf die kanonische URL.
  8. Sitemap abgleichen: Führe in XML-Sitemaps vorzugsweise die URLs auf, die du als kanonisch etablieren möchtest.
  9. Nach Änderungen erneut prüfen: Kontrolliere Canonicals nach Relaunches, Plugin-Updates und URL-Migrationen.

Für die Analyse können der Browser-Quelltext, Serverprotokolle und die Funktionen der jeweils eingesetzten Webmaster- beziehungsweise Suchmaschinenplattformen genutzt werden. Ein einzelnes Tool ersetzt dabei nicht die fachliche Prüfung des Inhalts und der URL-Logik.

Canonical-Tags bei internationalen Websites

Mehrsprachige Websites benötigen eine besonders sorgfältige Abstimmung. Sprachversionen sind normalerweise keine Duplikate, wenn sie unterschiedliche Nutzergruppen und Inhalte bedienen. Daher sollte eine deutsche Seite nicht pauschal auf die englische Seite kanonisiert werden. Stattdessen benötigen die Sprachversionen ihre jeweils passende kanonische URL und eine konsistente hreflang-Struktur.

Auch regionale Versionen können sich bei Währung, Lieferbedingungen, Rechtstexten oder Verfügbarkeit unterscheiden. In solchen Fällen sollte die URL-Architektur diese Unterschiede abbilden, anstatt alle Länder auf eine einzige Version zu verweisen.

Wann ist kein Canonical die bessere Lösung?

Ein Canonical ist nicht automatisch nötig, nur weil zwei URLs ähnlich aussehen. Wenn jede URL einen eigenständigen, nützlichen Inhalt bietet, sollte sie nicht ohne Prüfung auf eine andere Seite verweisen. Ebenso ist eine Weiterleitung oft geeigneter, wenn der alte Inhalt dauerhaft ersetzt wurde.

Bei nahezu identischen Seiten kann außerdem eine inhaltliche Zusammenführung sinnvoller sein als ein technisches Signal. Entferne überflüssige Varianten, verbessere die URL-Struktur und reduziere automatisch erzeugte Parameter, wenn sie für die Nutzerführung nicht gebraucht werden. Gute technische SEO beginnt häufig mit einer verständlichen Informationsarchitektur.

FAQ

Ist ein Canonical-Tag eine Weiterleitung?

Nein. Ein Canonical-Tag lässt die aufgerufene URL grundsätzlich erreichbar und empfiehlt Suchmaschinen eine bevorzugte Version. Eine Weiterleitung führt Nutzer und Crawler dagegen direkt zu einer anderen URL.

Muss jede Seite ein selbstreferenzierendes Canonical haben?

Es ist häufig sinnvoll, die bevorzugte URL selbst als Canonical auszuzeichnen. Es handelt sich aber nicht um eine pauschale Reparatur für jede URL-Situation. Entscheidend sind eine konsistente URL-Struktur und eine technisch passende Implementierung.

Kann ich mit einem Canonical Duplicate Content vollständig verhindern?

Nein. Das Canonical liefert ein wichtiges Signal, ersetzt aber keine saubere Seitenstruktur. Bei stark unterschiedlichen Inhalten, fehlerhaften Zielseiten oder widersprüchlichen technischen Angaben kann das Signal anders bewertet oder ignoriert werden.

Soll die Canonical-URL in der XML-Sitemap stehen?

Idealerweise enthält die XML-Sitemap die URLs, die du als bevorzugte Versionen etablieren möchtest. Das ist ein zusätzliches Konsistenzsignal, ersetzt aber nicht die korrekte Implementierung im HTML und die Prüfung der Zielseiten.

Wie gehe ich mit URL-Parametern um?

Wenn ein Parameter nur Tracking oder eine technische Sortierung darstellt und den Inhalt nicht wesentlich verändert, kann die parameterfreie URL als Canonical dienen. Erzeugt der Parameter dagegen eine eigenständige, relevante Seite, sollte er nicht automatisch entfernt werden.

Kann eine Seite auf eine andere Domain kanonisiert werden?

Technisch sind domainübergreifende Canonicals möglich, sie sollten aber nur bei einer klaren inhaltlichen Beziehung und einem nachvollziehbaren Eigentums- oder Veröffentlichungsmodell eingesetzt werden. Ein versehentliches Cross-Domain-Canonical kann die eigene Seite aus dem Suchindex verdrängen.

Was mache ich bei widersprüchlichen Canonicals?

Ermittle zunächst, welche Anwendung das Signal ausgibt: Template, Plugin, Server oder Plattform. Entscheide anschließend eine einzige Ziel-URL, entferne doppelte Angaben und passe interne Links, Sitemaps sowie Weiterleitungen an. Danach sollte die Seite erneut technisch geprüft werden.

Fazit: Canonical-Tag richtig einsetzen

Wer den Canonical-Tag richtig einsetzen möchte, sollte ihn als Bestandteil einer konsistenten URL-Strategie betrachten. Wähle eine eindeutige bevorzugte URL, verweise nur bei inhaltlicher Nähe auf sie und halte Canonical, interne Links, Sitemaps und Weiterleitungen möglichst widerspruchsfrei. Prüfe außerdem regelmäßig, ob die Zielseite erreichbar und weiterhin die passende Version ist.

Der größte Nutzen entsteht nicht durch möglichst viele Canonicals, sondern durch klare Entscheidungen: Welche URLs sind eigenständig wertvoll, welche sind nur technische Varianten und welche sollten dauerhaft weiterleiten? Wenn diese Fragen sauber beantwortet sind, wird der Canonical-Tag zu einem verständlichen und kontrollierbaren SEO-Signal.